一句话结论:长会话省钱的开关不在「模型单价」,在「缓存命中单价」。 我按单价挑了个更便宜的模型,结果账单是另一条路线的 2.15 倍。
一、先说结果:为了省钱,我多付了 72%
账单出来那天我盯着屏幕看了半天。用量一个字没变,只是换了个"更便宜"的模型,钱却变多了。
半年前我干了件自以为聪明的事:在高峰时段把默认模型切换成一个「输入便宜 25%、输出便宜 35%」的型号,想着一天里最贵的那几个小时总能省下三成。
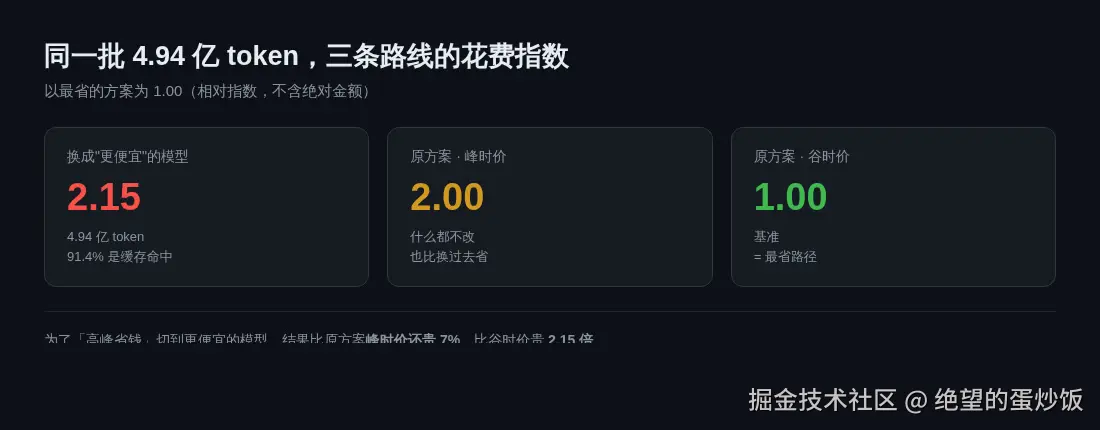
实际账单,三条路线的花费指数摆在一起(以最省的方案为 1.00):
| 我怎么花的 | 花费指数 | 说人话 |
|---|---|---|
| 换成"更便宜"的模型 | 2.15 | 我以为会最省的这个 |
| 同样的 token,原方案按峰时价 | 2.00 | 什么都不改,也比这个省 |
| 同样的 token,原方案按谷时价 | 1.00 | 什么都不改,只要这个价 |
同一批 4.94 亿 token,我多花了 115%,是谷时方案的 2.15 倍。
最讽刺的是:我之所以要"省钱",就是为了避开高峰的贵价时段。结果我换过去的那个模型,连原方案的峰时价都没打过。
为什么会这样?一句话:我比的是不重要的那两列价格,而真正决定账单的那一列,我根本没看。
下面三件事值得说清:我当初为什么这么选、钱到底花在哪、以及下次用什么数字一秒判断该不该换------最后那个数字,你现在就可以算出来。
二、我是怎么"省钱"的
我的使用场景很典型:跑 Agent,一个会话动辄几千万 token,上下文不断累加。高峰时段(9--12 点、14--18 点)我写了个定时任务,把默认模型切到另一家的 flash 版本。
选它的理由就三条:
- 输入单价比原方案便宜 25%
- 输出单价比原方案便宜 35%
- 名字里带 flash,官方定位就是"轻量高性价比"
按这个算法,高峰时段应该省下约三成的钱。两个月后我去拉了账单。
三、账单摊开:它不是免费的
我一直以为它在高峰时段是免费的------因为这个模型名字里带 "flash",很多平台的 flash 档都有免费额度。直到我把明细表拉下来,才知道自己错了两个月。
按用量结构还原,9 月到 10 月 22 日的总消耗 4.94 亿 token,其中主力模型贡献 98.8%,这部分是实打实计费的。
这里有个细节值得单说:我这套调度工具本地没有这家 provider 的定价表 ,所以它记的费用恒为 0。我在控制台里看了两周的"花费 ¥0",真以为它是免费的。直到我去平台后台拉了明细表。
四、钱到底花在哪:三个价格列,只有一行重要
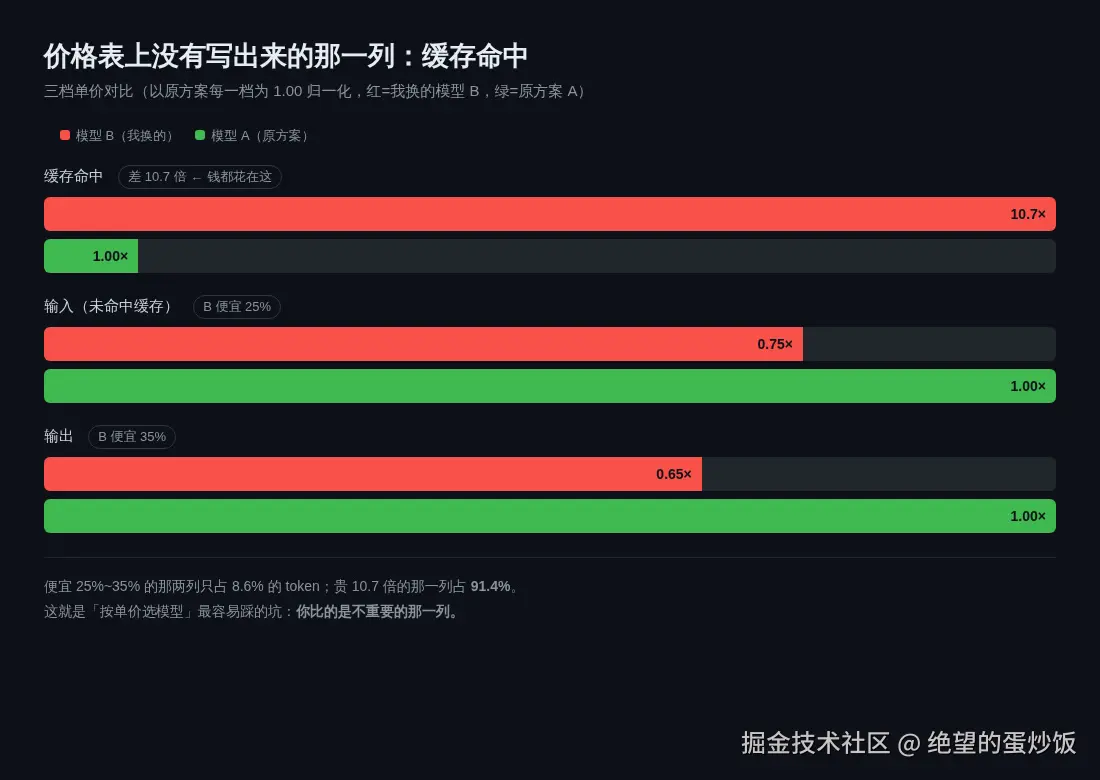
| 类型 | 模型 B(我换的) | 模型 A(原方案) | 谁便宜 |
|---|---|---|---|
| 缓存命中 | 贵 | 便宜 10.7 倍 | 原方案 |
| 输入(未命中缓存) | 便宜 25% | 贵 | 我换的 |
| 输出 | 便宜 35% | 贵 | 我换的 |
我在选型时比对的那两行,确实更便宜。但它们在真实用量里只占 8.6%,而贵 10.7 倍的那一行占了 91.4%。
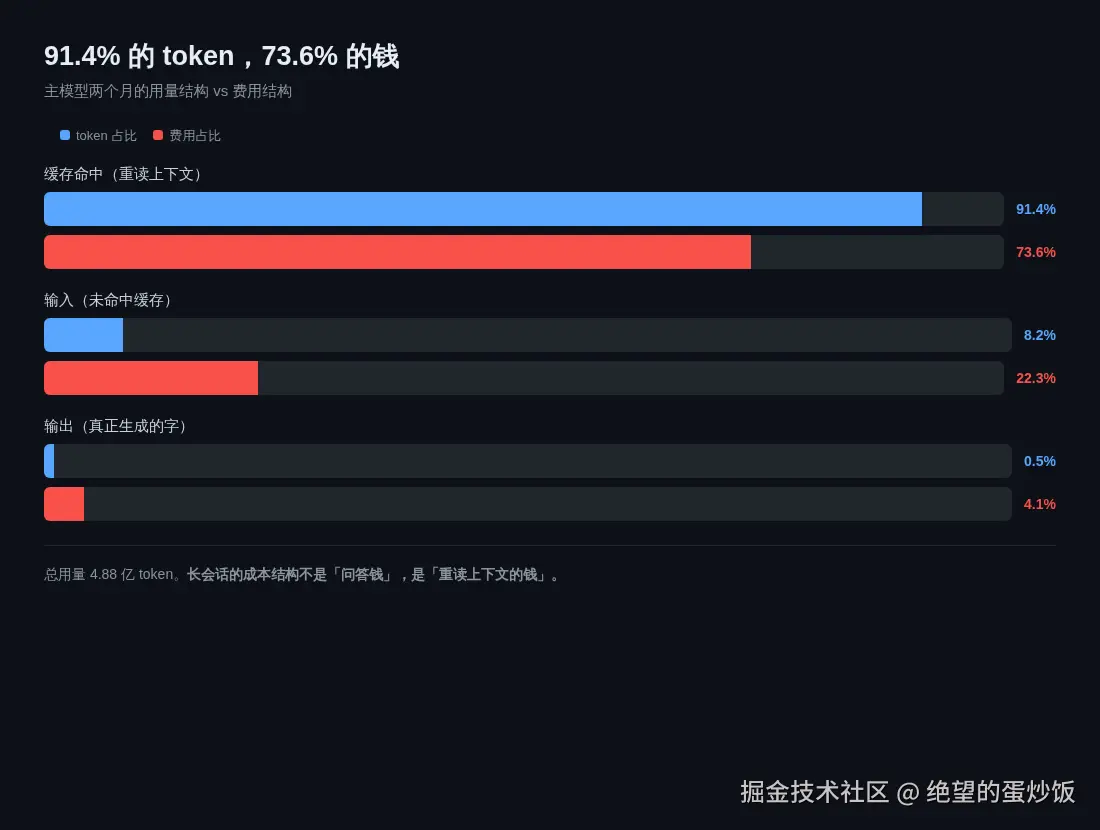
| 类型 | token 占比 | 费用占比 |
|---|---|---|
| 缓存命中 | 91.4% | 73.6% |
| 输入 | 8.2% | 22.3% |
| 输出 | 0.5% | 4.1% |
长会话的成本结构不是「问答钱」,是「重读上下文的钱」。
五、换成一个可判定的公式
上面的结论不用背,把它画成曲线就行------两条线交叉的那个点,就是「该不该换」的分界线。
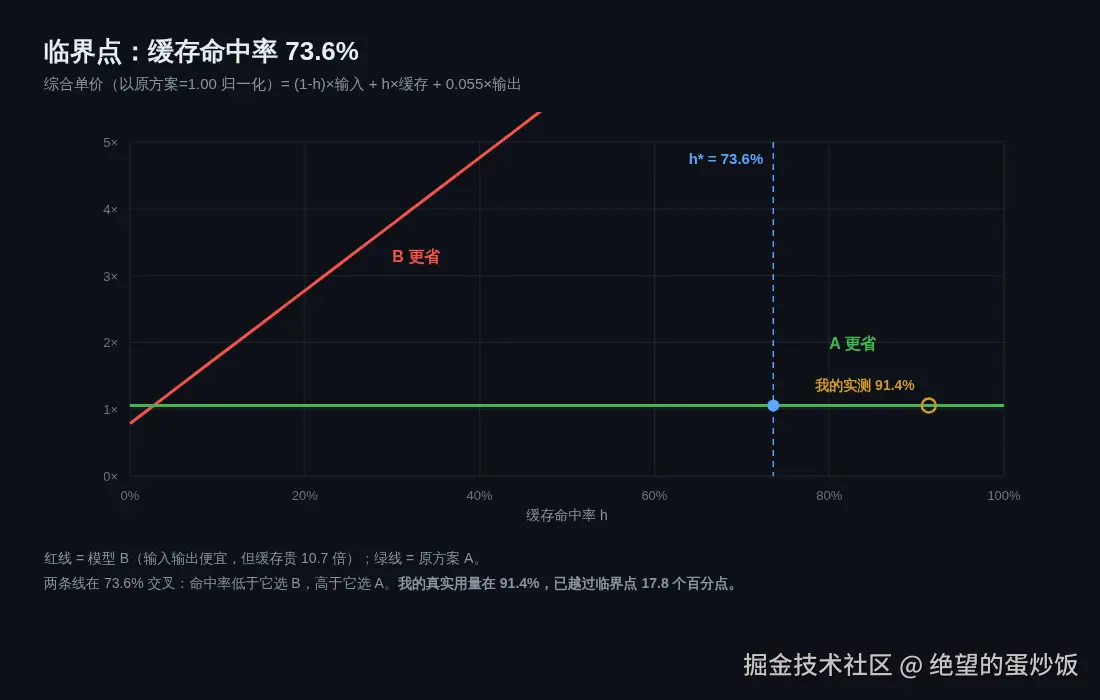
设缓存命中率 h,输出/输入比 r,某模型的三档单价为 c_cache / c_in / c_out,则每个「输入类 token」的综合成本:
scss
cost(h) = (1 - h) × c_in + h × c_cache + r × c_out我这次的实测参数:r = 0.055,h = 0.914。两个方案的综合单价,以原方案为 1.00 归一:
| 缓存命中率 h | 模型 B(我换的) | 模型 A(原方案) | 谁便宜 |
|---|---|---|---|
| 0% | 0.73 | 1.00 | B 便宜 27% |
| 40% | 0.82 | 1.00 | B 便宜 18% |
| 60% | 0.90 | 1.00 | B 便宜 10% |
| 73.6% | 1.00 | 1.00 | 打平(临界点) |
| 91.4%(我的实测) | 1.25 | 1.00 | A 便宜 20% |
| 100% | 1.49 | 1.00 | A 便宜 33% |
临界命中率 73.6%。 只要缓存命中率高过它,"输入便宜 25%"这个优势就会被"缓存贵 10.7 倍"完全吃掉。我实测 91.4%,越过临界点 17.8 个百分点。
六、决策表:什么时候换模型真能省钱
先看流程图,四个问题就能定结局:
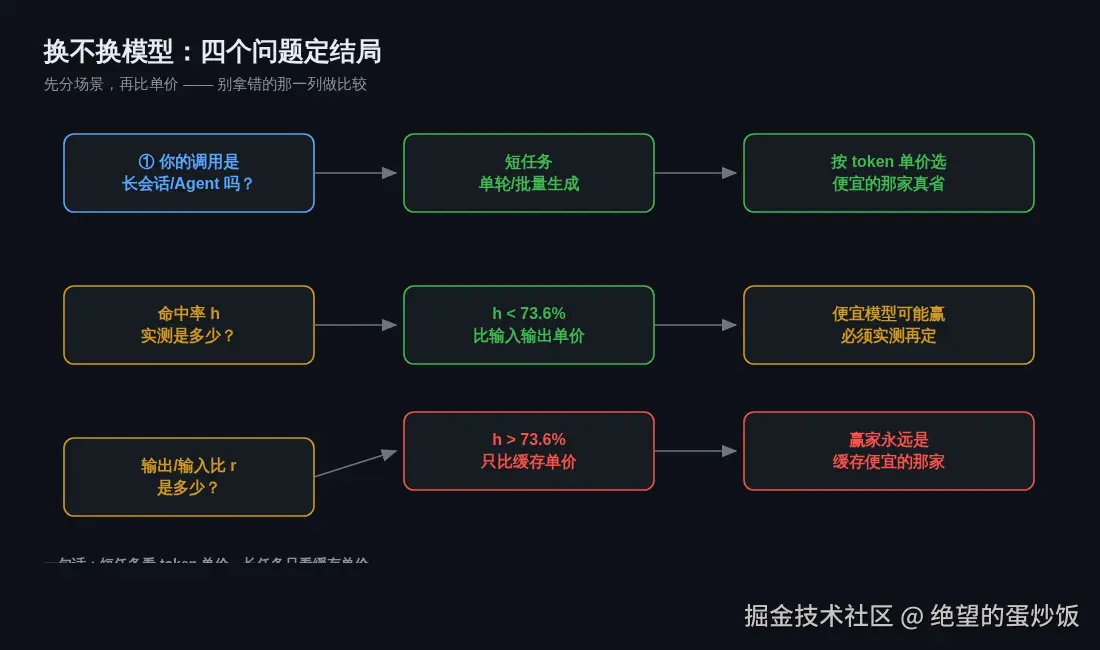
| 你的场景 | 缓存命中率典型值 | 结论 |
|---|---|---|
| 单轮问答、客服、批量生成 | 0--20% | 按输入/输出单价选,便宜的那家真能省 |
| 多轮对话(3--10 轮) | 40--70% | 看具体单价,接近临界点,必须实测 |
| Agent / 长上下文 / 代码库问答 | 85--97% | 只看缓存单价,输入输出便宜没用 |
| 完全相同的长 system prompt 反复调用 | ~100% | 缓存单价低的那家压倒性赢 |
一句话:短任务看 token 单价,长任务看缓存单价。
七、两个工程教训
1. 成本监控必须能对到账单
自建监控的 estimated_cost 在两种情况下会变成假数字:
- 本地定价表里没有这个 provider → 恒记 0,看着像免费
- 不同计费档位没拆分(比如按量价 vs 资源包抵扣 vs 分长度区间)→ 记出来的数只是标价复算
验法 :每周拿一张平台明细表,按「模型 × 价格类型(缓存/输入/输出)」交叉核对。对不上就说明你的定价表过期了。我给自己的断言是:标价复算值与账单金额相差超过 10% 就要查。
2. 缓存命中率是新的关键性能指标
以前我会盯 QPS、首字延迟、上下文长度。现在第一个看的是 缓存命中率:
- 命中率高 → 省钱,但一旦切换模型,缓存全部作废(跨 provider 缓存不通用)
- 频繁切模型 = 频繁丢掉缓存 = 每次都要付全价输入
所以"按时间段切模型省钱"这个策略,在长会话场景下天然是负收益 ------它不仅换了单价,还换了缓存池。我这次的账单就是这条规律的实证:省下的输入输出钱抵不过缓存损失 + 重新预热的钱。
八、我最后怎么处理的
- 把四个切模型的定时任务全停掉,只留一家
- 把配置里的"故障自动转备用 provider"也清空------否则主 provider 抖动时会静默切到计费未知的那家
- 定价表补齐之前不做选型对比,先看账单再谈性价比
- 留一条基线:现在只跑单一 provider,30 天花费固定在一个基数上,之后任何"优化"都对着这条线量,不要再凭单价表下结论
最后一句 :模型选型最容易犯的错不是选贵了或选便宜了,而是拿错的那一列做比较。价格表上有三列,你用来做决策的那一列,最好是真实用量占比最高的那一列。