上一篇讲了 Flink ResourceManager 的启动流程,RM 启动后会管理 Slot 和 TaskManager。这篇聚焦 Dispatcher------Flink 集群的作业分发器。你有没有想过,一条 flink run 命令提交的 JobGraph,是如何到达集群并启动作业的?Dispatcher 内部依次初始化了哪些组件?JobManagerRunner 是如何被创建和启动的?Application 模式下用户 main 为什么在 Dispatcher 启动时执行?这篇从 ClusterEntrypoint 创建 Dispatcher 讲起,深入 Dispatcher 内部启动流程,剖析 Dispatcher、StandaloneDispatcher、ApplicationDispatcher、JobManagerRunnerFactory、JobGraphStore、DispatcherBootstrap 等核心类的源码,把 Dispatcher 从创建到作业提交的完整链路讲透。
一、Dispatcher 整体架构
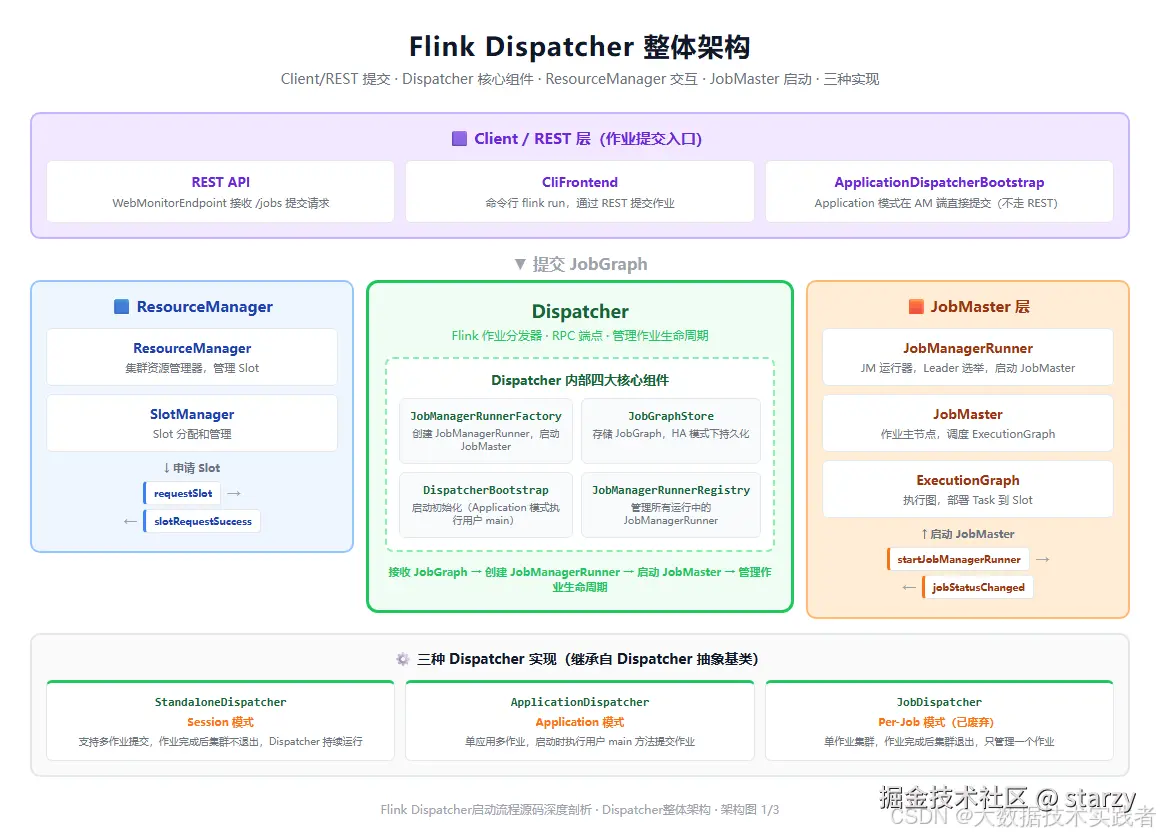
下面这张图是 Flink Dispatcher 整体架构,包括 Client/REST 提交层、Dispatcher 核心组件、ResourceManager 交互、JobMaster 启动,以及三种 Dispatcher 实现。
1.1 Dispatcher 在 Flink 集群中的定位
Dispatcher 是 Flink 集群的作业分发器,负责:
- 接收客户端提交的 JobGraph(通过 REST API 或直接调用)
- 创建并启动 JobManagerRunner,由 JobManagerRunner 启动 JobMaster
- 管理所有运行中作业的生命周期(创建、启动、状态监控、清理)
- HA 模式下持久化 JobGraph,故障恢复时重建作业
- Application 模式下执行用户 main 方法,构建并提交 JobGraph
Dispatcher 不负责资源管理(那是 ResourceManager 的工作),也不负责作业调度(那是 JobMaster 的工作)。Dispatcher 是作业提交的入口和生命周期管理者,在 Client 和 JobMaster 之间架起一座桥梁。
1.2 Dispatcher 内部四大核心组件
Dispatcher 内部有四个核心组件,各司其职:
JobManagerRunnerFactory:创建 JobManagerRunner 的工厂类。Dispatcher 接收到 JobGraph 后,调用工厂的 createJobManagerRunner 方法创建 JobManagerRunnerImpl 实例,传入 JobGraph、配置、HA 服务等。
JobGraphStore:JobGraph 存储服务。HA 模式下将已提交的 JobGraph 持久化到 ZooKeeper 或 K8s ConfigMap,Dispatcher 重启或 Leader 切换时从存储恢复已提交但未完成的作业,重新启动 JobManagerRunner。
DispatcherBootstrap:Dispatcher 启动初始化器。Standalone 模式下是空实现;Application 模式下是 ApplicationDispatcherBootstrap,在 Dispatcher 启动后通过反射执行用户 main 方法,构建 JobGraph 并直接提交给 Dispatcher(不走 REST API)。
JobManagerRunnerRegistry:JobManagerRunner 注册表。管理所有运行中的 JobManagerRunner,提供注册、注销、查询、关闭等接口,确保作业完成后资源被正确释放。
1.3 三种 Dispatcher 实现
Flink 有三种 Dispatcher 实现,对应不同的部署模式:
| 实现类 | 部署模式 | 特点 |
|---|---|---|
| StandaloneDispatcher | Session 模式 | 支持多作业提交,作业完成后集群不退出,Dispatcher 持续运行接收新作业 |
| ApplicationDispatcher | Application 模式 | 单应用多作业,启动时执行用户 main 方法提交作业,所有作业完成后可选择退出 |
| JobDispatcher | Per-Job 模式 | 单作业集群(已废弃),作业完成后集群退出,Dispatcher 只管理一个作业 |
三种实现都继承自 Dispatcher 抽象基类,复用通用的作业提交、JobManagerRunner 管理、JobGraphStore 恢复逻辑,只在 DispatcherBootstrap 和集群退出策略上有差异。
二、ClusterEntrypoint 创建 Dispatcher 流程
Dispatcher 的创建始于 ClusterEntrypoint.startCluster(),这是所有 Flink 集群入口的标准启动流程。
2.1 八步创建流程
java
public abstract class ClusterEntrypoint implements AutoCloseable {
    public void startCluster() throws Exception {
        try {
            // 1. 初始化基础组件
            pluginManager = PluginUtils.createPluginManager(...);
            FileSystem.initialize(configuration, pluginManager);
            SecurityUtils.install(new SecurityConfiguration(configuration));
            MetricRegistry metricRegistry = createMetricRegistry(configuration);

            // 2. 启动 RPC 服务
            rpcService = createRpcService(configuration);

            // 3. 启动 HA 服务
            haServices = createHaServices(configuration, rpcService);

            // 4. 启动 BlobServer
            blobServer = new BlobServer(configuration, haServices.createBlobStore());

            // 5. 启动 ResourceManager(必须在 Dispatcher 之前)
            resourceManager = createResourceManager(...);
            resourceManager.start();

            // 6. 创建 Dispatcher
            dispatcher = createDispatcher(...);
            dispatcher.start();

            // 7. 启动 REST 端点
            webMonitorEndpoint = createRestEndpoint(...);
            webMonitorEndpoint.start();

        } catch (Exception e) {
            throw new FlinkException("Could not start cluster entrypoint.", e);
        }
    }

    protected abstract Dispatcher createDispatcher(...);
}
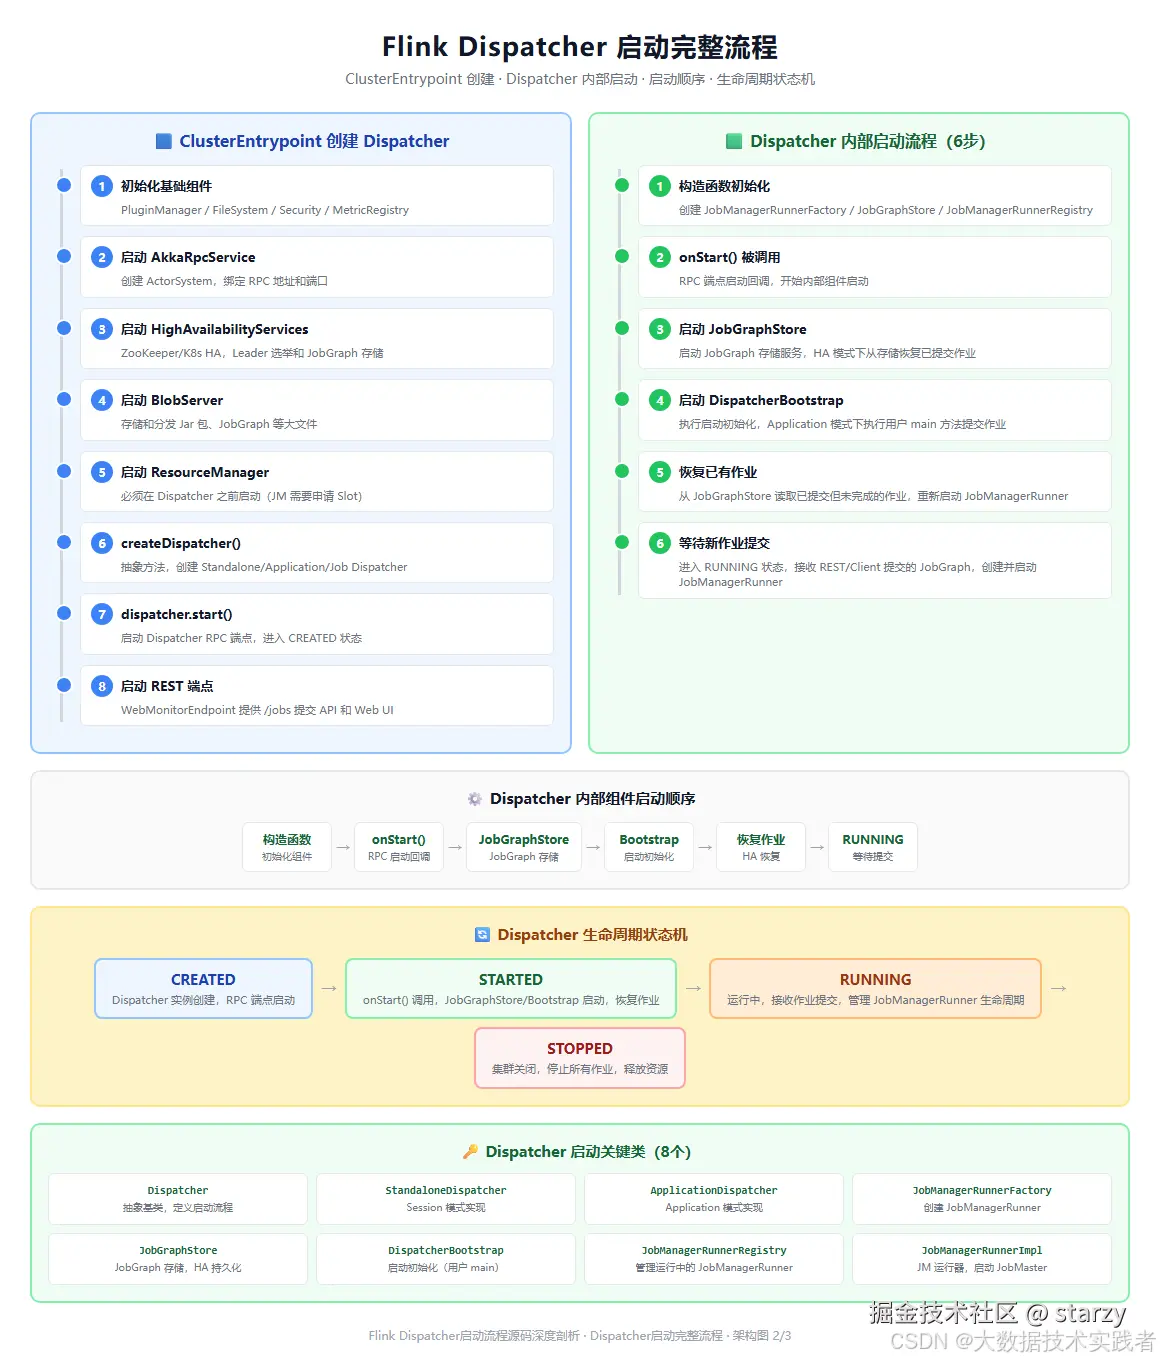
关键顺序:基础组件 → RPC → HA → BlobServer → ResourceManager → Dispatcher → REST。
为什么 ResourceManager 必须在 Dispatcher 之前启动?因为 Dispatcher 启动 JobManagerRunner 后,JobMaster 需要向 ResourceManager 申请 Slot。如果 RM 还没启动,JM 的 Slot 请求就会失败。所以启动顺序是严格的:先有资源管理者,再有作业分发者,最后有 REST 接口。
2.2 createDispatcher 抽象方法
createDispatcher 是抽象方法,由具体的 ClusterEntrypoint 子类实现:
java
// YarnApplicationClusterEntrypoint
@Override
protected Dispatcher createDispatcher(
        Configuration configuration,
        RpcService rpcService,
        HighAvailabilityServices haServices,
        ResourceManagerGateway resourceManagerGateway,
        BlobServer blobServer,
        HeartbeatServices heartbeatServices,
        ...) throws Exception {
    // Application 模式:创建 ApplicationDispatcher + ApplicationDispatcherBootstrap
    final ApplicationDispatcherBootstrap bootstrap =
        new ApplicationDispatcherBootstrap(
            applicationConfiguration.getJobClassName(),
            applicationConfiguration.getProgramArgs(),
            applicationConfiguration.getSavepointPath());

    return new ApplicationDispatcher(
        rpcService,
        haServices.getDispatcherLeaderElection(),
        ...
        bootstrap);
}
YARN Application 模式下创建 ApplicationDispatcher,并传入 ApplicationDispatcherBootstrap(用于执行用户 main)。Standalone/Session 模式下创建 StandaloneDispatcher,传入空的 DispatcherBootstrap。
三、Dispatcher 内部启动流程源码
Dispatcher 实例创建后,调用 dispatcher.start() 启动 RPC 端点,随后触发内部组件启动。下面这张图是 Dispatcher 启动完整流程,包括 ClusterEntrypoint 创建 Dispatcher 8步、Dispatcher 内部启动6步、启动顺序横条、生命周期状态机和8个关键类。
3.1 构造函数初始化
java
public abstract class Dispatcher extends FencedRpcEndpoint<DispatcherId>
        implements DispatcherGateway {

    private final Configuration configuration;
    private final RpcService rpcService;
    private final HighAvailabilityServices haServices;
    private final ResourceManagerGateway resourceManagerGateway;

    private final JobManagerRunnerFactory jobManagerRunnerFactory;
    private final JobGraphStore jobGraphStore;
    private final JobManagerRunnerRegistry jobManagerRunnerRegistry;
    private final DispatcherBootstrap dispatcherBootstrap;

    private final Map<JobID, JobManagerRunner> runningJobs;
    private final Map<JobID, CompletableFuture<JobManagerRunner>> pendingJobManagerRunners;

    public Dispatcher(
            RpcService rpcService,
            DispatcherId fencingToken,
            Configuration configuration,
            HighAvailabilityServices haServices,
            ResourceManagerGateway resourceManagerGateway,
            JobManagerRunnerFactory jobManagerRunnerFactory,
            JobGraphStore jobGraphStore,
            JobManagerRunnerRegistry jobManagerRunnerRegistry,
            DispatcherBootstrap dispatcherBootstrap,
            ...) {
        super(rpcService, fencingToken);
        this.configuration = configuration;
        this.rpcService = rpcService;
        this.haServices = haServices;
        this.resourceManagerGateway = resourceManagerGateway;
        this.jobManagerRunnerFactory = jobManagerRunnerFactory;
        this.jobGraphStore = jobGraphStore;
        this.jobManagerRunnerRegistry = jobManagerRunnerRegistry;
        this.dispatcherBootstrap = dispatcherBootstrap;

        this.runningJobs = new HashMap<>();
        this.pendingJobManagerRunners = new HashMap<>();
    }
}
构造函数中初始化了四个核心组件:JobManagerRunnerFactory、JobGraphStore、JobManagerRunnerRegistry、DispatcherBootstrap。同时初始化了 runningJobs(运行中作业集合)和 pendingJobManagerRunners(待启动的 JobManagerRunner 异步创建集合)。
3.2 onStart() 内部启动
java
@Override
public void onStart() throws Exception {
    try {
        // 1. 启动 JobGraphStore
        jobGraphStore.start(new JobGraphStoreListener() {
            @Override
            public void onAddedJobGraph(JobID jobId) {
                // JobGraph 被添加时触发(HA 恢复)
                runRecoveredJob(jobId);
            }
            @Override
            public void onRemovedJobGraph(JobID jobId) {
                // JobGraph 被移除时触发
                removeJob(jobId);
            }
        });

        // 2. 启动 DispatcherBootstrap
        dispatcherBootstrap.initialize(
            new DispatcherBootstrap.DispatcherGatewayProvider() {
                @Override
                public DispatcherGateway getDispatcherGateway() {
                    return getSelfGateway(DispatcherGateway.class);
                }
            },
            new FatalErrorHandler() {
                @Override
                public void onFatalError(Throwable throwable) {
                    onFatalError(throwable);
                }
            });

        // 3. 恢复已有作业(从 JobGraphStore 读取)
        recoverJobs();

    } catch (Exception e) {
        throw new DispatcherException("Could not start the Dispatcher.", e);
    }
}
onStart() 是 Dispatcher 内部启动的核心,三步:
第1步:启动 JobGraphStore:启动 JobGraph 存储服务,注册监听器。当 JobGraph 被添加或移除时触发回调,用于 HA 模式下的作业恢复。
第2步:启动 DispatcherBootstrap:执行启动初始化。Standalone 模式下是空操作;Application 模式下 ApplicationDispatcherBootstrap 通过反射执行用户 main 方法,构建 JobGraph 并直接提交给 Dispatcher。
第3步:恢复已有作业:从 JobGraphStore 读取所有已提交但未完成的 JobGraph,为每个作业创建并启动 JobManagerRunner,实现 HA 故障恢复。
3.3 作业提交内部逻辑
java
@Override
public CompletableFuture<Acknowledge> submitJob(JobGraph jobGraph, Time timeout) {
    final JobID jobId = jobGraph.getJobID();

    // 1. 检查作业是否已存在
    if (runningJobs.containsKey(jobId) || pendingJobManagerRunners.containsKey(jobId)) {
        return FutureUtils.completedExceptionally(
            new JobSubmissionException(jobId, "Job has already been submitted."));
    }

    // 2. 将 JobGraph 存入 JobGraphStore(HA 持久化)
    final CompletableFuture<Void> jobGraphStoredFuture =
        CompletableFuture.runAsync(() -> {
            try {
                jobGraphStore.putJobGraph(jobGraph);
            } catch (Exception e) {
                throw new CompletionException(e);
            }
        }, getRpcService().getExecutor());

    // 3. 创建并启动 JobManagerRunner
    final CompletableFuture<JobManagerRunner> jobManagerRunnerFuture =
        jobGraphStoredFuture.thenApplyAsync(
            ignored -> {
                try {
                    return createJobManagerRunner(jobGraph);
                } catch (Exception e) {
                    throw new CompletionException(e);
                }
            }, getRpcService().getExecutor());

    // 4. 注册到 pendingJobManagerRunners
    pendingJobManagerRunners.put(jobId, jobManagerRunnerFuture);

    // 5. 启动 JobManagerRunner
    jobManagerRunnerFuture.thenAcceptAsync(
        jobManagerRunner -> {
            pendingJobManagerRunners.remove(jobId);
            runningJobs.put(jobId, jobManagerRunner);
            jobManagerRunner.start();
        }, getMainThreadExecutor());

    return CompletableFuture.completedFuture(Acknowledge.get());
}
作业提交的关键步骤:
- 检查作业是否已提交(去重)
- 将 JobGraph 存入 JobGraphStore(HA 持久化)
- 异步创建 JobManagerRunner
- 注册到 pendingJobManagerRunners(防止重复创建)
- 启动 JobManagerRunner,加入 runningJobs
3.4 Dispatcher 生命周期状态机
Dispatcher 有清晰的生命周期状态:
sql
CREATED → STARTED → RUNNING → STOPPED- CREATED:Dispatcher 实例创建,RPC 端点启动
- STARTED:onStart() 调用,JobGraphStore/Bootstrap 启动,恢复作业
- RUNNING:运行中,接收作业提交,管理 JobManagerRunner 生命周期
- STOPPED:集群关闭,停止所有作业,释放资源
四、核心类源码剖析
4.1 ApplicationDispatcherBootstrap
ApplicationDispatcherBootstrap 是 Application 模式的核心,负责在 AM 端执行用户 main 方法:
java
public class ApplicationDispatcherBootstrap implements DispatcherBootstrap {
    private final String jobClassName;
    private final String[] programArgs;
    private final String savepointPath;

    @Override
    public void initialize(
            DispatcherGatewayProvider dispatcherGatewayProvider,
            FatalErrorHandler fatalErrorHandler) {
        try {
            // 1. 加载用户作业入口类
            Class<?> mainClass = Class.forName(
                jobClassName, true, Thread.currentThread().getContextClassLoader());

            // 2. 获取 main 方法
            Method mainMethod = mainClass.getMethod("main", String[].class);

            // 3. 通过反射执行用户 main 方法
            // 用户 main 内部会调用 env.execute(),构建 JobGraph 并提交给 Dispatcher
            mainMethod.invoke(null, (Object) programArgs);

        } catch (Exception e) {
            fatalErrorHandler.onFatalError(
                new FlinkException("Failed to execute application main method.", e));
        }
    }
}
关键逻辑:
- Class.forName 加载用户作业入口类
- 反射调用 main 方法,传入程序参数
- 用户 main 内部创建 StreamExecutionEnvironment,调用 env.execute() 构建 JobGraph
- JobGraph 通过本地 DispatcherGateway 提交(不走 REST API,直接内存调用)
- main 方法执行失败调用 fatalErrorHandler,Dispatcher 进程退出
这就是 Application 模式的核心:用户 main 在 AM 端的 Dispatcher 启动时执行,客户端只需上传 Jar,不构建 JobGraph,大幅降低客户端负载。
4.2 JobManagerRunnerFactory
JobManagerRunnerFactory 负责创建 JobManagerRunner:
java
public class JobManagerRunnerFactory {
    private final Configuration configuration;
    private final HighAvailabilityServices haServices;
    private final ResourceManagerGateway resourceManagerGateway;
    private final BlobServer blobServer;
    private final HeartbeatServices heartbeatServices;

    public JobManagerRunner createJobManagerRunner(
            JobGraph jobGraph,
            ...) throws Exception {
        // 1. 创建 JobManagerSharedServices(共享服务:库缓存、文件系统等)
        final JobManagerSharedServices jobManagerSharedServices =
            new JobManagerSharedServices(...);

        // 2. 创建 JobManagerRunnerImpl
        final JobManagerRunnerImpl jobManagerRunner = new JobManagerRunnerImpl(
            jobGraph,
            configuration,
            haServices,
            resourceManagerGateway,
            blobServer,
            heartbeatServices,
            jobManagerSharedServices,
            ...);

        return jobManagerRunner;
    }
}
JobManagerRunnerFactory 创建 JobManagerRunnerImpl,传入 JobGraph、配置、HA 服务、ResourceManagerGateway 等。JobManagerRunnerImpl 负责 Leader 选举和 JobMaster 启动。
4.3 JobGraphStore
JobGraphStore 负责 JobGraph 的持久化存储:
java
public interface JobGraphStore {
    void start(JobGraphStoreListener listener) throws Exception;
    void stop() throws Exception;

    // 存储 JobGraph
    void putJobGraph(JobGraph jobGraph) throws Exception;

    // 获取 JobGraph
    JobGraph recoverJobGraph(JobID jobId) throws Exception;

    // 获取所有已存储的 JobGraph ID
    Collection<JobID> getJobIds() throws Exception;

    // 删除 JobGraph
    void removeJobGraph(JobID jobId) throws Exception;

    interface JobGraphStoreListener {
        void onAddedJobGraph(JobID jobId);
        void onRemovedJobGraph(JobID jobId);
    }
}
ZooKeeper 实现将 JobGraph 序列化后存储在 ZooKeeper znode 中;K8s 实现存储在 ConfigMap 中。Dispatcher 启动时调用 recoverJobs() 从 JobGraphStore 读取所有已提交的 JobGraph,为每个未完成的作业重新创建 JobManagerRunner。
五、作业提交流程与 JobManagerRunner 生命周期
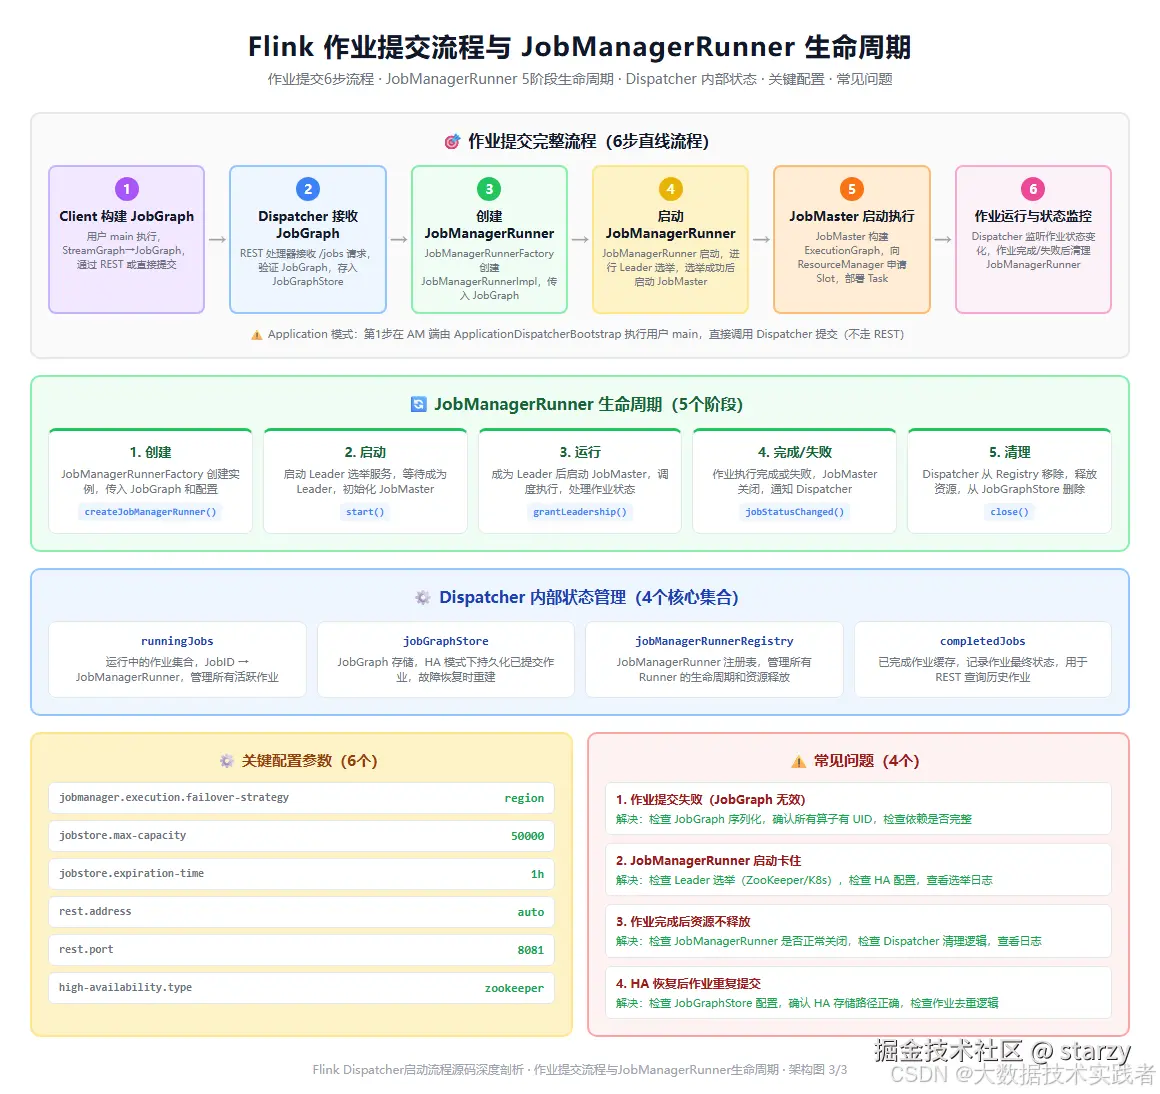
下面这张图是作业提交流程与 JobManagerRunner 生命周期,包括作业提交6步直线流程、JobManagerRunner 5阶段生命周期、Dispatcher 内部4个状态集合、关键配置和常见问题。
5.1 作业提交6步流程
作业提交是 Dispatcher 最核心的功能,完整流程6步:
第1步:Client 构建 JobGraph:用户 main 方法执行,创建 StreamExecutionEnvironment,添加 Source/Transformation/Sink,调用 env.execute() 触发 StreamGraph→JobGraph 构建。Session 模式下在客户端构建,通过 REST 提交;Application 模式下在 AM 端构建,直接提交。
第2步:Dispatcher 接收 JobGraph:REST 处理器接收 /jobs 请求(Session 模式),或 ApplicationDispatcherBootstrap 直接调用 submitJob(Application 模式)。验证 JobGraph 有效性,检查是否重复提交。
第3步:创建 JobManagerRunner:JobManagerRunnerFactory 创建 JobManagerRunnerImpl,传入 JobGraph、配置、HA 服务、ResourceManagerGateway。异步创建,避免阻塞 RPC 线程。
第4步:启动 JobManagerRunner:JobManagerRunner 启动,进行 Leader 选举(HA 模式),选举成功后启动 JobMaster。JobMaster 构建 ExecutionGraph,初始化 SlotPool。
第5步:JobMaster 启动执行:JobMaster 向 ResourceManager 申请 Slot,Slot 分配后部署 Task 到 TaskManager,作业开始运行。JobMaster 定期向 Dispatcher 上报作业状态。
第6步:作业运行与状态监控:Dispatcher 监听作业状态变化(jobStatusChanged),作业完成或失败后清理 JobManagerRunner,从 runningJobs 移除,从 JobGraphStore 删除,释放资源。
5.2 JobManagerRunner 生命周期
JobManagerRunner 有5个生命周期阶段:
1. 创建:JobManagerRunnerFactory 创建实例,传入 JobGraph 和配置。此时还未启动,不占用资源。
2. 启动:调用 start() 方法,启动 Leader 选举服务,等待成为 Leader。HA 模式下可能有多个 JobManagerRunner 实例(Standby),只有一个能成为 Leader。
3. 运行:成为 Leader 后(grantLeadership 回调),启动 JobMaster,构建 ExecutionGraph,申请 Slot,部署 Task,作业正式运行。
4. 完成/失败:作业执行完成(FINISHED)或失败(FAILED),JobMaster 关闭,通知 Dispatcher 作业状态变化。
5. 清理:Dispatcher 从 JobManagerRunnerRegistry 移除,调用 close() 释放资源,从 JobGraphStore 删除 JobGraph,清理临时文件。
5.3 Dispatcher 内部状态管理
Dispatcher 维护4个核心状态集合:
- runningJobs:运行中的作业集合,JobID → JobManagerRunner,管理所有活跃作业
- jobGraphStore:JobGraph 存储,HA 模式下持久化已提交作业,故障恢复时重建
- jobManagerRunnerRegistry:JobManagerRunner 注册表,管理所有 Runner 的生命周期和资源释放
- completedJobs:已完成作业缓存,记录作业最终状态,用于 REST 查询历史作业
六、关键配置参数
yaml
# 故障恢复策略(region:只重启受影响区域;full:重启整个作业)
jobmanager.execution.failover-strategy: region

# JobGraph 存储最大容量(已完成作业缓存数量)
jobstore.max-capacity: 50000

# JobGraph 存储过期时间(已完成作业保留时长)
jobstore.expiration-time: 1h

# REST API 地址(自动获取)
rest.address: auto

# REST API 端口
rest.port: 8081

# REST 绑定端口范围(避免端口冲突)
rest.bind-port: 8081-8090

# HA 类型(zookeeper/kubernetes/none)
high-availability.type: zookeeper

# ZooKeeper 集群地址
high-availability.zookeeper.quorum: zk1:2181,zk2:2181,zk3:2181

# HA 存储目录(JobGraph 和元数据持久化)
high-availability.storageDir: hdfs:///flink/ha

# Dispatcher 空闲超时(Application 模式,所有作业完成后等待时间)
dispatcher.idle-timeout: 0s
关键配置说明:
jobmanager.execution.failover-strategy:故障恢复策略,region 只重启受影响区域,生产环境用 regionjobstore.max-capacity / expiration-time:已完成作业缓存的容量和过期时间,用于 REST 查询历史rest.port / rest.bind-port:REST API 端口,生产环境建议配置端口范围避免冲突high-availability.type / storageDir:HA 配置,生产环境必须配置,确保 Dispatcher 故障后作业可恢复dispatcher.idle-timeout:Application 模式下所有作业完成后的等待时间,0 表示立即退出
七、常见问题与最佳实践
7.1 常见问题
问题1:作业提交失败(JobGraph 无效)
- 原因:JobGraph 序列化失败,算子没有 UID,依赖缺失,类加载冲突
- 解决:为所有算子指定 UID,使用 maven-shade 打包依赖,检查类加载顺序(classloader.resolve-order)
问题2:JobManagerRunner 启动卡住
- 原因:Leader 选举失败(ZooKeeper 连接问题),HA 配置错误,JobMaster 初始化失败
- 解决:检查 ZooKeeper 集群状态,确认 high-availability 配置,查看 JobManager 日志
问题3:作业完成后资源不释放
- 原因:JobManagerRunner 未正常关闭,Dispatcher 清理逻辑异常,Slot 未释放
- 解决:检查作业状态是否正常结束,查看 Dispatcher 日志,检查 ResourceManager Slot 释放
问题4:HA 恢复后作业重复提交
- 原因:JobGraphStore 配置错误,HA 存储路径不一致,作业去重逻辑失效
- 解决:检查 high-availability.storageDir 配置,确认所有 JM 使用相同存储路径,检查 JobGraph 去重
7.2 最佳实践
1. 为所有算子指定 UID:生产环境必须为所有算子指定 uid(),确保 JobGraph 序列化和 Savepoint 恢复时算子状态正确映射。缺少 UID 可能导致作业提交失败或状态恢复错误。
2. 配置 HA 高可用:生产环境必须配置 ZooKeeper 或 K8s HA,设置 high-availability.storageDir,确保 Dispatcher 故障后已提交作业可自动恢复。JobGraphStore 是 HA 恢复的关键。
3. 使用 Application 模式:生产环境推荐 Application 模式,用户 main 在 AM 端执行,客户端负载低,作业隔离性好。Session 模式适合开发测试和频繁提交小作业的场景。
4. 监控 Dispatcher 指标:关注 Dispatcher 的运行中作业数、待提交作业数、JobManagerRunner 创建成功率、作业完成/失败率。配置 Prometheus 指标上报和告警,及时发现作业提交异常。
5. 合理配置作业缓存:jobstore.max-capacity 和 expiration-time 控制已完成作业的缓存数量和保留时间。生产环境根据作业量合理配置,避免内存溢出,同时保留足够的历史查询能力。
6. 优化作业提交性能:大作业的 JobGraph 构建可能耗时较长,Application 模式下在 AM 端构建可避免网络传输。使用 maven-shade 打包 fat jar,减少类加载冲突。避免在 main 方法中执行耗时操作。
八、总结
Flink Dispatcher 启动流程源码深度剖析要点回顾:
第一,Dispatcher 整体架构是理解的基础。Dispatcher 是 Flink 集群的作业分发器,内部四大核心组件:JobManagerRunnerFactory(创建 JobManagerRunner)、JobGraphStore(JobGraph 持久化存储)、DispatcherBootstrap(启动初始化,Application 模式执行用户 main)、JobManagerRunnerRegistry(Runner 注册表)。三种实现:StandaloneDispatcher(Session 模式)、ApplicationDispatcher(Application 模式)、JobDispatcher(Per-Job 模式,已废弃)。
第二,ClusterEntrypoint 创建 Dispatcher 流程是八步标准流程:基础组件 → RPC → HA → BlobServer → ResourceManager → Dispatcher → REST。ResourceManager 必须在 Dispatcher 之前启动,因为 JobMaster 启动后需要向 RM 申请 Slot。createDispatcher 是抽象方法,由具体 ClusterEntrypoint 子类实现。
第三,Dispatcher 内部启动流程是三步:构造函数初始化四大组件 → onStart() 启动 JobGraphStore/DispatcherBootstrap/恢复作业 → 等待新作业提交。作业提交内部逻辑:检查去重 → 存入 JobGraphStore → 异步创建 JobManagerRunner → 注册 pending → 启动并加入 runningJobs。Dispatcher 生命周期:CREATED → STARTED → RUNNING → STOPPED。
第四,核心类源码是理解实现的关键。ApplicationDispatcherBootstrap 通过反射执行用户 main 方法,是 Application 模式的核心,用户 main 构建 JobGraph 后直接提交给 Dispatcher(不走 REST)。JobManagerRunnerFactory 创建 JobManagerRunnerImpl,传入 JobGraph 和配置。JobGraphStore 负责 JobGraph 持久化,ZooKeeper/K8s 实现,Dispatcher 启动时从存储恢复已提交作业。
第五,作业提交流程与 JobManagerRunner 生命周期是 Dispatcher 的核心功能。作业提交6步:Client 构建 JobGraph → Dispatcher 接收 → 创建 JobManagerRunner → 启动 JobManagerRunner → JobMaster 启动执行 → 作业运行与状态监控。JobManagerRunner 5阶段:创建 → 启动(Leader 选举)→ 运行(启动 JobMaster)→ 完成/失败 → 清理。Dispatcher 维护4个状态集合:runningJobs、jobGraphStore、jobManagerRunnerRegistry、completedJobs。
理解 Flink Dispatcher,不仅能帮助排查作业提交失败、JobManagerRunner 启动卡住等常见问题,更能体会到 Flink 作业管理的分层设计------Client 负责构建 JobGraph,Dispatcher 负责作业生命周期管理,JobManagerRunner 负责 Leader 选举和 JobMaster 启动,JobMaster 负责作业调度执行,ResourceManager 负责 Slot 资源分配。五者通过 JobGraph 和 Slot 机制协作,构成了 Flink 集群完整的作业提交和执行体系。