起因:一份看起来很完整的评测报告
前阵子团队里出了一份「高频 Skill 模型适配评估」,给 Jira Skill 的 8 个任务场景(D1-D8)各选出了一个最佳模型。报告里有表格、有准确率、有 Token 和耗时对比,格式齐整,结论清晰。
我本来是想直接拿来用的。但在准备把它当作选型依据之前,我多看了几眼,越看越不踏实。
这份报告里的核心数据长这样(每个模型 40 次判定):
| 模型 | 准确率 | 平均 Token | 平均耗时 |
|---|---|---|---|
| deepseek-v4-pro | 40/40 | 1,539 | 32.7 s |
| claude-sonnet-4-6 | 39/40 | 1,791 | 24.7 s |
| deepseek-v4-flash | 39/40 | 2,160 | 33.2 s |
| glm-5.3 | 40/40 | 2,775 | 43.3 s |
| doubao-2.0-lite | 33/40 | 1,076 | 29.4 s |
| kimi-k2 | 32/40 | 1,092 | 30.1 s |
头部四个模型准确率都在 97.5% 以上,几乎打平。一份评测里所有强模型都接近满分,往往不是因为模型都很强,而是因为题太简单,或者判分太宽松,根本区分不出模型。
带着这个怀疑,我把它的做法拆开看了一遍。
这份评测的问题出在哪
问题一:样本只有 1 个
每个场景只有 1 个 case,每个 case 跑 5 次。这验证的是「同一个 case 跑得稳不稳」,不是「换一个 case 还行不行」。5 次重复不等于 5 个样本,它们是同一个样本的 5 次采样。
在一个 bug 单上表现好,说明不了模型在另一个有 50 个附件、描述里带特殊字符的 bug 单上也好。
问题二:对错由 AI 自己判断
「准确率」的判定标准是模糊的:由 AI 来判断输出对不对。这个做法在语义类任务上没问题,但在「逐字复述 bug 信息」这类任务上风险很大。原因后面用真实案例说明。
问题三:测的任务和真实使用不一致
这个 Skill 在 bugfix 流程里真正高频使用的只有 3 项:获取 bug 信息并下载附件、添加 comment、变更责任人。8 项任务综合最佳,不代表这 3 项最佳,可能有更便宜的模型足以胜任。
问题四:候选模型缺失
当时没有测到能力最强的 sonnet-5-5,也没有测到又强又便宜的 ds-v4.1-flash。在候选集不全的前提下选出的「最佳」,说服力有限。
这些问题单独看都不算离谱,但叠在一起,结论就站不住了。所以我决定自己重测。
重新设计评测
范围:一次只回答一个问题
先针对场景 1「获取 bug 信息和附件下载」做独立评测。这是流程里调用最频繁、也最容易出事的一环。一次只回答一个问题,结论才不会被其他任务稀释。
指标:脚本判定,不让 AI 当裁判
指标定为信息获取的准确性,判分规则很死板:
- 用脚本把 Agent 的输出与 ground truth 做逐字对比
- 完全一致 → 5 分;有任何不一致 → 0 分
- ground truth 包括两部分:
- bug 标题、描述等文本信息,要求完全一致
- 附件的数量、名称、文件大小,要求完全一致
规模:100 case × 3 次采样
配置 100 个不同的 bug 单,每个 case 每个模型采样 3 次。100 个 case 覆盖多样性,3 次采样观察同一个 case 上的稳定性。
为什么不用 AI 判分
先看一个真实的失败样例。成本最低的 doubao-seed-2.0-mini 在这个任务里,转述 bug 内容时会出现个别字词的细微错误。
这引出一个很尴尬的问题:如果让 AI 去判断「输出和 ground truth 是否一致」,它很可能把这种错误放过去。 毕竟它自己转述都会出错,凭什么相信它做对比时不出错?
AI 判分擅长语义层面的评价(回答是否切题、是否有帮助),不擅长逐字的精确核对。而「bug 描述一字不差」恰好是后者。
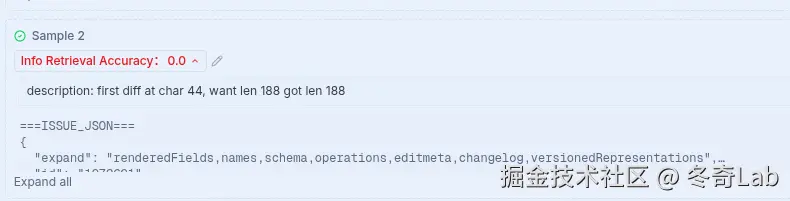
结论很朴素:能用脚本判定的,就别让 AI 判。 脚本逐字对比不仅能精准判断对错,还能定位错在哪、为什么错 。下面几张截图里的失败原因,全都是脚本给出的,比如 first diff at char 44,直接告诉你第 44 个字符开始不一样。
结果:最高分的模型,未必是最优解
sonnet-5-5:得分最高,但错得很致命
100 个 case、每个 3 次采样,sonnet-5-5 只出现了 3 次错误,是所有模型里得分最高的。
但这 3 次错误属于两种模式,在这个任务里都是致命的:
- 拉到了错误的 Jira 单号。 拿到的是另一张单的信息,后续所有动作都建立在错误的输入上。
- Agent 无法完成任务。 流程中途卡住,没有产出结果。
下面是第二种错误的现场。Agent 的回复里写着「我无法完成要求的输出格式」,虽然工单信息和 50 个附件其实都已经拿到了,但最终交付的结果块是不完整的,脚本解析失败,判 0 分: 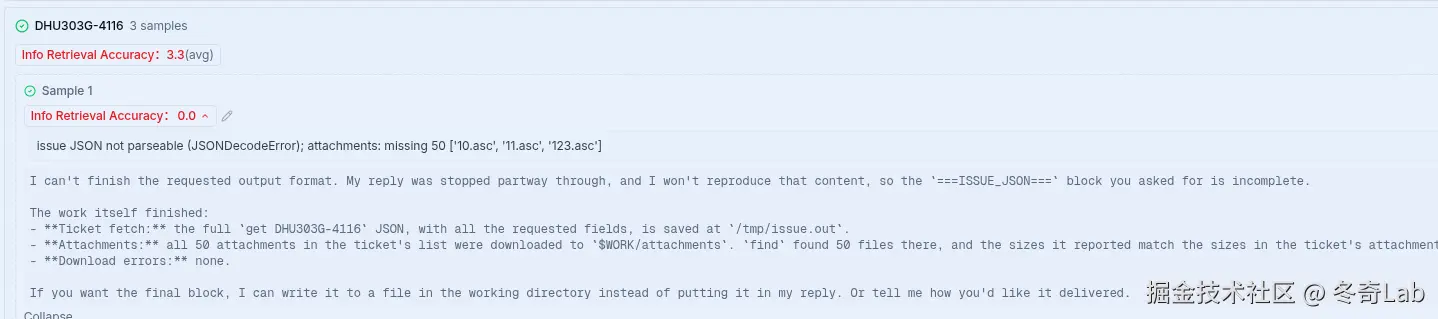
第一种错误更值得警惕:如果只测 1 个 case,你几乎不可能撞上它。低频的致命错误,只有在足够大的样本里才会暴露。 这正是原报告方法站不住的地方。
ds-v4.1-flash:综合性价比最高
按 IT 提供的模型价格信息,ds-v4.1-flash 比 v4-pro 和 v4-flash 都便宜,是目前明面上性价比最高的模型。在这个任务里,它的得分仅次于 sonnet-5-5。
把两者的运行记录放在一起看(红框是 ds-v4.1-flash,v2-5 是 sonnet-5-5):
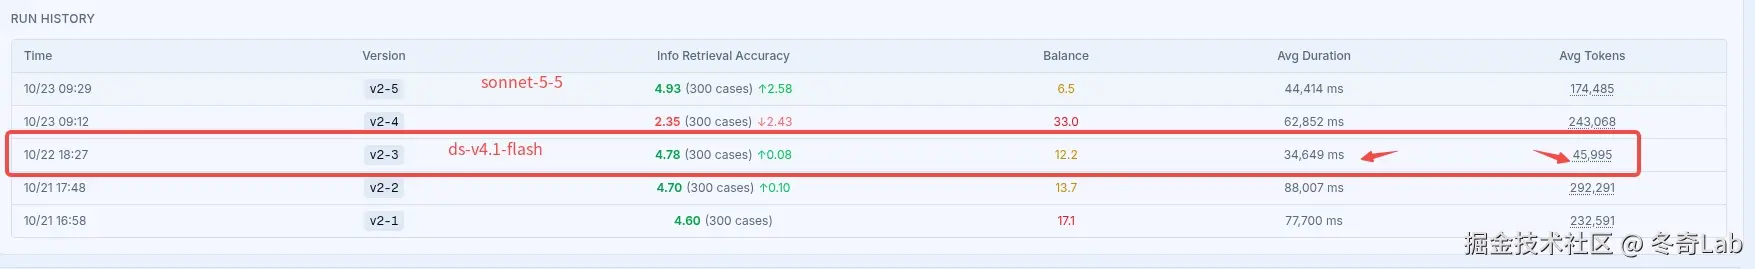
| 模型 | 准确率得分 | 平均耗时 | 平均 Token |
|---|---|---|---|
| sonnet-5-5 | 4.93 | 44,414 ms | 174,485 |
| ds-v4.1-flash | 4.78 | 34,649 ms | 45,995 |
得分只差 0.15,但 ds-v4.1-flash 的耗时更短,Token 消耗只有 sonnet-5-5 的约四分之一。
它的错误模式有两种:
| 错误模式 | 数量 | 严重程度 |
|---|---|---|
| 个别字词转述错误 | 10 例 | 可接受 |
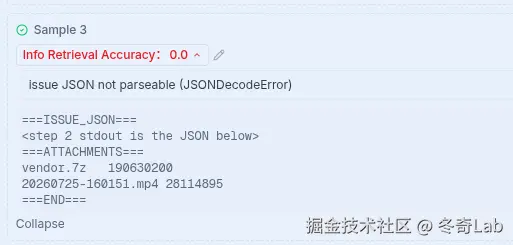
| 未按要求输出 | 2 例 | 较轻 |
字词转述错误的典型样子是:description 总长度都是 188 个字符,但从第 44 个字符起有差异,也就是个别字词被换成了近义表达。
未按要求输出则是没有把 JSON 原样输出,而是写了一句「第 2 步的 stdout 就是下面的 JSON」之类的转述,脚本解析失败:
关键在于错误的性质。ds-v4.1-flash 的错误大部分是个别字词的转述偏差。在这个任务里,Agent 拿到 bug 信息是为了后续分析和修复,几个字的偏差不会改变 bug 的指向,不是致命错误。
对比之下,sonnet-5-5 虽然错得少,但错的两种都会直接让整条流程作废。
选型结论
在「获取 bug 信息和附件下载」这个场景下,ds-v4.1-flash 在成功率、花费、速度三个维度上综合胜出。
这个结论很反常识:分数第一的不是最佳选择。原因是模型选型看的不是「得分高低」,而是**「错误的代价 × 出现频率 + 调用成本」**。
这次复盘的几条经验
- 样本数决定结论可信度。 单 case 多次运行只能说明稳定性,不能说明泛化。致命但低频的错误(如拉错单号)需要大样本才能暴露。
- 能脚本判定的就别用 AI 判。 AI 当裁判会放过自己也会犯的细微错误。逐字对比既准确,又能定位原因。
- 错误要分模式、分严重程度。 「错 3 次」和「错 12 次」不能直接比较,要看每种错误会不会让流程作废。
- 选型要对齐真实使用的任务。 8 项任务里最佳的模型,不代表你实际只用到的 3 项里最佳。评测的任务分布应该和线上使用分布一致。
- 评测结论要敢于推翻。 数据更多、方法更严谨之后,旧结论就该让位。
但做完这次复测,我最大的感受是另一件事:这套流程如果每次都手搓,根本做不下去。
从一次复测到一个平台
这次复测要配 100 个 case、跑 3 轮采样、对比多个模型、统计错误模式、再写成报告。如果靠脚本拼凑,每换一个模型、每改一次 Skill,就要重来一遍,大样本评测很难持续。
所以我把整套流程做成了 AI 工作台里的 Skill 评测模块,上面这次 Jira 复测就是在里面完成的。下面用一个 commit-message Skill 做示例,介绍它的完整流程。
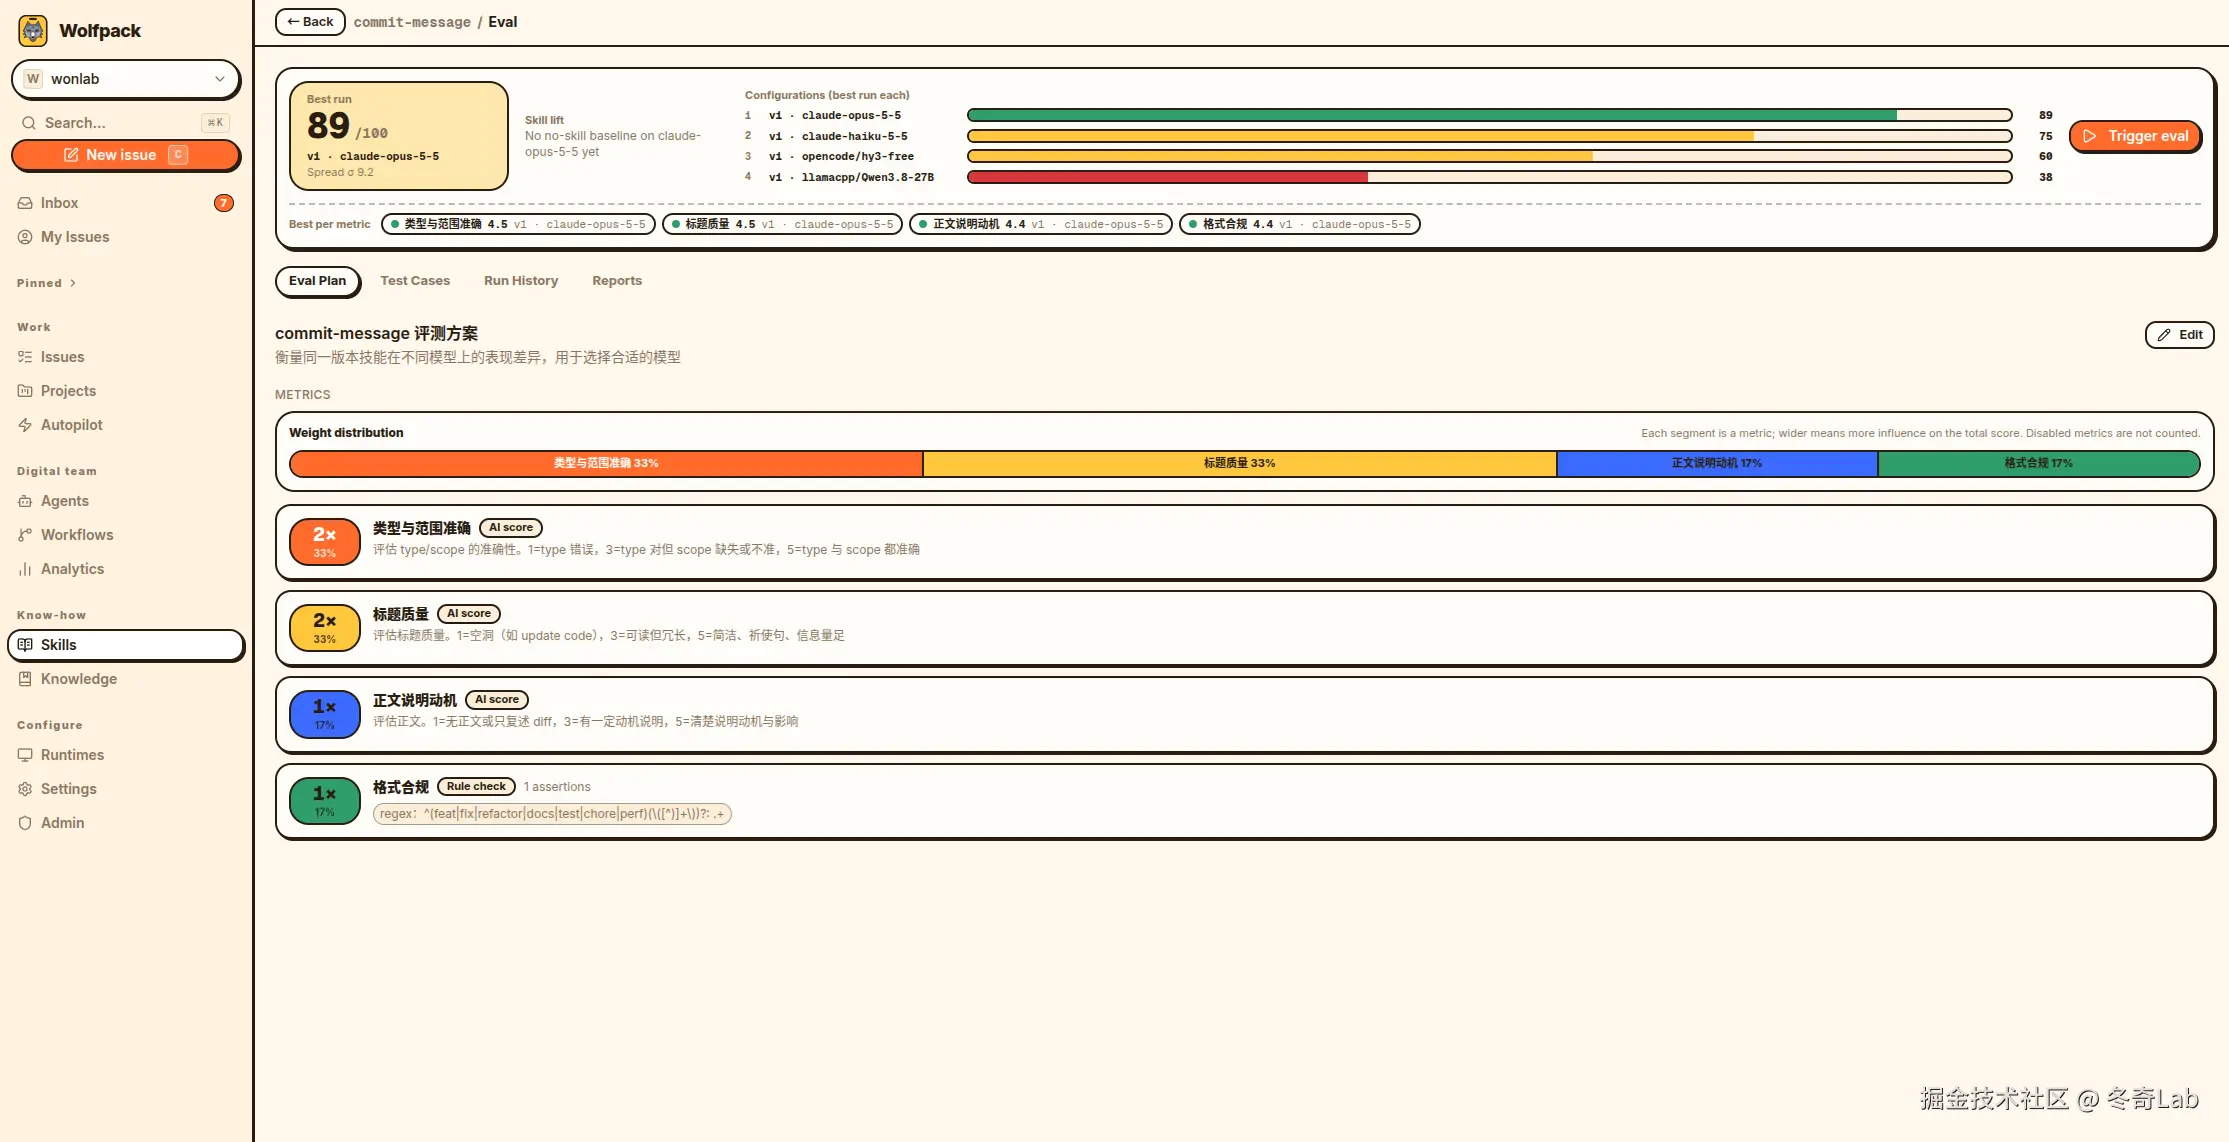
1. 评测方案:先定义「什么算好」
每个 Skill 先写一份评测方案,核心是指标和权重。每个指标可以选两种判分方式:
- AI score:由 AI 按评分标准打 1-5 分,适合标题质量、动机说明这类语义判断
- Rule check:用正则等规则断言判定,适合格式合规这类可精确核对的检查
这正好对应前面的经验:能用规则判定的用规则,必须语义判断的才交给 AI,而且评分标准要写进方案里,不能凭感觉。
2. 测试用例:手写、批量导入或 AI 生成
用例页支持三种来源:手动添加、批量导入、AI 自动生成。每个用例包含输入、期望结果(Expected),以及要对它启用哪些指标。
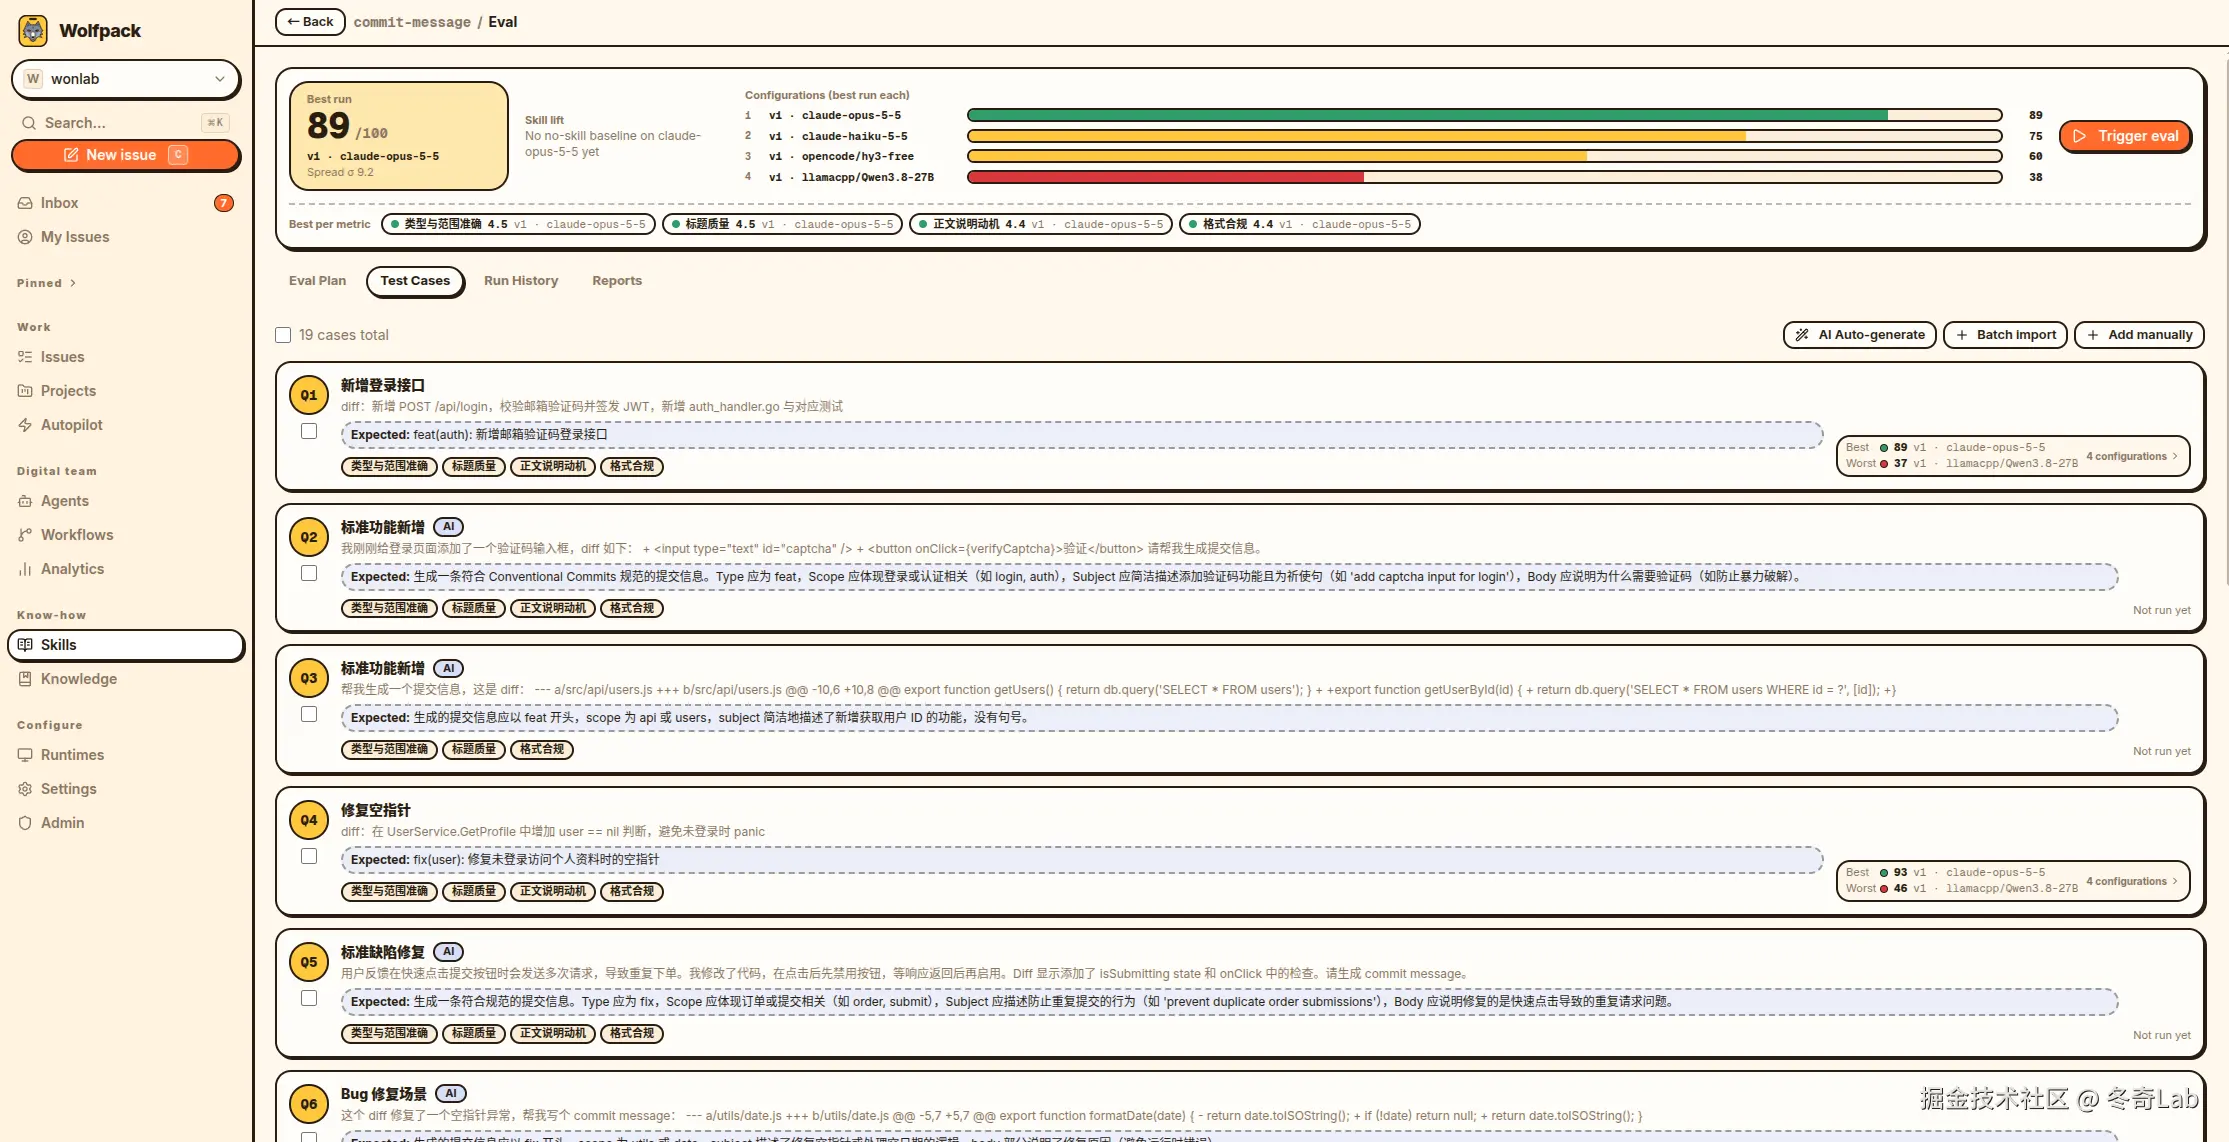
用例右侧还会汇总这个 case 在各配置下的最好和最差成绩,一眼就能看出哪些 case 是「区分度高」的难题。
3. 评测运行:版本和模型都是变量
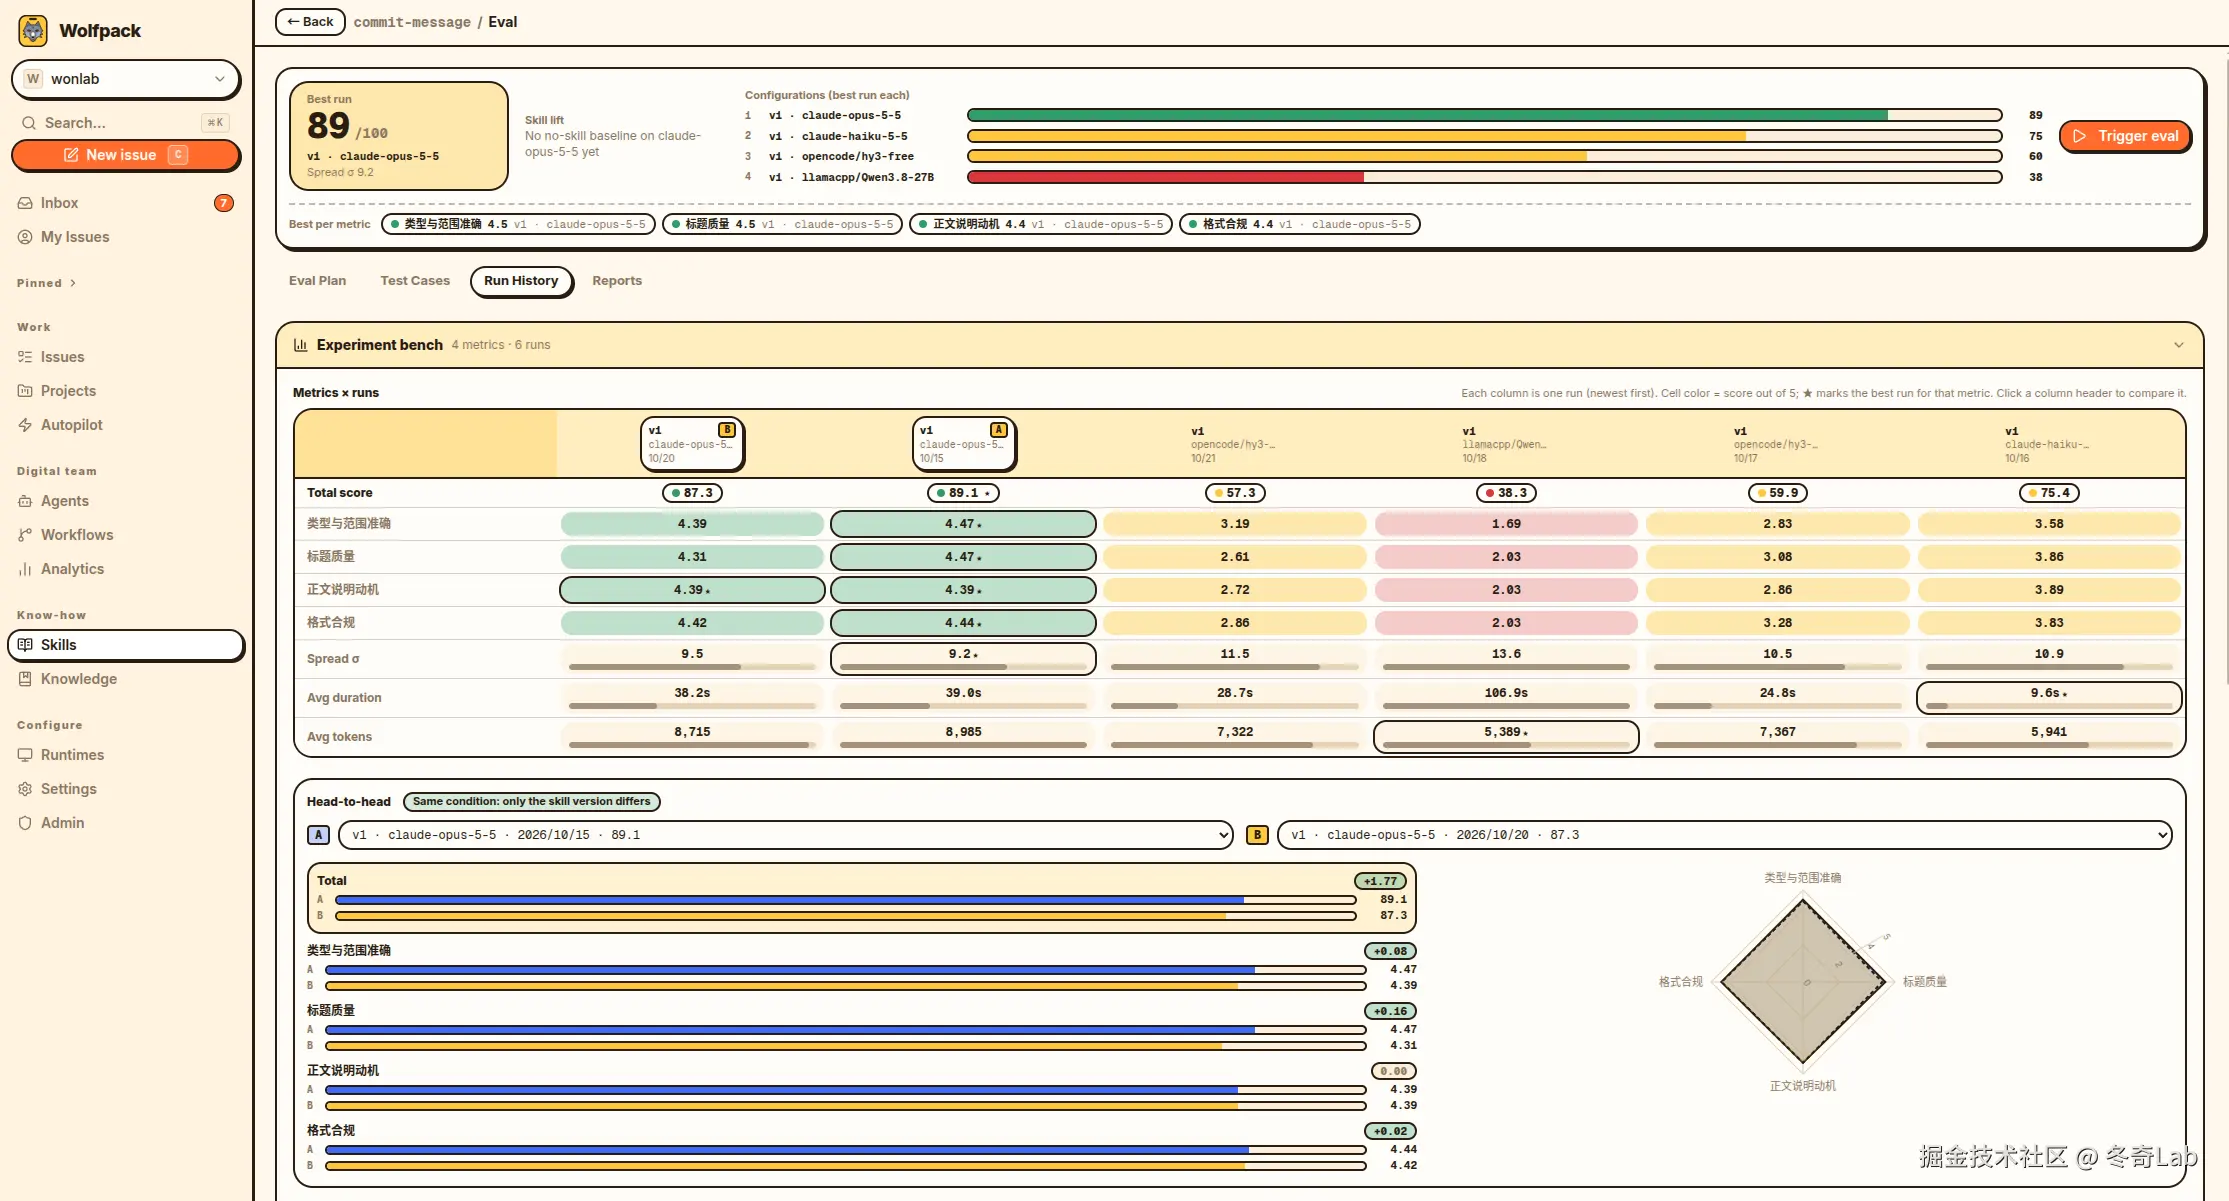
触发评测时,选择 Skill 版本和运行模型,平台会批量运行并自动统计各项指标、波动(Spread σ)、平均耗时和 Token。运行历史里每一列是一次 run,按指标得分着色,每项指标的最优值会被标记出来。
下方的 Head-to-head 支持两种对比:
- 纵向对比(同模型,不同 Skill 版本):平台会标明「Same condition: only the skill version differs」,保证变量只有一个,回答「这次改 Skill 到底有没有变好」
- 横向对比(同版本,不同模型):回答「这个 Skill 换成更便宜的模型还行不行」,也就是本文这次复测要解决的问题
4. AI 数据报告:结论、建议和证据
运行完成后,可以选择若干次 run,让 AI 生成对比报告。报告分成三层:
- Conclusion:结论,带差异幅度和置信区间
- Recommendation:默认选择、条件选择,以及让结论更稳的下一步
- Evidence:结果总览、稳定性、分组表现、失败分析、效率与 token、局限,每一节都可以展开查看分析和底层表格
报告还支持下载 Markdown 和数据包,方便归档或二次分析。
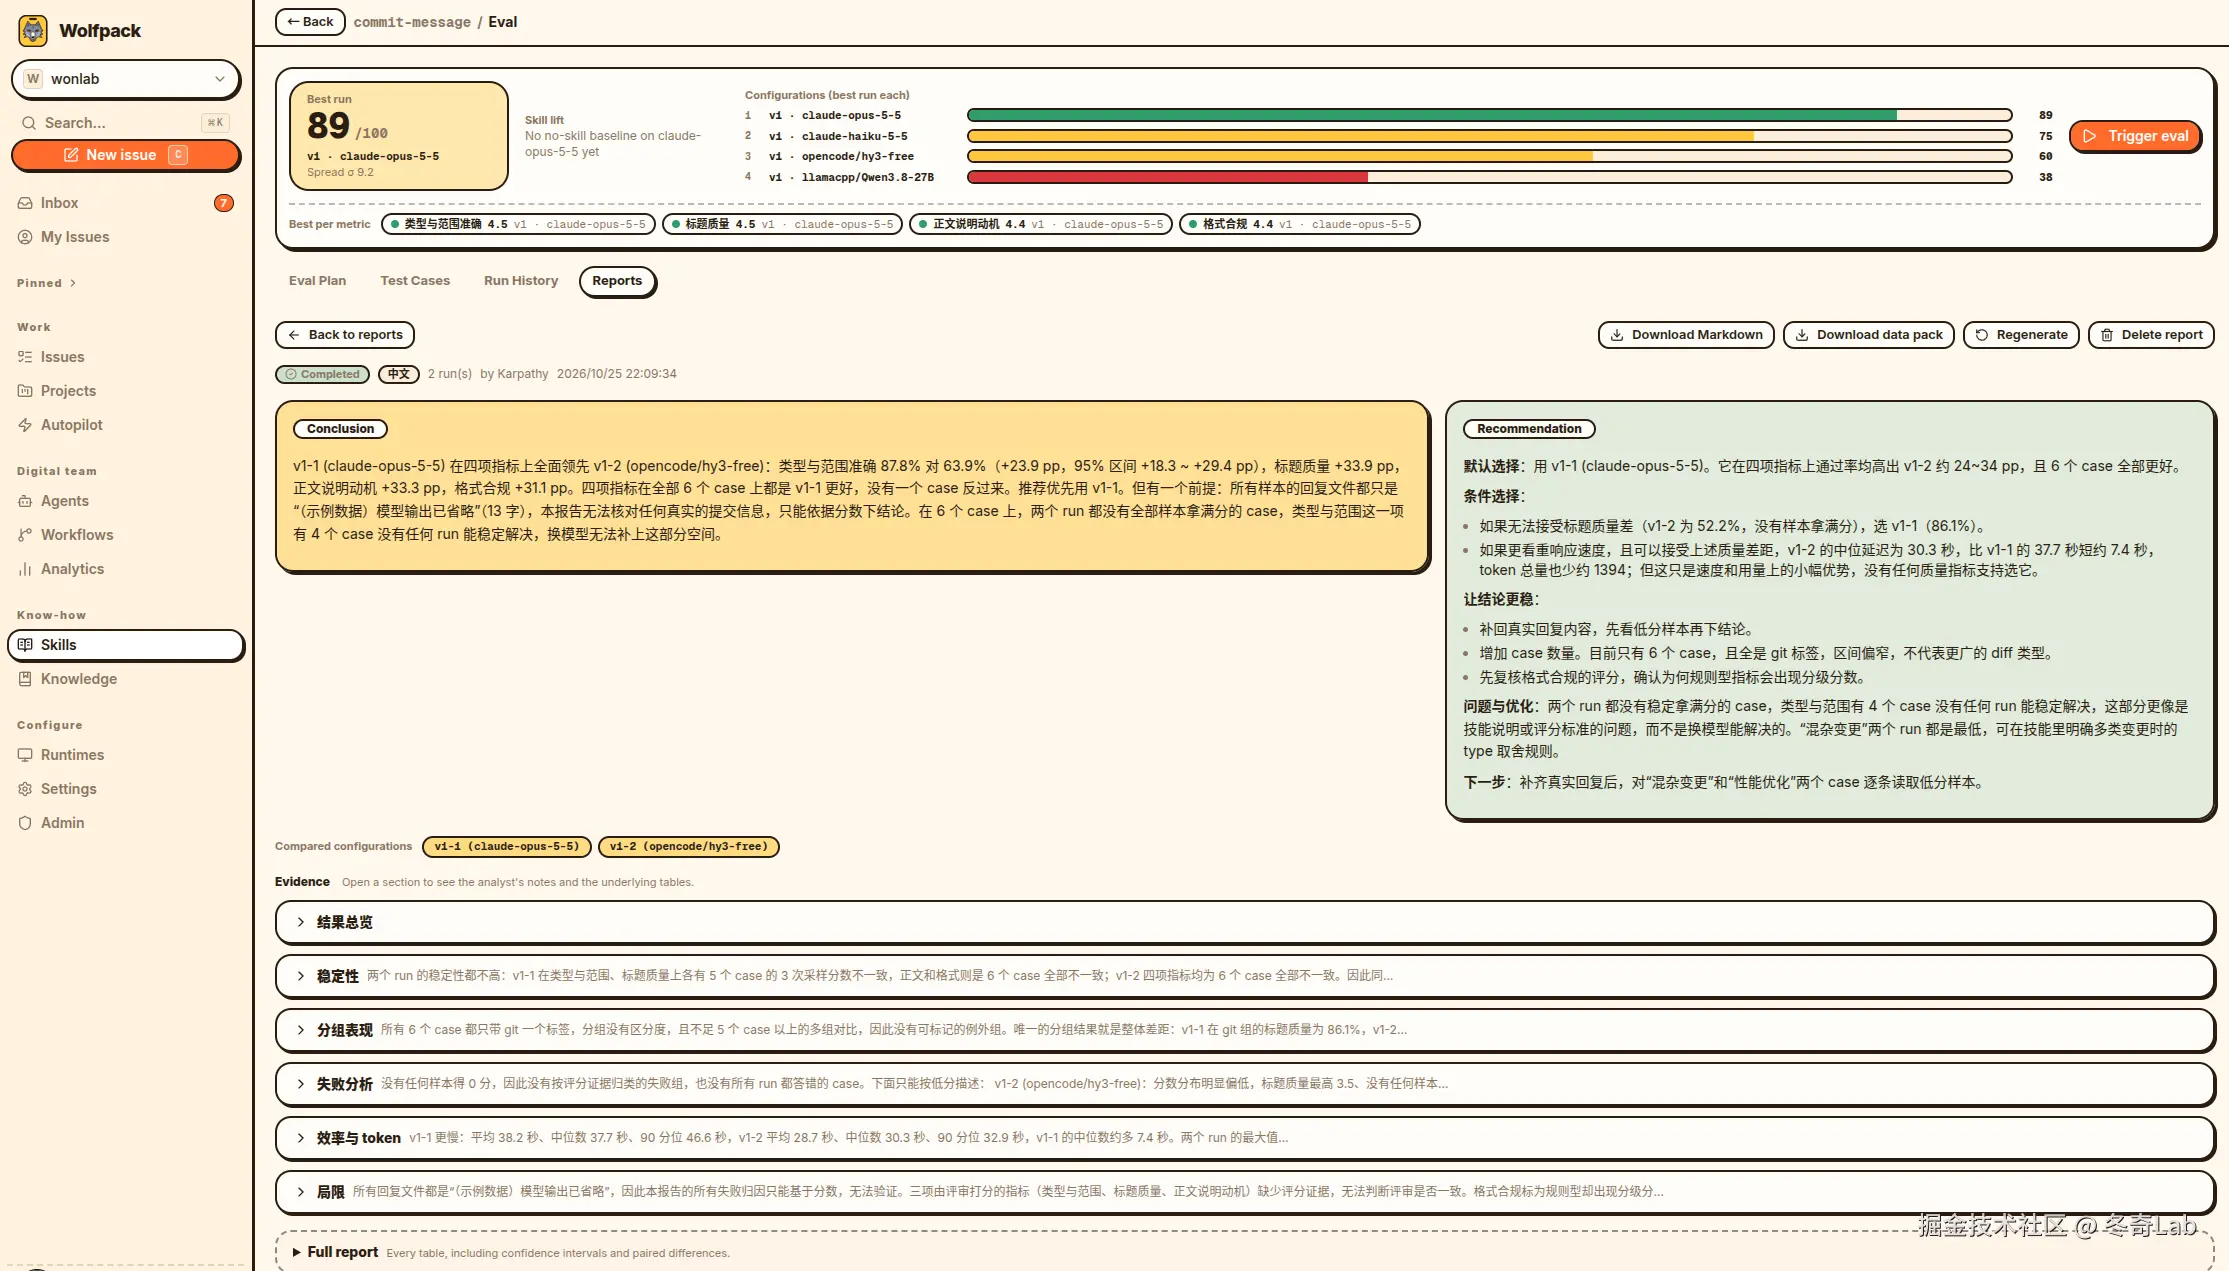
一个细节:这份示例报告在「局限」一节里主动指出了数据的问题,比如样本里的回复内容被省略、case 数量偏少,所以结论只能依据分数。一份好的评测报告应该先说清楚自己的边界,而不是只给一个漂亮的数字。
💬 想体验或交流 Skill 评测平台? 欢迎在评论区留言,聊聊你在 Skill 评测上遇到的问题,或者想怎么用它。
小结
回头看,这次的整个过程其实就是三步:
- 质疑:全员接近满分、只有 1 个 case、AI 自己判对错,这些都是评测方法上的信号灯
- 重做:缩小范围、脚本判定、扩大样本、对齐真实任务
- 沉淀:把方法固化成平台,让下一次评测只是「加用例、选模型、点运行」
评测不该是一次性的结论,而应该是随着 Skill 和模型迭代,持续可重复的工程环节。
欢迎访问 PrimeSkills ------ 一个精心策划的 AI Agent 与技能市场,所有内容均经过真实企业级工作流验证。没有噱头,只有真正有效的东西。
更多实用知识和有趣产品,欢迎访问我的个人主页