大家好,我是加洛斯,是一名全栈工程师👨💻,这里是我的知识笔记与分享,旨在把复杂的东西讲明白。如果发现有误🔍,万分欢迎你帮我指出来!废话不多说,正文开始 👇
Elasticsearch 是一个开源的分布式搜索和分析引擎 ,基于 Apache Lucene 构建,通过 RESTful API 和 JSON 文档提供近乎实时的数据存储、搜索与分析能力。
它既能做毫秒级的全文搜索 和语义/向量检索,也能对海量数据进行实时聚合分析;并且天然支持分布式架构,可无缝扩展到数百节点、处理 PB 级数据。
在实际应用中,它常与 Logstash、Kibana 组成 ELK,广泛用于日志分析、站内搜索和实时数据分析等场景。
本文主要基于
Spring Boot生态讲述ES8.x 版本,默认已自动搭建好单点ES8 容器与Kibana。(不会搭建也没事,现在 Agent 这么发达,一句话搞定!)
一、炼气入门
1.1 正排索引
在讲倒排索引之前,我们得从正排索引说起。传统数据库(如 MySQL)采用正向索引,假设你有一个文档表:
| id | title | price |
|---|---|---|
| 1 | 小米手机 | 3499 |
| 2 | 华为手机 | 4999 |
| 3 | 华为小米充电器 | 49 |
| 4 | 小米手环 | 49 |
当用户输入「手机」进行搜索时,如果是正排索引(或者 MySQL 的 LIKE '%手机%'),系统没有别的选择,只能进行全表扫描:
- 读取第 1 行 :检查 Doc 1 的
title(小米手机),发现包含「手机」,命中! 放入结果集。 - 读取第 2 行 :检查 Doc 2 的
title(华为手机),发现包含「手机」,命中! 放入结果集。 - 读取第 3 行 :检查 Doc 3 的
title(华为小米充电器),没发现「手机」,跳过。 - 读取第 4 行 :检查 Doc 4 的
title(小米手环),没发现「手机」,跳过。
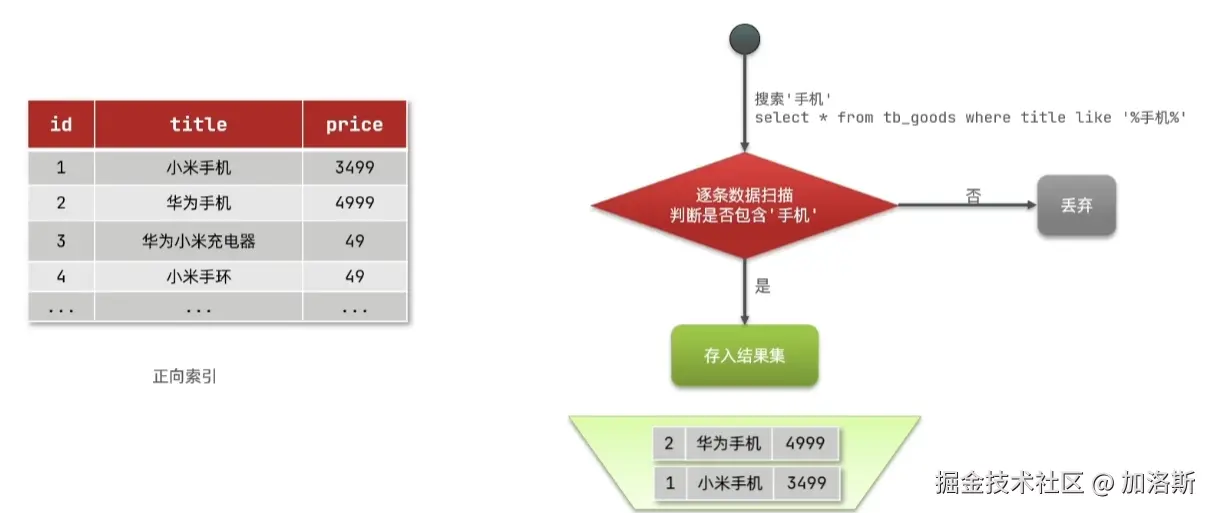
如果这张表只有 4 行,眨眼间就搜完了。但如果是 100 万行 甚至 1 亿行呢?系统为了找「手机」,必须把 1 亿行数据全部读取一遍,逐条检查里面有没有这两个字。这个过程需要大量的磁盘 I/O 和 CPU 计算,导致响应极慢(可能需要几秒甚至几十秒)。
1.2 倒排索引
在学习倒排索引之前,我们需要了解其中两个概念:
- 文档(Document) :指被索引的原子单位。在全文检索中,它可以是一篇网页、一篇文章或一个
JSON文档。每个文档会被分配一个唯一的文档编号(DocID)用于标识。 - 词条(Term) :指从文档中提取出来的、用于建立索引的词语或标记。它是搜索时的基本匹配单位。文档经过分词 和标准化后,会产生一系列词条。
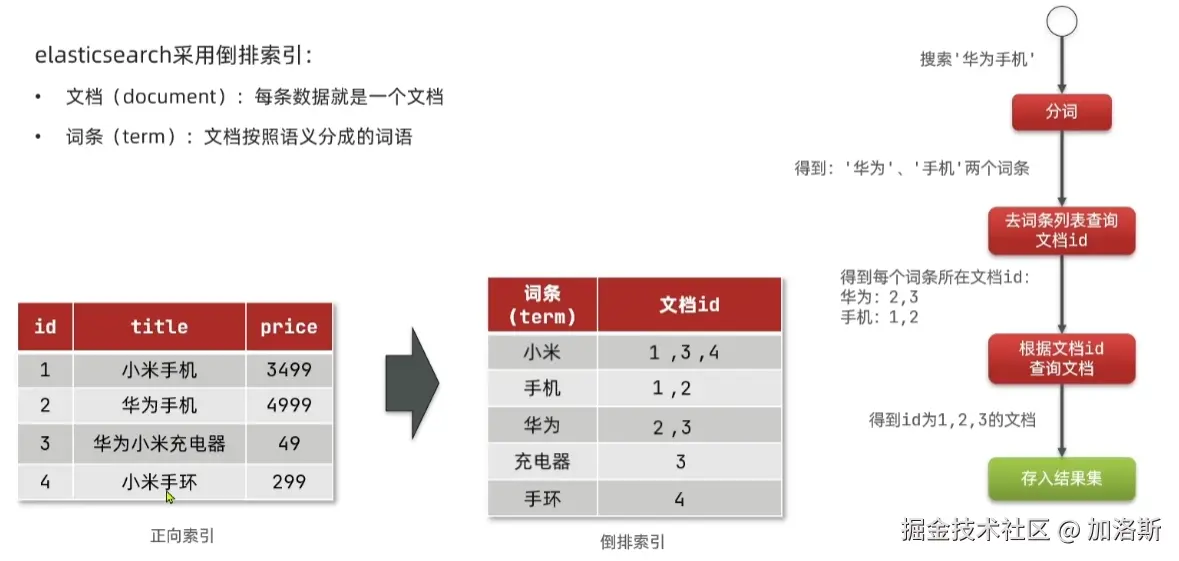
倒排索引的本质,就是建立了一张 「词条 → 文档 ID」 的映射表,直接跳过了无关数据,用空间换取了极致的时间。我们看下图:
1. 数据的正向存储(左侧图)
在 ES 中,每一条商品数据都是一个文档(Document) 。如果像 MySQL 一样按行存储(如左侧表),想要查找包含「手机」的商品,系统必须逐行扫描 title 字段,数据量大时性能极差。
2. 倒排索引的构建(中间图)
在数据写入时,ES 会在底层做一次「倒排」转换:把标题按照语义拆分成一个个词条(Term),并记录每个词条出现在哪些文档 ID 中。
例如:
- 「华为」出现在文档 2 和 3 中;
- 「手机」出现在文档 1 和 2 中。
3. 搜索的执行流程(右侧图)
当用户搜索「华为手机」时,ES 的查询路径如下:
- 分词:将查询词拆分为 华为 和 手机 两个词条。
- 查词条表:去中间的倒排索引中,极速定位到「华为」对应 2, 3,「手机」对应 1, 2。
- 合并结果 :取并集,得出命中的文档 ID 为 1, 2, 3。(教学上先用并集直观展示「谁出现过这些词」;真实默认的
match更接近bool/should,若要求词条都出现可用operator: and或bool/must,此时交集为文档 2。) - 查询文档:根据 ID 取出完整的文档数据,存入结果集返回给前端。
由于文档 2 同时命中「华为」和「手机」,其相关性得分最高,因此「华为手机」会排在首位。
想象你要找一本书里所有提到「苹果」的地方。正排索引就像书的目录:从「第 1 页」查到「这一页讲了苹果和香蕉」,你得从头翻每一页才能找全「苹果」。倒排索引则像书末的关键词索引:直接查「苹果 → 第 3、17、42 页」,一步到位。所以正排是「文档 → 内容」,适合按文档查内容;倒排是「关键词 → 文档列表」,适合快速全文搜索。
1.3 ES 的索引(Index)
在 Elasticsearch 中,「索引(Index)」 是一个被严重「一词多义」化的概念。
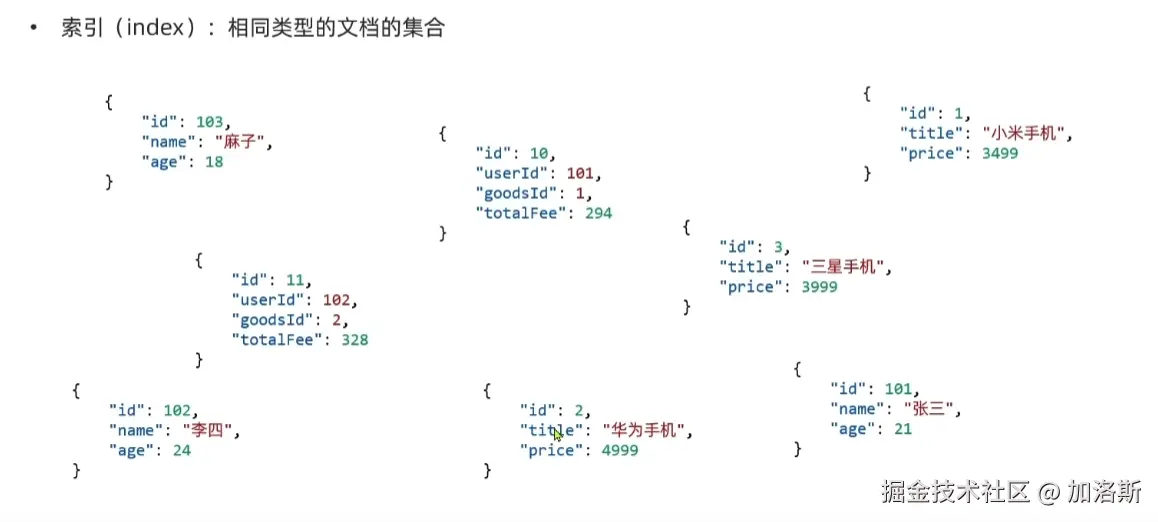
ES 中的索引在逻辑上相当于 MySQL 的表,它是文档的集合。
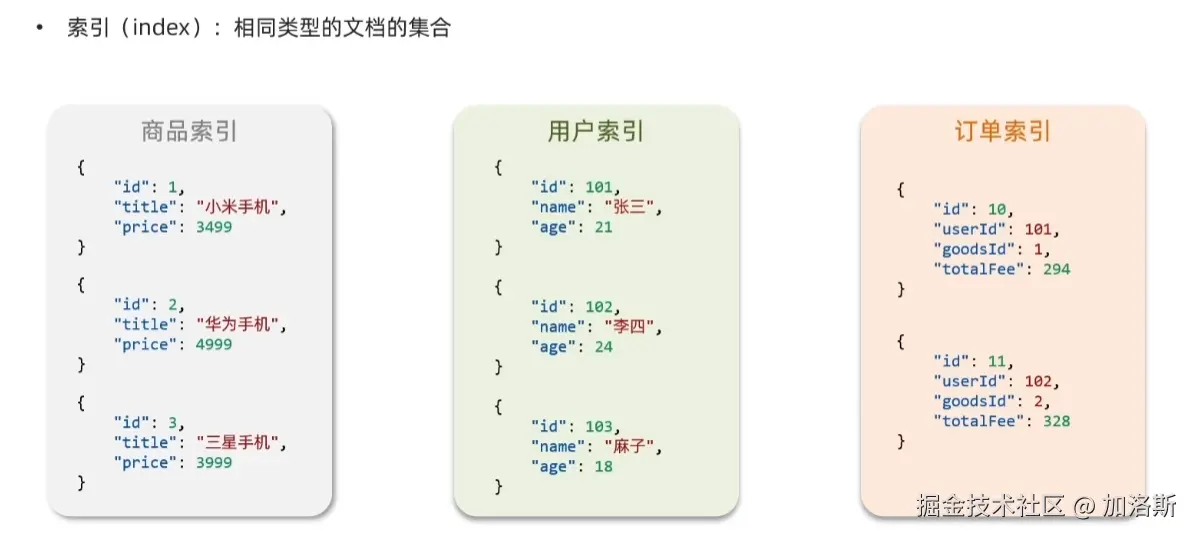
但在物理层面,它并不是一张简单的表格,而是由底层
Lucene引擎生成的海量倒排索引文件组成的。当你向 ES 写入数据时,ES 不仅把数据存了下来,还顺便在磁盘上构建了那张庞大的倒排表,这就是 ES 空间换时间的秘诀所在。
我相信大家对于 MySQL 都应该非常熟悉,我们用 MySQL 的概念来复习一下 ES 中的概念,方便大家理解。
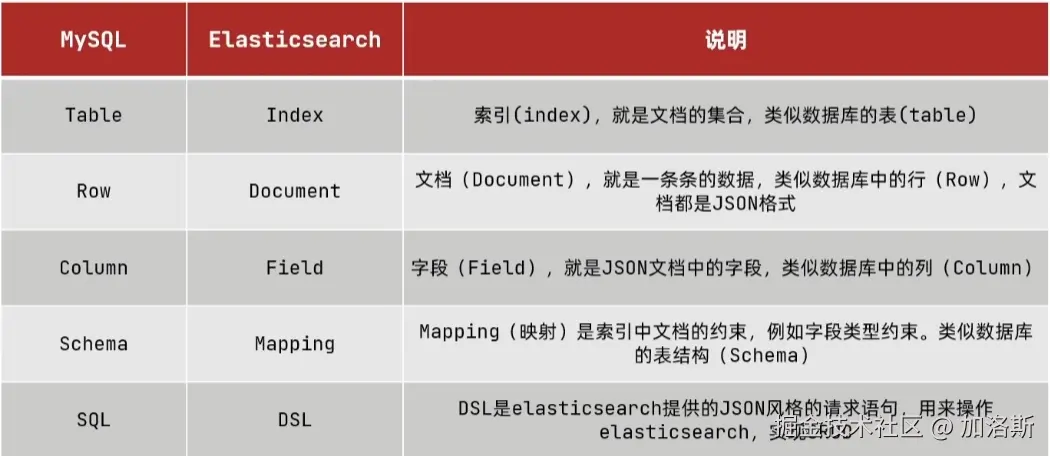
二、筑基固本
2.1 分词器
ES 在创建倒排索引时需要对文档分词。你可以把分词器理解为 「切词刀」。它的核心工作,就是在数据写入(建索引)和用户搜索查询时,把一整句话按照一定的规则切分成一个个独立的「词条(Term)」。在 ES 底层,一把完整的「切词刀」由三个零件组成,按顺序执行:
- Character Filters(字符过滤器):最前端的预处理。比如把文本里的 HTML 标签
<p>去掉,或者把&替换成 and。 - Tokenizer(分词器/切词器):核心部件。负责把长文本切分成一个个词。比如把「我爱北京」切成 我, 爱, 北京。
- Token Filters(词元过滤器):后置处理。对切好的词进行加工,比如把所有大写转小写(JAVA → java),去掉无意义的停用词(如「的」「是」、a),或者加上同义词(把「手机」替换为「移动电话」)。
2.2 常见分词器对比
在 ES 中,你可以选择不同的分词器:
standard(默认) :按空格和标点切分。对英文很友好,但对中文极差。它会把「沈阳喜欢学习」切成单字 沈, 阳, 喜, 欢, 学, 习,这会导致搜索变得极其杂乱。ik_smart(中文常用) :IK 分词器的智能模式。颗粒度较粗,适合搜索场景。比如把「中华人民共和国」直接切成 中华人民共和国。ik_max_word(中文常用) :IK 分词器的最细粒度模式。适合建立索引。它会把「中华人民共和国」切成 中华人民共和国, 中华人民, 中华, 华人, 人民共和国, 人民, 共和国, 共和, 国,尽可能多地覆盖各种搜索词。
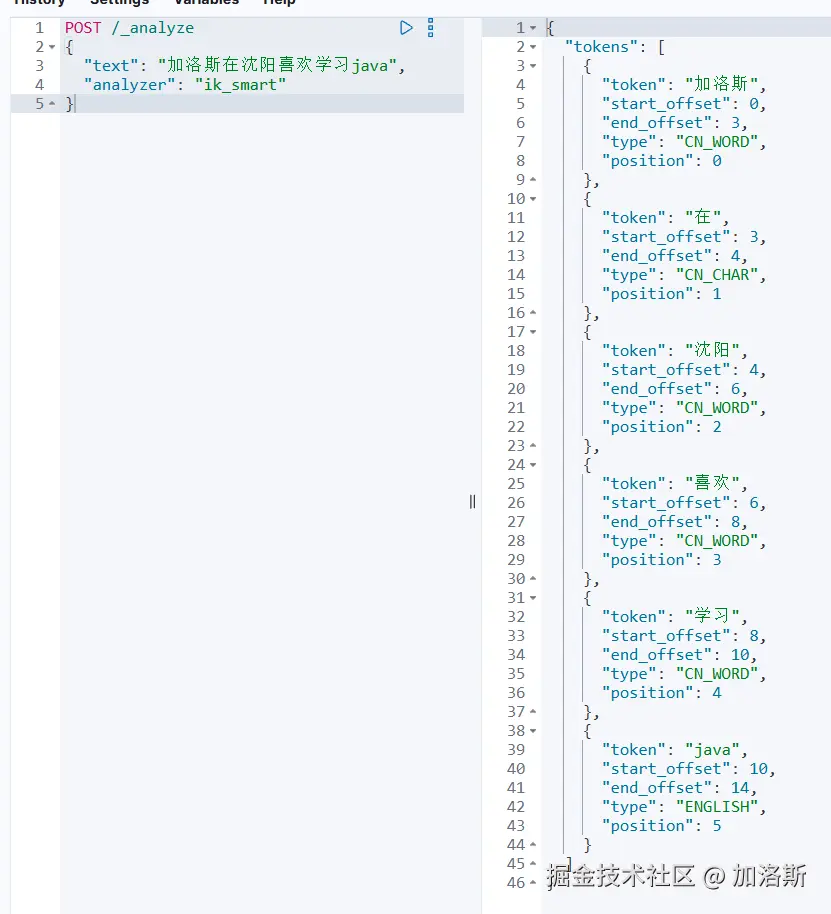
刚才运行的 POST /_analyze 命令,就是用来检验的。分词器选错,倒排索引就废了。
- 如果你用
standard处理中文:用户搜「沈阳」,是搜不到「我爱沈阳」这条数据的,因为在倒排表里,这条数据被拆成了 我, 爱, 沈, 阳,没有「沈阳」这个词。 text和keyword的根本区别 :text类型会经过分词器,拆成词条进倒排表;而keyword类型不经过分词器 ,整句话作为一个词条进倒排表。所以keyword才适合做精确匹配和聚合。
2.3 Mapping 映射
在上一节中我们知道,分词器决定了文本怎么切分。但 ES 怎么知道哪些字段需要分词,哪些字段不需要 ?这就必须依靠 Mapping。
如果把倒排索引比作一张庞大的词条字典,那么 Mapping 就是设计这张字典的图纸。它相当于 MySQL 中的表结构,不仅定义了字段的类型,更决定了该字段在底层如何建立索引。
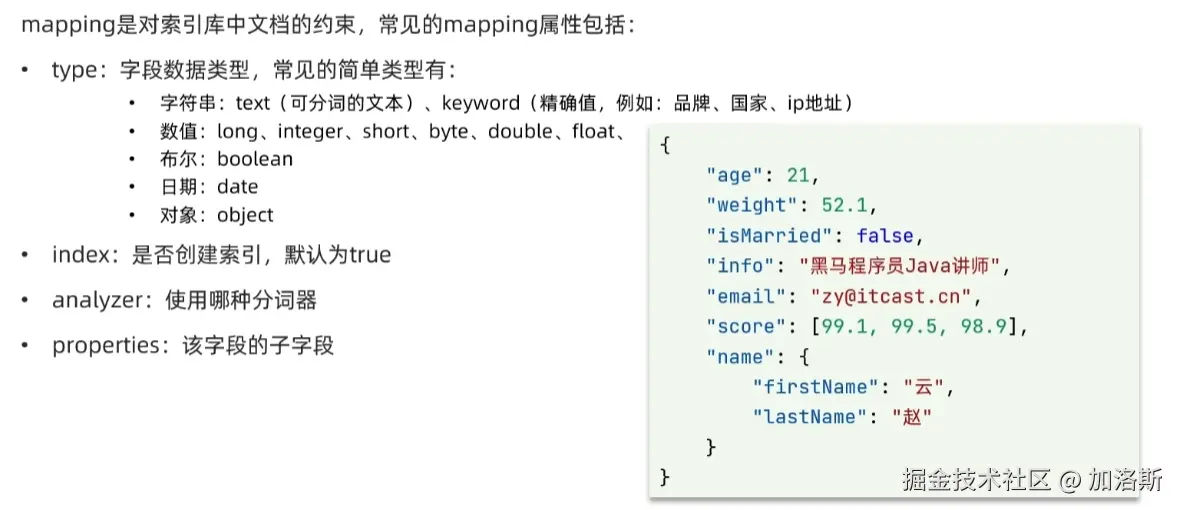
两个核心字符串类型:text 与 keyword
我们在使用 ES 时,最容易踩坑的就是分不清这两个类型,它们直接决定了倒排索引的结构:
text(会分词) :适合全文检索。比如商品标题「小米手机」,进倒排索引时会被拆成 小米, 手机。因此,text字段不能直接用来做排序或聚合统计(会报错或极其消耗内存)。keyword(不分词) :适合精确匹配和聚合。它会把整个字符串作为一个完整的词条存入倒排表。比如订单状态「在售」,进倒排索引就是完整的 在售。因此,订单号、用户名、状态枚举,一律使用keyword。
避坑指南 :对
text字段用match搜「小米手机」时,查询也会分词,通常仍可能命中(按「小米」「手机」等词条去匹配)。若你要的是整句精确相等 ,请用keyword+term;若只要「像整句一样严一点」的全文匹配,可用match的operator: and或match_phrase。不要把「全文匹配」和「精确匹配」混为一谈。
在生产环境需要注意 :如果你在写入数据前没有手动创建Mapping,ES 会根据你插入的第一条数据「自动猜」类型(动态映射)。比如,遇到"123",ES 可能会把它猜成long数字类型。后续你想存"00123"时,前导零就会丢失,甚至报错。因此,作为架构师,在生产环境必须关闭动态映射(Dynamic Mapping),或者在建索引时手动声明所有字段类型,确保底层倒排索引的质量。
三、金丹悟道
前面两个境界,我们已经把 Elasticsearch 的内功心法摸透了。进入金丹期,我们开始动手实操。在 ES 中,我们要操作的核心对象是索引(Index)和文档(Document)。本节我们先来看看如何通过 RESTful API 对索引进行基础的增删改查。
3.1 创建索引(Create)
创建一个索引,本质上就是定义了数据的「正向结构」(Mapping)以及它的「物理分布」(Settings)。基础的创建语法如下,我们不仅要建索引,还要顺便指定分片、副本数以及我们前面讲过的 Mapping:
json
PUT /product_index
{
  "settings": {
    "number_of_shards": 3,    // 主分片数,一旦创建不可修改
    "number_of_replicas": 1   // 副本数,随时可改
  },
  "mappings": {
    "properties": {
      "title": {
        "type": "text",
        "analyzer": "ik_max_word"
      },
      "brand": {
        "type": "keyword"
      },
      "price": {
        "type": "double"
      },
      "created_at": {
        "type": "date",
        "format": "yyyy-MM-dd HH:mm:ss"
      }
    }
  }
}
在阅读这段 JSON 时,你可以把它完全类比为 MySQL 里的 CREATE TABLE 语句,但它多了一些物理分布的配置。我们逐层拆解:
1. 基础信息:PUT /product_index
PUT:代表创建(幂等操作,重复执行会报错------索引已存在)。- /
product_index:这是这个索引的名字。
注意 :ES 强制要求索引名必须全部小写,不能包含大写字母。
2. settings:物理分布与分片配置
这块是架构师该考虑的事情,作为一个新手小白会用就好,配置什么的完全不用你操心啦,等你学会了搭建集群回头再理解一下也不迟。
json
"settings": {
  "number_of_shards": 3,    // 主分片数
  "number_of_replicas": 1   // 副本数
}
这部分相当于 MySQL 的存储引擎配置(ENGINE=InnoDB),它决定了数据在底层硬件上怎么存。
number_of_shards: 3(主分片) :ES 是一个分布式引擎,它会把你的数据「切」成 3 份,分散在不同的节点上。这里有一个绝对不能踩的坑:主分片数一旦在创建时定死,后期是绝对不能修改的。 因为底层基于Lucene,路由规则已经根据主分片数固定了,如果要改,只能重建索引导数据。通常建议单分片大小控制在 10GB~30GB 之间。number_of_replicas: 1(副本) :相当于给每个主分片配一个「备胎」。好处有两个:一是高可用(主分片所在机器挂了,副本顶上);二是分担读取压力(搜索请求可以打到副本上)。副本数是随时可以动态修改的。
如果你完全不写 settings 里的分片和副本配置,ES 会使用以下默认值:
number_of_shards(主分片) :默认 1number_of_replicas(副本) :默认 1
3. mappings:正向结构
json
"mappings": {
  "properties": { ... }
}
这部分对应 MySQL 的字段定义(CREATE TABLE (...))。properties 下面就是一个个具体的字段。
ES 6.x 及更早的版本支持一个索引下放多种「文档类型」(
type),不同type的字段若重名但类型不同,Lucene底层会冲突,所以官方从 6.x 开始废弃type;ES 7 限制一个索引只能有一个type,名字固定为_doc(纯占位,无实际意义);到 ES 8,type被彻底移除,一个索引就是一张表 ,mapping 直接写properties,不再需要包一层_doc------你在 ES 8 里如果照老教程写成mappings._doc.properties,会直接报错。
接下来看里面的四个具体字段:
① title 字段(全文检索类型)
json
"title": {
  "type": "text",
  "analyzer": "ik_max_word"
}type: "text":告诉 ES 这是一个文本字段,会被拆碎、进倒排索引。analyzer: "ik_max_word":指定使用 IK 分词器的最细粒度模式。比如「小米手机」会被拆成「小米」「手机」「小米手机」等多个词条。这样当用户搜「小米」或「手机」时,都能命中这个商品。
② brand 字段(精确值类型)
json
"brand": {
  "type": "keyword"
}type: "keyword":告诉 ES 这个字段不分词,原封不动作为一个整体存进倒排索引。- 为什么不用
text?因为如果品牌是「华为手机」,被拆成「华为」和「手机」,用户搜「手机」时,连「华为手机」这个品牌也会被搜出来(但这其实是品类,不是品牌)。用keyword,不管是做精确过滤(term查询)还是做分组聚合(terms聚合),性能和准确性都是最高的。
③ price 字段(数值类型)
json
"price": {
  "type": "double"
}- 用于存储价格。ES 对数值类型有特殊的底层优化(
BKD Tree),做范围查询(如price>= 100)速度极快。
④ created_at 字段(日期类型)
json
"created_at": {
  "type": "date",
  "format": "yyyy-MM-dd HH:mm:ss"
}type: "date":告诉 ES 这是时间。- format:非常关键。如果你不写,ES 默认只认
ISO 8601格式(2023-10-01T12:00:00Z)。加上这个格式化参数后,你才能直接插入 2023-10-01 12:00:00 这样的常见时间字符串,并且可以用它做时间范围查询和按时间维度的聚合分析(如date_histogram)。
创建之后,返回如下:
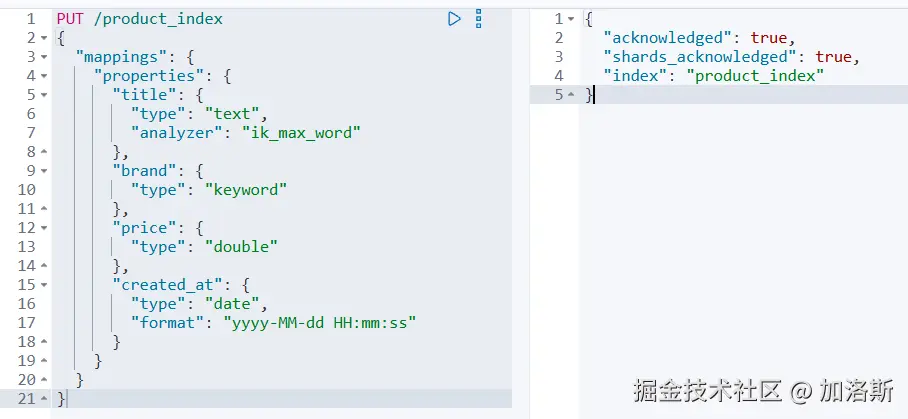
| 字段 | 值 | 含义 |
|---|---|---|
| acknowledged | true | 集群已确认收到创建请求,索引元数据已写入 |
| shards_acknowledged | true | 分片已分配(不一定全部 STARTED,但已开始分配) |
| index | product_index | 刚创建的索引名 |
3.2 查看、删除、修改索引
1. 查看索引(Read)
建好索引后,我们需要像查 MySQL 表结构一样,随时确认它的状态。ES 提供了几个非常实用的 _cat(查看)API:
- 查看所有索引列表:
http
GET /_cat/indices?v效果:会以表格的形式列出集群里所有的索引,包括健康状态(health)、状态(status)、主分片数、文档数(docs.count)、存储大小(store.size)等。相当于 MySQL 里的 SHOW TABLES;
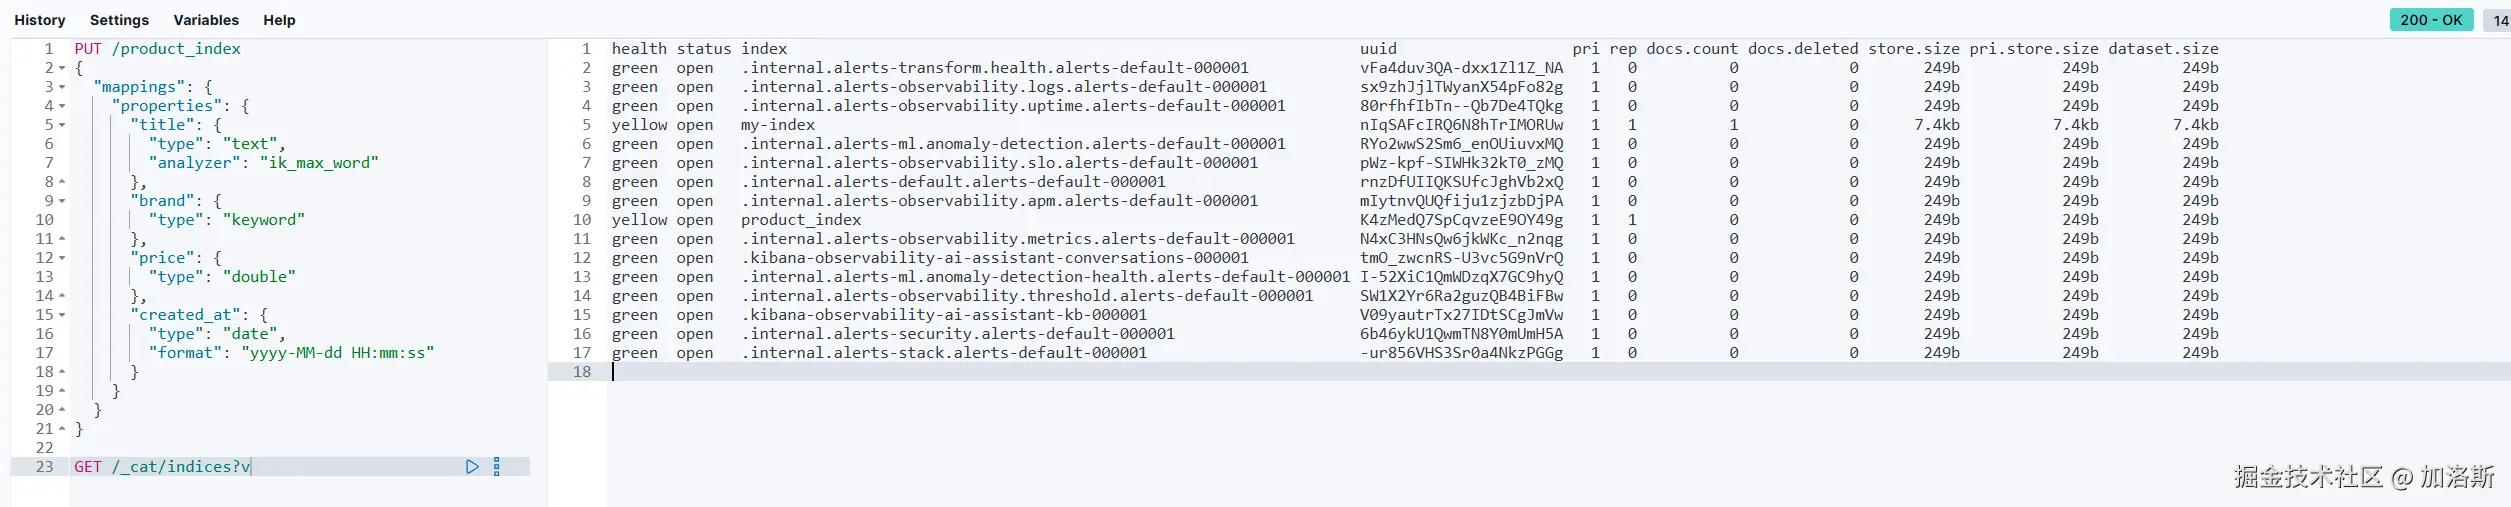
- 查看指定索引的
Mapping:
http
GET /product_index/_mapping效果:返回你刚才定义的字段结构。如果你没写 Mapping 而是让 ES 自动猜的,也可以用这个命令看看它猜成了什么类型。
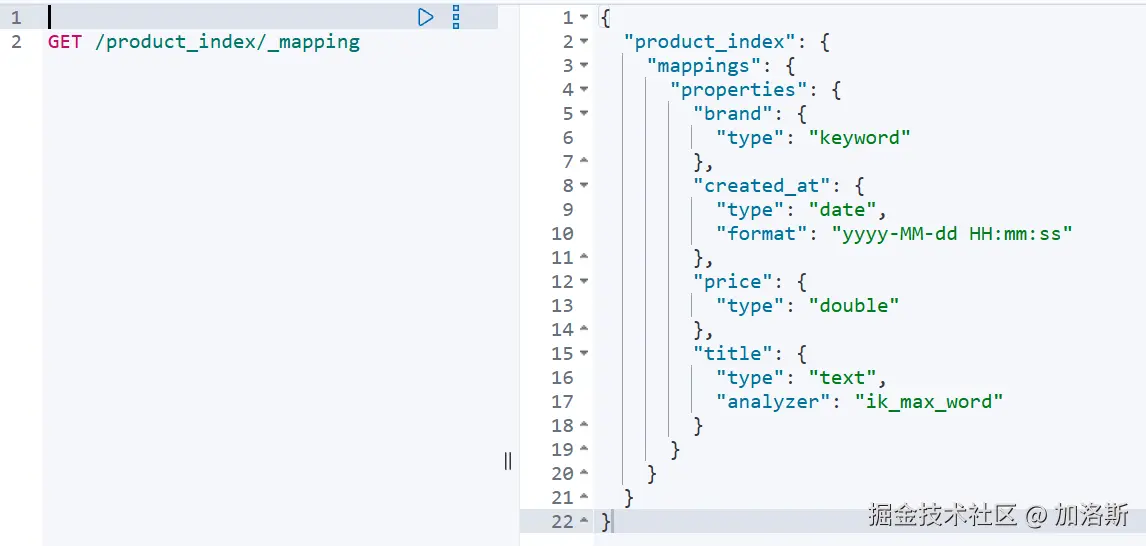
- 查看指定索引的 Settings:
http
GET /product_index/_settings效果:查看分片数、副本数等物理配置。(看不懂 AI 一下吧,这是架构师干的活)
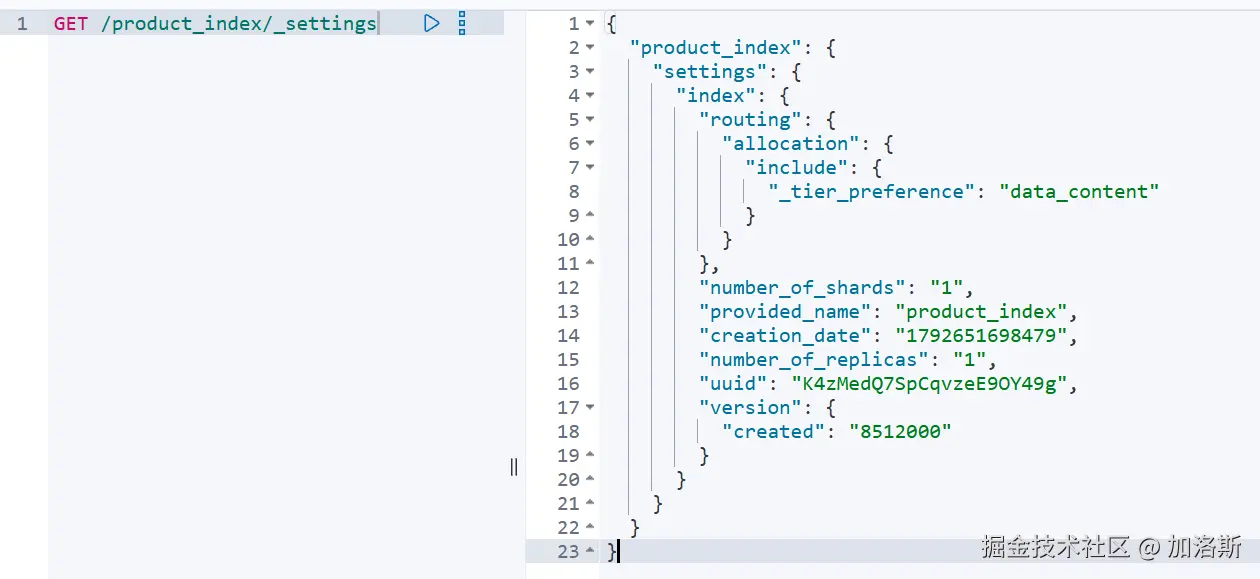
2. 修改索引
在 MySQL 中,如果表建错了,我们可以随时用 ALTER TABLE 修改字段类型。但在 ES 中,这是一条铁律:索引的字段类型(Mapping)建立后,绝对不能修改!
为什么?回想一下前面讲过的倒排索引 。数据写入时,ES 已经根据字段类型(比如 text 还是 keyword)把词条切好并建好索引了。如果允许你随意改类型,底层的数据结构就会彻底乱套,所以 ES 直接锁死了这个操作。
那如果真的要改,怎么办?
- 只能新增字段,不能修改老字段 :你可以往已有的
Mapping里添加新的字段(比如加一个stock库存字段),这没问题。 - 重建索引(终极方案) :如果你真把
price建成了text,非要改成double。唯一的办法是:新建一个Mapping正确的索引 → 用_reindexAPI 把老数据导过去 → 删掉老索引 → 给新索引起个老名字。
不过,有两个配置是可以随时通过 API 动态修改的:
① 修改副本数
比如你觉得现在查询压力太大,想把副本数从 1 增加到 2,直接执行:
http
PUT /product_index/_settings
{
  "number_of_replicas": 2
}
② 新增字段
虽然老字段的类型不能改,但如果你后续业务需要,随时可以往已有的索引里新增字段。
假设我们现在要给 product_index 增加一个 stock(库存)字段,语法如下:
http
PUT /product_index/_mapping
{
  "properties": {
    "stock": {
      "type": "integer"
    }
  }
}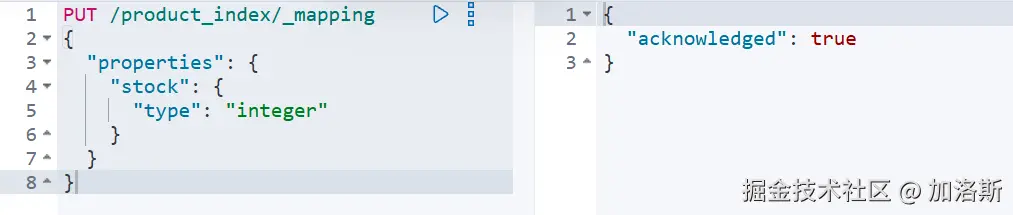
执行成功后,ES 会返回 {"acknowledged": true}。
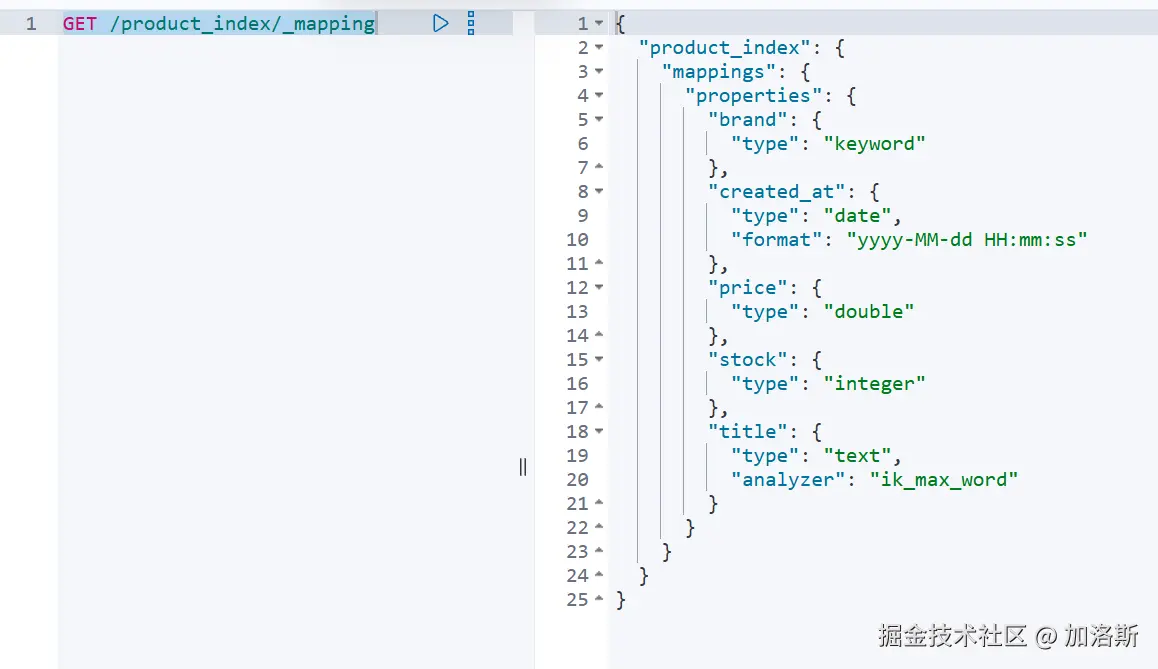
⚠️ 新增字段的注意事项:
- 历史数据不会自动填充 :你新增了
stock字段,之前已经写入的那些文档里,这个字段是不存在 的(查出来是 null)。只有新写入的、或者通过_updateAPI 局部更新的文档,才会拥有这个字段。- 直接写入即可 :只要
Mapping里加了stock,你在写入新文档时,直接在 JSON 里带上 "stock": 100 就行了,ES 会自动把它塞进倒排索引。- 如果开启了动态映射(
Dynamic Mapping) ,其实你根本不需要手动用PUT来加字段。你直接往文档里写一个之前没见过的字段,ES 会自动帮你把Mapping补上。但在生产环境中,强烈建议关闭动态映射,必须像上面这样手动声明,防止脏数据污染索引结构。
!!!!!修改分词器?不行!
如果你建索引时用了默认分词器,后来装了 IK 分词器想改,直接改 Mapping 是不行的。必须重建索引。生产环境建索引前,一定要先确认好分词器。
注:这里可以引出,如果要重建索引,通常会用
_reindex结合 alias 别名来做平滑过渡,这是高级架构师的常规操作。
3. 删除索引(Delete)
删除索引的语法极其简单,甚至简单到有点危险:
http
DELETE /product_index⚠️ 避坑指南:
在 ES 8 中,如果你写成了
DELETE /product_index,product_index2,,或者DELETE/ ,ES 默认是直接拒绝执行的!因为在 ES 8 的默认配置(
action.destructive_requires_name: true)下,禁止使用通配符或_all删除索引,防止误删整个集群的数据。如果你的业务确实需要通配符删除(比如按天滚动的日志索引),必须在配置文件elasticsearch.yml中显式关闭这个保护机制。生产环境请慎用。
3.3 增删改查文档
索引(Index)相当于 MySQL 里的表结构,而**文档(Document)**就相当于表里的一行行数据(Row),通常以 JSON 格式表示。
在 ES 早期版本(6.x 及以前),一个索引下可以有多个 Type(比如 _doc、user 等),类似一个库有多张表。但在 ES 8 中,Type 概念已被彻底移除 ,所有文档统一存放在 _doc 端点下。
1. 新增/全量替换文档(Create / Update)
向索引中写入一条数据,通常使用 PUT 或 POST 方法。
方式 A:指定 ID 写入(PUT)
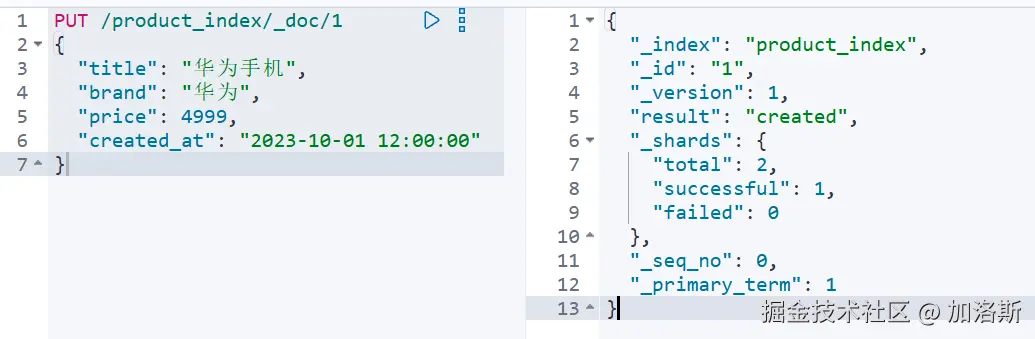
如果你希望自己控制文档的唯一 ID(比如商品 ID),使用 PUT:
http
PUT /product_index/_doc/1
{
  "title": "华为手机",
  "brand": "华为",
  "price": 4999,
  "created_at": "2023-10-01 12:00:00"
}
方式 B:自动生成 ID 写入(POST)
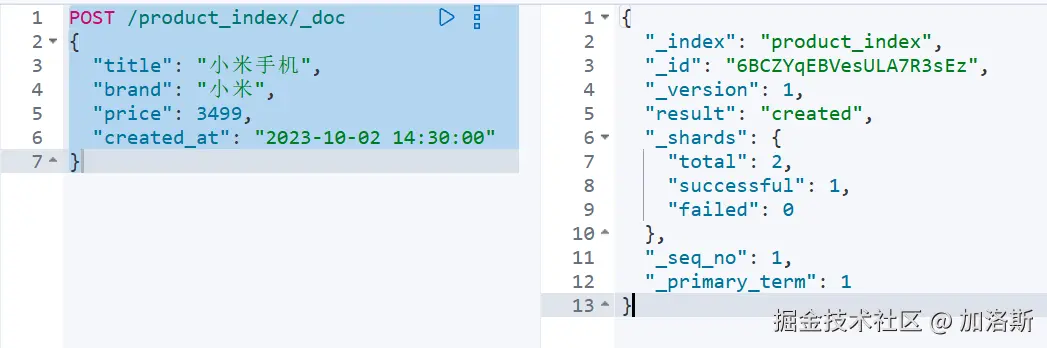
如果你不想自己维护 ID,可以使用 POST,ES 会自动生成一个随机的唯一字符串(如 mX3zY4sB...):
http
POST /product_index/_doc
{
  "title": "小米手机",
  "brand": "小米",
  "price": 3499,
  "created_at": "2023-10-02 14:30:00"
}
💡 核心机制提醒:
在 ES 中,没有真正的「修改」操作 。如果你对同一个 id(比如 1)再次执行
PUT,ES 并不会去原文档上修改字段,而是把旧文档标记为删除,然后写入一条全新的文档。这就是为什么 ES 的更新(Update)本质上也是全量替换。
2. 更新文档(Update)
| 写法 | 语义 | 行为 |
|---|---|---|
| PUT /product_index/_doc/1 | 全量替换 | 用请求体整个覆盖 ID=1 的文档 |
| POST /product_index/_doc/1 | 全量替换/新建 | 同上,ID 已存在则覆盖 |
| POST /product_index/_update/1 | 局部更新 | 只改请求体里指定的字段,其余字段保留 |
写法一:PUT /product_index/_doc/1 全量替换
http
PUT /product_index/_doc/1
{
  "price": 4500
}
查询结果:
json
{
  "_version": 2,
  "_source": {
    "price": 4500
  }
}
结果 :title、brand、created_at 全部丢失,文档只剩 price。
原因 :PUT /_doc/1 的请求体被当作文档的新全貌,没写的字段就是没有。
写法二:POST /product_index/_doc/1 全量替换/新建
先把文档恢复到完整状态:
http
PUT /product_index/_doc/1
{
  "title": "iPhone 15",
  "brand": "Apple",
  "price": 8999,
  "created_at": "2026-10-22 10:00:00"
}
然后执行:
http
POST /product_index/_doc/1
{
  "price": 4500
}
查询结果:
json
{
  "_version": 4,
  "_source": {
    "price": 4500
  }
}结果:和写法一一样,其他字段全丢。
和写法一的唯一区别在 ID 不存在时:
http
POST /product_index/_doc/999
{
  "price": 100
}
ID=999 不存在,POST /_doc/999 会自动创建这条文档。而 PUT /_doc/999 同样也会创建。所以在指定 ID 的情况下,两者行为几乎一致:存在则覆盖,不存在则创建。
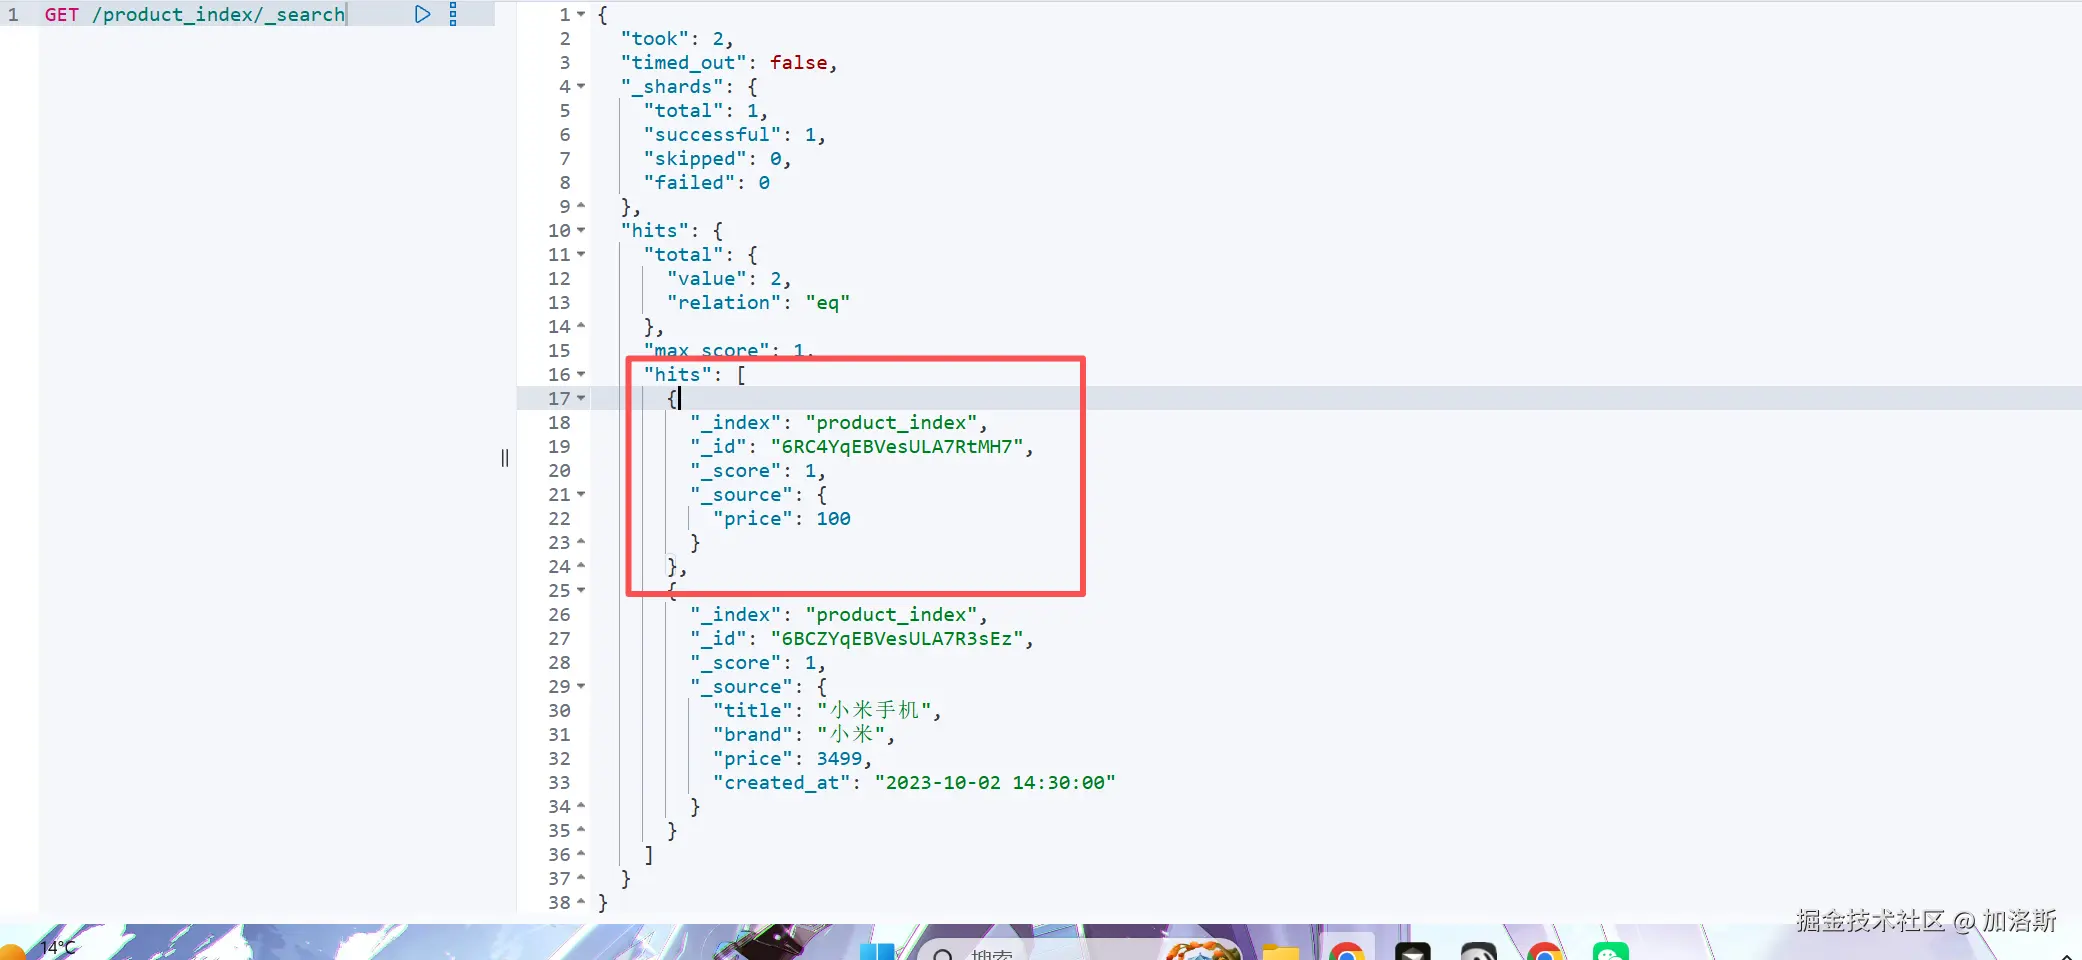
真正的区别是:POST /_doc 不带 ID 时,ES 自动生成 ID;PUT /_doc/1 必须带 ID。
http
POST /product_index/_doc
{
  "price": 100
}
这条会返回一个 ES 自动生成的 _id。
如果你只想修改某个字段(比如把商品 1 的价格降下来),不想把整个 JSON 重新传一遍,可以使用 _update API:
http
POST /product_index/_update/1
{
  "doc": {
    "price": 4500
  }
}
为什么请求体外面要包一层 "doc"
这是 _update API 的固定格式:
json
{
  "doc": {
    "要改的字段": "新值"
  }
}
doc 这个词在这里就是要合并进原文档的片段 。除了 doc,_update 还支持其他同级参数,比如:
json
{
  "doc": { "price": 4500 },
  "doc_as_upsert": true
}doc:要更新的字段doc_as_upsert:如果文档不存在,就把 doc 的内容当新文档插入script:用脚本更新(比如price+= 100)upsert:文档不存在时插入的完整文档
所以 doc 不是随便包的,是 _update 的语法要求。
注意:_update 内部其实也是先查出旧文档,合并字段后,再重建整个倒排索引。所以频繁更新对 ES 的磁盘和 CPU 都有一定压力。
3. 查询文档(Read)
查文档分两条路:知道 id,直接取一条;不知道 id、按条件找,使用 _search。
| 类别 | 查询/入口 | 用途 | 示例(请求体核心部分) | 关键要点 / 避坑 |
|---|---|---|---|---|
| 搜索入口 | GET /product_index/_search |
按条件在索引里找文档,请求体是 Query DSL | {"query":{"match_all":{}}} |
不带条件相当于扫索引文档,默认最多返回 10 条;真正干活的是 query 里的子句 |
| 全文检索 | match |
对查询词分词后去倒排索引匹配,并计算 _score |
{"query":{"match":{"title":"手机"}}} |
字段须是 text 且配置了分词器(如 ik_max_word);搜索时和索引时分析器要对得上;不要拿 keyword 字段用 match 做整句匹配 |
| 精确匹配 | term |
不分词,整段相等才算命中 | {"query":{"term":{"brand":"华为"}}} |
适合 keyword 字段;text 字段别乱用 term,分词后倒排里往往没有"整句"词条,容易查空 |
| 范围查询 | range |
按数值/时间区间过滤 | {"query":{"range":{"price":{"gte":1000,"lte":5000}}}} |
时间字段同理,换成 created_at 并注意 Mapping 里的 format;本章手写 Mapping 是 created_at,第四章注解实体是 createdAt,别混 |
| 组合条件 | bool |
把多个条件拼起来 | {"query":{"bool":{"must":[{"match":{"title":"手机"}}],"filter":[{"term":{"brand":"华为"}},{"range":{"price":{"gte":1000,"lte":5000}}}]}}} |
must 参与打分(适合全文);filter 不打分、结果更容易被缓存(适合精确过滤和区间) |
| 条数与分页 | size / from |
控制返回条数和分页 | "size": 20, "from": 0 |
默认一次返回 10 条;深分页(很大的 from)有坑,先养成"别一次捞太多"的习惯 |
| 删除文档(相关但非搜索) | DELETE /product_index/_doc/1 |
删除指定文档 | --- | 成功返回含 "result": "deleted";DELETE 不会立刻物理抹盘,先在 .del 打标记,段合并时才清理;ES 更适合"追加为主",不适合高频改删主库 |
| (1)按 id 查 |
http
GET /product_index/_doc/1这里的 _doc 是 API 路径里的占位,固定写 _doc ,别换成 _type、user 之类。ES 8 里 Type 已经没了,文档 API 路径上却还留着 _doc 这个名字------可以把它理解成「文档操作」的缩写,而不是类型名。
前文建索引时说 ES 8 不再需要在 Mapping 里写
_doc;但按 id 读写文档时,路径里仍然要带它。
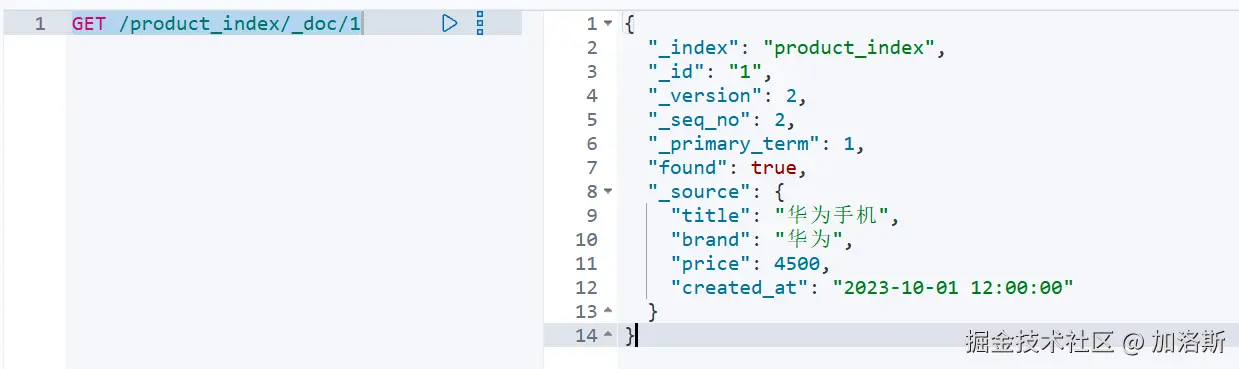
| 字段 | 含义 |
|---|---|
_index |
文档所在索引 |
_id |
文档 ID |
_version |
版本号,每更新一次 +1 |
_seq_no |
分片内序列号,用于并发控制 |
_primary_term |
主分片任期,配合 _seq_no 做乐观锁 |
found |
是否找到;id 不存在时为 false |
_source |
文档原始内容 |
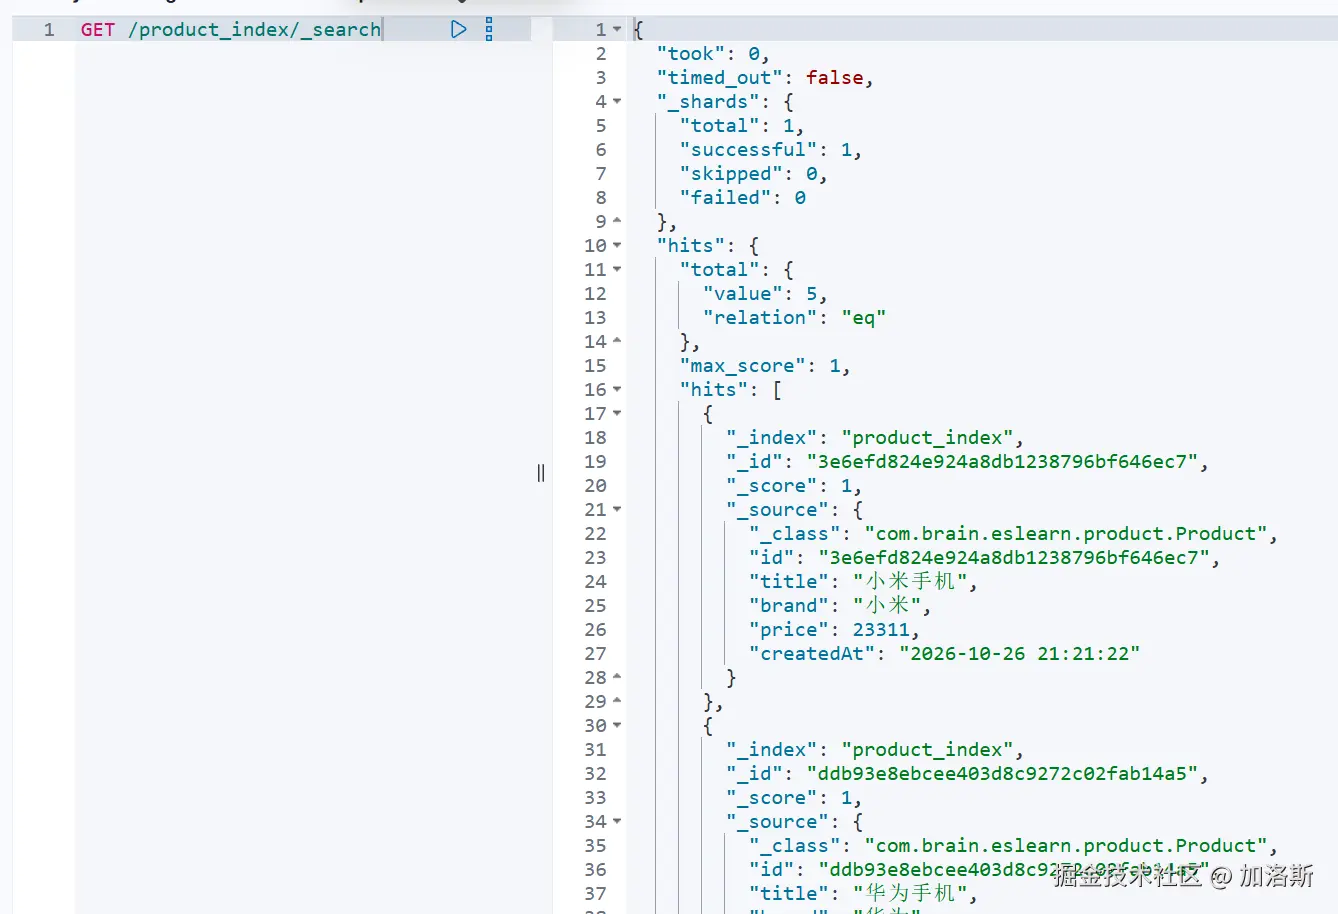
(2)搜索入口:_search
按 id 查是「拿这一本」;_search 是「按条件在书架上找」。请求体是 Query DSL
http
GET /product_index/_search
{
  "query": {
    "match_all": {}
  }
}
不带条件时相当于扫索引里的文档(默认最多返回 10 条)。真正干活的是 query 里换上的各种子句。
 (3)
match:全文检索
搜标题里和「手机」相关的商品:
http
GET /product_index/_search
{
  "query": {
    "match": {
      "title": "手机"
    }
  }
}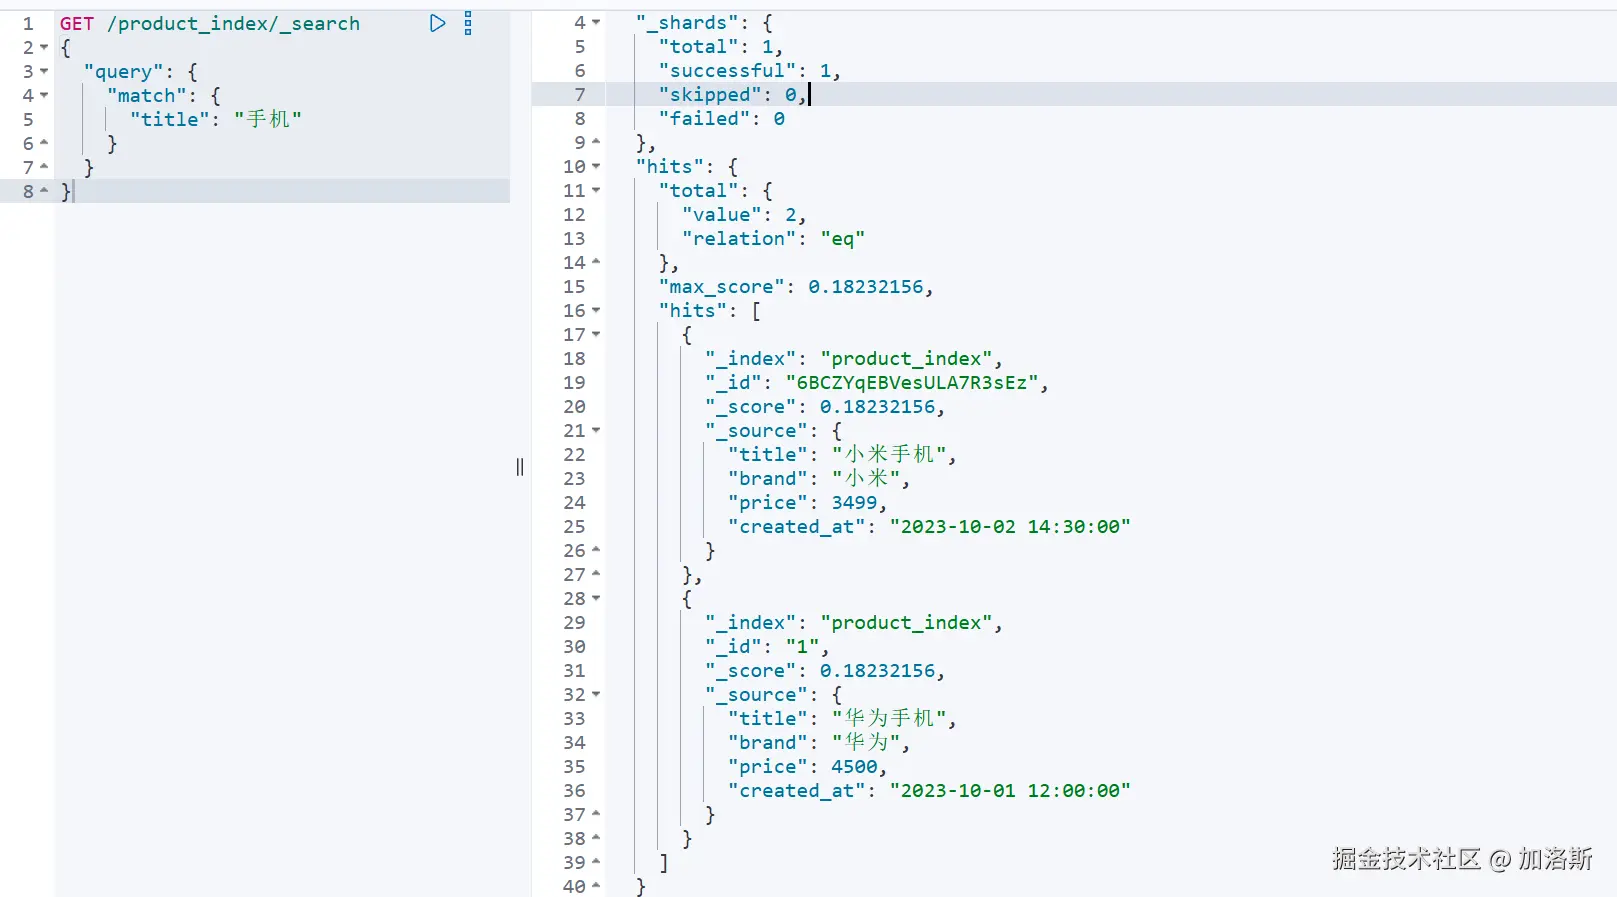
match 会对查询词做分词,再去倒排索引里匹配,并算出 _score。回头看我们建索引时的 Mapping:title 是 text,还配了 ik_max_word------所以「华为手机」会按中文词条去搜,而不是整句查询。
说人话就是这么回事:
你在 Kibana 里搜「华为手机」,match 不会 拿整句「华为手机」去标题里做字符串全等比对。它会先问分词器:这句话能拆成哪些词?配了 ik_max_word 之后,大致会拆成「华为」「手机」这类词条。
索引那边呢?写入文档时,title 因为是 text,同样已经被 IK 拆过,倒排索引里存的是「词条 → 哪些文档」:比如「手机」下面挂着文档 1、2,「华为」下面挂着文档 2、5。搜索时就拿拆出来的词条去这张表里查,命中的文档收进结果集。
然后 ES 还会给每条命中算个 _score(分数):大概意思是「这条有多像你要找的」。两个词都沾上的,通常比只沾上一个词的分数高,是相关度在排队。
这也是为什么 Mapping 很重要:
title必须是会分词的text,并且索引时、搜索时用的分析器要对得上。要是你把标题建成keyword,整句存成一个死词条,再用match去搜「手机」,往往对不上,结果就空了或很怪。全文搜索用match;品牌这种要整段相等的,才轮到后面的term。
(4)term:精确匹配
品牌是 keyword,不分词,整段相等才算命中。这时用 term:
http
GET /product_index/_search
{
  "query": {
    "term": {
      "brand": "华为"
    }
  }
}
避坑 :
keyword用term;text字段别乱用term------分词后倒排里往往没有「整句」那一个词条,很容易查空。全文场景用match。
(5)range:范围
价格区间举个短例子就够:
http
GET /product_index/_search
{
  "query": {
    "range": {
      "price": {
        "gte": 1000,
        "lte": 5000
      }
    }
  }
}
时间字段同理,把字段换成 created_at,并带上建 Mapping 时写的 format(本章手写 Mapping 是下划线 created_at;第四章注解实体会变成 createdAt,两边别混)。
(6)bool:组合条件
真实业务很少只塞一个条件。用 bool 把上面几样拼起来:标题要相关度,品牌和价格当门禁。
http
GET /product_index/_search
{
  "query": {
    "bool": {
      "must": [
        { "match": { "title": "手机" } }
      ],
      "filter": [
        { "term": { "brand": "华为" } },
        { "range": { "price": { "gte": 1000, "lte": 5000 } } }
      ]
    }
  }
}
must会参与打分(适合全文);filter不打分、结果更容易被缓存(适合精确过滤和区间)。
bool 里的条件,其实就分两种放法。
一种是让ES去计算分数,谁分数高谁排前面
标题用 match 搜「手机」就是这种:有的标题「华为手机」两个词都沾,有的只沾「手机」一个,你希望更贴的排前面------那就扔进 must,让 ES 去算 _score。
另一种是过滤,你必须符合我写的要求才能被查询出来
品牌必须是华为、价格必须在 1000 到 5000,这种没有更像一点的说法,过了就留、不过就搜不到。那就放 filter里面。
实战就一句话:全文 match 进 must,精确值和区间 term、range 进 filter。
别把过滤条件硬塞进 must 让它参与打分,也别指望 filter 帮你把相关的结果往前排------它只管筛,不管排。
(7)条数与分页
默认一次返回 10 条。需要时可以加 "size": 20、"from": 0。深分页(很大的 from)有坑,留给后面单独说。
4. 删除文档(Delete)
http
DELETE /product_index/_doc/1成功时返回里会有 "result": "deleted"。
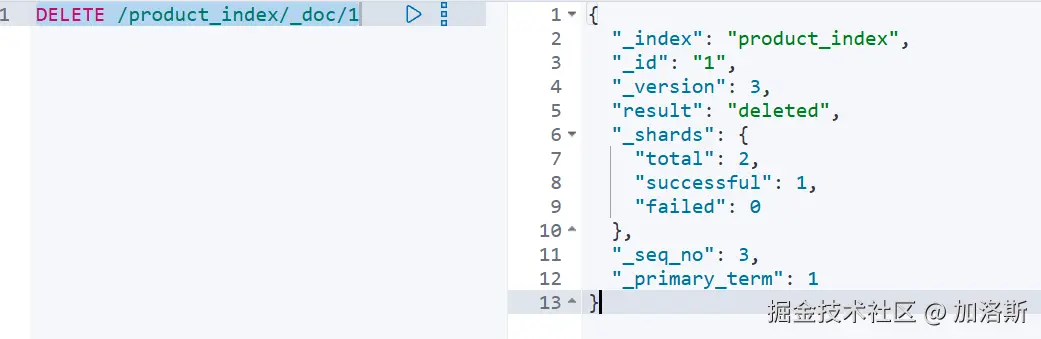
避坑 :
DELETE不会立刻把磁盘数据抹掉,先在.del里打标记,等Lucene段合并时再物理清理。所以频繁删改会让磁盘短暂膨胀、CPU 忙一阵------ES 更适合「追加为主」,不太适合当高频改删的主库。
四、元婴整合
我们在 Kibana 里把 REST 和 DSL 进行了实验 。但是在业务项目里总不能每次手拼 JSON 发 HTTP------这一章就把同样的操作使用 Spring Boot 3 + Spring Data Elasticsearch 实现,看看真实开发项目是怎么做的。
4.1 选型
网上还能搜到大量 RestHighLevelClient 的教程,那是 ES 7 时代的旧客户端,ES 8 已废弃,别再跟。
官方方向是 Java API Client (co.elastic.clients:elasticsearch-java)。在 Spring Boot 里,日常我们用 spring-boot-starter-data-elasticsearch:它帮你接好客户端,并提供 ElasticsearchRepository、ElasticsearchOperations 这些工程化封装。
4.2 依赖与配置
1. 引入依赖(Spring Boot 3 需要 JDK 17+):
xml
<!-- Elasticsearch 8 Java 客户端。版本跟着 Spring Boot,当前是 8.18.8 -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-elasticsearch</artifactId>
</dependency>
<!-- RestClient 在这个包里。starter 只是传递依赖,IDE 经常解析不到 org.elasticsearch -->
<dependency>
    <groupId>org.elasticsearch.client</groupId>
    <artifactId>elasticsearch-rest-client</artifactId>
</dependency>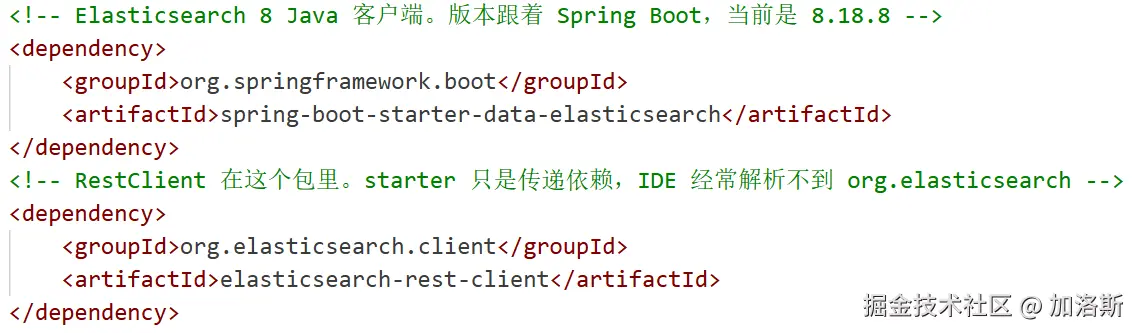
注:这个 starter 底层已经自动适配了新的 Java API Client。
2. 配置类
先在配置里写好 url、用户名、密码。ES 7 默认可以不开安全;ES 8 默认开安全模式,第一次启动会给内置用户 elastic 生成密码,客户端必须带账号。
下面这段是固定写法------看不懂也没关系,先复制,把配置项对上你的环境:
java
/**
 * Elasticsearch 客户端。
 */
@Configuration
public class ElasticsearchConfig {

    @Value("${spring.elasticsearch.url}")
    private String url;

    @Value("${spring.elasticsearch.username}")
    private String username;

    @Value("${spring.elasticsearch.password}")
    private String password;

    // 底层网络客户端,负责发 HTTP。服务停掉时调用 close,把连接池关掉
    @Bean(destroyMethod = "close")
    public RestClient elasticsearchRestClient() {
        if (!StringUtils.hasText(url)) {
            throw new IllegalStateException("Elasticsearch 地址未配置");
        }
        HttpHost host = HttpHost.create(url.trim());
        BasicCredentialsProvider credentialsProvider = new BasicCredentialsProvider();
        credentialsProvider.setCredentials(AuthScope.ANY, new UsernamePasswordCredentials(username, password));
        return RestClient.builder(host)
                .setHttpClientConfigCallback(httpClientBuilder ->
                        httpClientBuilder.setDefaultCredentialsProvider(credentialsProvider))
                .build();
    }

    // 业务里注入的是这个:RestClient 管连接,这里再包一层做 JSON 编解码
    @Bean
    public ElasticsearchClient elasticsearchClient(RestClient elasticsearchRestClient) {
        RestClientTransport transport = new RestClientTransport(elasticsearchRestClient, new JacksonJsonpMapper());
        return new ElasticsearchClient(transport);
    }

}
4.3 实体与 Repository
金丹期我们手写 JSON Mapping;到了 Spring Data,用注解把 Java 类映射成索引结构:
java
/**
 * 商品索引(product_index)。分词用 ik_max_word,集群上要先装好 IK 插件。
 */
@Data
@Document(indexName = "product_index")
public class Product {

    @Id
    private String id;

    @Field(type = FieldType.Text, analyzer = "ik_max_word")
    private String title;

    @Field(type = FieldType.Keyword)
    private String brand;

    @Field(type = FieldType.Double)
    private Double price;

    @Field(type = FieldType.Date, format = {}, pattern = "yyyy-MM-dd HH:mm:ss")
    private LocalDateTime createdAt;

}
字段名提醒 :第三章手写 Mapping 用的是
created_at;这里 Java 属性是createdAt,Spring Data 默认按属性名落到 ES。查、写都要和当前索引真实字段名对齐,别两套混着用。
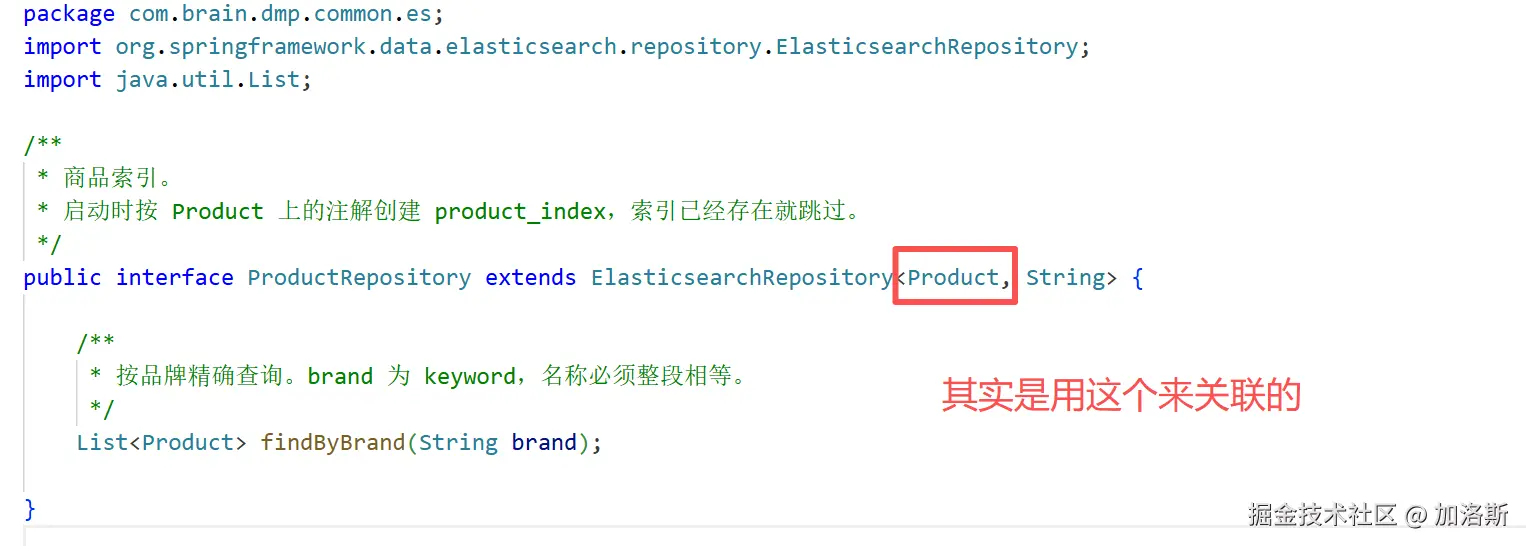
Repository 继承 ElasticsearchRepository 即可。启动时会按注解创建 product_index(索引已存在则跳过):
java
/**
 * 商品索引。
 * 启动时按 Product 上的注解创建 product_index,索引已经存在就跳过。
 */
public interface ProductRepository extends ElasticsearchRepository<Product, String> {

    /** 按品牌精确查询。brand 为 keyword,名称必须整段相等。 */
    List<Product> findByBrand(String brand);

}
验证一下:先删掉旧的 product_index。
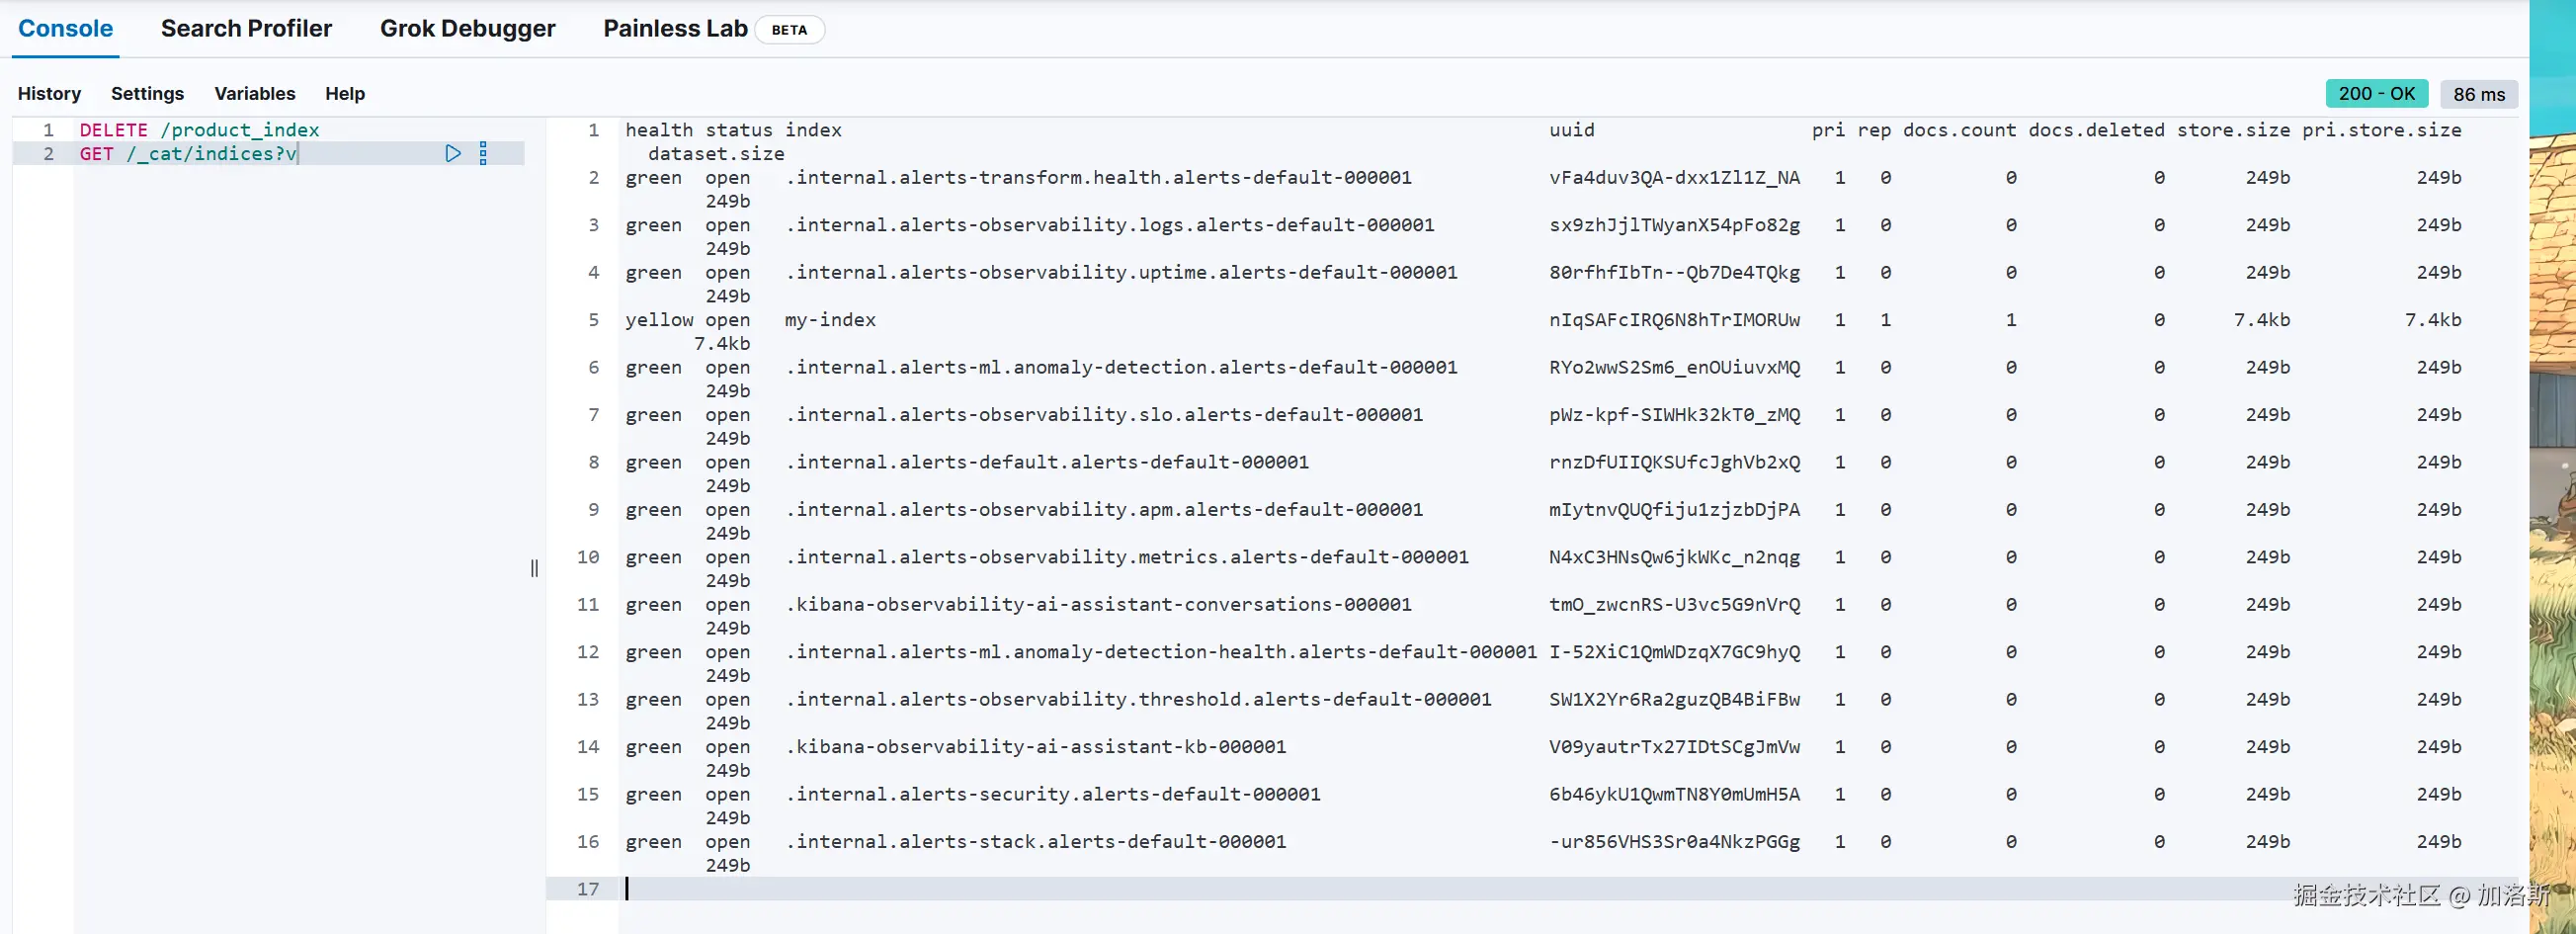
再启动项目,看会不会自动建回来:
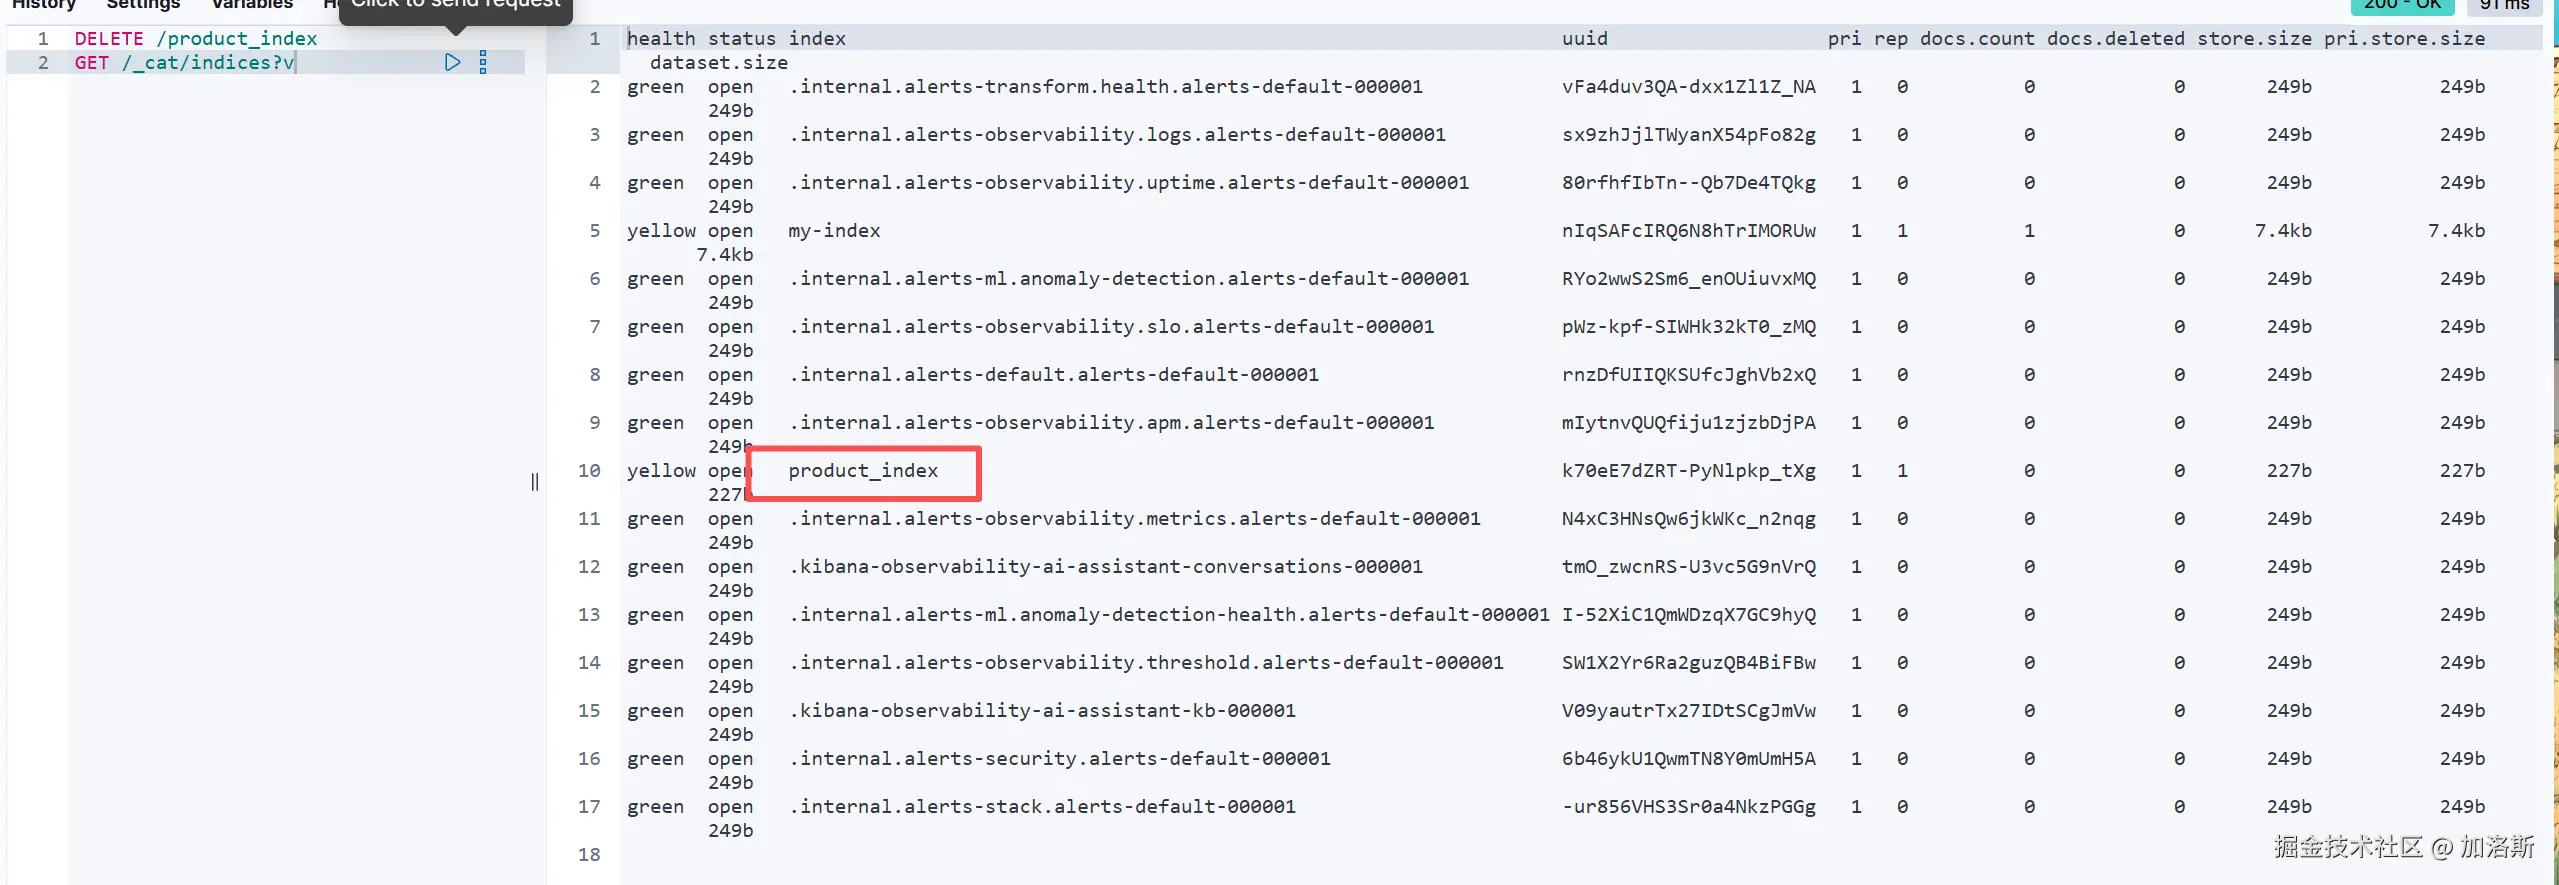
索引创建成功。
4.4 CRUD
实体和 Repository 有了,接下来把增删改查接到业务接口上。
接口骨架:Controller + Service + VO
Controller 只负责收参、校验、回包,不自己拼 DSL:
java
@Tag(name = "商品索引")
@RestController
@RequestMapping("/product/product")
@Validated
public class ProductController {

    @Resource
    private ProductService productService;

    @Operation(summary = "新增商品")
    @PostMapping("/save")
    public CommonResult<String> save(@Valid @RequestBody ProductSaveReqVO reqVO) {
        return CommonResult.success(productService.save(reqVO));
    }

    @Operation(summary = "查询商品")
    @GetMapping("/get")
    public CommonResult<ProductRespVO> get(@RequestParam("id") String id) {
        if (!StringUtils.hasText(id)) {
            throw new ServiceException(ErrorCode.BAD_REQUEST, "商品编号不能为空");
        }
        return CommonResult.success(productService.get(id));
    }

    @Operation(summary = "修改商品")
    @PostMapping("/update")
    public CommonResult<Boolean> update(@Valid @RequestBody ProductSaveReqVO reqVO) {
        productService.update(reqVO);
        return CommonResult.success(true);
    }

    @Operation(summary = "删除商品")
    @PostMapping("/remove")
    public CommonResult<Boolean> remove(@RequestParam("id") String id) {
        if (!StringUtils.hasText(id)) {
            throw new ServiceException(ErrorCode.BAD_REQUEST, "商品编号不能为空");
        }
        productService.remove(id);
        return CommonResult.success(true);
    }

}
Service 接口:
java
public interface ProductService {

    String save(ProductSaveReqVO reqVO);

    ProductRespVO get(String id);

    void update(ProductSaveReqVO reqVO);

    void remove(String id);

}
实现类开头大概长这样:注入 Repository 和转换器,私有方法 findProduct 后面增改查删都会用到。
java
@Slf4j
@Service
@AllArgsConstructor
public class ProductServiceImpl implements ProductService {

    private final ProductRepository productRepository;

    private final ProductConvert productConvert;

    // 复杂搜索时再注入 ElasticsearchOperations,见「查」小节

    private Product findProduct(String id) {
        return productRepository.findById(id).orElseThrow(() -> {
            log.warn("【商品索引】商品不存在,id={}", id);
            return new ServiceException(ErrorCode.BAD_REQUEST, "商品不存在");
        });
    }

}
入参 / 出参 VO 按项目习惯用 @Data + @Schema 即可:
java
@Data
@Schema(description = "商品信息")
public class ProductRespVO {

    @Schema(description = "商品编号")
    private String id;

    @Schema(description = "商品标题")
    private String title;

    @Schema(description = "品牌")
    private String brand;

    @Schema(description = "价格")
    private BigDecimal price;

    @Schema(description = "创建时间")
    private LocalDateTime createdAt;

}

@Data
@Schema(description = "商品保存参数")
public class ProductSaveReqVO {

    @Schema(description = "商品编号")
    private String id;

    @NotBlank(message = "商品标题不能为空")
    @Schema(description = "商品标题")
    private String title;

    @NotBlank(message = "品牌不能为空")
    @Schema(description = "品牌")
    private String brand;

    @NotNull(message = "价格不能为空")
    @Schema(description = "价格")
    private BigDecimal price;

    @Schema(description = "创建时间")
    private LocalDateTime createdAt;

}
1. 增
业务代码
完整的 save 方法如下:
java
@Override
public String save(ProductSaveReqVO reqVO) {
    if (StringUtils.hasText(reqVO.getId()) && productRepository.existsById(reqVO.getId())) {
        log.warn("【商品索引】新增商品失败,编号已存在,id={}", reqVO.getId());
        throw new ServiceException(ErrorCode.BAD_REQUEST, "商品编号已存在");
    }
    Product product = productConvert.toProduct(reqVO);
    if (!StringUtils.hasText(product.getId())) {
        product.setId(UUID.randomUUID().toString().replace("-", ""));
    }
    if (product.getCreatedAt() == null) {
        product.setCreatedAt(LocalDateTime.now());
    }
    log.info("【商品索引】新增商品,id={}", product.getId());
    productRepository.save(product);
    return product.getId();
}
save 到底是什么
productRepository.save(product) 不用你自己实现。ProductRepository 继承了 ElasticsearchRepository,往上又接到 CrudRepository,save 是内置方法。
语义上有点像 MyBatis-Plus 的 saveOrUpdate:有文档就覆盖写,没有就新建。
有 id 时,底层大致对应之前讲过的:
http
PUT /product_index/_doc/{id}也就是把整份 JSON 盖上去。没有 id(若真交给框架生成)会走 ES 自动分配 _id 的路径;我们项目里更常见的是先补 UUID 再 save。
调一下接口:
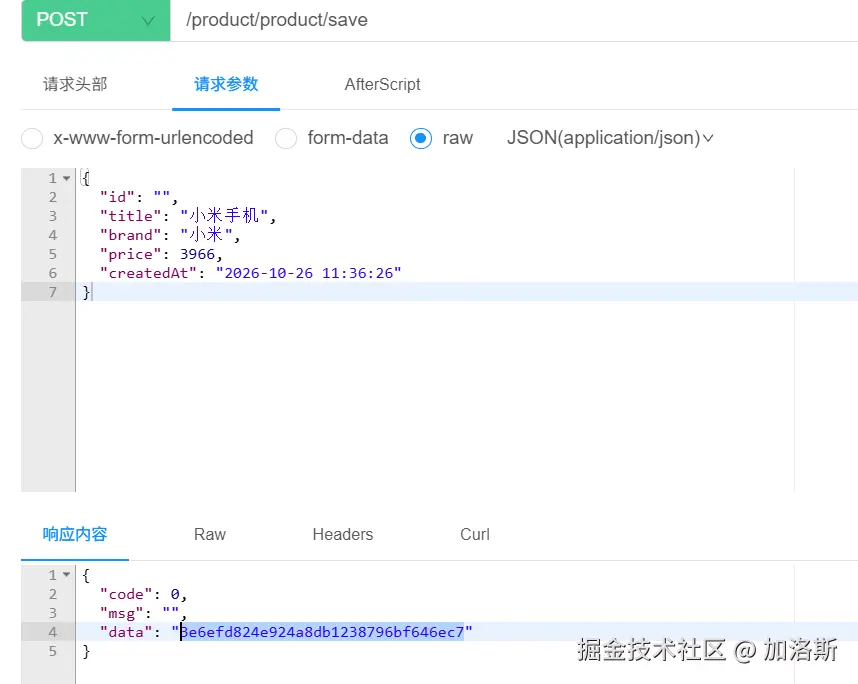
用返回的 id 在 Kibana 里核对一下:
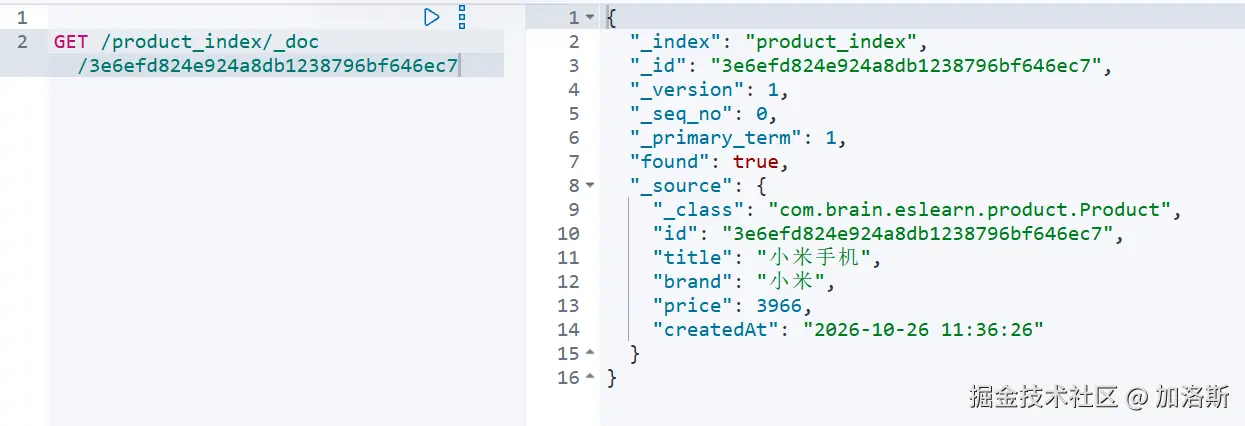
2. 改
完整 update
java
@Override
public void update(ProductSaveReqVO reqVO) {
    if (!StringUtils.hasText(reqVO.getId())) {
        throw new ServiceException(ErrorCode.BAD_REQUEST, "商品编号不能为空");
    }
    Product dbProduct = findProduct(reqVO.getId());
    Product product = productConvert.toProduct(reqVO);
    product.setId(dbProduct.getId());
    if (product.getCreatedAt() == null) {
        product.setCreatedAt(dbProduct.getCreatedAt());
    }
    log.info("【商品索引】修改商品,id={}", product.getId());
    productRepository.save(product);
}
为啥还是 save
改文档在 Repository 这一层还是 save。带了已存在的 id,语义就是覆盖式写入,对应第三章的 PUT /_doc/{id} 全量替换。
业务上多了几步,都是为了不触发全量替换的坑
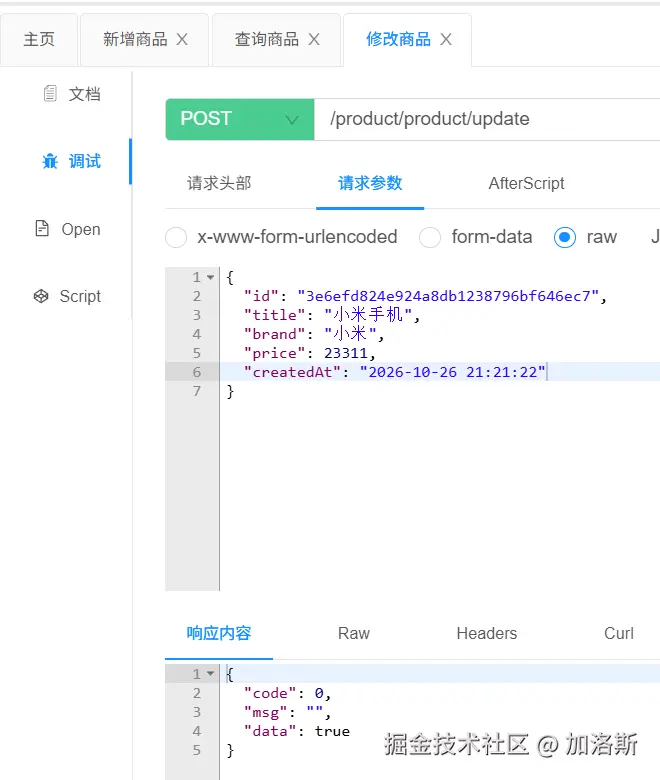
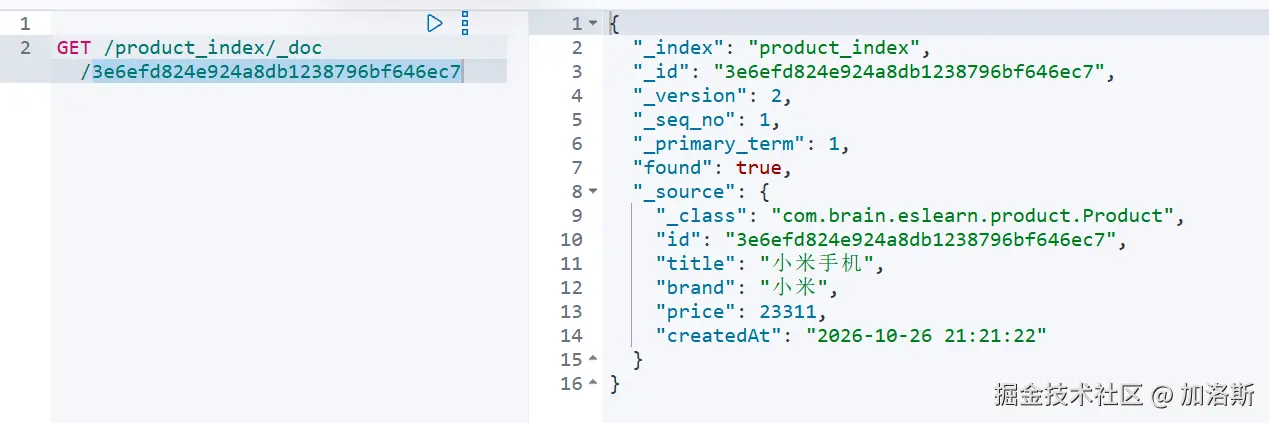
3. 查
查就比较复杂的多了,他有好几种方法,按 id、方法名派生、再到组合条件的 NativeQuery。
按 id 查:findById + findProduct
java
@Override
public ProductRespVO get(String id) {
    return productConvert.toResp(findProduct(id));
}

private Product findProduct(String id) {
    return productRepository.findById(id).orElseThrow(() -> {
        log.warn("【商品索引】商品不存在,id={}", id);
        return new ServiceException(ErrorCode.BAD_REQUEST, "商品不存在");
    });
}
findById 对应:
http
GET /product_index/_doc/{id}返回的是 Optional:有文档就取出转 VO,没有就抛业务异常。改、删共用同一个 findProduct,避免到处复制「不存在」的判断。
方法名派生:findByBrand
简单条件可以写在 Repository 上,Spring Data 按方法名生成查询:
java
List<Product> findByBrand(String brand);brand 是 keyword,这里语义就是精确相等,底层接近 term。
复杂业务查询
业务搜索常见形态是:「标题关键词 + 可选品牌 + 可选价格区间 + 可选时间区间」,有的条件传了、有的没传。这种动态组合,用 ElasticsearchOperations 拼 NativeQuery 最直接------把第三章的 bool DSL 用 Lambda 写出来,对照 Kibana 也好查。
简单 CRUD 继续走 ProductRepository;组合搜索走 ElasticsearchOperations。
完整 list 方法
java
@Override
public List<ProductRespVO> list(ProductQueryReqVO reqVO) {
    log.info("【商品索引】按条件查询,id={},title={},brand={},minPrice={},maxPrice={},createdAtStart={},createdAtEnd={}",
            reqVO.getId(), reqVO.getTitle(), reqVO.getBrand(), reqVO.getMinPrice(), reqVO.getMaxPrice(),
            reqVO.getCreatedAtStart(), reqVO.getCreatedAtEnd());
    NativeQuery query = NativeQuery.builder()
            .withQuery(q -> {
                if (!hasCondition(reqVO)) {
                    return q.matchAll(matchAll -> matchAll);
                }
                return q.bool(bool -> {
                    // 标题要相关度 → must + match;编号/品牌/区间是门禁 → filter
                    if (StringUtils.hasText(reqVO.getTitle())) {
                        bool.must(must -> must.match(match -> match.field("title").query(reqVO.getTitle())));
                    }
                    if (StringUtils.hasText(reqVO.getId())) {
                        bool.filter(filter -> filter.ids(ids -> ids.values(reqVO.getId())));
                    }
                    if (StringUtils.hasText(reqVO.getBrand())) {
                        bool.filter(filter -> filter.term(term -> term.field("brand").value(reqVO.getBrand())));
                    }
                    if (reqVO.getMinPrice() != null || reqVO.getMaxPrice() != null) {
                        bool.filter(filter -> filter.range(range -> range.number(number -> {
                            number.field("price");
                            if (reqVO.getMinPrice() != null) {
                                number.gte(reqVO.getMinPrice().doubleValue());
                            }
                            if (reqVO.getMaxPrice() != null) {
                                number.lte(reqVO.getMaxPrice().doubleValue());
                            }
                            return number;
                        })));
                    }
                    if (reqVO.getCreatedAtStart() != null || reqVO.getCreatedAtEnd() != null) {
                        bool.filter(filter -> filter.range(range -> range.date(date -> {
                            date.field("createdAt").format("yyyy-MM-dd HH:mm:ss");
                            if (reqVO.getCreatedAtStart() != null) {
                                date.gte(DATE_TIME_FORMATTER.format(reqVO.getCreatedAtStart()));
                            }
                            if (reqVO.getCreatedAtEnd() != null) {
                                date.lte(DATE_TIME_FORMATTER.format(reqVO.getCreatedAtEnd()));
                            }
                            return date;
                        })));
                    }
                    return bool;
                });
            })
            .withMaxResults(1000)
            .build();
    return elasticsearchOperations.search(query, Product.class)
            .stream()
            .map(SearchHit::getContent)
            .map(productConvert::toResp)
            .toList();
}
对照 DSL
上面这段 Java,在「标题、id、品牌、价格、时间都传了」时,等价于下面这份请求
json
POST /product_index/_search
{
  "size": 1000,
  "query": {
    "bool": {
      "must": [
        { "match": { "title": "华为手机" } }
      ],
      "filter": [
        { "ids": { "values": ["abc123"] } },
        { "term": { "brand": "华为" } },
        { "range": { "price": { "gte": 1000, "lte": 5000 } } },
        {
          "range": {
            "createdAt": {
              "gte": "2024-01-01 00:00:00",
              "lte": "2024-12-31 23:59:59",
              "format": "yyyy-MM-dd HH:mm:ss"
            }
          }
        }
      ]
    }
  }
}
对照关系:
bool.must(...match title...)→must+matchbool.filter(...ids / term / range...)→filterwithMaxResults(1000)→"size": 1000- 一个条件都没有 →
match_all(再被 size 截断)
拆 bool:每个条件放哪
和第三章同一套分工,这里落到代码上再说一遍。
标题 → must + match
java
bool.must(must -> must.match(match -> match.field("title").query(reqVO.getTitle())));标题是 text + IK,要分词、要相关度。用户搜「华为手机」,两个词都沾上的应该排更前------所以进 must,让 ES 算 _score。
id → filter + ids
java
bool.filter(filter -> filter.ids(ids -> ids.values(reqVO.getId())));按文档 _id 过滤,比自己对业务字段做 term 更直接。这里的 id 就是实体 @Id 映射出去的那个。
品牌 → filter + term
java
bool.filter(filter -> filter.term(term -> term.field("brand").value(reqVO.getBrand())));brand 是 keyword,不分词,整段相等才算。必须用 term,别用 match。传「华为」,就不会因为标题里带「华为」却品牌不是华为而误伤------品牌过滤走的是 keyword 倒排里的整词条。
价格 → filter + range.number
java
bool.filter(filter -> filter.range(range -> range.number(number -> {
    number.field("price");
    if (reqVO.getMinPrice() != null) {
        number.gte(reqVO.getMinPrice().doubleValue());
    }
    if (reqVO.getMaxPrice() != null) {
        number.lte(reqVO.getMaxPrice().doubleValue());
    }
    return number;
})));
新版 Java API Client 把 range 拆成了 number / date 等分支。gte / lte 就是大于等于 / 小于等于;只传一边也行。
创建时间 → filter + range.date
java
date.field("createdAt").format("yyyy-MM-dd HH:mm:ss");执行结果那几行:为啥要 getContent
java
return elasticsearchOperations.search(query, Product.class)
        .stream()
        .map(SearchHit::getContent)
        .map(productConvert::toResp)
        .toList();
search(query, Product.class):拿拼好的 query 去查,并把命中的_source反序列化成Product。- 返回类型是
SearchHits<Product>,里面每一条是SearchHit,除了文档本身还有_score、高亮、sort 值等元数据。 SearchHit::getContent:把外壳剥掉,只取出里面的Product。不做这一步,后面没法直接当实体用。productConvert::toResp:实体转前端 VO。toList():收成列表返回。
复杂的是「怎么拼 query」,不是「怎么取结果」------取结果这几行几乎每次搜索都同构。
withMaxResults(1000) 的问题
java
.withMaxResults(1000)教学演示可以这么写,一次最多查询 1000 条,避免默认 10 条太少、也避免无限拉。
正确做法是带上页码和页大小,走分页查询,下一节 4.5 就把日常 Spring 分页和深翻用的 search_after 讲透。
java
@Operation(summary = "条件查询商品")
@PostMapping("/list")
public CommonResult<List<ProductRespVO>> list(@RequestBody ProductQueryReqVO reqVO) {
    return CommonResult.success(productService.list(reqVO));
}
用
POST+ body 传组合条件比较省事;你项目习惯GET+ 查询参数也行,按规范改即可。
4. 删
java
@Override
public void remove(String id) {
    findProduct(id);
    log.info("【商品索引】删除商品,id={}", id);
    productRepository.deleteById(id);
}
先 findProduct:不存在就明确报错,避免「删一个根本没有的 id」却静默成功。再 deleteById,对应:
http
DELETE /product_index/_doc/{id}查询侧马上会找不到;磁盘上仍是先打 .del 标记、段合并后再物理清理------和第三章说的是同一套底层。业务上的软删除字段(deleted=true 再 filter 掉)是另一层事,别和引擎的 .del 混为一谈。
4.5 分页查询
上一节 list 用了 withMaxResults(1000),那只是临时查询。真正的列表接口要分页。日常 Spring Boot、数据量没到几百万那种,优先用 from + size(Spring 里就是 Pageable) ;一直往下滚、翻页数据非常多,此时就应该使用 search_after。
from + size 在 Kibana
ES 默认一次只给你 10 条。列表页肯定不够,请求里常带这两个字段:
http
GET /product_index/_search
{
  "from": 0,
  "size": 10,
  "query": {
    "match": {
      "title": "手机"
    }
  }
}size:这一页要几条,类似 SQL 的LIMIT。from:跳过前面多少条,类似OFFSET。第一页一般是from: 0, size: 10,第二页from: 10, size: 10,第三页from: 20, size: 10。
返回里有 hits.total(或 hits.total.value),告诉你符合条件的大概有多少条,前端算总页数靠它。这一页的数据在 hits.hits 数组里。
| 页码 | from | size |
|---|---|---|
| 第 1 页 | 0 | 10 |
| 第 2 页 | 10 | 10 |
| 第 3 页 | 20 | 10 |
公式:from = (页码 - 1) * 每页条数。
注意 :
from + size有上限,默认最大到 10000 。想一次from: 9990, size: 20还行,再往后会被拒。不是随便设的------from越大,查询越慢。
为啥慢?可以这么理解:from/size 这套分页,ES 大致得先在各分片上把前面那些「跳过」的候选也排出来,再丢掉,最后才把你要的那一页给你。页码靠前还好;你一翻到很后面(深分页),坐标排序和合并的成本会明显上去,集群也容易被拖慢。
所以:
- 普通后台列表、前几页浏览:
from+size够用。 - 一页别太大,常见 10 / 20 / 50,别动不动
size: 1000当分页用。 - 真要「一直往下翻、翻到很深」------无限滚动、导出超大结果------别死磕很大的
from,用后面的search_after。
日常 Spring 怎么写:Pageable
NativeQuery 上挂 Pageable,底层还是 from / size:
java
public PageResult<ProductRespVO> page(ProductQueryReqVO reqVO, int page, int size) {
    // Spring 的 PageRequest 页码从 0 开始:第 1 页传 0,第 2 页传 1
    Pageable pageable = PageRequest.of(page, size);

    NativeQuery query = NativeQuery.builder()
            .withQuery(q -> {
                if (!hasCondition(reqVO)) {
                    return q.matchAll(m -> m);
                }
                return q.bool(bool -> {
                    if (StringUtils.hasText(reqVO.getTitle())) {
                        bool.must(m -> m.match(t -> t.field("title").query(reqVO.getTitle())));
                    }
                    if (StringUtils.hasText(reqVO.getId())) {
                        bool.filter(f -> f.ids(i -> i.values(reqVO.getId())));
                    }
                    if (StringUtils.hasText(reqVO.getBrand())) {
                        bool.filter(f -> f.term(t -> t.field("brand").value(reqVO.getBrand())));
                    }
                    if (reqVO.getMinPrice() != null || reqVO.getMaxPrice() != null) {
                        bool.filter(f -> f.range(r -> r.number(n -> {
                            n.field("price");
                            if (reqVO.getMinPrice() != null) {
                                n.gte(reqVO.getMinPrice().doubleValue());
                            }
                            if (reqVO.getMaxPrice() != null) {
                                n.lte(reqVO.getMaxPrice().doubleValue());
                            }
                            return n;
                        })));
                    }
                    if (reqVO.getCreatedAtStart() != null || reqVO.getCreatedAtEnd() != null) {
                        bool.filter(f -> f.range(r -> r.date(d -> {
                            d.field("createdAt").format("yyyy-MM-dd HH:mm:ss");
                            if (reqVO.getCreatedAtStart() != null) {
                                d.gte(DATE_TIME_FORMATTER.format(reqVO.getCreatedAtStart()));
                            }
                            if (reqVO.getCreatedAtEnd() != null) {
                                d.lte(DATE_TIME_FORMATTER.format(reqVO.getCreatedAtEnd()));
                            }
                            return d;
                        })));
                    }
                    return bool;
                });
            })
            .withPageable(pageable)
            .build();

    SearchHits<Product> hits = elasticsearchOperations.search(query, Product.class);
    List<ProductRespVO> list = hits.stream()
            .map(SearchHit::getContent)
            .map(productConvert::toResp)
            .toList();
    long total = hits.getTotalHits();
    // PageResult 换成你项目里的分页包装即可:list + total + page + size
    return new PageResult<>(list, total, page, size);
}
几个容易踩的点:
PageRequest.of(page, size)的 page 从 0 起。前端若传「第 1 页」,进 Spring 前要减一,或者约定前端直接传 0-based。- 用
withPageable,不要再用withMaxResults(1000)冒充分页 。两者都能限制条数,但Pageable会同时带上from,才能翻到第 2、第 3 页。 - 总数从
SearchHits.getTotalHits()拿 ,列表仍是getContent那条链。包装成你们统一的PageResult/Page即可。
Controller 可以这样接收:
java
@Operation(summary = "分页查询商品")
@PostMapping("/page")
public CommonResult<PageResult<ProductRespVO>> page(@RequestBody ProductQueryReqVO reqVO,
                                                    @RequestParam(defaultValue = "0") int page,
                                                    @RequestParam(defaultValue = "10") int size) {
    return CommonResult.success(productService.page(reqVO, page, size));
}search_after:深翻页
from + size 翻到很后面时,前面说了,ES 得先把跳过的候选也排好再丢掉,页码越大越亏。数据多、又要一直往下翻(无限滚动、导出下一批),就别死磕很大的 from,改用 search_after。
思路:下一页不从「第 N 条」开始数,而是从「上一页最后一条」接着往后捞。
第一次还是普通搜索,但要带上稳定排序 (业务排序字段 + _id,避免分数或时间一样时顺序乱排序):
http
GET /product_index/_search
{
  "size": 10,
  "sort": [
    { "createdAt": "desc" },
    { "_id": "asc" }
  ],
  "query": {
    "match": { "title": "手机" }
  }
}
看返回里最后一条的 sort 值,比如 [1696152000000, "abc123"]。下一页把它原样塞进 search_after,不要再写 from:
http
GET /product_index/_search
{
  "size": 10,
  "search_after": [1696152000000, "abc123"],
  "sort": [
    { "createdAt": "desc" },
    { "_id": "asc" }
  ],
  "query": {
    "match": { "title": "手机" }
  }
}
ES 会从这条之后继续取 10 条。再翻页,就拿新一页最后一条的 sort 接着传。像接力,不靠「跳过前 10 万条」。
Spring 侧示意(查询条件仍可复用上一节的 bool 拼装,这里只突出 sort / search_after):
java
public List<ProductRespVO> searchAfter(ProductQueryReqVO reqVO,
                                       List<Object> searchAfter,
                                       int size) {
    NativeQueryBuilder builder = NativeQuery.builder()
            .withQuery(q -> {/* 同 list / page 的 bool 拼装 */})
            .withSort(Sort.by(Sort.Order.desc("createdAt"), Sort.Order.asc("_id")))
            .withMaxResults(size);

    if (searchAfter != null && !searchAfter.isEmpty()) {
        builder.withSearchAfter(searchAfter);
    }

    SearchHits<Product> hits = elasticsearchOperations.search(builder.build(), Product.class);
    // 下一页游标:最后一条 SearchHit 的 getSortValues()
    // List<Object> next = hits.getSearchHits().get(hits.getSearchHits().size() - 1).getSortValues();
    return hits.stream()
            .map(SearchHit::getContent)
            .map(productConvert::toResp)
            .toList();
}
第一次 searchAfter 传 null;之后把上一页最后一条的 getSortValues() 原样传回来。sort 字段和 search_after 里的值,数量、顺序必须一致;翻页中途别改排序条件。
search_after 不擅长 「直接跳到第 50 页」这种随机跳页;它适合「上一页 → 下一页」顺序翻。要总页数、要点页码,还是 from/size。
我是加洛斯,我们下期见 👋