大家好,我是数据库小学妹👋我踩过的坑,你别再踩。
上个月,我照着一家快递公司的表结构,搭了个演示环境。一张运单明细表,1.4 亿行,八个月。日报跑七十秒。加个需求,按小时看网点签收。就这一句话,日报变成十二分钟。
数据是构造的,不是客户的生产库。表结构、分区方式和两段 SQL 都在下面,照着能跑。遇到这种报表,第一反应通常是换引擎。先别急,先问一句:到底在查什么?这个问题答不清,换什么产品都白搭。这篇讲 OLAP 数据库的三件事。路线怎么选,报表怎么提速,边界在哪。顺序也是动手顺序。
OLAP数据库是什么?先当成一类负载看
OLAP 数据库,是面向联机分析处理的数据库系统。它按多维模型组织数据。海量历史数据的聚合、切片和下钻,是它的强项。三个关键词:多维、聚合、历史数据。它不是某一款产品的名字,而是一类查询负载。选型之前,先把自己的负载摊开看。
OLAP数据库选型:三条路线,先看一张表
同样叫 OLAP,底下的做法差得很远。主流分三条:MOLAP、ROLAP、HOLAP。名字像缩写游戏,本质是三个问题:提前算还是现场算?汇总和明细放一起还是分开?先把这三个问题答清楚,再谈产品。
| 路线 | 数据怎么放 | 查询怎么算 | 适合什么 | 代价 |
|---|---|---|---|---|
| MOLAP | 预聚合结果,存多维数组或立方体 | 直接读算好的结果 | 维度固定、高频、报表 | 维度一多组合爆炸,回刷贵 |
| ROLAP | 关系表或宽表,明细加轻度汇总 | 查询时现场过滤、聚合、关联 | 维度不固定、即席分析 | 大查询吃资源,依赖建模和优化器 |
| HOLAP | 汇总走预聚合,明细走关系表 | 按查询粒度选路 | 既要固定报表又要下钻 | 两套链路都要维护,架构复杂 |
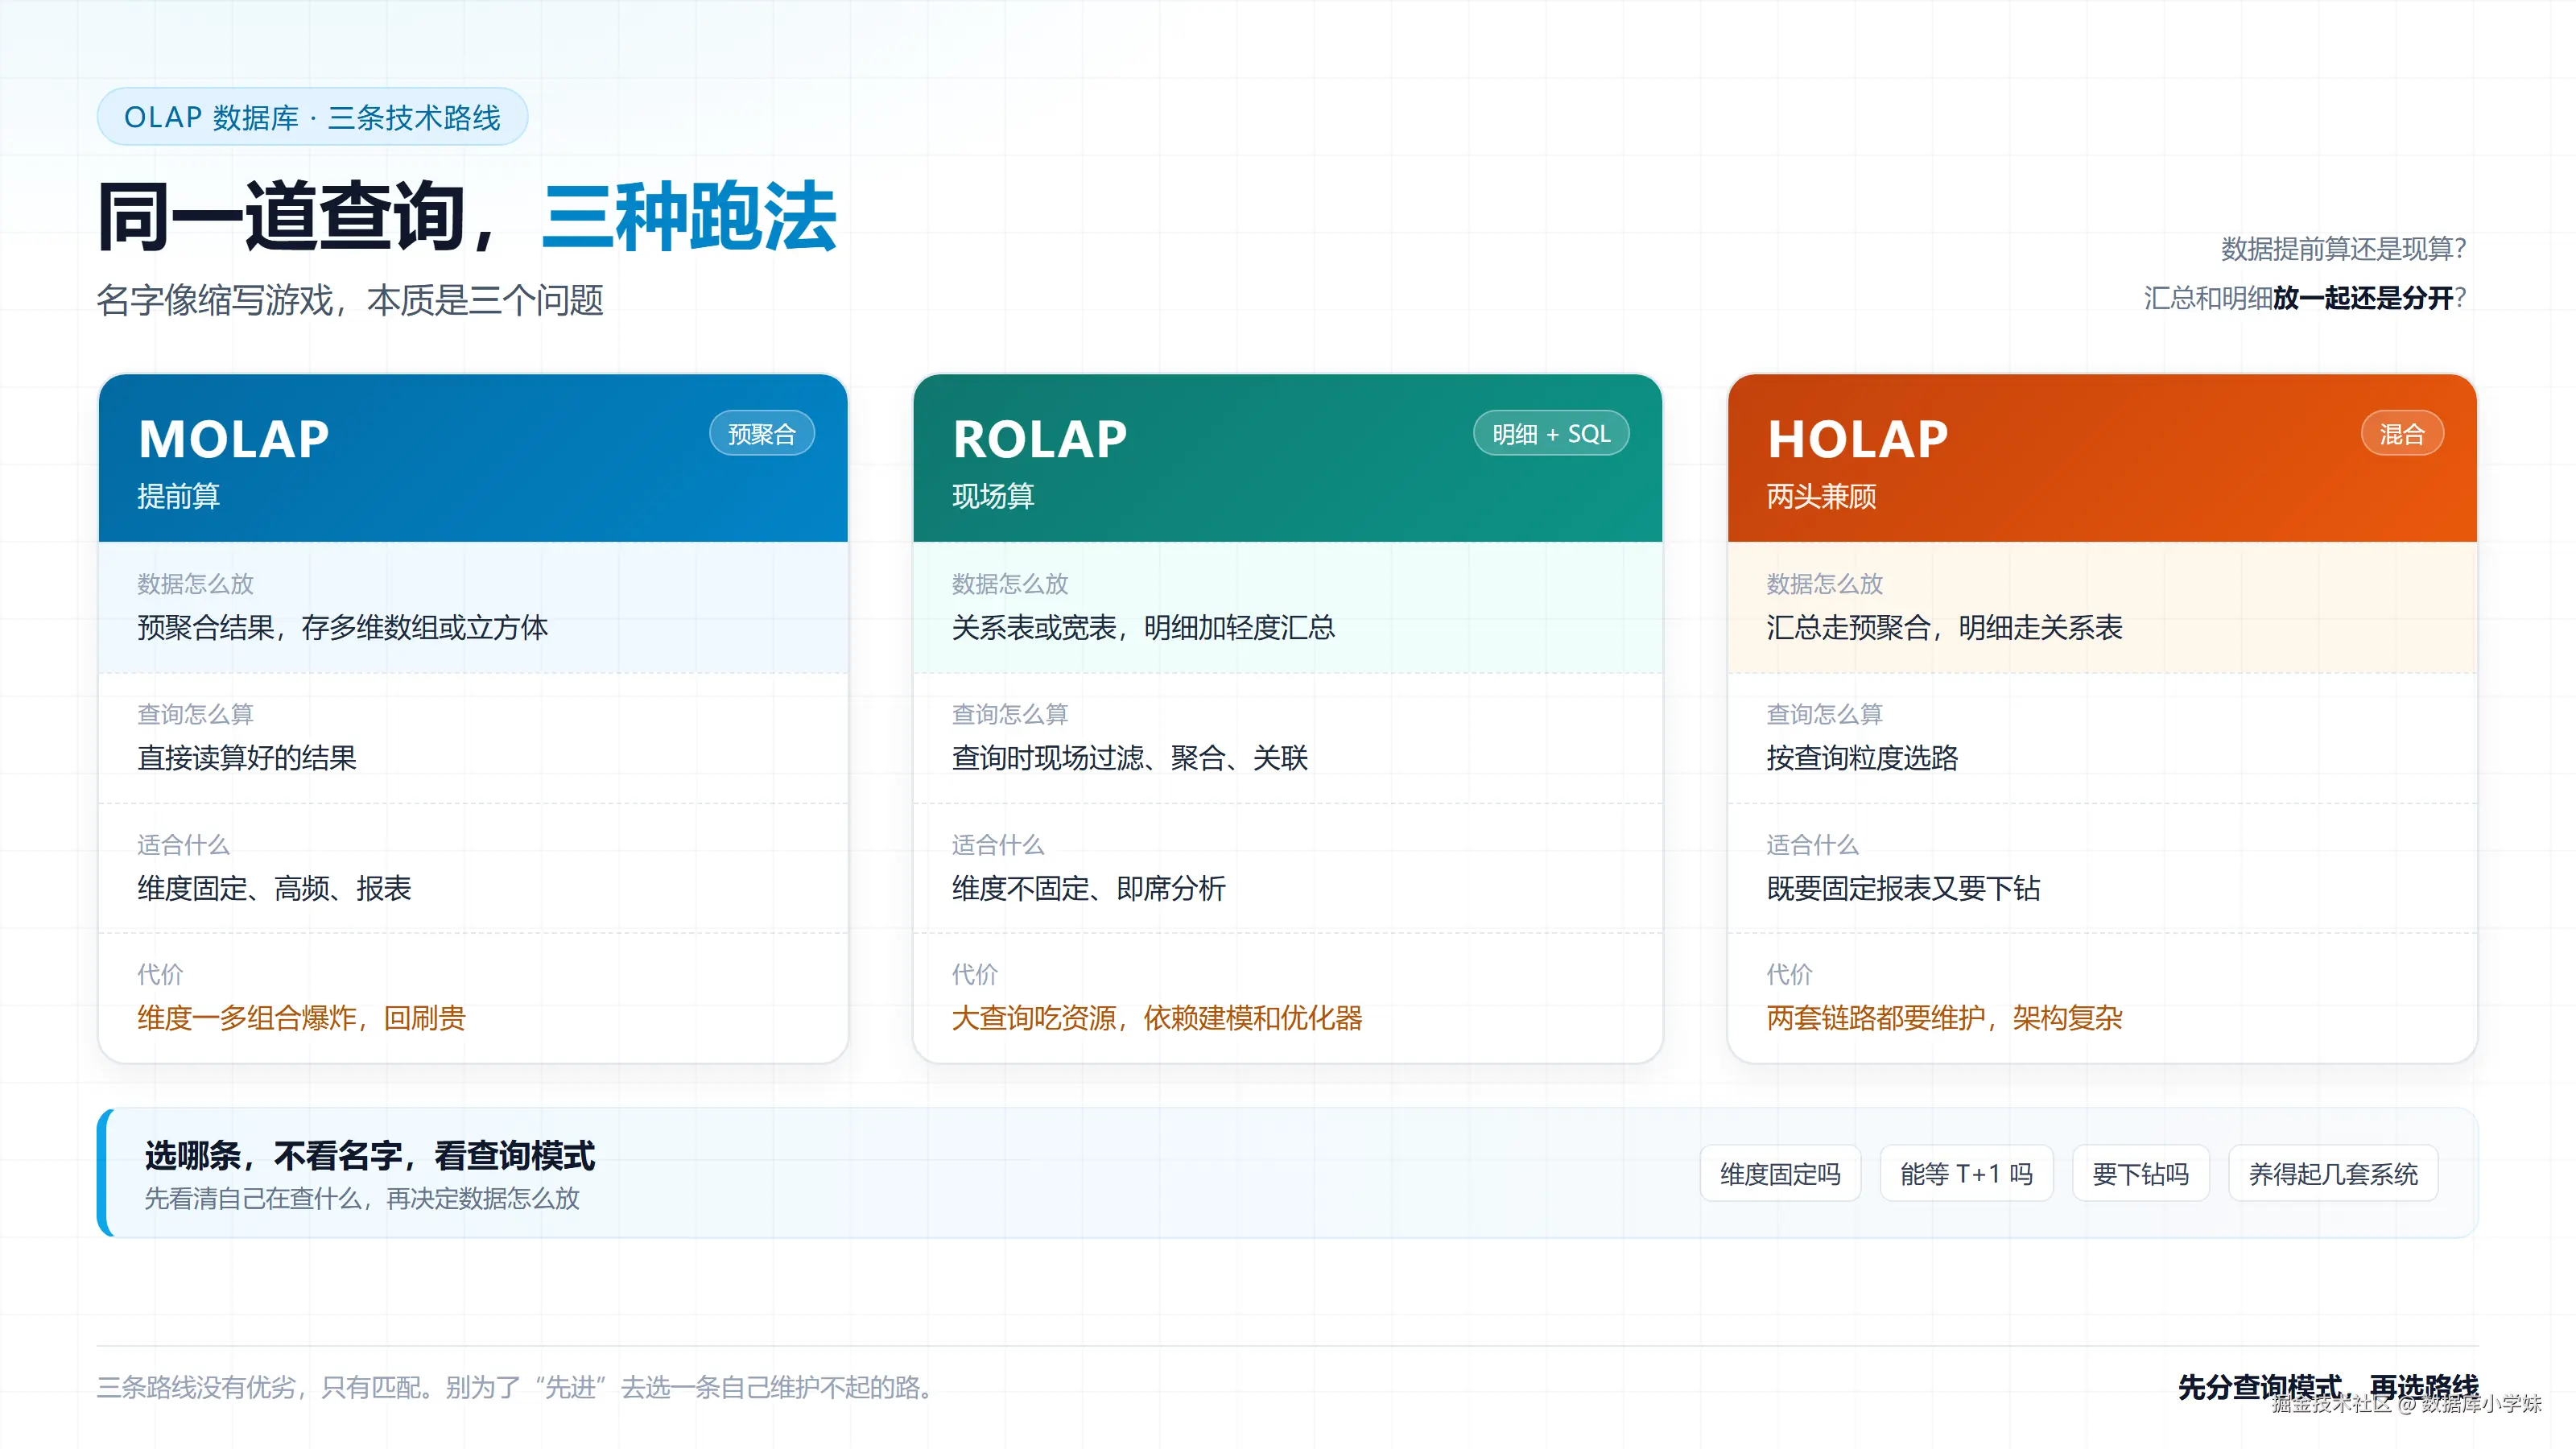
图1:MOLAP、ROLAP、HOLAP 三条路线
MOLAP 的核心是提前算。 常用维度的组合先算好,查询直接读结果。快是真的快,代价按乘法涨。三个维度各十个值,一千种组合。六个维度,一百万种。我见过一个项目,六个维度八个值。再乘三个度量,一天上百万行。
ROLAP 的核心是现场算。 明细放关系表,查询时用 SQL 现算,维度随便换。但现场算不稳。ROLAP 引擎快不快,看四件事。列存、分区裁剪、向量化执行、优化器选路。少一件,大查询就容易把资源拖死。很多团队说 ROLAP 慢,其实是这四件缺了两件。
HOLAP 想两头兼顾。 汇总走预聚合,明细下探走关系表。听着两全,实际是两套链路要养。小团队先算人手,再决定上不上。
Cube 没那么神秘。它就是一张按维度排好序的汇总表。查"华南 9 月 A 线路",直接定位一行。查所有线路,把几行加起来。这就是预聚合:常用的加法,提前做掉。cube 不是越大越好,够用就行。
选型就四问
选 OLAP 数据库,先问四句。维度固定吗? 固定,优先预聚合。不固定,别急着建 cube。能等 T+1 吗? 能等,预聚合加定时刷新最省事;等不了,才看实时链路。要下钻明细吗? 要,ROLAP 或 HOLAP 更合适。只看看板,MOLAP 够用。养得起几套系统? 人手不够,路线越简单越好。
四问答完,路线基本就定了。固定口径的汇总,金仓 KES 可以直接用物化视图承载。刷新跟着调度走,查询只读结果。交易分析想收一套底座,可以把它放进候选。先过四问,再做隔离测试。
OLAP数据库报表优化:一条日报,五步压下来
回到这张表。时效日报按网点、线路、月份汇总,扫八个月运单明细。别急着换引擎,按顺序走五步。每一步都要有结果,不能靠感觉。
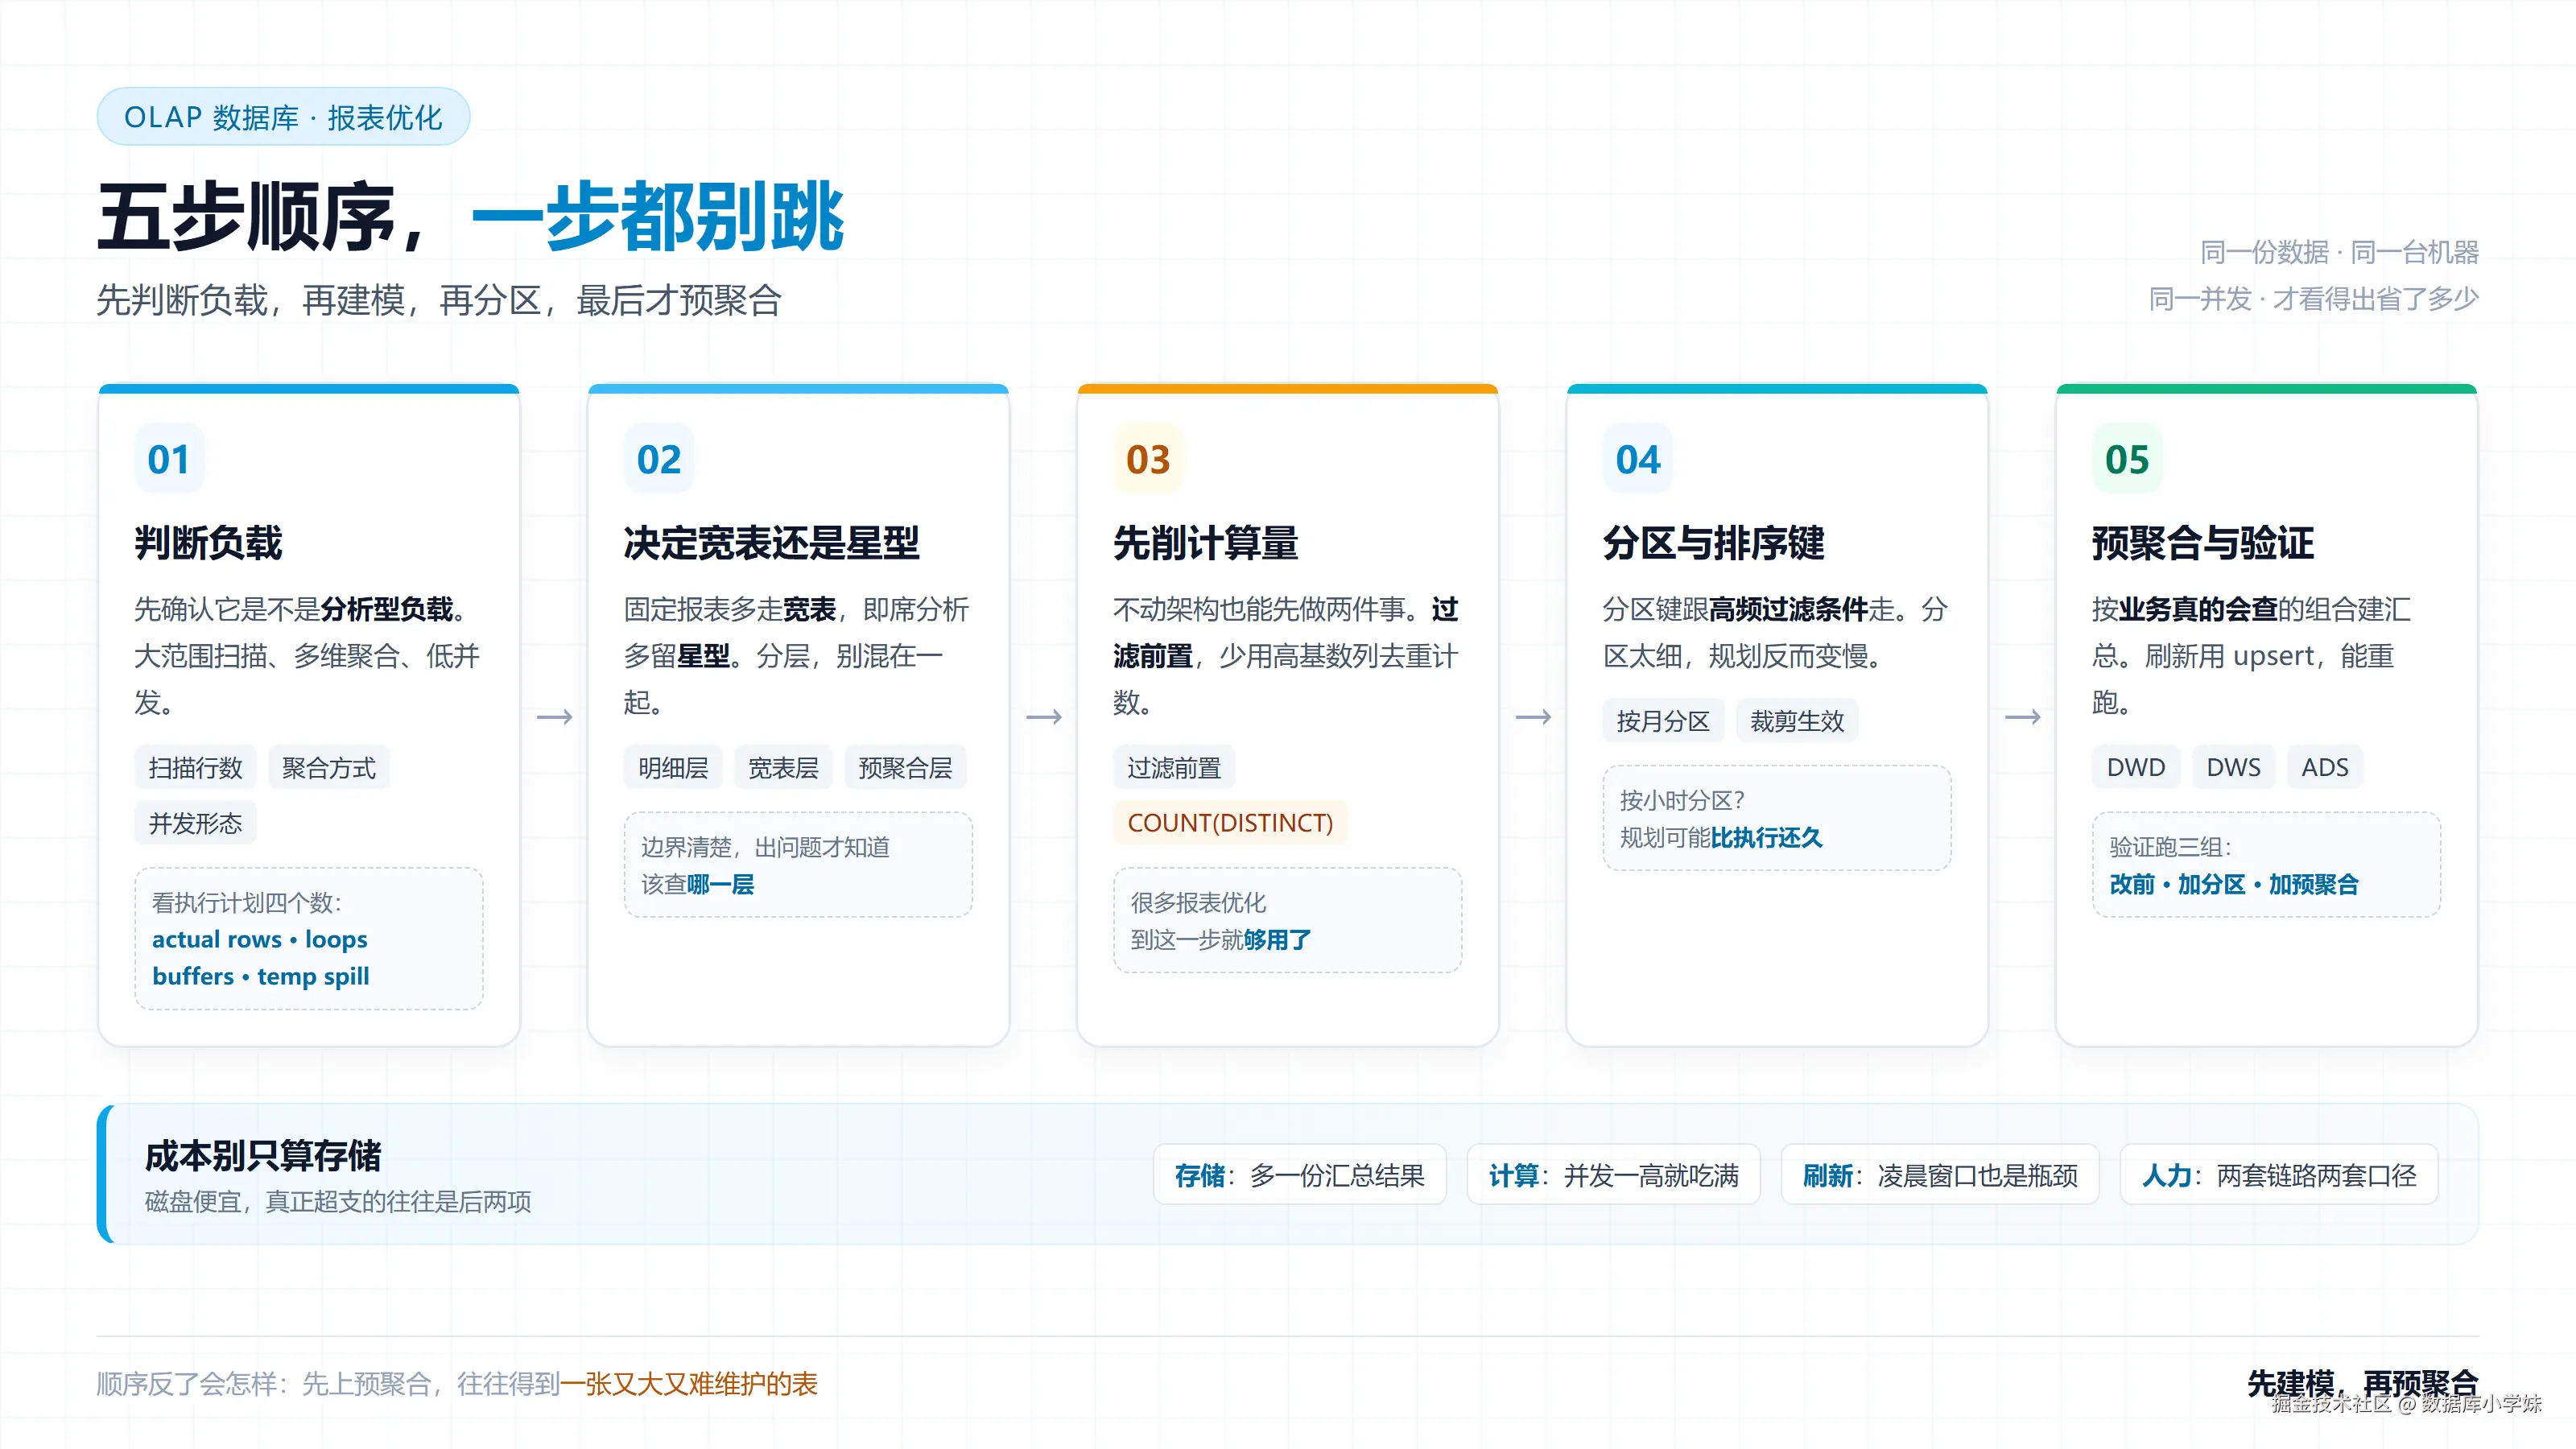
图2:报表优化的五个步骤
第一步,判断它是不是 OLAP 负载。 看三件事:扫描行数、聚合方式、并发形态。八个月明细、多维聚合、低并发,典型。执行计划我只看四个数。
| 指标 | 异常信号 |
|---|---|
| actual rows 与 rows 估算 | 差得远,统计信息可能过期 |
| loops | 次数高,代价跟着往上涨 |
| shared read | 数值高,说明在啃磁盘 |
| temp read / written | 非零,说明排序或哈希落盘 |
四个数看完,能判断慢在扫描、连接、排序还是内存。方向对了,再改 SQL。统计信息没跟上,优化器只能猜。顺序反了,调半天也是白调。
第二步,建模。 三条路:宽表、星型、预聚合。宽表查询路径短,冗余多。星型灵活,join 多。预聚合最快,粒度难改。
| 方案 | 查询路径 | 适合 | 代价 |
|---|---|---|---|
| 宽表 | 单表扫描,少 join | 固定报表、高频查询 | 冗余多,更新要回刷 |
| 星型 | 事实表加维度表 | 即席分析、维度多变 | join 多,依赖优化器 |
| 预聚合表 | 直接读汇总结果 | 高频固定报表 | 粒度难改,回刷麻烦 |
我的做法是分层。明细层保留最细粒度。宽表层按报表拼。固定日报再往上做预聚合。三层各管一段,出问题知道该查哪层。我第一次做分层时也嫌麻烦,把明细和汇总塞进一张宽表。改一次口径,花了两天。
第三步,先把计算量削掉。 过滤条件往前放,能在明细层过滤的别等聚合后再滤。少拿高基数列做 COUNT(DISTINCT)。去重计数很吃内存。业务能接受近似值,就用近似聚合。这两步不改架构,很多报表到这够用了。
第四步,分区。 查询最怕扫全表,分区裁剪是第一道闸。分区键要跟最常用的过滤条件走,跟索引没关系。选错键,后面的索引和预聚合都白搭。
sql
CREATE TABLE dwd_waybill_detail (
  waybill_no   VARCHAR(32),
  sign_date    DATE,
  network_id   BIGINT,
  route_id     BIGINT,
  carrier_id   BIGINT,
  promised_hrs NUMERIC(8,2),
  actual_hrs   NUMERIC(8,2)
) PARTITION BY RANGE (sign_date);

CREATE TABLE dwd_waybill_detail_2026_09
  PARTITION OF dwd_waybill_detail
  FOR VALUES FROM ('2026-09-01') TO ('2026-10-01');
按月分区,查询带上签收日期,优化器就能裁掉无关分区。KES 的分区表也是这个用法。排序键看过滤和分组的高频列。网点和线路常一起出现,就放前面。分区别切太细,按月够用就别按天。我见过按小时分区的表,规划比执行还慢。
第五步,预聚合。 固定日报每天算同样的口径。与其每次扫明细,不如提前算好。算一次,查很多次。这一步最省时间,也最容易被滥用。
sql
CREATE TABLE dws_timeliness_mon (
  mon        DATE,
  network_id BIGINT,
  route_id   BIGINT,
  sign_qty   BIGINT,
  ontime_qty BIGINT,
  updated_at TIMESTAMP,
  PRIMARY KEY (mon, network_id, route_id)
);

INSERT INTO dws_timeliness_mon
  (mon, network_id, route_id, sign_qty, ontime_qty, updated_at)
SELECT date_trunc('month', sign_date)::date,
       network_id,
       route_id,
       COUNT(*),
       SUM(CASE WHEN actual_hrs <= promised_hrs THEN 1 ELSE 0 END),
       now()
FROM dwd_waybill_detail
WHERE sign_date >= DATE '2026-09-01'
  AND sign_date <  DATE '2026-10-01'
GROUP BY 1, 2, 3
ON CONFLICT (mon, network_id, route_id)
DO UPDATE SET sign_qty   = EXCLUDED.sign_qty,
              ontime_qty = EXCLUDED.ontime_qty,
              updated_at = EXCLUDED.updated_at;
用 upsert,重复跑不会产生重复行。刷新策略三种:全量重算、按分区重算、增量合并。日报按天或按月重算最稳。固定口径的汇总,KES 用物化视图就能承接。刷新跟着调度走,报表只读结果。
改完要验证。同一份数据、同一台机器、同一并发,跑三组。演示机 8 核 32GB,单并发。三组放一起,才知道每一步省了多少。只看单次查询,容易高估效果。
| 阶段 | 扫描行数 | 峰值内存 | 响应时间 | 备注 |
|---|---|---|---|---|
| 改前 | 约 1.4 亿 | 3.6 GB | 70 s | 全表扫描,排序落盘 |
| 加分区 | 约 2100 万 | 1.2 GB | 16 s | 只扫 9 月分区 |
| 加预聚合 | 约 4 千 | 90 MB | 3 s | 直接读汇总表 |
这组数字是演示参考值,数据是造的。换机器、换数据量都会变,别当 benchmark。并发和刷新窗口也要看。大导入之后,统计信息要跟着更新。不然,优化器只能拿着旧数字选路。
上线前三项检查,跟引擎无关。
| 迁移前检查 | 通过标准 |
|---|---|
| 点查有没有留在交易库 | 分析库点查占比接近零 |
| 分区键有没有对齐过滤条件 | 常用时间条件能命中裁剪 |
| 统计信息跟不跟大导入 | 导入后自动触发,不靠人记 |
这三件事先做完,再谈换不换引擎。顺序反了,新引擎也一样慢。我见过换完引擎更慢的项目。问题全在这三项里,不在参数表上。
边界:OLTP、数仓、湖仓、融合库,别混着用
这几个概念常被放在一句话里比。其实不在一个层级。混着问,选型就会绕圈。先看表。
| 概念 | 解决什么 | 和 OLAP 数据库的关系 | 什么时候别用 |
|---|---|---|---|
| OLTP 数据库 | 处理当前事务,保证一笔业务正确落库 | 为 OLAP 提供源数据,不承担大范围分析 | 别拿它跑全量聚合,容易拖垮交易 |
| OLAP 数据库 | 多维聚合、切片、下钻、即席查询 | 本身就是分析负载的承载者 | 别拿它接高频点查 |
| 数据仓库 | 面向分析的存储与建模底座 | 可以承载 OLAP,但 OLAP 不只存在于数仓 | 别把它当成一款查询引擎来选 |
| 数据湖 | 存原始文件和多格式数据 | 湖上可以跑 OLAP,但要配引擎和元数据管理 | 别指望只存文件就能直接出报表 |
| 湖仓一体 | 在湖上建仓,开放表格式 | 为 OLAP 提供统一存储底座 | 别忽略小文件治理和元数据服务 |
| 融合数据库(KES) | 一套底座承接交易、分析与多模数据 | 能承载部分聚合负载,少一次搬运 | 分析负载重、查询又散时别硬收 |
| HTAP | 一套系统兼顾事务与分析 | 可能减少数据搬运,但要先做资源隔离 | 别假设它天然互不干扰,必须压测 |
先分清底座和负载。数仓、湖仓是底座。OLAP 是负载,HTAP 是架构选择。融合库也是架构选择,不等于把三者塞进一套。
选型前先做七天负载画像。查询类型、扫描字节、峰值并发,看压力。新鲜度、日增、报表重合度,看取舍。数据量小、报表固定、能等 T+1,数仓加预聚合够用。数据到 TB 级、维度多变、要秒级响应,再看列存引擎。交易分析要共一份数据,先评估融合架构,再做隔离。
国产化替换时,常会评估金仓(KingbaseES)。它靠分区表、并行查询、物化视图,接住一部分聚合负载。优势是少一次数据搬运。但资源隔离、查询治理、统计信息,这三样省不得。分析量到了 PB 级、查询又散,独立引擎更稳。
这个演示案例,最后怎么落的
回到开头。我把查询分成三组。固定日报按网点、线路、日期走预聚合。临时分析按小时、异常类型、承运商切,走明细加分区。点查看单个运单,回交易库。
分组之后,迁移才有边界。固定日报留在汇总层。临时分析留在明细层。点查回交易库。三组各走各的路径,互不抢资源。这个顺序不能反。先分查询,再谈搬到哪套系统。
OLAP数据库的三个坑,我踩过两个
第一个,把所有报表都做成 cube。预聚合不免费,维度一多,存储和回刷都受不了。我见过一个团队全算了一遍。存储翻几倍,最后砍掉一半。
第二个,把 ROLAP 当成不用建模。现场算不等于乱放,分区、排序键、宽表设计一个都不能少。这个坑我踩得最狠。有次把明细表直接当分析表用,每次查询都扫全表。后来补了分区,扫描量才下来。
第三个,只看单次查询快不快。预聚合表的刷新窗口,常会变成新瓶颈。白天查得快,凌晨刷得哭,不是好架构。刷新和写入,也是架构的一部分。
OLAP数据库常见问题
OLAP 数据库和 OLTP 数据库有什么区别? OLTP 管当前事务,按主键点查。OLAP 管历史分析,大范围扫描再聚合。延迟、并发、存储偏好都不一样。两者是分工关系,不是替代关系。
一定要建 cube 吗? 不一定。cube 只是 MOLAP 的一种实现。维度固定、口径稳定的日报,建了划算。维度多变、查询又散,建了就是负担。先看查询模式,再决定建不建。
国产 OLAP 数据库怎么选? 先看场景,再看案例和生态,别只看参数表。交易分析想收一套底座,可以评估 KES 这类融合库。它有分区表、并行查询、物化视图,能接住一部分聚合负载。分析量到了 PB 级、查询又散,独立引擎更稳。
上了 OLAP 数据库,为什么报表还是慢? 先查四件事:分区键、统计信息、点查混跑、预聚合口径。这四件跟产品无关,跟习惯有关。多数问题不在引擎,在数据组织和查询写法。换引擎不换建模,慢的还是慢。
写在最后
OLAP 数据库的答案,不在产品清单里,在查询分层里。先分清哪些查询固定、哪些临时、哪些是点查。再决定每一层算在哪。固定走预聚合,临时走明细加分区,点查回交易库。选型看分层。提速看分层。迁移边界,还是看分层。
我判断 KES 这类融合库,也按这个逻辑。分区裁剪、并行查询、物化视图,能接住一部分分析负载。两类负载能少搬一次。但工具替代不了分层。分层错了,换多少引擎都白搭。
你们现在的报表,固定维度多还是临时分析多?评论区说说,我帮你判断该从哪一步动手。别急着换引擎,先把分层说清楚。我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋