💡 一句话总结:手机 GUI 智能体的延迟大头不是「看屏幕」,而是让 7B 大模型逐 token「写」出动作。GUI-JEPA 干脆不让它写------截图编码一次,对每个候选控件在 JEPA 隐空间里打分,一步 51 毫秒,0.5B 参数保住 7B 模型 86-92% 的精度。做端侧智能体、手机自动化的人值得读。
导语:你的手机智能体,一步要等多久?
先问一个可能戳到你的问题:你跑过真机上的 GUI 智能体吗?就是那种「看一眼截图、替你点一下」的 agent。
体验过的人多半有个共同的体感------慢。论文里引了一组数:8B 级智能体在真机基准上平均一步要 2.6 到 10.6 秒。你指令都说了半天了,它还在那儿「思考人生」。
慢在哪儿?很多人第一反应是「模型太大」。但这篇论文开门见山指了一个更本质的问题:慢的大头是解码。主流做法是让 VLM 把动作当文本一个 token 一个 token 生成出来(比如输出一段 JSON),Qwen2.5-VL-7B 微调后在 H20 上 vLLM 服务一步要 207 毫秒、HF transformers 要 507 毫秒------其中一半以上的时间花在逐 token 解码上。
更扎心的是,已有研究表明 VLM 在 prefill 阶段(读入截图和指令时)就已经「锁定」了要点的目标元素,后面的解码只是在精修坐标。换句话说:答案早就有了,它还在一个字一个字地念给你听。
那能不能干脆不让它念?上海交大、南洋理工和阿里巴巴的团队给了个相当干脆的答案:能。这篇 GUI-JEPA(arXiv 2610.36877)是第一个完全不解码、用 JEPA 隐空间「打分选动作」的 GUI 智能体策略。
想自己动手试?
- 📄 论文:arXiv 2610.36877
- 💻 代码:GitHub · bcwang-sjtu/GUI-JEPA
- 📊 数据集:AndroidControl(基准)、GUI-Odyssey / VideoCUA(编码器预训练)
这篇论文到底想解决什么问题?
先把痛点掰开。GUI 智能体每走一步要干三件事:看截图、想动作、执行。「想动作」这一步,现在的主流是生成式------让模型把「点击坐标 (x,y)」这样的动作当文本吐出来。
这条路线有两个绑在一起的代价:
- 时间:解码是逐 token 的串行过程,token 一个接一个往外蹦。前面说了,这一步占了整个响应时间的一半以上。
- 显存:要在环里放一个 7B+ 的模型,15-16GB 显存起步,端侧设备基本无缘。
而另一边,「候选打分」这条路线其实早有人走:把屏幕上可点的元素(来自无障碍树,a11y tree,系统提供的界面结构化信息)一个个列出来,给每个候选打个分,选分最高的执行。V-Droid、Jev-Mobile 这些工作都是这个思路。
但这里有个绕不开的尴尬:这些打分器的环里还是得放一个 LLM 或 VLM------要么用大模型算分,要么用它验证。等于「解码」没了、「大模型」还在,快得有限。
论文的一句话研究问题就是:能不能让 GUI 智能体在一个不含任何生成模型的隐空间里完成「打分选动作」,把解码和大模型一起请出环?
它的思路是什么?
GUI-JEPA 的答案是借 JEPA(Joint-Embedding Predictive Architecture,联合嵌入预测架构,LeCun 团队带火的「不预测像素、只预测隐向量」的自监督路线)的壳,做打分器的芯。整体流程一句话:截图编码一次,每个候选变出一个「假如执行它」的隐向量,打分,选最高的。
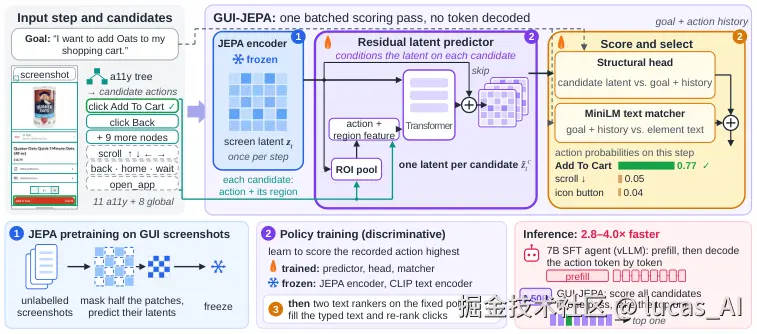 图说:上半部分是一次真实步骤的完整打分流程------截图编码一次,所有候选拼成一个 batch 一次算完;下半部分对比「一次打分」与「逐 token 解码」的时间量级,火焰=训练、雪花=冻结。
拆开看四个关键部件:
- JEPA 编码器(ViT-L,303M,冻结):先在 18.9 万张无标注 GUI 截图上自监督预训练------随机遮住一半图像块,让网络在隐空间里补全被遮部分的表征(不还原像素,只对齐「语义隐向量」)。训练只花了 0.76 GPU 小时,之后彻底冻结、token 缓存,推理时每个截图只编码一次。
- 残差隐预测器(39.9M,全场戏份最重的模块) :对每个候选动作(比如「点击这个按钮」),把「16 维动作向量 + 这个按钮区域的图像特征」喂进去,在截图隐向量的基础上叠加一个残差------得到「假如点了它,屏幕语义会变成什么样」的隐向量。同一步的所有候选拼一个 batch,一次前向全算完。
- 结构头(余弦打分) :把每个候选的隐向量与「指令 + 历史」的条件向量做余弦相似度。关键设计是一条铁律:头部能看到的候选相关信息,只允许来自预测器输出的隐向量------想绕过 JEPA 通路抄近路?结构上不给这条路。
- 文本匹配器(MiniLM,33M):光看图像还不够,再把「指令文本 vs 候选控件的文字」做个交叉编码打分,两路分数相加。你想想「点击『提交订单』还是『取消』」这种事,控件的文字本来就是最强的信号。
最后取 argmax 执行。如果是「输入文本」类动作,还有个 22.7M 的小排序器从指令里把要输入的话挑出来;如果是点击,一个类型门控的重排器再复排一遍。全程没有任何 token 生成------一步的成本只取决于你有多少候选,跟「话说多长」彻底无关。
这套设计里我个人觉得最巧的是那条「防绕过」铁律。它把一个工程问题变成了一个可验证的科学问题:既然打分器只能通过隐通路获取候选信息,那消融实验就能干净地回答「JEPA 隐空间到底有没有用」。
效果到底怎么样?
先给结论框:同一 GPU、同样输入、同一个严格 judge,GUI-JEPA 用 6% 的参数,跑出了 7B 微调模型 86-92% 的分布内精度,速度快 2.8-4 倍。
数字摊开看(AndroidControl 基准,IDD 分布内子集,步级准确率,越高越好):
- 自家同协议参照 Qwen2.5-VL-7B(LoRA 微调):AC-Low 91.0 / AC-High 70.9
- GUI-JEPA(0.5B):AC-Low 84.1 / AC-High 61.0------分别保留了 92.4% 和 86.1%
速度那组数更直观(单卡 H20、batch 1、100 条真实步骤的中位数):
- GUI-JEPA:fp32 一步 74.3 毫秒,bf16 一步 51.5 毫秒
- 7B 参照:vLLM 207 毫秒,HF transformers 507 毫秒
- 显存:2.5-3.5 GB vs 16 GB 上下------4.6-6.4 倍的差距
什么概念?7B 模型光 prefill(还没开始吐字)的时间,就够 GUI-JEPA 完整走完一步还有富余。放手机上,这是「能本地跑」和「必须上云」的区别。
看一眼它实际怎么选动作:下面是三个真实步骤,覆盖点击、全局动作、文本输入三类------绿框是正确答案,紫框是 GUI-JEPA 的选择,每步都只花一次前向。
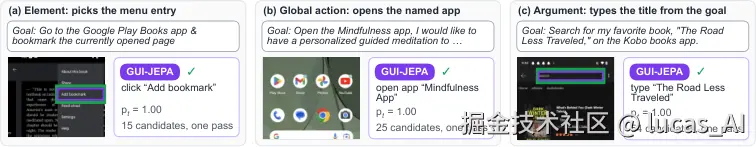 图说:三个真实 AndroidControl 步骤------(a) 在 15 个候选里点中菜单项,(b) 按目标文本开启指定应用,(c) 把书名从指令里抄出来填进输入框。
还有一个加分项:两个小的文本排序器加起来才 56M 参数,就在 OOD(分布外)AC-High 上抬了 3.8 分------其中跨度排序器把「输入文本」类动作的准确率从 13.5% 拉到 52.5%,几乎是白捡的分。
但真正让我觉得这篇「值得记住」的,是第 5 节的机制分析。他们在训练前给预测器做过「动力学预训练」(用真实操作转移数据学「点了之后屏幕会怎么变」),按世界模型的直觉,这应该很有用吧?
结果:随机初始化的预测器,跟动力学预训练过的打平。 各类预测辅助目标也全都不加分。前向探针更绝:这个预测器预测「下一步的屏幕隐向量」,比直接抄当前隐向量还差。
也就是说,它压根不是世界模型,而是学成了一个「按动作和区域变换当前屏幕表征」的决策特征提取器。作者的结论很清醒:JEPA 当 GUI 策略用时,应该按「决策质量」来训练和评价,而不是按「预测保真度」。这跟最近「世界模型预测能力与动作相关性是两回事」的研究线正好接上了。
为什么你要关心?
如果你就做 GUI/设备控制智能体,这篇几乎是直接可抄的作业。几条具体的:
- 端侧部署路线:0.5B 参数、2.5GB 显存、51ms 一步------这是目前少见的、明确对着「上真机」设计的策略范式。a11y 树在 Android 上就是 AccessibilityService,工程上拿得到。
- 混合部署的性价比账:论文给了个很实用的数字------GUI-JEPA top-2 分差对自身错误的判别 AUROC 有 0.74。这意味着你可以让小模型兜底 90% 的简单步骤,分差小的难题升级给 7B 大模型,成本和精度都拿捏。
- 「打分替代解码」是个可迁移的思路:只要你的动作空间能枚举成候选集(web DOM 节点、桌面 UIA 元素、API 调用列表),这套「候选条件化残差隐 + 余弦打分」的范式都值得试。论文自己也说了 web DOM 是自然的下一步。
- 机制结论对做世界模型的人是一记提醒:为决策训练的表征 ≠ 为预测训练的表征。如果你在给 agent 配世界模型,先想清楚它到底该「预测得准」还是「选得对」。
理性看待
冷静几句。GUI-JEPA 依赖 a11y 树这个特权输入,纯视觉闭环的场景(跨应用、游戏、非原生界面)它暂时覆盖不了;评测停在步级,没有在线任务完成率,终止判断和规划都还是空白;7B 参照只用 4000 条数据训了一轮 LoRA,训练预算与 GUI-JEPA(全量数据 6 epoch)不完全对齐,86-92% 这个「精度保留率」应理解为保守下界。另外相当一部分设计选择是在测试集的分布内子集上调的,OOD 数字(47.7)反而更值得看。最后,「JEPA 路线优于小 VLM 路线」并没有被证明------论文证明的是这条路线可行、快、机制自洽,它是无解码器 GUI 策略的第一个扎实的可行性数据点,不是终局答案。