10 月 22 日,代号 Kibitz 的匿名模型出现在 Arena 的代码对战里。当天几家媒体的标题几乎是同一个句式:性能直追 GPT-6 Astra,月底有望官宣。
同一天,Artificial Analysis 的智能指数榜上,Kimi K3 是 44 分,GPT-6 Astra 是 53 分。
9 分。听着不多。
但 K3 还有一项指标掉得更狠:Terminal-Bench 4.0,13%。同一项上,GPT-6 Astra 是 59%。
而这一轮爆料的升级方向,写的是"长程自主任务、游戏与 3D 代码增强、操作电脑"。
操作电脑。终端。13%。
先把这句话放在这儿,后面回来看它。
哪些是硬的,哪些是"网友说"
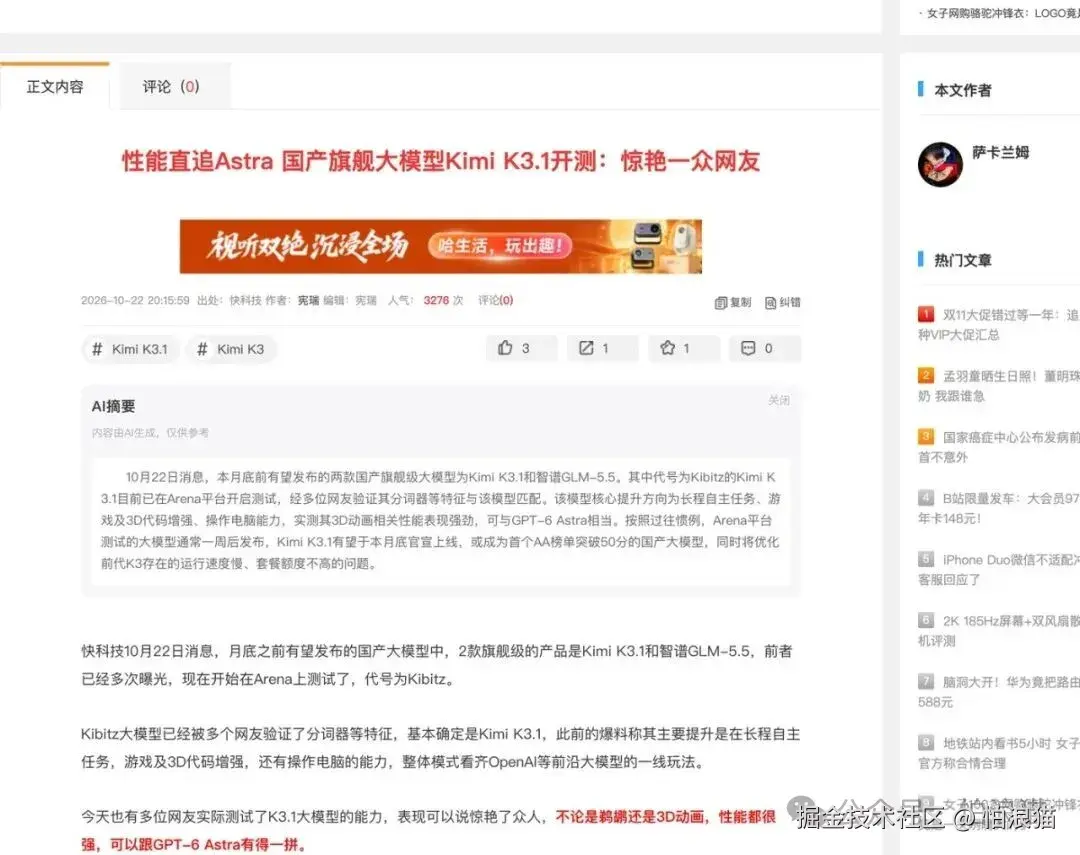
标题说"直追",正文最后一句才是真正的大话------"首个 AA 榜单突破 50 分的国产大模型"。
这条消息本身不假,四家媒体在 10 月 22 日同时报了:快科技、站长之家、新浪财经转机器之心、彭博社电讯。核心事实是:Arena.ai(原 LMArena)的 Code Arena 里出现了两个没人认领的模型,Kibitz 和 Kalmia。
但"Kibitz 就是 Kimi K3.1"这件事,官方一个字没说。社区给的证据是三条:
第一条最硬,是分词器指纹。 账号 @aitrackerbot 做了两轮测试,让模型复述 11 个专门用来识别 Moonshot 模型的特殊 token。Kibitz 这 11 个全乱码,和该账号测过的所有 Kimi 模型表现一致;同时测的其他 7 家实验室的模型,都能准确复制这些字符串。
第二条是官方接口泄露。 有人抓了 Kimi 官方域名下一个配置接口的返回,里面出现了 "to": "k3.1" 这样的会话切换目标,说明产品端已经在为 K3.1 铺路。发帖者当晚补了一句:这条配置已被撤回。
第三条是节奏。 Max For AI 称两家都已进入发布前最后阶段,预计本周内推出。按 Arena 的惯例,匿名模型进场测试到正式发布通常隔一周左右。
顺带说一句同批的另一个:Kalmia。社区判断它是阿里的 Qwen 4,有人看了它的 3D 可驾驶汽车 demo,评价"能比肩 GPT-6.1 Sol Ultra"。如果这两个判断都成立,那这个月底就是三家撞车------Kimi K3.1、Qwen 4、智谱 GLM-5.5。
这是国产旗舰第一次不是排队发布,而是同月对撞。 对读者是好事,对厂商不是。
三条合起来,可信度不低。但请记住它们的性质:这是三条间接证据,不是一次官方确认。
真正缺的那块拼图是成绩。Arena 的匿名盲测不公布 Elo,只在对战后台记录胜负。也就是说,截至今天,没有任何一个公开数字能支撑"直追 Astra"这句话。
那能查到的是什么?
9 分之间,站着 20 个配置档
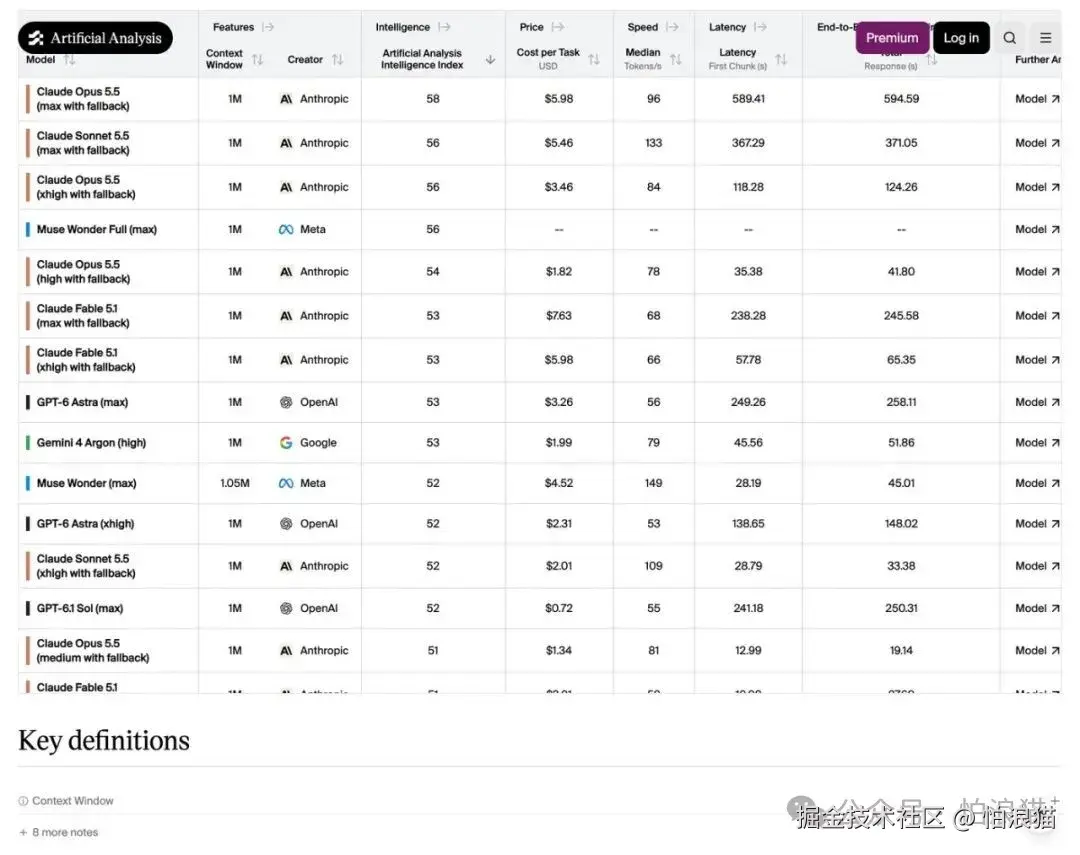
从 53 到 44 这 9 分,中间挤着 7 个模型、20 个配置档。
Artificial Analysis 是目前少数几个把"能力"压缩成单一数字、并且公开全部原始分的机构。它的智能指数现在跑的是 v4.3.2 版本,十项评测加权:Agent 类 30%、通用 30%、编程 20%、科学推理 20%。
这段先看图,再看表。
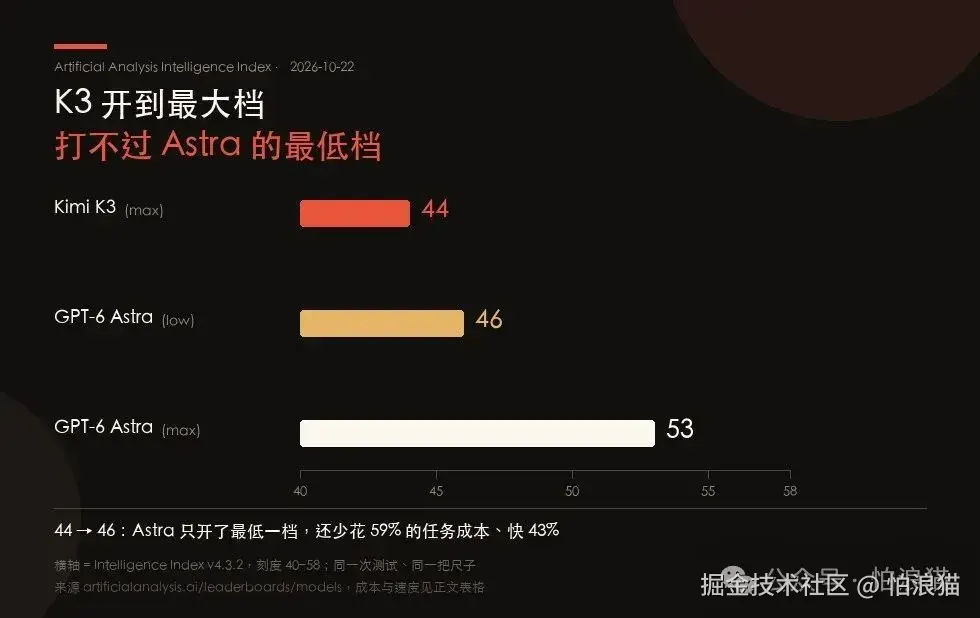
AA 测了 K3 两档、Astra 五档。K3 开满档,分数低于 Astra 的最低档。
在这把尺子上:
| 模型 | 智能指数 | 每任务成本 | 输出速度 | | --- | --- | --- | --- | | Claude Opus 5.5 (max) | 58 | 5.98∣96tok/s∣∣ClaudeSonnet5.5(max)∣56∣5.46 | 133 tok/s | | GPT-6 Astra (max) | 53 | 3.26∣56tok/s∣∣Gemini4Argon(high)∣53∣1.99 | 79 tok/s | | MiMo-V2.6-Pro | 46 | 0.13∣52tok/s∣∣GPT−6Astra(low)∣46∣0.82 | 53 tok/s | | GLM-5.3 (max) | 45 | 2.01∣78tok/s∣∣Qwen3.8Max∣45∣5.41 | 40 tok/s | | Step 5 Preview | 44 | 1.03∣180tok/s∣∣∗∗KimiK3(max)∗∗∣∗∗44∗∗∣∗∗2.00** | 37 tok/s |
看清楚这张表再往下读。
50 分以上有 19 个配置档,全部来自四家公司:Anthropic、OpenAI、Google、Meta。没有一家中国公司。
国产最高是小米 MiMo-V2.6-Pro 的 46 分。
所以"K3.1 有望成为首个突破 50 分的国产模型"这句话,翻译成人话是:它要比现在高 6 分,一次跨过排在前面的 20 个配置档,成为唯一一个站在 50 分以上的中国模型。
这不是"国产第一"的量级,这是"空降全球前十、并且是中国唯一"的量级。 从 44 到 50 以上,一个版本内跳完,我还没见过先例。
顺带说一句,"希望能达到 55 分甚至 60 分左右"这个预期,60 分目前不存在。全球第一的 Opus 5.5 是 58。
13% 这一项,才是这次该盯的地方
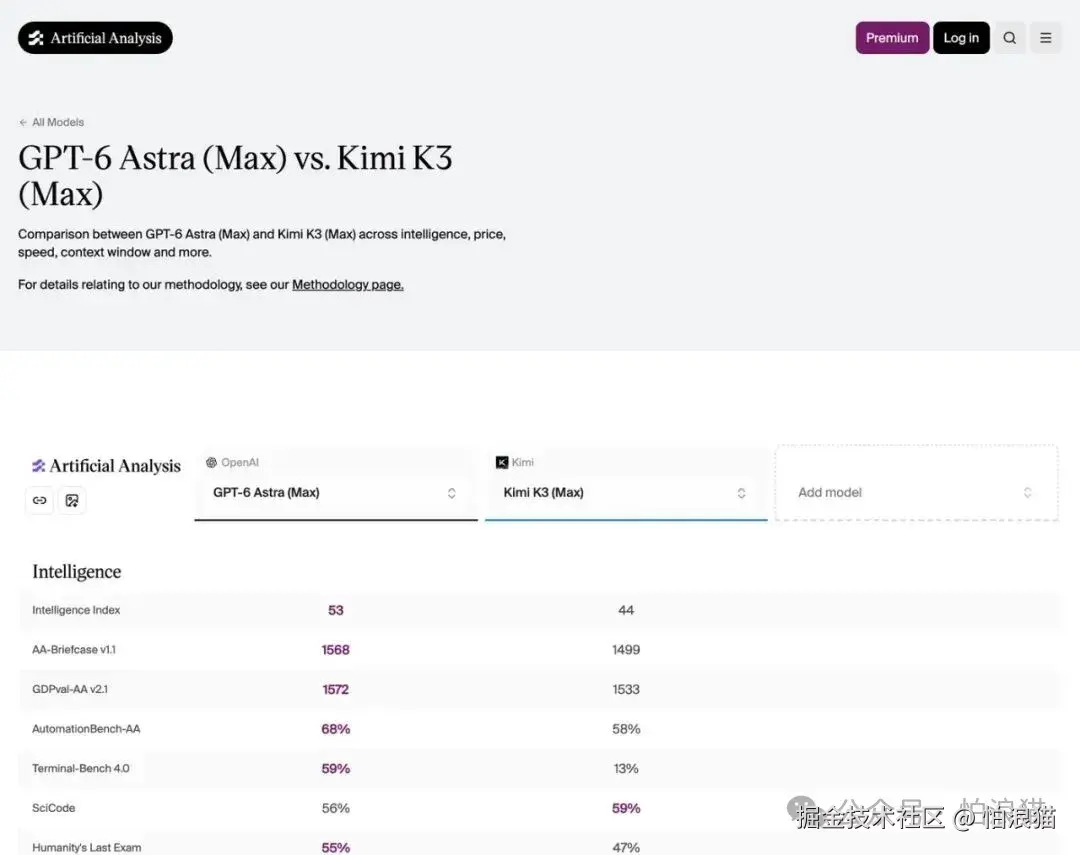
同一个页面、同一次测试。Terminal-Bench 4.0 一栏,59% 对 13%;SciCode 上 K3 反而赢了 3 个点。
这张图是整件事里信息量最大的一张。
Terminal-Bench 4.0 考的是什么?给一个 Agent 一个终端,66 个任务,跨软件、机器学习、科学、运维、安全、硬件、媒体七个领域,看它能不能真的把活干完。跑三遍取平均 pass@1。这是目前最接近"操作电脑"这个说法的公开评测。
Kimi K3 在这项上拿到 13%。什么概念------GPT-6 Astra 是 59%,Claude Fable 5.1 是 52%,GLM-5.3 是 42%,连小米 MiMo-V2.5-Pro 都有 35%。
Astra 是 K3 的 4.5 倍。
而 K3.1 的升级清单上,第一条是"长程自主任务",第三条是"操作电脑的能力"。
这两句话如果为真,第一个该动的数字就是 13%。 不是鹈鹕,不是 3D 动画,是终端里那 87% 没做完的任务。
再看 SciCode------K3 拿 59%,反而比 Astra 高 3 个点。这说明它不是全面落后,是偏科:单点写代码的活儿不差,把一堆步骤串起来在真实环境里跑完的活儿很弱。
偏科的位置,恰好是 Agent 时代的正面战场。
57 分和 44 分,是两把尺子
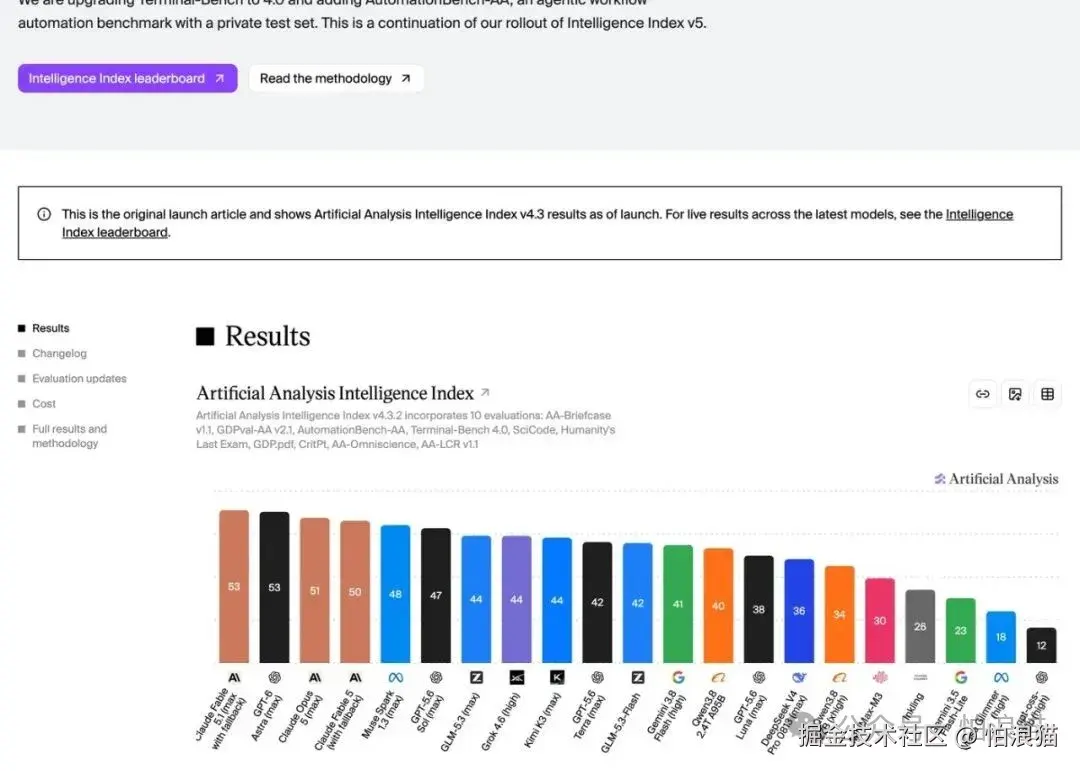
改版当天 44 分那一档有两个:GLM-5.3 和 K3,当时并列开源第一。
这里必须打断一下,否则容易被数字带偏。
如果你去搜"Kimi K3 Artificial Analysis",会搜到大量"57 分、全球第三"的报道。那是 7 月 K3 发布时的数字,没错。
但今天你去 AA 官网看,K3 是 44 分。
模型没变,尺子换了。
9 月 7 日,AA 发布了智能指数 v4.3:把 Terminal-Bench 从 2.1 升到 4.0(题目全面加难),把 τ³-Banking 换成和 Zapier 合作的 AutomationBench-AA(657 个私有任务,考跨应用业务流),同时把"有私有题集/答案"的评测权重从 40% 提到 45%。
结果是全行业集体掉分:Claude Fable 5.1 掉 3.39 分,GPT-6 Astra 掉 1.85,Grok 4.6 掉 6.17。Claude Fable 5 在 7 月是 60 分,现在是 49.7。
这件事的意义在于:任何引用绝对分数的说法,都必须带上版本号。 一个不带版本号的"57 分"或"44 分",等于一个没有刻度的数字。
所以那条新闻里"首个突破 50 分"的说法,用的是哪把尺子?大概率还是 7 月那把------因为用新的这把,50 分意味着要追平 GPT-6 Astra 的中档。
顺带一个小反转。v4.3 发布那天,AA 的原话是"GLM-5.3 和 Kimi K3 继续领跑开源权重模型",两个都是 44 分。两个月后的今天,开源第一是小米 MiMo-V2.6-Pro 的 46 分。
榜单是会变的,而且变得比发布会快。
它最大的对手不在大洋对面
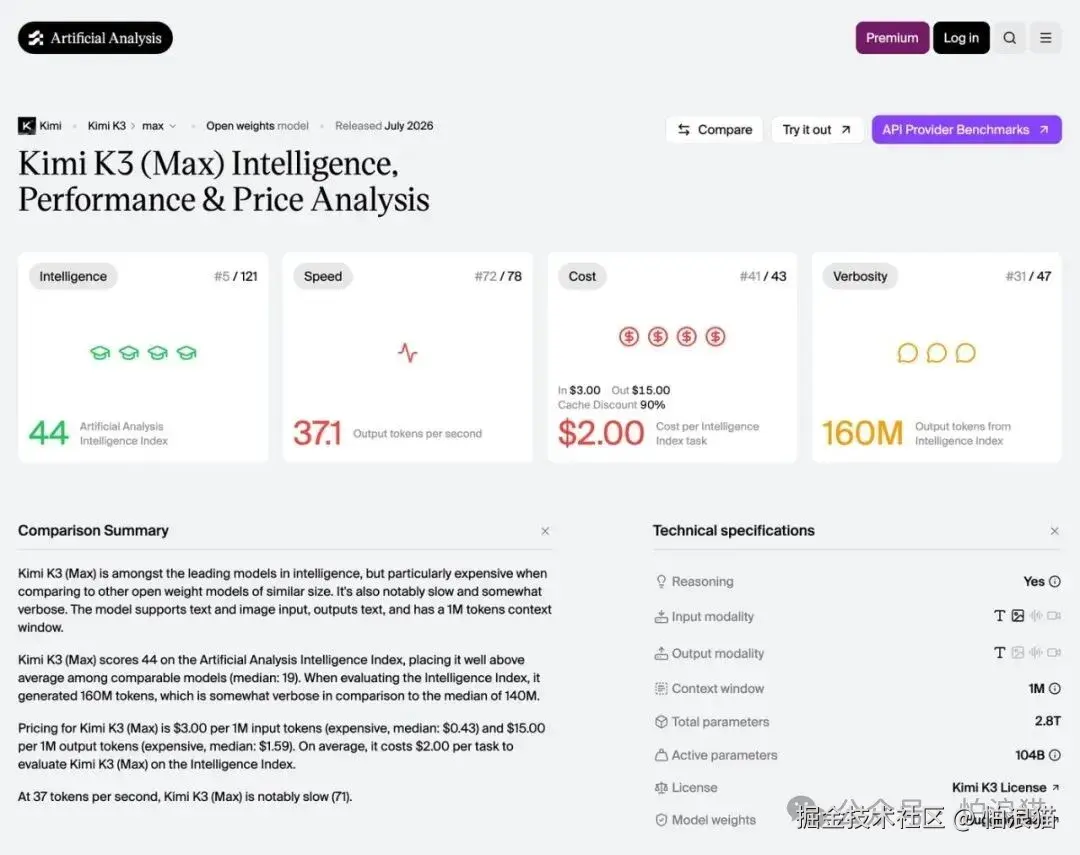
AA 在页面上直接写了 "notably slow",37.1 tok/s 在同批 78 个模型里排第 72。
回到那张表,看三列数字。
**成本: 2.00一个任务。∗∗ 同分的MiMo−V2.6−Pro是0.13,同分的 Step 5 Preview 是 1.03,45分的DeepSeekV4.1Flash是0.26。K3 比小米贵 15 倍。
速度:37 tok/s。 这一档国产模型里最快的 Step 5 Preview 是 180,差近 5 倍。AA 页面上直接写了一句 "notably slow"。
耗时: 每任务 1231 秒,20 分 31 秒。跑完整个智能指数,K3 吐出 1.6 亿个 token。
这三项加起来,正好对上媒体那句轻描淡写的"上代 K3 受算力拖累,速度慢,这两个月存在感不如 DeepSeek V4.1 Flash"。
数字比这句话难看得多:K3 在自己国家的第一梯队里,智能指数并列第 5,速度垫底,同分里最贵------是 Step 5 Preview 的两倍。
所以 K3.1 要补的课有两门,不是一门。13% 是能力那门,$2.00 和 37 tok/s 是可用性那门。后者更难------它跟模型结构无关,跟卡有关。
一家在筹备上市的公司,输不起第二次限流
这里还有一层,跟分数无关,但会决定 K3.1 长什么样。
今年 7 月 K3 发布后,月之暗面在 48 小时内被请求量打穿,官方公告说请求"远超预测",直接暂停了新用户订阅,只保已有会员,然后分批重开。同一份公告里还提到,要把 Kimi 主会员和 Kimi Code 拆成两个套餐。
这件事的商业背景是:据 China Daily 当时的报道,月之暗面的年化收入从 4 月的 2 亿美元涨到 6 月的 3 亿美元,K3 发布后又翻了几倍;公司已经在向股东分发决议、筹备港股上市,可能在半年内完成 IPO。
一家准备上市的公司,最怕的不是榜单掉一名,是用户付了钱用不上。
所以你会看到一个矛盾的价格策略:K3 把输出定价定在 100 元 / 百万 token,是 DeepSeek V4-Pro 和小米 MiMo-V2.5-Pro 的十几倍、GLM-5.2 的 3.5 倍、Qwen3.7-Max 的 2.8 倍。分析师给的解释是"用能力定价,结束国内低价内卷"。
但用户侧的体感是另一回事:贵、慢、还限流。
这两个矛盾,就是 K3.1 这次真正的考题。 不是"能不能追平 Astra",是"追平之后端不端得住"。37 tok/s 和每任务 20 分钟,是端不住的证据。
1/14 这个数,别急着信
社区里流传最广的一个数字是:Kibitz 做同样的任务,token 成本只有 GPT-6 Astra 的 1/14。
这个说法有两个问题。
第一,口径不明 。如果是按 token 单价算,K3 现在官方价是输入 3、输出15 每百万 token,Astra 是 10/50,比值约 1/3,不是 1/14。想凑到 1/14,得假设 Kibitz 的定价又降了一大截------这是推测,不是公告。
第二,AA 官方算的是每任务成本,不是每 token 价格 。按这个口径,K3 是 2.00,Astra是3.26,只便宜 39%。原因是 K3 一个字一个字往外吐,单任务要 8 万个 token(4.8 万输出 + 3.2 万推理),单价再便宜也填不平。
便宜的单价 + 啰嗦的输出 = 不便宜的实际账单。 Agent 时代按 token 烧钱,这个账要算总账,不是算单价。
一句冷水,和怎么自己验
机器之心那篇的最后一段值得单独拎出来:实际效果参差不齐。有的测试里,Kibitz 能摸到 GPT-6 Astra Medium 和 Opus 5.5 Medium 的水平;有的测试里,质量掉得相当明显,前后判若两模。
比较合理的解释是:Arena 上挂的八成是训练途中的某个检查点,不是最终版。 检查点的特点是上限已经露出来了,下限还没长齐。
所以现在能确认的只有一件事:上限很高。 下限、速度、价格、许可证,一条都还没到能下结论的时候。
想自己验的话,路径是这样的:打开 Arena.ai 的 Code Arena,随便扔一个又长又难的编码或推理题进去,投完票看对面坐的是谁。Kibitz 和 Kalmia 是随机刷出来的,脸黑的要多抽几把。官方发布前免费,过时不候。
输入框的提示语已经改成了"或做个 Agent 任务"------产品叙事先走了一步。
如果 K3.1 月底真的发了,我最想先看三个数,按顺序:Terminal-Bench 4.0 有没有从 13% 跳上去、每任务成本有没有从 $2.00 降下来、输出速度有没有从 37 tok/s 提起来。
三个数里只要有一个没动,那"直追 Astra"就还只是一句网友感受。
后台回我「k31」,我把这篇用到的榜单原始数据、对比页链接、和 K3.1 发布后该盯的三个数整理成一份发你。
你手上有让 Agent 跑终端的真实活儿吗?评论区留一句最麻烦的那个,月底我挑几个,拿 K3.1 和 Astra 一起复跑一遍。