项目配套完整开源仓库 : github.com/xliulc-lang...
本系列文章记录阶段二「C++ 构建体系与链接原理」的两大核心实战:
- 【实战项目一】脱离 IDE 黑盒:GCC 编译四大阶段、汇编级优化对抗与工业级编译门禁 (👈 当前正在阅读)
- 【实战项目二】透视二进制黑盒:ELF 核心段剖析、虚函数逆向与 Binutils 生产发布规范
本篇目录
- [1.1 认知重塑:为什么现代 C++ 工程师必须脱离 IDE 的绿色运行按钮?](#1.1 认知重塑:为什么现代 C++ 工程师必须脱离 IDE 的绿色运行按钮? "#11-%E8%AE%A4%E7%9F%A5%E9%87%8D%E5%A1%91%E4%B8%BA%E4%BB%80%E4%B9%88%E7%8E%B0%E4%BB%A3-c-%E5%B7%A5%E7%A8%8B%E5%B8%88%E5%BF%85%E9%A1%BB%E8%84%B1%E7%A6%BB-ide-%E7%9A%84%E7%BB%BF%E8%89%B2%E8%BF%90%E8%A1%8C%E6%8C%89%E9%92%AE")
- [1.2 实验拆解一:编译流水线四大阶段逐级透视(预处理、编译、汇编、链接)](#1.2 实验拆解一:编译流水线四大阶段逐级透视(预处理、编译、汇编、链接) "#12-%E5%AE%9E%E9%AA%8C%E6%8B%86%E8%A7%A3%E4%B8%80%E7%BC%96%E8%AF%91%E6%B5%81%E6%B0%B4%E7%BA%BF%E5%9B%9B%E5%A4%A7%E9%98%B6%E6%AE%B5%E9%80%90%E7%BA%A7%E9%80%8F%E8%A7%86%E9%A2%84%E5%A4%84%E7%90%86%E7%BC%96%E8%AF%91%E6%B1%87%E7%BC%96%E9%93%BE%E6%8E%A5")
- [1.3 实验拆解二:GCC 优化级别 (-O0 ~ -O3, -Os) 汇编级对抗与 2000 万规模基准压测](#1.3 实验拆解二:GCC 优化级别 (-O0 ~ -O3, -Os) 汇编级对抗与 2000 万规模基准压测 "#13-%E5%AE%9E%E9%AA%8C%E6%8B%86%E8%A7%A3%E4%BA%8Cgcc-%E4%BC%98%E5%8C%96%E7%BA%A7%E5%88%AB--o0---o3--os-%E6%B1%87%E7%BC%96%E7%BA%A7%E5%AF%B9%E6%8A%97%E4%B8%8E-2000-%E4%B8%87%E8%A7%84%E6%A8%A1%E5%9F%BA%E5%87%86%E5%8E%8B%E6%B5%8B")
- [1.4 实验拆解三:工业级编译告警门禁与 -g 调试符号内核机制](#1.4 实验拆解三:工业级编译告警门禁与 -g 调试符号内核机制 "#14-%E5%AE%9E%E9%AA%8C%E6%8B%86%E8%A7%A3%E4%B8%89%E5%B7%A5%E4%B8%9A%E7%BA%A7%E7%BC%96%E8%AF%91%E5%91%8A%E8%AD%A6%E9%97%A8%E7%A6%81%E4%B8%8E--g-%E8%B0%83%E8%AF%95%E7%AC%A6%E5%8F%B7%E5%86%85%E6%A0%B8%E6%9C%BA%E5%88%B6")
- [1.5 总结与高频面试八股复盘清单](#1.5 总结与高频面试八股复盘清单 "#15-%E6%80%BB%E7%BB%93%E4%B8%8E%E9%AB%98%E9%A2%91%E9%9D%A2%E8%AF%95%E5%85%AB%E8%82%A1%E5%A4%8D%E7%9B%98%E6%B8%85%E5%8D%95")
一、实战项目一:脱离 IDE 黑盒------GCC 编译四大阶段、汇编级优化对抗与工业级编译门禁
在 Windows Visual Studio 或 CLion 等现代集成开发环境中,初学者习惯了点击绿色的"Run"按钮。点击之后,源码自动变成运行中的程序。
然而,一旦脱离图形界面进入 Linux 生产环境,面对复杂的微服务工程、持续集成(CI/CD)流水线以及以下典型故障时,IDE 封装的抽象就会彻底失效:
- 编写了头文件声明,编译通过了,链接时却突然报出
undefined reference to 'xxx'; - 代码在本地 Debug 跑得好好的,上线开启
-O2或-O3优化后出现死循环或偶发段错误; - 线上发生 Crash 需要排查 Core Dump,却发现缺少调试符号,或者担心开启
-g会严重拖垮服务运行性能; - 业务代码中潜伏着隐蔽的有符号/无符号转换漏洞,裸编译静默通过,上线引发资产计算穿透。
要解决这些问题,必须亲手将 GCC/Clang 的编译流水线拆开,在磁盘上逐一审视每一个阶段的产物与符号表。(配套代码位于仓库 projects/stage_2/compile_pipeline_lab/)。
1.1 认知重塑:为什么现代 C++ 工程师必须脱离 IDE 的绿色运行按钮?
在 Linux 下,编译器(如 g++)本质上是一个驱动程序(Driver),它隐藏了底下四个核心子程序的链式调用:
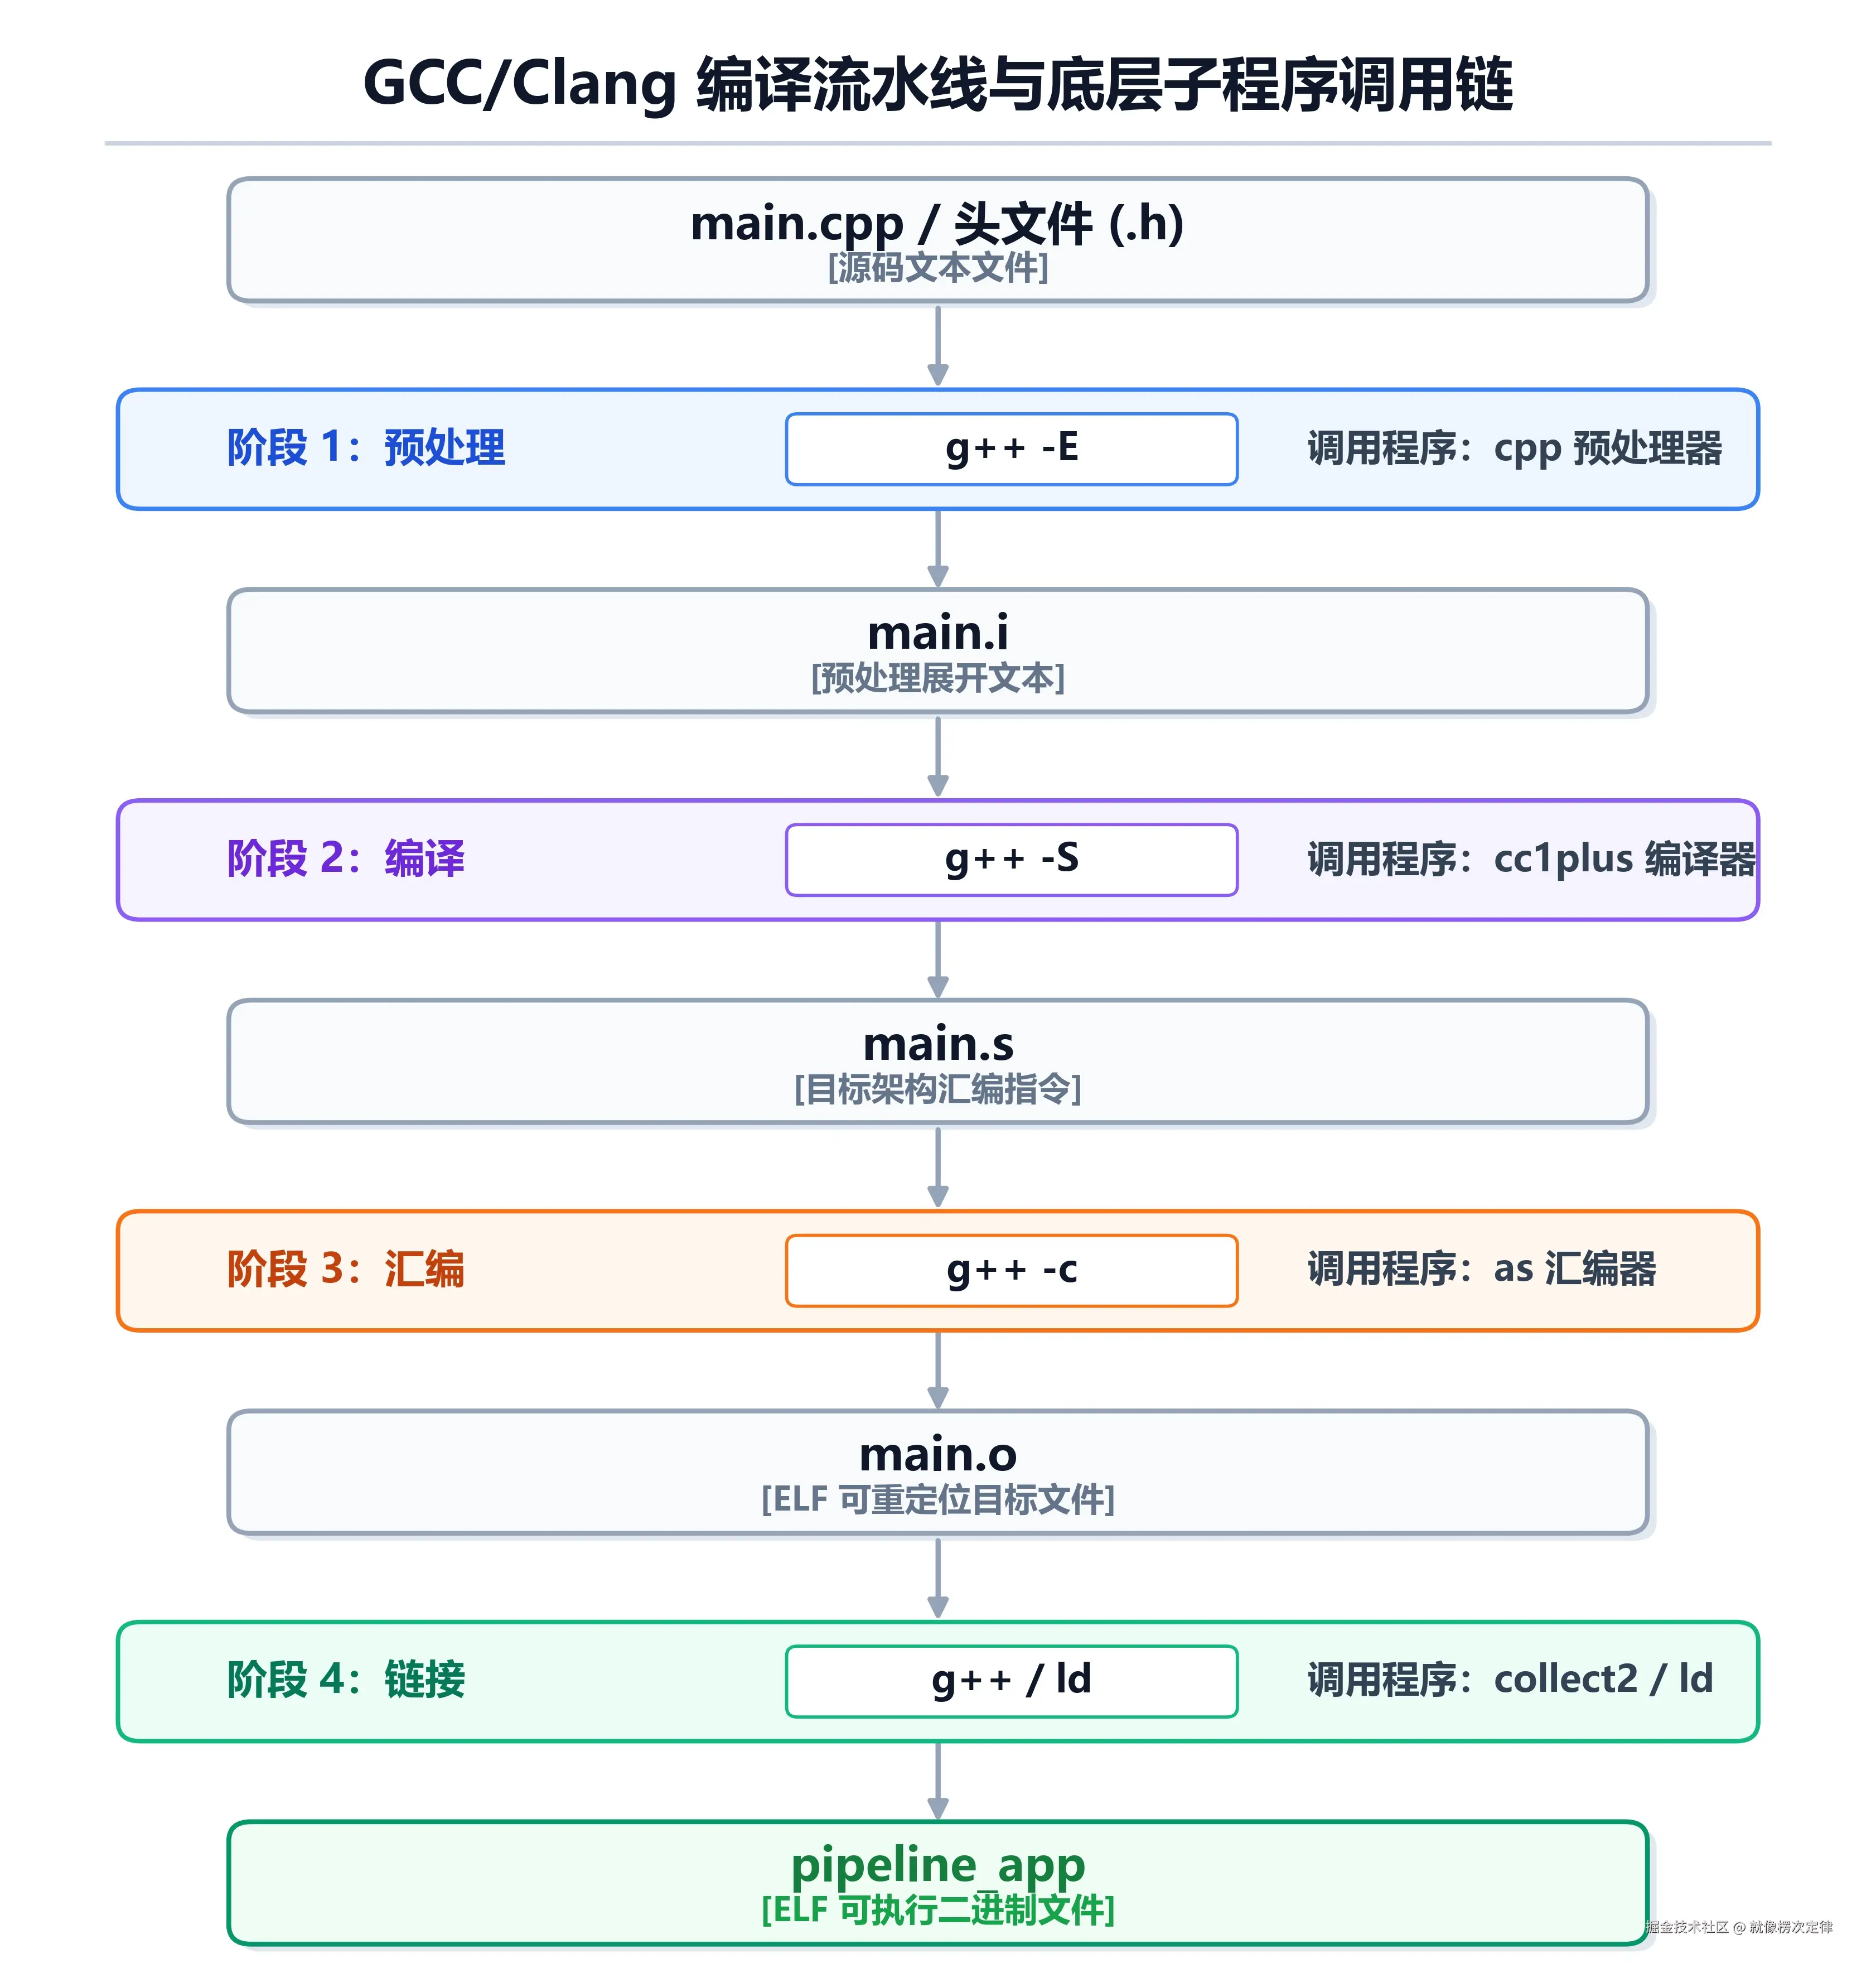
每一阶段都有其独立的职责边界和排错工具。当构建报错发生时,第一反应应当是精准定性该错误发生在哪个阶段,而不是盲目修改代码重试。
1.2 实验拆解一:编译流水线四大阶段逐级透视(预处理、编译、汇编、链接)
进入子实验目录 part1_pipeline/,我们将一段包含头文件、宏定义、多模块全局变量、函数重载的业务代码(main.cpp、logger.cpp、math_ops.cpp),显式分解为磁盘产物。
1.2.1 预处理阶段 (g++ -E):文本层面的替换与展开
预处理阶段主要执行纯文本替换操作,不涉及任何 C++ 语法和类型检查。
bash
# 显式执行预处理,传入宏定义 ENABLE_DEBUG_LOG=1 并引入头文件目录 include
g++ -E -Iinclude -DENABLE_DEBUG_LOG=1 main.cpp -o build_artifacts/main.i
审查产物 build_artifacts/main.i,可以观察到以下底层现象:
- 行数剧烈膨胀 :源码
main.cpp仅有 40 行,展开#include <iostream>与工程头文件后,生成的main.i达到 近 30,000 行。在 C++ 中包含大型标准库头文件成本极高,这也是现代 C++ 引入 Module 的根源。 - 注释被彻底擦除 :源代码中的单行注释(
//)与块注释(/* ... */)在预处理后荡然无存。 - 宏的就地展开 :源码中的宏调用
CALC_SQUARE(9)被直接替换为文本((9) * (9)),APP_VERSION被替换为"2.4.0"。 - 条件编译生效 :由于传递了
-DENABLE_DEBUG_LOG=1,#ifdef ENABLE_DEBUG_LOG分支内的代码被保留,未激活分支被直接裁剪。
1.2.2 编译阶段 (g++ -S):C++ Name Mangling(名字修饰)探秘
编译阶段调用真正的编译器(cc1plus),将预处理文本转化为特定 CPU 架构的汇编指令(x86-64)。
bash
g++ -S -std=c++17 -Iinclude build_artifacts/main.i -o build_artifacts/main.s
g++ -S -std=c++17 -Iinclude src/math_ops.cpp -o build_artifacts/math_ops.s
核心机制剖析:为什么会有 Name Mangling?
底层的汇编器与链接器历史悠久,只认识扁平的函数符号名,原生不支持"同名重载函数"与"命名空间" 。
为了实现 C++ 的多态与重载,C++ 编译器在生成汇编代码时,会依据函数的作用域、函数名以及形参类型列表,将函数签名编码(倾扎/修饰)成全局唯一的汇编符号。
我们在 math_ops.cpp 中定义了两个同名的重载加法函数:
cpp
namespace lab_pipeline {
    int add(int a, int b) { return a + b; }
    double add(double a, double b) { return a + b; }
}
通过 grep 检索汇编文件 math_ops.s:
bash
grep -E "_ZN12lab_pipeline3addE" build_artifacts/math_ops.s输出的汇编符号如下:
_ZN12lab_pipeline3addEii:_Z开头代表修饰符号,N...E包裹嵌套命名空间,ii代表两个int类型入参。_ZN12lab_pipeline3addEdd:末尾的dd代表两个double类型入参。
使用 GNU 诊断工具 c++filt 可以直接反解还原:
bash
c++filt _ZN12lab_pipeline3addEii
# 输出: lab_pipeline::add(int, int)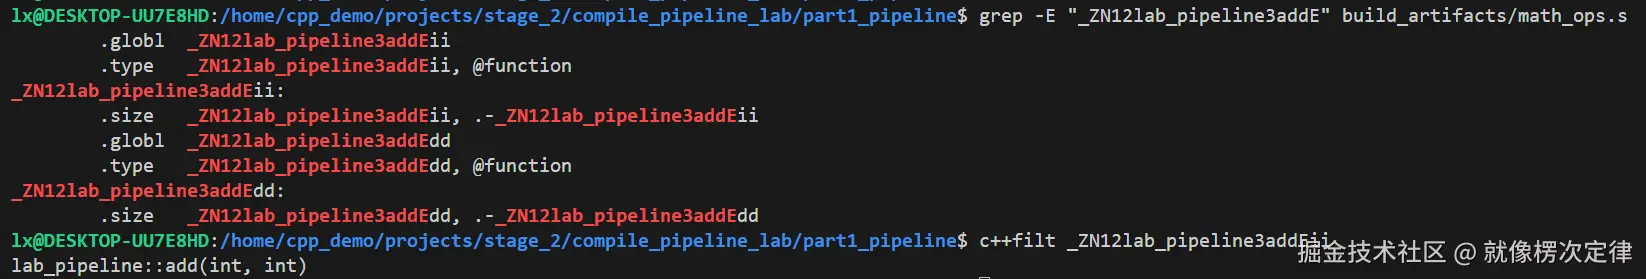
1.2.3 汇编阶段 (g++ -c):机器码生成与未决符号(Undefined Symbols)
汇编器(as)将文本汇编指令逐行翻译成 CPU 架构识别的二进制机器码,生成 ELF 64-bit Relocatable 可重定位目标文件(.o)。
bash
g++ -c build_artifacts/main.s -o build_artifacts/main.o
g++ -c build_artifacts/logger.s -o build_artifacts/logger.o
g++ -c build_artifacts/math_ops.s -o build_artifacts/math_ops.o
此时使用 file 命令查看 main.o:
text
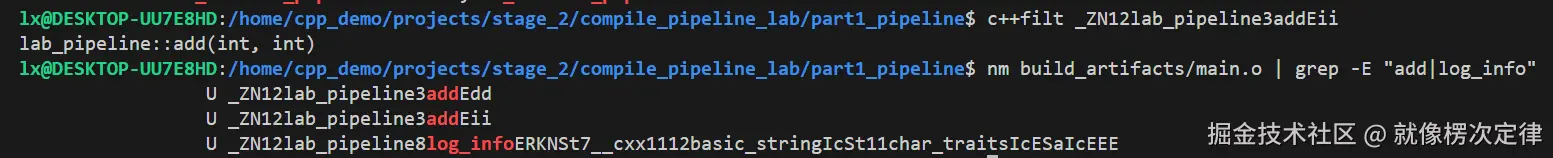
build_artifacts/main.o: ELF 64-bit LSB relocatable, x86-64, version 1 (SYSV), not stripped由于 main.cpp 中调用了 logger.cpp 和 math_ops.cpp 提供的函数,而此时各模块还是独立的 .o 文件,尚未进行链接 。使用 nm 工具查看 main.o 的符号表:
bash
nm build_artifacts/main.o | grep -E "add|log_info"
text
                 U _ZN12lab_pipeline3addEii
                 U _ZN12lab_pipeline8log_infoERKNSt7__cxx1112basic_stringIcSt11char_traitsIcESaIcEEE
符号前面的 U(Undefined) 极其关键!它表明此时这些外部符号是未决的,其真实的物理内存地址是一片空白(填 0),必须等待链接阶段进行地址重定位。
1.2.4 链接阶段 (g++ / ld) 与经典报错 undefined reference
链接器将离散的 .o 目标文件合并,把代码段(.text)与数据段(.data)拼接在一起,并计算所有未决符号的相对/绝对跳转偏移量(重定位)。
bash
# 正常链接:同时传入所有参与构建的目标文件
g++ build_artifacts/main.o build_artifacts/logger.o build_artifacts/math_ops.o -o build_artifacts/pipeline_app
此时再次查看 pipeline_app 的符号表,原本为 U 的符号已全部解析为代码段中的已决符号 T(Text Section)。
故障注入:体验经典的 undefined reference 报错
如果在链接阶段故意漏掉依赖模块,只编译链接 main.o:
bash
g++ build_artifacts/main.o -o build_artifacts/bad_app终端将抛出最经典的错误信息:
text
build_artifacts/main.o: in function 'main':
main.cpp:(.text+0x5a): undefined reference to 'lab_pipeline::add(int, int)'
main.cpp:(.text+0x7b): undefined reference to 'lab_pipeline::log_info(std::__cxx11::basic_string<char, std::char_traits<char>, std::allocator<char> > const&)'
collect2: error: ld returned 1 exit status
面试与排障第一准则 :
留意最后一行明确写着
collect2: error: ld returned 1 exit status。
ld是 Linux 下的标准链接器,这铁证说明:代码的 C++ 语法没有任何问题,头文件声明也完全正确,预处理、编译、汇编全部成功通过了,错误 100% 发生在最后的链接组装期!根因就是链接器在给定的输入文件中搜寻不到该符号的具体机器指令实现。
1.3 实验拆解二:GCC 优化级别 (-O0 ~ -O3, -Os) 汇编级对抗与 2000 万规模基准压测
进入 part2_optimization/ 目录。编译器优化绝不仅仅是"运行快一点",其在汇编指令层面会对代码进行脱胎换骨式的重构。
1.3.1 汇编级深度对比:常量折叠(Constant Folding)与死代码消除(DCE)
观察 bench_compute.cpp 中的一个测试函数:
cpp
long long constant_folding_demo() {
    long long sum = 0;
    for (int i = 1; i <= 1000; ++i) {
        sum += i;
    }
    if (sum < 0) {
        std::cout << "Unreachable dead branch!" << std::endl;
    }
    return sum;
}
我们分别在 -O0(无优化)与 -O2(深度优化)下生成汇编代码并进行对比:
1. -O0 下的汇编指令(低效直译)
assembly
# bench_O0.s 片段
_Z22constant_folding_demov:
    pushq   %rbp
    movq    %rsp, %rbp
    movq    $0, -8(%rbp)        # sum = 0
    movl    $1, -12(%rbp)       # i = 1
.L2:
    cmpl    $1000, -12(%rbp)    # 比较 i 是否小于等于 1000
    jg      .L3
    movl    -12(%rbp), %eax
    cltq
    addq    %rax, -8(%rbp)      # sum += i
    addl    $1, -12(%rbp)       # ++i
    jmp     .L2                 # 循环 1000 次!
.L3:
    # 还要继续判断 sum < 0 分支...
在 -O0 下,编译器严格按照源码语义,在栈上分配局部变量,忠实地执行了 1000 次寄存器加载、内存递增与条件跳转。
2. -O2 下的汇编指令(编译器降维打击)
assembly
# bench_O2.s 片段
_Z22constant_folding_demov:
    movl    $500500, %eax       # 直接加载常量 500500 返回!
    ret
在 -O2 优化下,编译器的静态数据流分析器直接算出从 1 累加到 1000 的结果是 500500。
整整 1000 次循环、局部变量栈帧开销,以及后面永远不可能为负数的 if (sum < 0) 分支,被编译器全部消除(Dead Code Elimination),最终优化为一条加载立即数的高速指令!
1.3.2 密集向量计算压测 (20,000,000 规模元素)
运行自动化基准压测脚本 compare_optimizations.sh,对 2000 万个浮点数进行密集向量变换,各优化级别的真实性能与二进制特征如下:
bash
./compare_optimizations.sh| 优化级别 | 核心函数汇编行数 | 二进制文件体积 | 执行耗时 (ms) | 相对加速比 |
|---|---|---|---|---|
-O0 |
62 行 | 26.6 KB | 158.4 ms | 1.00x(基准) |
-O1 |
36 行 | 16.8 KB | 48.2 ms | ~3.28x |
-O2 |
22 行 | 17.2 KB | 17.6 ms | ~9.00x |
-O3 |
84 行(SIMD 展开) | 17.0 KB | 11.8 ms | ~13.42x |
-Os |
22 行 | 16.9 KB | 24.5 ms | ~6.46x |
深入思考:为什么工业界生产环境绝大多数默认使用
-O2而不是无脑上-O3?
- 代码膨胀与 CPU 缓存未命中 :
-O3会极其激进地进行函数循环展开(Loop Unrolling)和函数内联(Inlining),导致核心热点代码体积急剧膨胀,进而挤爆 CPU 的一级指令缓存(L1 i-Cache),在大型复杂业务工程中甚至可能出现反向减速;- 浮点与数学安全风险 :部分激进优化可能改变浮点计算的精度和微小结合律,带来偶发不可控的数值精度漂移。因此,
-O2是兼顾吞吐量、缓存友好度与稳定性的最佳工业平衡点。
1.4 实验拆解三:工业级编译告警门禁与 -g 调试符号内核机制
进入 part3_compiler_flags/ 目录。在企业级工程规范中,编译器参数直接决定了线上系统的稳定底线。
1.4.1 裸编译的灾难:隐蔽 Bug 现场复原
在文件 suspicious_code.cpp 中预先埋伏了数个生产常见的"带病代码":
cpp
// 隐患 1: 有符号与无符号整数混合比较
int a = -1;
unsigned int b = 1;
if (a < b) {
    // 预期成立,但实际由于隐式转换,-1 被转为 4294967295 (0xFFFFFFFF),导致逻辑颠倒!
}

// 隐患 2: 局部变量未初始化即参与运算
int uninitialized_var;
int result = uninitialized_var + 10; // 读取栈上残留脏数据!

// 隐患 3: 基类析构函数未声明为 virtual
class Base { public: ~Base() {} };
class Derived : public Base { ... };
Base* ptr = new Derived();
delete ptr; // 内存泄漏!派生类析构函数被直接跳过!
如果不加任何警告参数直接裸编译:
bash
g++ suspicious_code.cpp -o build_flags/app_naive编译过程一片死寂,静默通过!
运行该程序,输出结果充满脏内存垃圾值与颠倒的业务判断逻辑。这种缺陷如果逃逸到生产环境,排查代价极其巨大。

1.4.2 大厂质量门禁:-Wall -Wextra -Werror
为防止此类低级失误合入代码主干,大厂的 CI/CD 流水线会开启最高级别编译拦截门禁:
bash
g++ -Wall -Wextra -Werror suspicious_code.cpp -o build_flags/app_blocked终端瞬间输出红白报错,编译直接被强行中断:
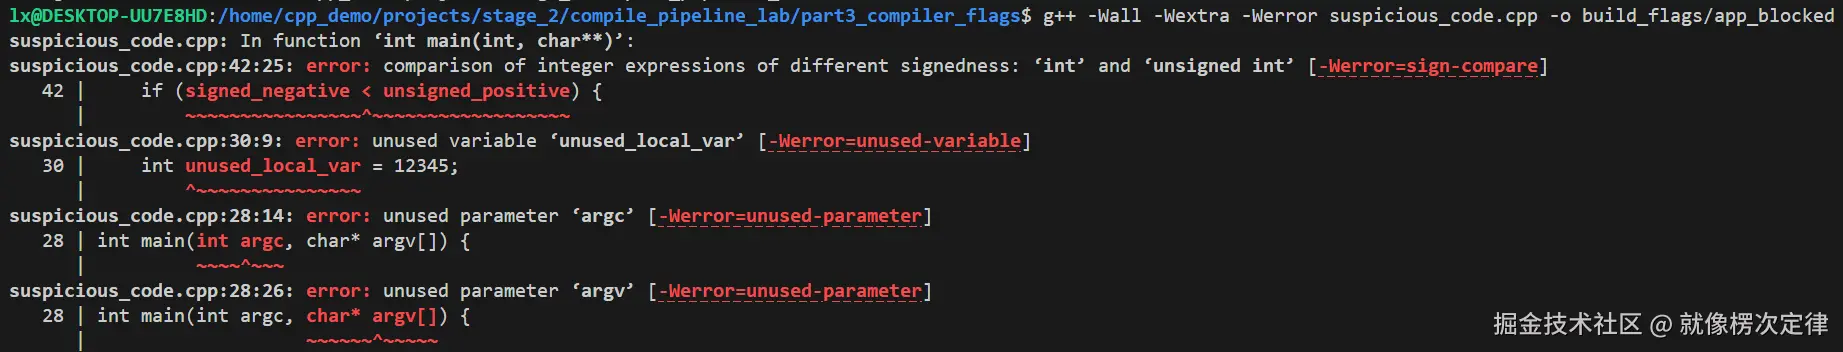
-Wall:开启大部分常见的警告(Warning All,包括变量未初始化、分支遗漏return等);-Wextra:开启更严苛的补充警告(包括有符号/无符号隐式提升比对、未使用的入参等);-Werror:将所有警告直接视作编译错误(Treat warnings as errors),只要有一处 Warning,编译立即失败,强行将质量防线前置到代码提交期。
1.4.3 核心面试题解密:-g 到底会不会拖慢程序运行速度?
很多刚接触 Linux 的开发者常有一种误解:"-g 生成了调试信息,让可执行文件变大了好几倍,肯定会严重拖慢程序运行速度,所以线上发布绝对不能带 -g"。
我们通过实验验证这一命题的真伪:
bash
# 分别编译无 -g 与带 -g 的程序
g++ -O2 test_debug_symbol.cpp -o build_flags/app_no_g
g++ -O2 -g test_debug_symbol.cpp -o build_flags/app_with_g
使用 ls -lh 查看体积:
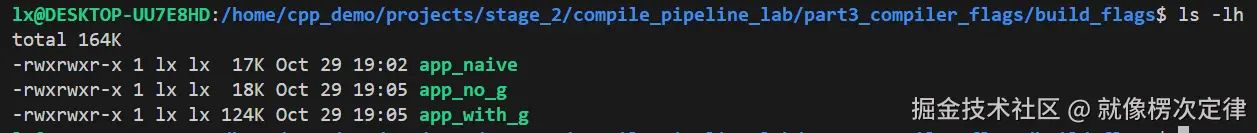
app_no_g:约 18 KBapp_with_g:约 124 KB(体积膨胀了近 7 倍!)
体积确实剧烈膨胀了,但它影响运行时性能吗?我们使用 readelf -S 深入观察 ELF 的节头表(Section Headers):
bash
readelf -S build_flags/app_with_g | grep "\.debug_"
text
  [28] .debug_aranges    PROGBITS         0000000000000000  00003050
  [29] .debug_info       PROGBITS         0000000000000000  00003080
  [30] .debug_abbrev     PROGBITS         0000000000000000  00009c90
  [31] .debug_line       PROGBITS         0000000000000000  0000a6c0
  [32] .debug_str        PROGBITS         0000000000000000  0000bf20
底层真相揭晓 :
仔细观察
readelf输出中的Flags标志列。正常会被 CPU 执行的代码段(.text)和数据段(.data)都带有A(Alloc) 属性,表示程序启动时需要操作系统分配内存。而所有 DWARF 调试段(
.debug_*)均没有A标志!这意味着:Linux 在通过
execve系统调用将程序装载进内存时,根本不会把.debug_*段映射到物理内存中!结论 :
-g绝对不会拖慢程序的运行时指令执行速度,也不会增加进程常驻内存(RSS)!它仅仅是占用了磁盘空间和网络传输带宽而已。
如果需要发布极小体积的二进制,只需使用 strip 即可无损剥离符号:
bash
strip --strip-all build_flags/app_with_g -o build_flags/app_stripped
# 体积瞬间从 123 KB 回退到 15 KB,比原始 app_no_g 还要轻量!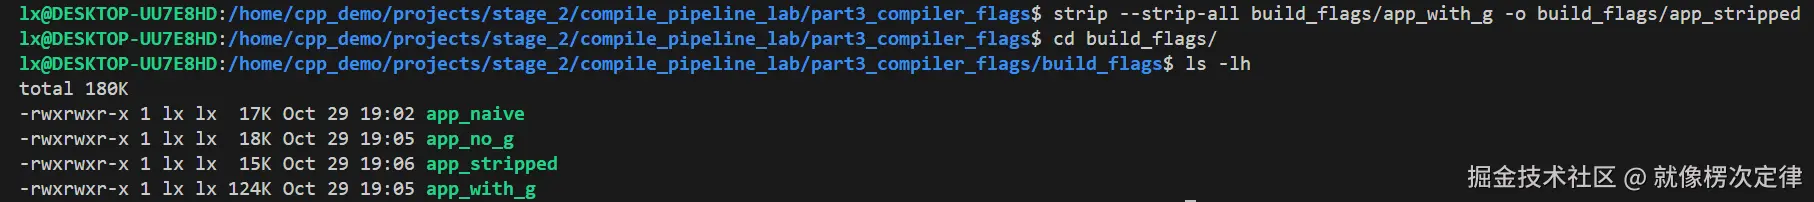
写在最后与下篇预告
写在最后
在现代 Linux C++ 工程化体系中,构建系统远不仅是敲击 make 或点击 IDE 上的运行按钮。从高级语言源码(.cpp)到最终的可执行程序(ELF),每一层转换都有其明确的职责分工与底层边界:
- 预处理阶段:专注文本维度的宏展开、头文件拼接与条件编译分支裁剪;
- 编译阶段:负责词法语法分析、Name Mangling(名字修饰)与目标架构汇编指令生成;
- 汇编阶段 :将汇编代码翻译为 CPU 可识别的机器码,生成未决符号(
U)等待填坑的目标文件; - 链接阶段:通过符号解析与地址重定位,最终合并段结构产出完整的可执行程序。
唯有彻底搞清楚这一流水线上的每一个阶段产物,并在代码提交时通过严苛的 -Wall -Wextra -Werror 门禁消灭隐患,才能在面对 undefined reference、优化级别引发的行为异常或线上崩溃时,拥有从容精准的排障直觉。
本项目涉及的所有测试源码、故障复现用例与基准压测脚本均已开源,推荐在本地 WSL 环境中克隆并单步验证:
bash
git clone https://github.com/xliulc-lang/linux-notebook.git
cd linux-notebook/projects/stage_2/compile_pipeline_lab
chmod +x run_all.sh
./run_all.sh
下篇预告:透视二进制黑盒------ELF 核心段剖析与 Binutils 生产发布规范
当可执行文件生成之后,它在 Linux 底层到底是以何种数据结构存储的?
在阶段二的下一个实战项目中(对应开源仓库 projects/stage_2/elf_binutils_lab),我们将视线由"编译流水线"推进到"二进制程序本身",借助 Linux 强大的 Binutils 工具链(readelf、objdump、nm、objcopy、strip),全面透视 ELF 的内部世界:
- ELF 核心段结构解密 :利用
readelf现场验证,为什么声明一个 10MB 的未初始化全局大数组,生成的二进制文件体积却"几乎为零"?(剖析.bss段的NOBITS特性); - 源码混显与虚函数逆向 :使用
objdump -S -C -M intel实现 C++ 源码与汇编指令的交织混显,逆向追踪 C++ 多态与虚函数表(vtable/vptr)在底层的间接寻址指令; - 跨语言混编与符号表体系 :通过
nm深入识别T/U/D/B/R符号类型代码,现场复现并攻克 C/C++ 混编时因遗漏extern "C"导致的链接崩溃; - 大厂工业级发布标准 :实操使用
objcopy剥离独立.debug符号文件,利用strip为生产二进制瘦身 80%+,并通过.gnu_debuglink实现"线上极轻量发布、本地通过 GDB 精准定位 Crash 源码行号"的双赢架构。
敬请期待下篇更新!