Cosmos Curator 总览:从一条样本的组成,选对数据处理入口
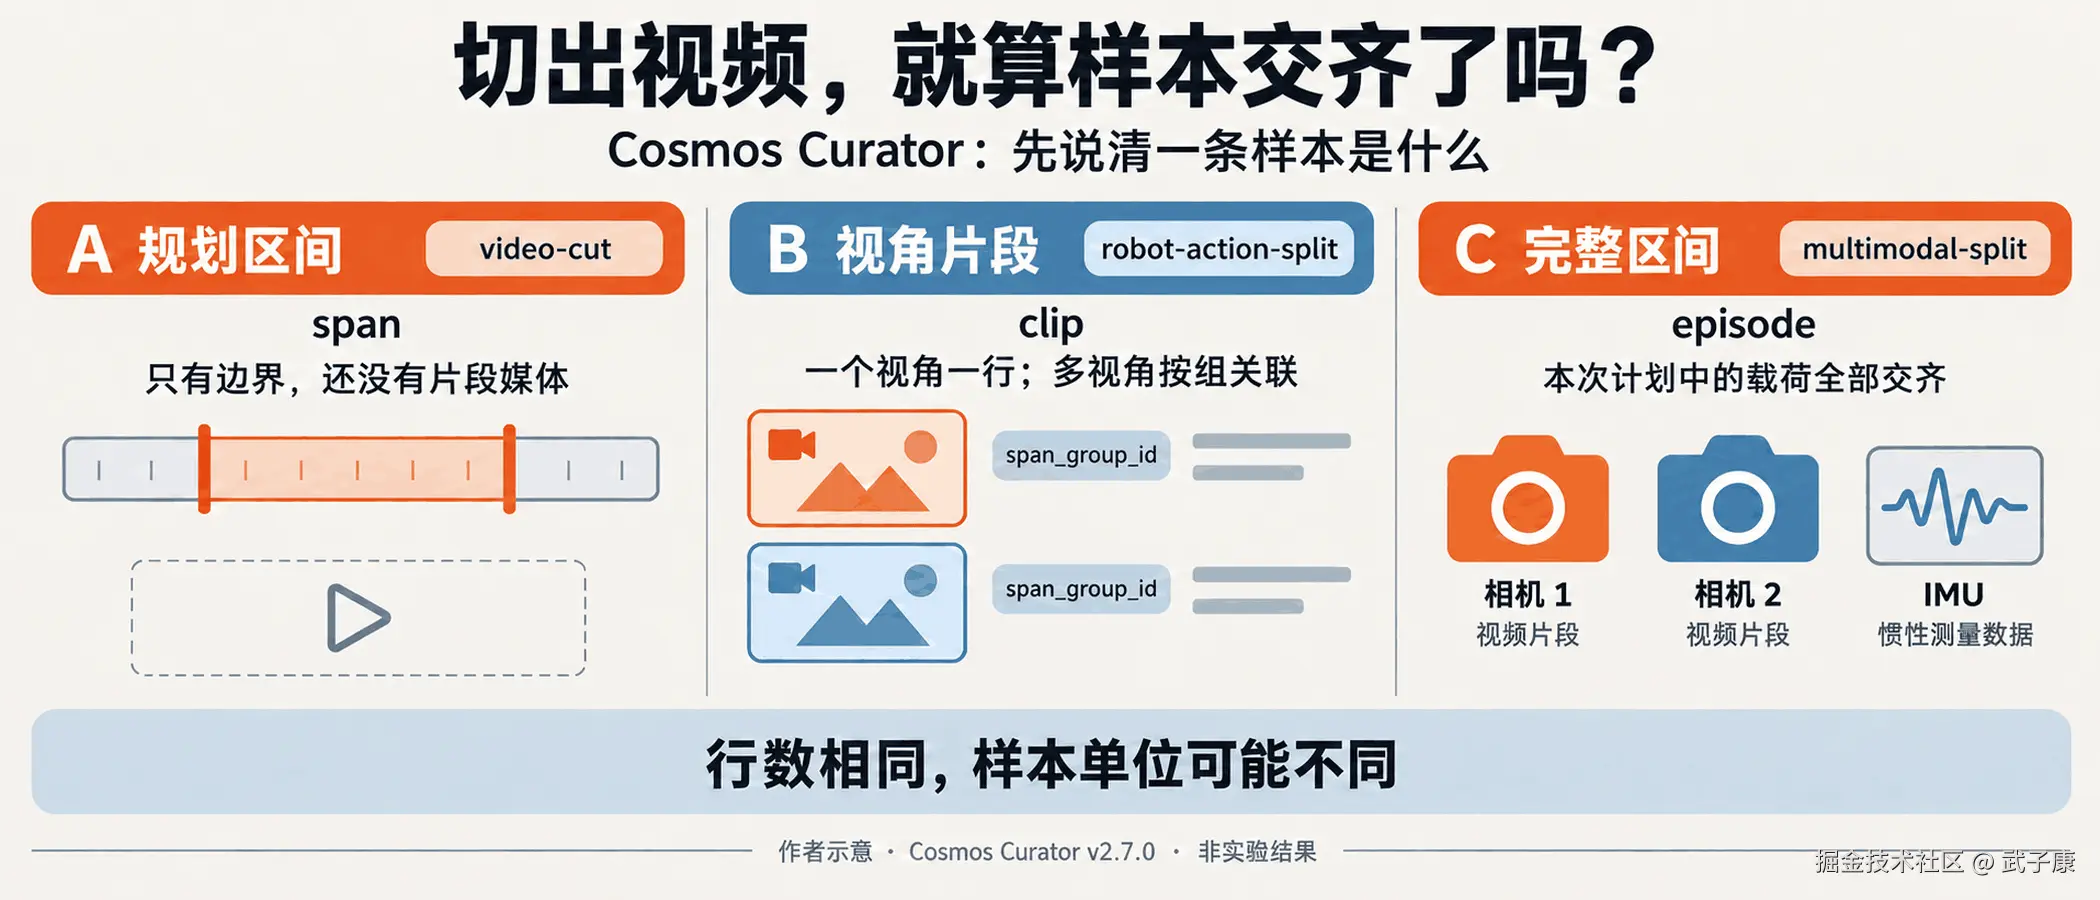
假设团队收到了两批巡逻数据。第一批是普通 MP4,希望切出片段、生成描述,供人检索。第二批包含前视和侧视视频,还有同次采集的 IMU;训练任务要求两路画面与运动信息共同组成一条样本。
它们都需要"切视频",但交付标准不同。第一批找到一个可播放、可追溯的片段,就能继续做描述。第二批即使生成了几千个 MP4,也可能连一条完整样本都没交齐:某个区间缺了侧视画面,或者 IMU 处理失败。
选择 Cosmos Curator 入口时,最先要确定的就是这件事:下游消费的一条样本是什么,由哪些输入共同组成,什么时候才算完成。 再据此选择已有视频流水线或 Curator Next recipe,能更早发现数据格式和交付方式的不匹配。
本文以官方仓库 v2.7.0 的文档和源码为准,首次核对日期为 2026 年 10 月 1 日,2026 年 10 月 13 日重新从官方固定 tag 读取并核对十份文档/源码,均与原捕获逐字一致。tag 仍指向提交 78abe61f24a3718153a45d6ba4f13429c4988e63。当前默认 main 已指向另一个提交;本篇不把其余新代码行为追溯套入 v2.7.0。巡逻场景与新增清单程序都是构造示例;清单已本地运行,没有运行 Curator、GPU 流水线或验证训练效果。
一套仓库里,已经有两种组织工作的方式
理解 Curator,可以从它能把原始材料加工成什么开始。
现有视频参考流水线先通过 split-annotate 切分、筛选、生成描述和向量;dedup 利用向量做语义去重;shard-dataset 再将片段和描述组织成文档指定的 WebDataset。这些入口覆盖了从视频到可消费数据的多个环节,却不是任何任务都要依次执行的统一流程。只做视频检索的团队,就需要依据自己的检索存储和消费接口决定后续加工。^1^
这些既有流水线与 Xenna 阶段模型有历史关联。Curator Next 则采用另一套编程方式:以 Ray Data 组织执行,以 Lance 保存表格数据,用可组合组件和 recipe 提供参考实现。Recipe 可以理解为一份可修改的处理方案,规定这一轮怎样读输入、执行操作和写出结果。媒体大文件仍可留在对象存储中,由表格记录引用。^2^
这个区别会影响接入代码。不能从"都属于 Curator"推出 Next recipe 沿用 Xenna 阶段接口,也不能把一个流程的输出路径直接交给另一个流程。官方在 v2.7.0 仍明确把 cosmos_curator.next 放在孵化命名空间:导入路径、配置、标识和 schema 都可能变化,现有流水线在过渡期继续可用。这里适合固定版本阅读和接入,不能预先承诺平滑升级。把已有消费者也列出来:如果下游读取固定输出目录,改入口同时意味着调整消费程序,不按名字新旧作决定。^2^
普通视频:先辨认手里的是切分计划,还是可播放片段
既有 split-annotate 的输出中,视频、向量和元数据分开放置。官方输出树里,与判断交付最相关的几项如下,省略了其他可选目录:^1^
text
{output_clip_path}/
├── clips/{clip-uuid}.mp4
├── metas/v0/{clip-uuid}.json
├── processed_videos/{input-video-relpath}.json
└── summary.json
这个结构能直接提醒消费者:拿到 MP4 只是拿到了媒体文件,生成描述的结果、来源与其他信息还要结合对应元数据读取。具体启用的处理阶段也决定了会有哪些字段和附属产物。
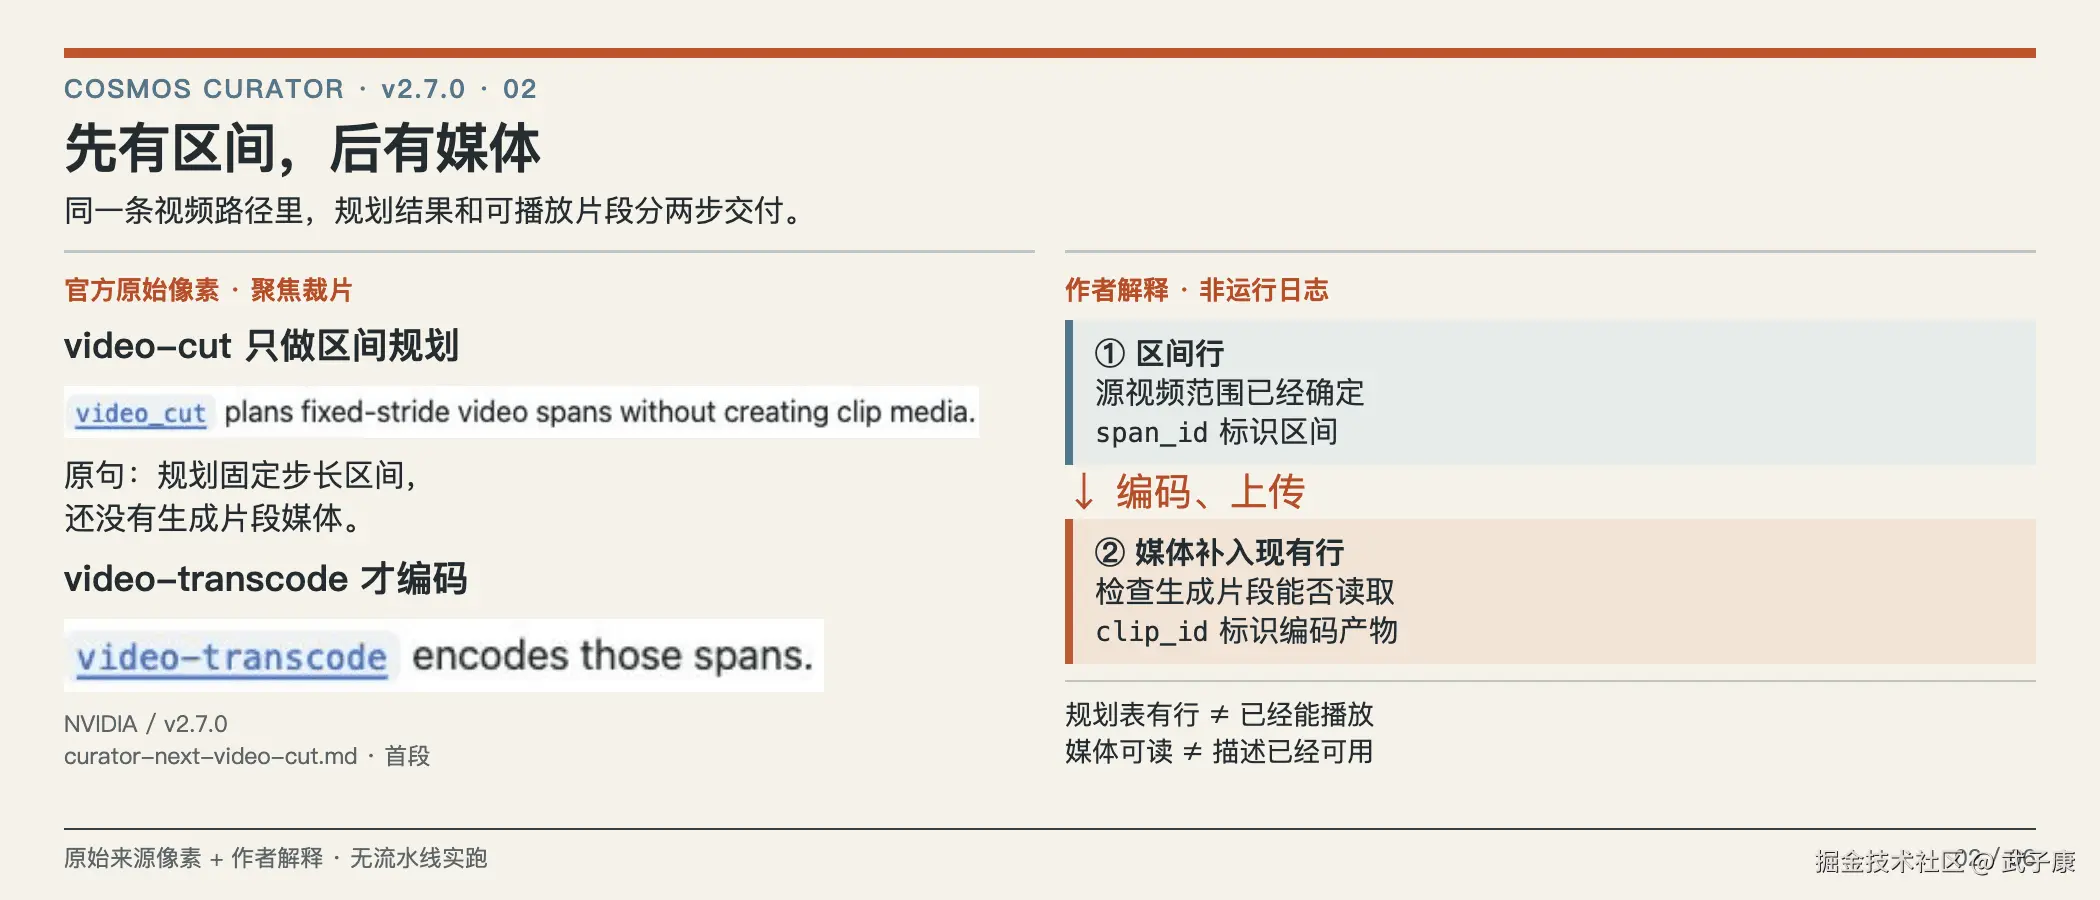
Next 的平面视频路径进一步把"决定切哪里"和"真的编码出来"拆开。v2.7.0 的 video-cut 规划固定步长区间并写入 Lance;它不生成片段媒体。输入按文档要求是 S3 MP4 URI 或递归 S3 根目录,并要求源 URI 对应的内容不可变。随后 video-transcode 才编码、上传片段,把媒体信息填回现有行。^3^^4^
下面保留官方 schema 中的两个关键字段,以及源码生成编码产物标识的表达式:^5^^6^
python
# video_cut/contracts.py:规划区间的标识
pa.field("span_id", pa.string(), nullable=False)

# video_transcode/contracts.py:编码产物的标识
pa.field("clip_id", pa.string(), nullable=False)
return canonical_digest({"span_id": span_id, "transcode_contract_id": contract_id})它说明区间和编码产物是两层身份。同一段源视频时间范围,可以在概念上保持相同的区间身份,而编码设置参与决定片段身份。这有利于把范围选择与物化媒体区分开;不意味着当前 recipe 允许在同一输出里随意覆盖已有编码结果 。官方转码流程会检查已完成片段的编码约定和目标位置,不兼容的片段会被拒绝。^4^
源码摘录中的 nullable=False 是字段最初构造;同一文件随后将转码扩展列转换为 nullable,允许上游继续追加尚未转码的 span 行。可为空的 schema 不意味着空值是完整片段:转码文档要求片段内要么全部待处理,要么每一行都具有匹配编码约定和目标位置的完成元数据;混合、部分填充或不兼容片段被拒绝。转码的有限运行回执也不能宣布后来追加的行已完成。消费端应核对本次表版本和所选行,不能仅见一个历史 completion 就忽略新 pending 行。^4^^6^
对开头的 MP4 检索任务,这给出了一个具体验收顺序:先检查区间是否覆盖了需要的内容,再检查转码后的媒体引用能否读取,最后检查描述是否绑定到正确媒体。video-cut 有结果行,并不代表检索服务已经可以播放;编码成功也不等于描述一定可用,描述还要绑定消费者选用的那次 clip 产物;失败要留在对应层,不将另外两步的成功拼成整条样本成功。这是消费契约设计,未运行检索服务。
v2.7.0 已移除旧 Next video-split recipe,文档指向 video-cut 加 video-transcode。碰到旧教程时,要把这条历史路径与现有 Xenna 视频流水线分开辨认,不能只替换命令名字后沿用所有旧表结构。^3^
从消费者反查,哪一种"成功"还没发生
源URI内容不可变的要求也应在接入前解释清楚。同一个路径如果悄悄换成另一份文件,区间身份和来源追溯就可能失去共同依据。团队应保存实际输入身份并约束替换方式,不能认为字符串相同就说明源内容没有变化。
编码条件变化则属于另一种情况:时间范围仍指向同一段来源,媒体产物却应按编码约定解释。如果消费者缓存了旧clip,处理团队又产生另一组编码结果,就需要明确选用哪一份,不能以"反正都是同一span"为由混用。官方兼容性检查不允许任意覆盖的边界,在这里正是保护身份的一部分;它没有替项目决定升级媒体时怎样更新下游引用。
多传感器数据:缺一路,可能影响的是整条样本
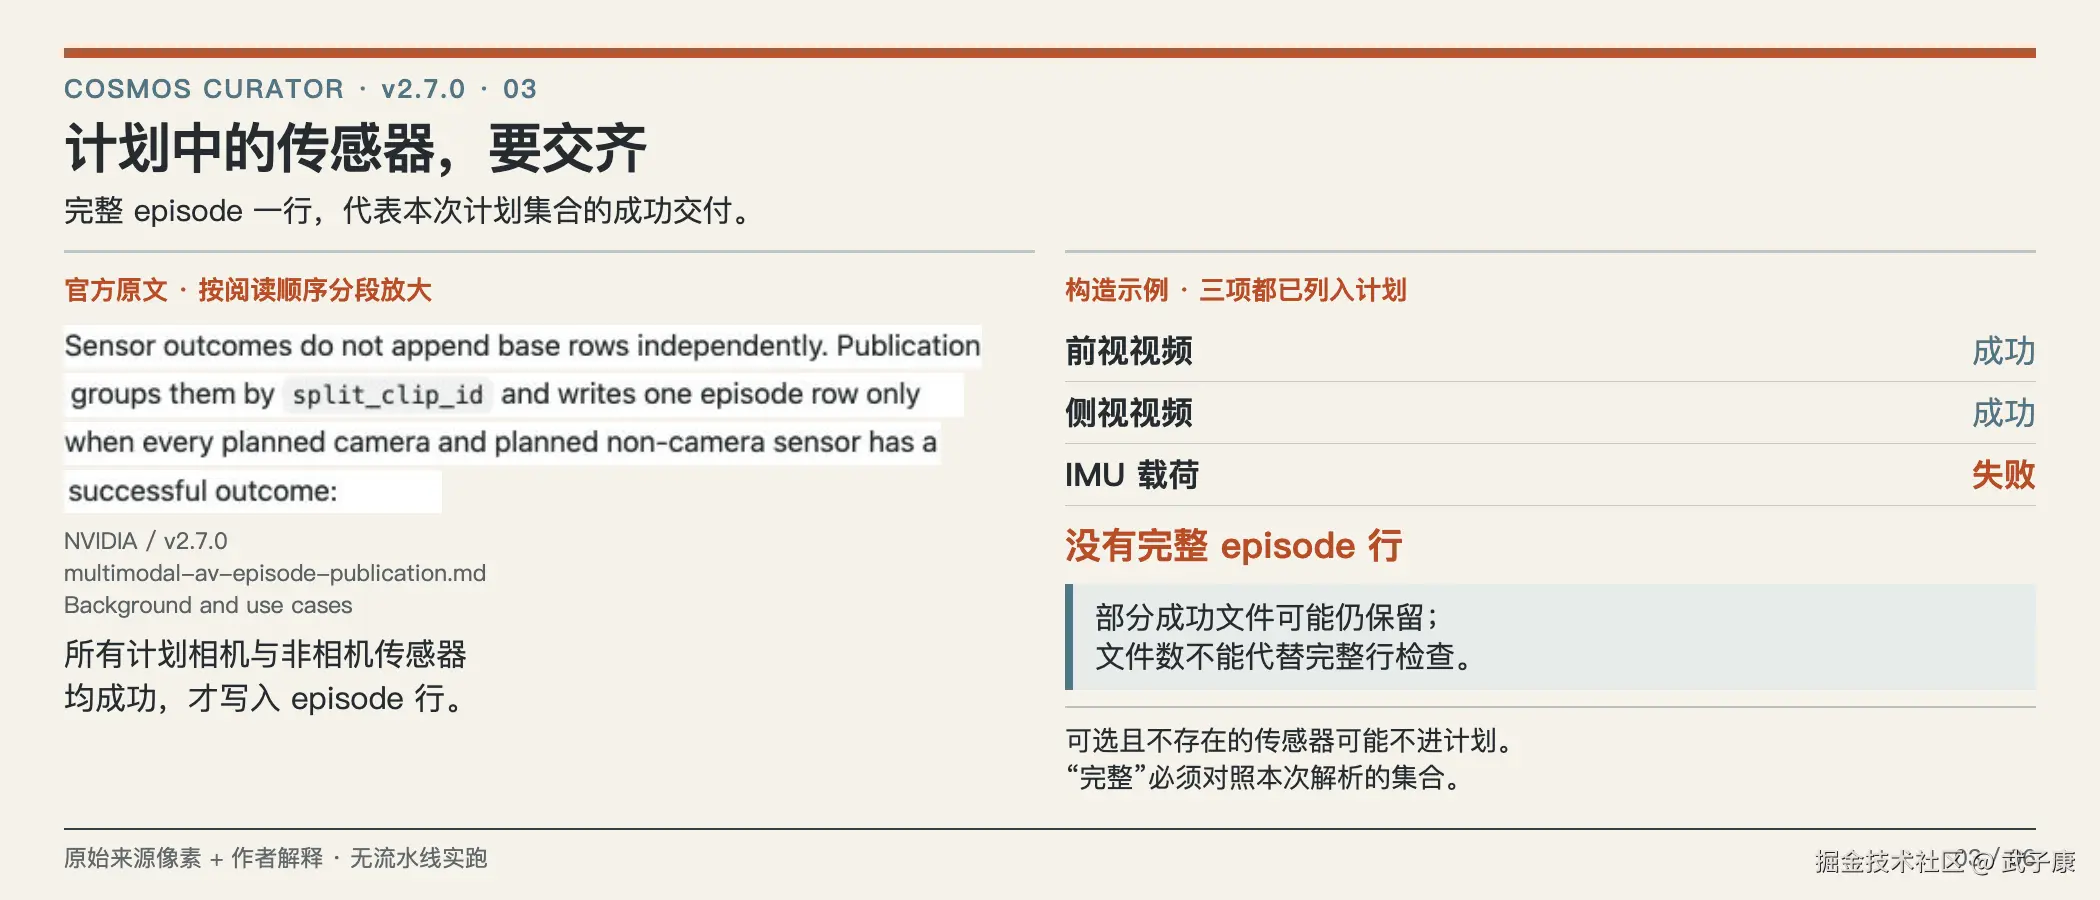
第二批巡逻数据的难点,来自"同一次区间要交齐什么"。v2.7.0 的 multimodal-split 把一个完整同步区间写成 episodes.lance 的一行。相机视频、时间附属文件、非相机传感器的 MCAP 文件仍是外部载荷,一行中保存它们的描述和引用。^7^
官方文档给出的结构,可以简化理解为:
text
一条 episode
├── episode_id
├── camera_media[]   各计划相机的媒体与时间文件描述
└── sensor_media[]   各计划非相机传感器的载荷描述
这里的数组表示一条区间内有多个传感器产物。相机名称是数据内容,无需为每一种相机配置新增一套顶层列。
更关键的是何时允许出现这一行。发布器把一个区间的结果归组,检查计划中的相机及非相机传感器是否齐备;缺项或失败会使该 episode 不进入完整结果表。成功生成的兄弟文件可能还留在存储里,用于诊断或重试。因此,目录里有前视 MP4、侧视 MP4,仍不能替代完整结果行的检查。诊断对象与可消费样本的清单应分开,排障时保留失败组关联身份,不把成功兄弟文件自动称作已发布样本。^7^^8^
对示例任务,假设前视、侧视与 IMU 都已列入本次计划,IMU 失败就可能导致该区间没有完整行。若一个可选传感器在规划时被判定为不存在,它不会被放进该会话的计划集合。于是"完整"的含义是满足本次已解析的传感器集合,不能据此声称所有硬件传感器都交齐了。两种情形最终都可能没有 IMU 文件,却含义不同;保存计划集合、计划身份和其来源依据,不能只写"无 IMU"。
这也解释了为什么验收必须同时保留"计划是什么"和"完成了什么"。仅统计存储里新增多少文件,会把部分成功当成整条样本成功。另一方面,历史上写入过完整行,也不能保证引用对象今天仍完整可读;读取时仍需根据描述验证所消费的载荷。^7^
固定版 assemble_episode_group() 比较 episode、来源、区间、采样、时间来源、split contract 及计划集合等共享事实;计划内缺项或终态 failure 产生 dropped 核算控制行,完整组才产生 complete 控制行。重复、未计划键或共享事实冲突属于合同错误;所谓 success 还必须有该传感器类型所需的产物描述。随后 stage_episode_batch() 只接受 complete 并投影正式 episode schema,不能把 dropped 控制行当成部分发布。这里是静态读源码的结论,不是本地执行了发布器。^8^
官方描述还分别保留 episode_id 的逻辑区间身份和 materialization_digest 的完整物化集合身份。后者由已登记的哈希与其他事实组成,并非额外读取全部外部文件后得到的校验。相机列表按名称排序是序列化顺序,不是模型输入视角顺序;消费者应显式选 camera key,并绑定具体媒体、大小与哈希。^7^
文件残留与完整样本,要在失败时区分
反过来,若一行完整episode已经存在,读取时仍要检查其引用当前可读。表格描述和外部大文件的生命周期可能由不同操作管理;某次处理成功,不能保证以后没有权限、路径或对象变化。消费者可按当前合同验证所需载荷,并将读取失败对应到具体引用,不把缺项悄悄替成另一会话的视频。本文没有执行对象读取,所以这些检查仍是待验证步骤。
对于同步关系,文件名称只能提供线索,不能证明时间对应;两个脱离采集关系的 MP4 不因叫前视/侧视就满足 recipe 输入。两路相机和IMU属于哪个会话、如何确定区间、各自时间数据来自哪里,需要与recipe要求一起核对。若这些关系缺失,先补输入描述或收缩任务,不通过手动改名把两个独立MP4拼成同步样本。这个边界能避免后续模型训练把格式上可读取的行误当成来源上成立的样本。
带动作数据的机器人片段,又是另一种行单位
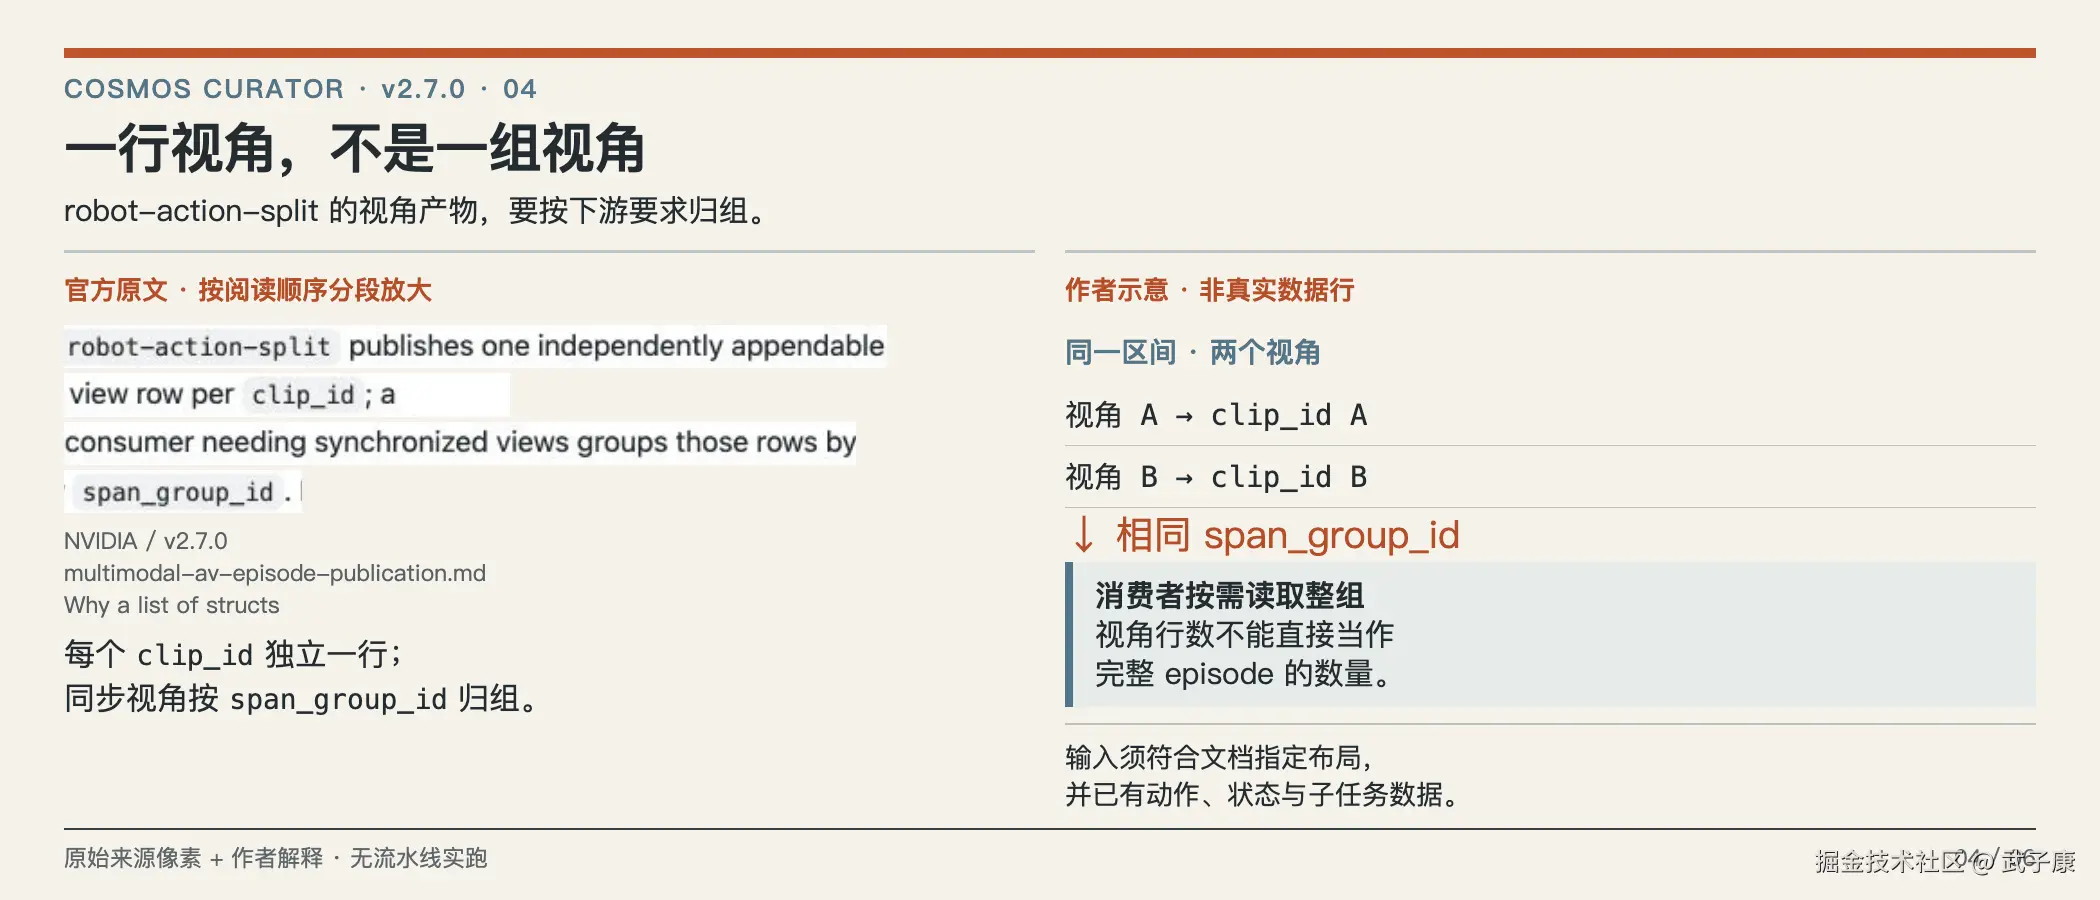
有些输入已经是带状态、动作和子任务元数据的机器人数据集。robot-action-split 针对文档描述的 LeRobot/Mecka 布局,根据 Parquet 中的子任务边界抽取区间,输出视频、动作数据及元数据。它不应被理解为对任意 MP4 自动推断可靠的动作标签。^9^
这个路径的输出行按单个视角片段组织,clip_id 标识视角产物,同一区间的多视角通过 span_group_id 关联。消费者如果需要一组同步视角,就要再按组处理。它与 multimodal-split 的"完整 episode 一行"采用不同组织方式。^7^^9^
从而,三类数据中"导出了 1000 行"代表的工作量和样本数可能完全不同。1000 个规划区间、1000 个相机视角和 1000 个完整 episode,不能直接互换。这个差异比统一叫它们"视频片段"更影响下游读取、失败处理和数量统计。
数量统计也必须跟着样本单位变化
作者建议在交付表上同时写行数、媒体数和下游样本数,并声明三者关系。一个区间可能有多个视角产物,多传感器episode又可能引用多份载荷;文件多不等于训练样本多,行少也不一定意味着处理不足。统计的目的先是让团队知道哪种单位已经交齐,而不是给不同recipe排一个未经同口径验证的产量名次。
失败重试也应回到这一单位。如果机器人数据的某个视角失败,消费者能否接受剩余视角,由其消费合同决定;不能把multimodal-split的整行规则直接移到另一recipe。反之,多传感器任务需要完整区间时,也不能因为某个clip可用就默认整组可用。复用工具或存储,不代表能复用同一完整性判定。
完成小样本后再扩大规模,保留同一版本、输入身份和输出合同。若后来更换孵化recipe的schema或消费接口,建立新的比较记录,而不是沿用旧读取结果填当前完成状态。这样,从原始素材到可消费样本的每个层级都能解释,Curator组件提供的能力也不会被误写成项目已经完成训练或生产交付。
把选择落在一个小样本上
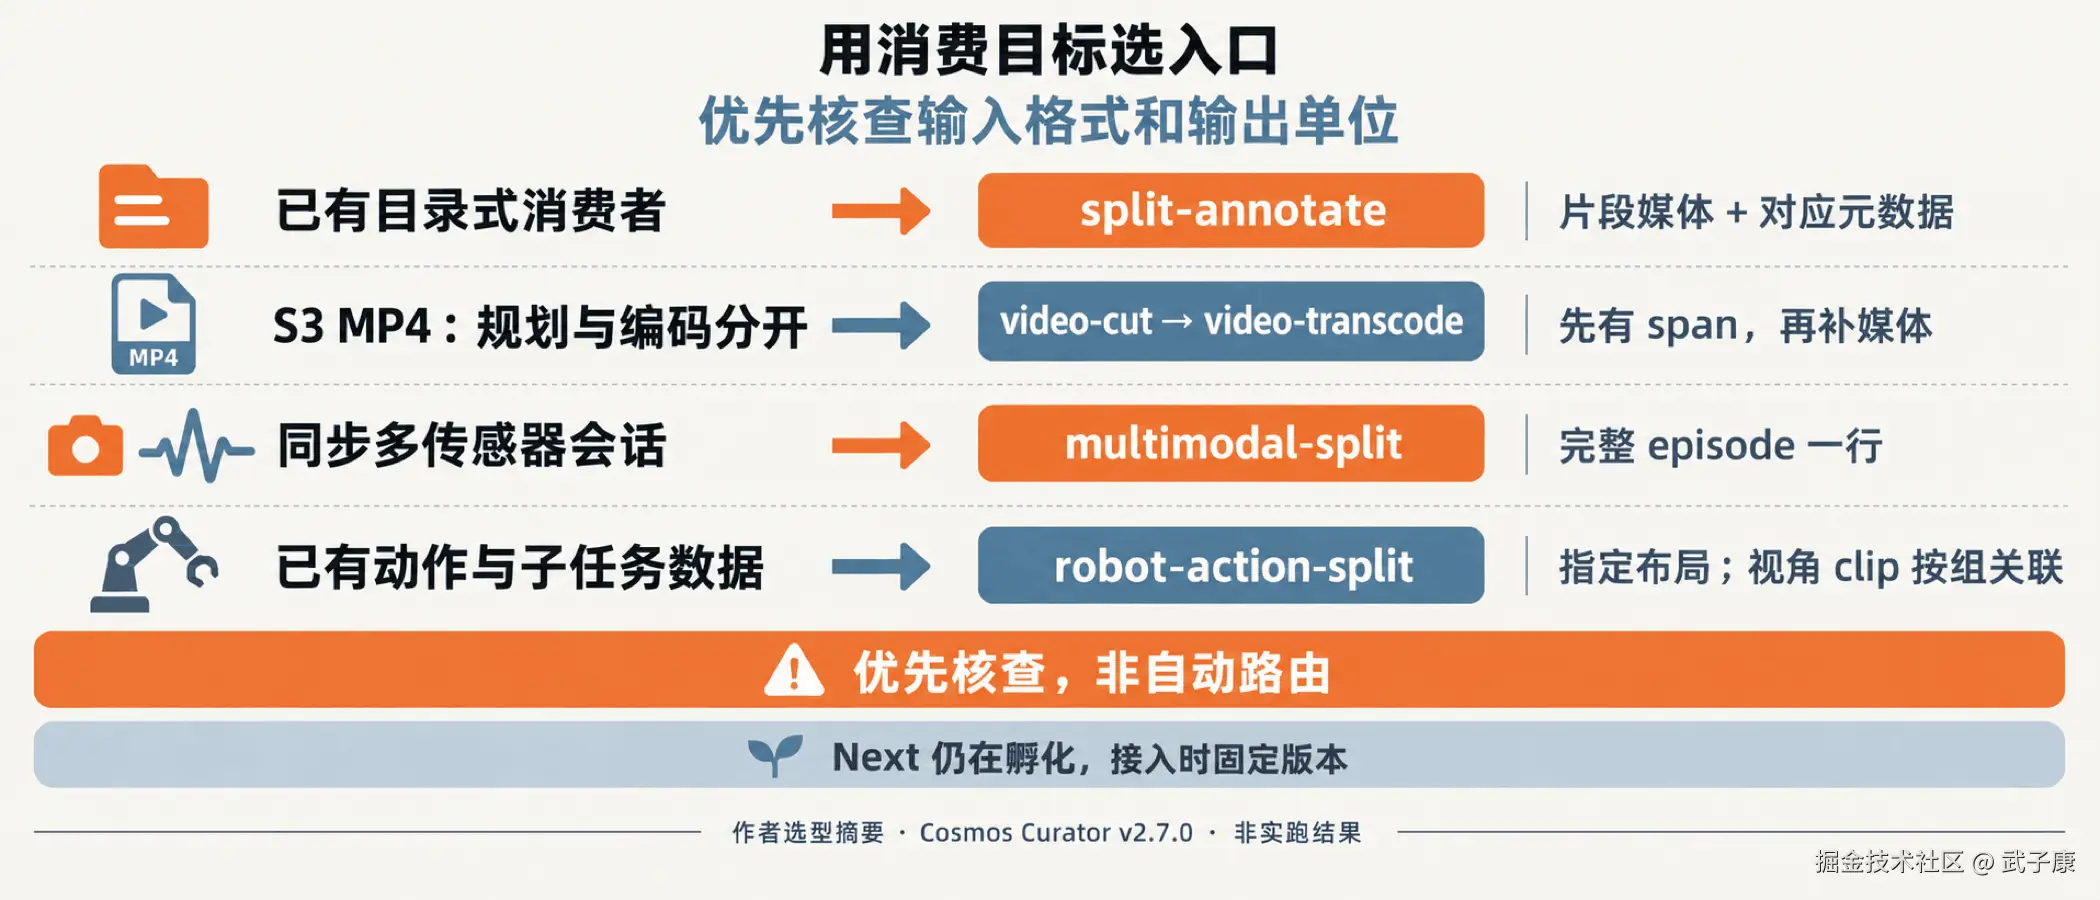
可以用下面这张表记录当前选择。它是根据上述官方行为整理的选型摘要,不是官方自动路由规则。
| 已有输入与消费目标 | 优先核查的入口 | 先确认的交付单位 |
|---|---|---|
| 普通视频,下游已读取现有目录式输出 | split-annotate 及所需后续流水线 |
片段媒体与对应元数据;检查启用阶段 |
| S3 MP4,需要分开管理区间规划和编码 | Next video-cut → video-transcode,再接所需加工 |
先有 span 行,转码再补媒体字段 |
| 带时间关系的多相机和其他传感器会话,消费完整区间 | Next multimodal-split |
一条完整 episode 包含计划载荷集合 |
| 符合指定布局且已有动作/子任务数据的机器人数据集 | Next robot-action-split |
一条视角 clip,多视角用组标识关联 |
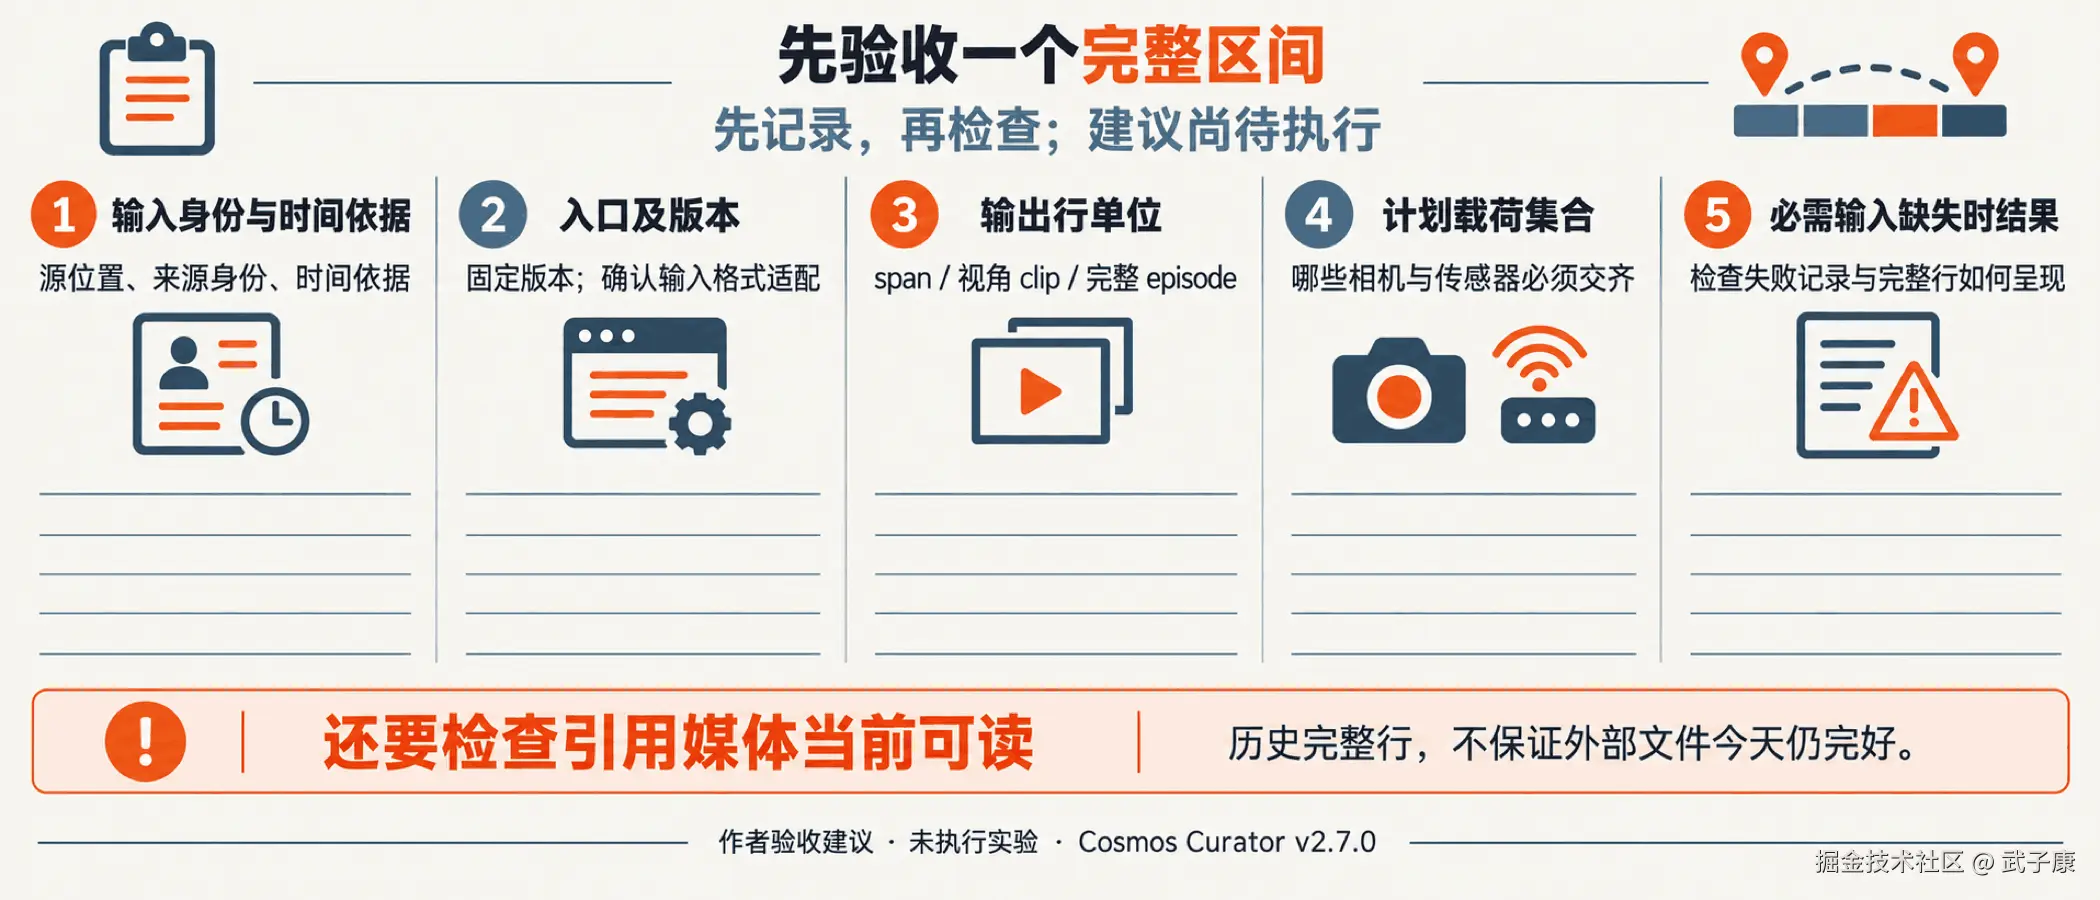
针对巡逻示例,首轮可以只选一个包含两路相机和 IMU 的短区间。先记录这些输入的身份与时间依据,再核查 recipe 是否接受其格式,接着确认输出能表达下游需要的一条样本。对计划必需的一个传感器构造缺失输入,观察运行失败或不完整结果如何呈现。这是官方 recipe 上尚未执行的验收建议,图中的小样本卡仍指这项探针。检索任务只需单视频描述时,先验证媒体与描述绑定;不要只选最好处理的素材,输入与消费目标不匹配时,再多行数也不能证明入口合适。
最小可运行例:检查三种人工交付清单
将下面完整代码保存为 sample_unit_contract.py,运行 python3 sample_unit_contract.py。只用 Python 标准库和内存字典,不读媒体,不启动 Ray,不创建 Arrow/Lance,不调用 Cosmos recipe。demo-* 标识与 fixture:// URI 都是自造字符串,不能交给官方 SDK 当合法产物;本例既不重算 canonical_digest,也不模拟官方发布器的全部分支或终态优先级。
三项检查分别回答:span 有没有绑定符合当前人工约定的 clip 描述;episode 清单是否覆盖计划集合并共享本例身份/时钟/区间字段;机器人两条视角行是否满足消费者约定的 front/side 组键。这里的区间 (0, 10) 没有真实时间单位或传感器测量含义,只是相等比较用的构造元组。相机三个 URI 槽位用于提醒视频与两个时间附属产物,正式 schema 的大小、SHA、版本、类型/nullable 等字段仍要按官方合同校验,本例不是完整验证器。
python
"""Check three finite, author-invented manifests; never execute Cosmos Curator."""
from copy import deepcopy

SPAN = {"span_id": "demo-span", "source_id": "demo-source", "interval": (0, 10)}
CLIP = {"span_id": "demo-span", "encoding": "demo-encode-A",
        "clip_id": "demo-clip-A", "uri": "fixture://clip-A.mp4"}
PLAN = {"episode": "demo-episode", "plan": "demo-plan-v1",
        "clock": "demo-clock", "interval": (0, 10),
        "cameras": ("front", "side"), "sensors": ("imu",)}


def check_span(span, clip):
    if span != SPAN:
        return "REJECT_SPAN_IDENTITY"
    if clip is None:
        return "PLAN_ONLY"
    if clip.get("span_id") != span["span_id"]:
        return "REJECT_SPAN_BINDING"
    if clip.get("encoding") != "demo-encode-A":
        return "REJECT_ENCODING_CONTRACT"
    if not clip.get("clip_id") or not clip.get("uri"):
        return "REJECT_MEDIA_DESCRIPTOR"
    # A URI is only a string. This script performs no object reads.
    return "MEDIA_DESCRIPTOR_PRESENT_READ_UNVERIFIED"


def outcome(kind, key, plan=PLAN):
    assets = ((f"fixture://{key}.mp4", f"fixture://{key}.timeline",
               f"fixture://{key}.sensor-times") if kind == "camera"
              else (f"fixture://{key}.mcap",))
    return {**{field: plan[field] for field in ("episode", "plan", "clock", "interval")},
            "kind": kind, "key": key, "status": "declared_ok", "assets": assets}


def check_episode(plan, rows):
    expected = [("camera", key) for key in plan["cameras"]]
    expected += [("sensor", key) for key in plan["sensors"]]
    received = [(row["kind"], row["key"]) for row in rows]
    if not plan["cameras"] or len(expected) != len(set(expected)):
        return "REJECT_PLAN_KEYS"
    if len(received) != len(set(received)):
        return "REJECT_DUPLICATE"
    if set(received) - set(expected):
        return "REJECT_UNPLANNED"
    if set(expected) - set(received):
        return "REJECT_MISSING"
    for row in rows:
        if any(row[field] != plan[field] for field in ("episode", "plan", "clock", "interval")):
            return "REJECT_SHARED_FACTS"
        if row["status"] != "declared_ok":
            return "REJECT_FAILED_OR_NONTERMINAL"
        required_count = 3 if row["kind"] == "camera" else 1
        if len(row["assets"]) != required_count or not all(row["assets"]):
            return "REJECT_ARTIFACT_DESCRIPTORS"
    return "PLAN_FIELDS_MATCH_OBJECT_READS_UNVERIFIED"


def check_views(rows):
    keys = [(row["span_group_id"], row["view"]) for row in rows]
    clips = [row["clip_id"] for row in rows]
    if len(keys) != len(set(keys)) or len(clips) != len(set(clips)):
        return "REJECT_DUPLICATE_VIEW_OR_CLIP"
    if any(row["span_group_id"] != "demo-group" for row in rows):
        return "REJECT_FOREIGN_GROUP"
    if {row["view"] for row in rows} != {"front", "side"}:
        return "REJECT_REQUIRED_VIEW_SET"
    return "VIEW_KEYS_MATCH_OBJECT_READS_UNVERIFIED"


def main():
    rows = [outcome("camera", "front"), outcome("camera", "side"), outcome("sensor", "imu")]
    views = [{"span_group_id": "demo-group", "view": key, "clip_id": "demo-clip-" + key}
             for key in ("front", "side")]
    assert check_span(SPAN, None) == "PLAN_ONLY"
    assert check_span(SPAN, CLIP) == "MEDIA_DESCRIPTOR_PRESENT_READ_UNVERIFIED"
    assert check_episode(PLAN, rows) == "PLAN_FIELDS_MATCH_OBJECT_READS_UNVERIFIED"
    assert check_views(views) == "VIEW_KEYS_MATCH_OBJECT_READS_UNVERIFIED"
    print("span_without_clip: " + check_span(SPAN, None))
    print("span_with_uri: " + check_span(SPAN, CLIP))
    print("episode_all_declared_ok: " + check_episode(PLAN, rows))
    print(f"robot_rows={len(views)} span_groups={len({row['span_group_id'] for row in views})}")
    print("robot_group: " + check_views(views))
    failed, foreign, no_timing, pending = [deepcopy(rows) for _ in range(4)]
    failed[2]["status"] = "declared_failed"
    foreign[1]["plan"] = "other-plan"
    no_timing[0]["assets"] = no_timing[0]["assets"][:1]
    pending[2]["status"] = "in_progress"
    wrong_clock = deepcopy(rows)
    wrong_clock[1]["clock"] = "other-clock"
    cases = [
        ("span_binding", check_span(SPAN, {**CLIP, "span_id": "other-span"}), "REJECT_SPAN_BINDING"),
        ("encoding", check_span(SPAN, {**CLIP, "encoding": "encode-B"}), "REJECT_ENCODING_CONTRACT"),
        ("missing_imu", check_episode(PLAN, rows[:2]), "REJECT_MISSING"),
        ("failed_imu", check_episode(PLAN, failed), "REJECT_FAILED_OR_NONTERMINAL"),
        ("pending_imu", check_episode(PLAN, pending), "REJECT_FAILED_OR_NONTERMINAL"),
        ("duplicate_sensor", check_episode(PLAN, rows + [rows[2]]), "REJECT_DUPLICATE"),
        ("unexpected_sensor", check_episode(PLAN, rows + [outcome("sensor", "gps")]), "REJECT_UNPLANNED"),
        ("foreign_plan", check_episode(PLAN, foreign), "REJECT_SHARED_FACTS"),
        ("clock", check_episode(PLAN, wrong_clock), "REJECT_SHARED_FACTS"),
        ("camera_sidecars", check_episode(PLAN, no_timing), "REJECT_ARTIFACT_DESCRIPTORS"),
        ("one_view", check_views(views[:1]), "REJECT_REQUIRED_VIEW_SET"),
        ("duplicate_view", check_views(views + [views[0]]), "REJECT_DUPLICATE_VIEW_OR_CLIP"),
        ("foreign_group", check_views([views[0], {**views[1], "span_group_id": "other-group"}]), "REJECT_FOREIGN_GROUP"),
    ]
    for name, actual, expected in cases:
        assert actual == expected, (name, actual)
        print("reject_" + name + ": " + actual)
    smaller_plan = {**PLAN, "plan": "demo-plan-no-imu", "sensors": ()}
    smaller_rows = [outcome("camera", key, smaller_plan) for key in smaller_plan["cameras"]]
    assert check_episode(smaller_plan, smaller_rows) == "PLAN_FIELDS_MATCH_OBJECT_READS_UNVERIFIED"
    print("optional_absent_in_new_plan: " + check_episode(smaller_plan, smaller_rows))
    print("object_reads=0 media_decodes=0 sensor_sync=NOT_MEASURED curator_runs=0")
    print(f"self_checks={len(cases)} counterexamples_passed")


if __name__ == "__main__":
    main()
本机 Python 3.11.6 实际运行,退出码 0。下面 stdout 来自这一程序;所有输入状态均属人工声明:
text
span_without_clip: PLAN_ONLY
span_with_uri: MEDIA_DESCRIPTOR_PRESENT_READ_UNVERIFIED
episode_all_declared_ok: PLAN_FIELDS_MATCH_OBJECT_READS_UNVERIFIED
robot_rows=2 span_groups=1
robot_group: VIEW_KEYS_MATCH_OBJECT_READS_UNVERIFIED
reject_span_binding: REJECT_SPAN_BINDING
reject_encoding: REJECT_ENCODING_CONTRACT
reject_missing_imu: REJECT_MISSING
reject_failed_imu: REJECT_FAILED_OR_NONTERMINAL
reject_pending_imu: REJECT_FAILED_OR_NONTERMINAL
reject_duplicate_sensor: REJECT_DUPLICATE
reject_unexpected_sensor: REJECT_UNPLANNED
reject_foreign_plan: REJECT_SHARED_FACTS
reject_clock: REJECT_SHARED_FACTS
reject_camera_sidecars: REJECT_ARTIFACT_DESCRIPTORS
reject_one_view: REJECT_REQUIRED_VIEW_SET
reject_duplicate_view: REJECT_DUPLICATE_VIEW_OR_CLIP
reject_foreign_group: REJECT_FOREIGN_GROUP
optional_absent_in_new_plan: PLAN_FIELDS_MATCH_OBJECT_READS_UNVERIFIED
object_reads=0 media_decodes=0 sensor_sync=NOT_MEASURED curator_runs=0
self_checks=13 counterexamples_passed
没有 clip 时只得到 PLAN_ONLY;填上 URI 后得到的是描述存在、读取未验证。即使两相机和 IMU 都声明成功,也只得到人工字段匹配、对象读取未验证。脚本没有将 URI 字符串当可读证据,没有把 declared_ok 等同于官方 success receipt 或真实传感器同步。机器人部分显示两行、一个组,也仅核组键,不能把这一个组宣称为完整 episode 或已可训练样本。
十三个反例拒绝错 span、编码约定变化、计划 IMU 缺失/失败/非终态、重复/额外传感器、跨计划混入、时钟字段不同、相机时间槽位缺失,以及缺视角/重复视角/跨组拼接。字段中的 clock 相等不证明物理时钟同步;它只帮助发现明显自相矛盾的登记。optional_absent 则另建不含 IMU 的人工计划,说明"没计划"和"计划内失败"需要不同记录,不允许从原计划里临时删必需项以补成功。
实际消费时还要读取所选对象,核字节大小/SHA并验证格式可读;读不了就留下失败引用,尚未尝试就保持未验证。完整表行只是发布时的证据边界,不能自动修复之后损坏的外部载荷;v2.7.0 文档也说明 canonical 重用不会重读并重哈希全部媒体。若需要修复,应另做显式验证和修复流程,不能指望普通重试凭原 row presence 就补齐。^7^
如果最终消费者只需要一条前视视频描述,那么为它强行组织多传感器 episode 会增加准备和检查工作;如果消费者必须同时读取多个传感器,把它们先当独立视频加工,则需要承担后续重新归组和证明完整性的工作。选择取决于实际消费要求。
Curator 的用途因此可以说得更具体:它提供把视频、传感器和标注加工成数据集的组件与参考流程;团队仍要决定输入是否合格、采用哪种样本单位,以及哪些结果值得保留。把这几项放在扩大运行规模之前验证,才知道这一轮流水线产出的是下游真正能接住的数据。
Footnotes
-
v2.7.0 Reference Video Pipelines,参考流水线职责与输出格式。 ↩ ↩2
-
v2.7.0 Curator Next,编程模型、孵化边界与既有流水线过渡。 ↩ ↩2
-
v2.7.0 Video Cut,输入范围、区间身份及规划与媒体分离。 ↩ ↩2
-
v2.7.0 Video Transcode,现有行上的媒体信息补充与兼容性检查。 ↩ ↩2 ↩3
-
v2.7.0 video_cut/contracts.py,
span_id字段。 ↩ -
v2.7.0 video_transcode/contracts.py,
clip_id字段和生成函数。 ↩ ↩2 -
v2.7.0 Canonical Multimodal AV Episode Publication,完整 episode、一行单位与载荷验证边界。 ↩ ↩2 ↩3 ↩4 ↩5 ↩6
-
v2.7.0 multimodal_split/publication.py,
assemble_episode_group中的完整性和终态检查。 ↩ ↩2 -
v2.7.0 Robot Action Split,输入布局、子任务边界和视角分组。 ↩ ↩2