2026-10-06·终止与自愈·连续错误检测
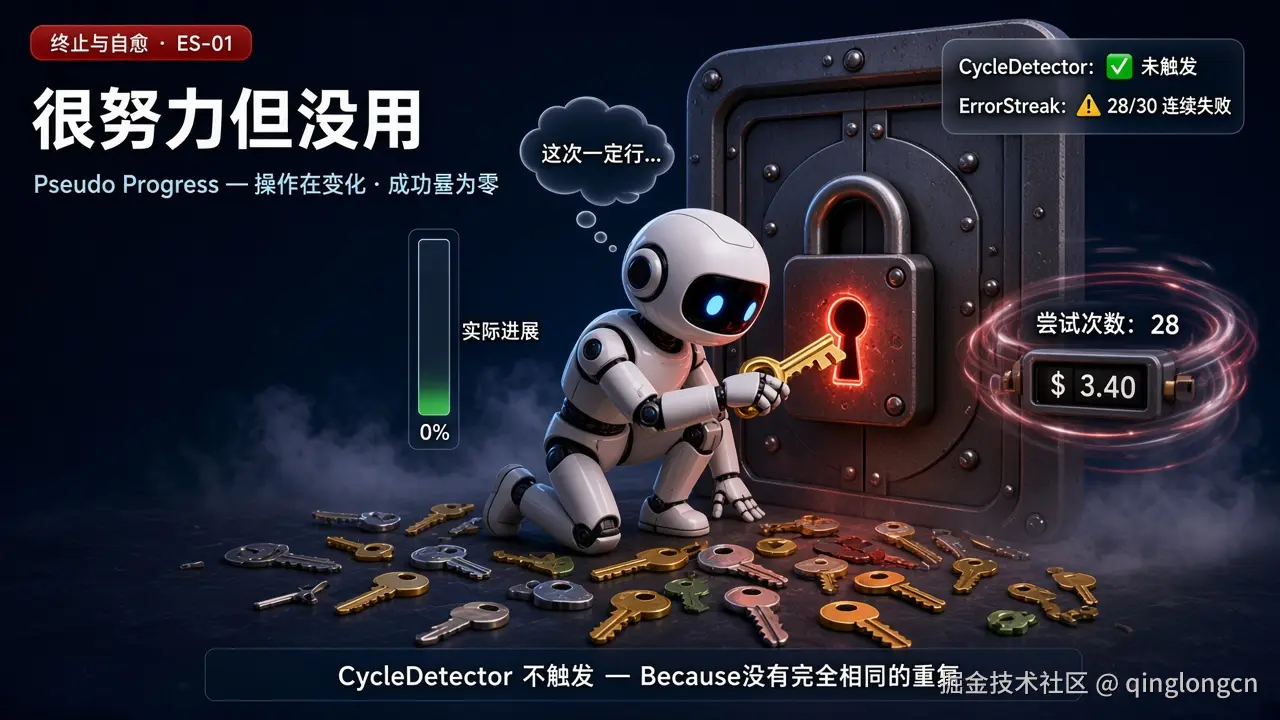
Agent 每轮都在调用不同的工具、尝试不同的参数------看起来在'积极工作'。但结果始终是错误。CycleDetector 不触发------因为没有完全相同的重复。这种'换着花样犯同一类错'的模式叫伪进展------操作在变化,但无一成功。
一个看起来正常的 Run
看这段 Agent 执行日志------每一行都是一次工具调用:
bash
轮次 31: exec("python -m pytest tests/models/")         → FAILED (3 errors)
轮次 32: edit("models/query.py", patch_v1)                → OK
轮次 33: exec("python -m pytest tests/models/")         → FAILED (2 errors)
轮次 34: edit("models/query.py", patch_v2)                → OK
轮次 35: exec("python -m pytest tests/models/")         → FAILED (3 errors, different)
轮次 36: edit("models/query.py", patch_v3)                → OK
轮次 37: exec("python -m pytest tests/models/")         → FAILED (2 errors, same as #33)
轮次 38: edit("models/query.py", patch_v4)                → OK
轮次 39: exec("python -m pytest tests/models/")         → FAILED (3 errors, same as #35)
...持续 20+ 轮
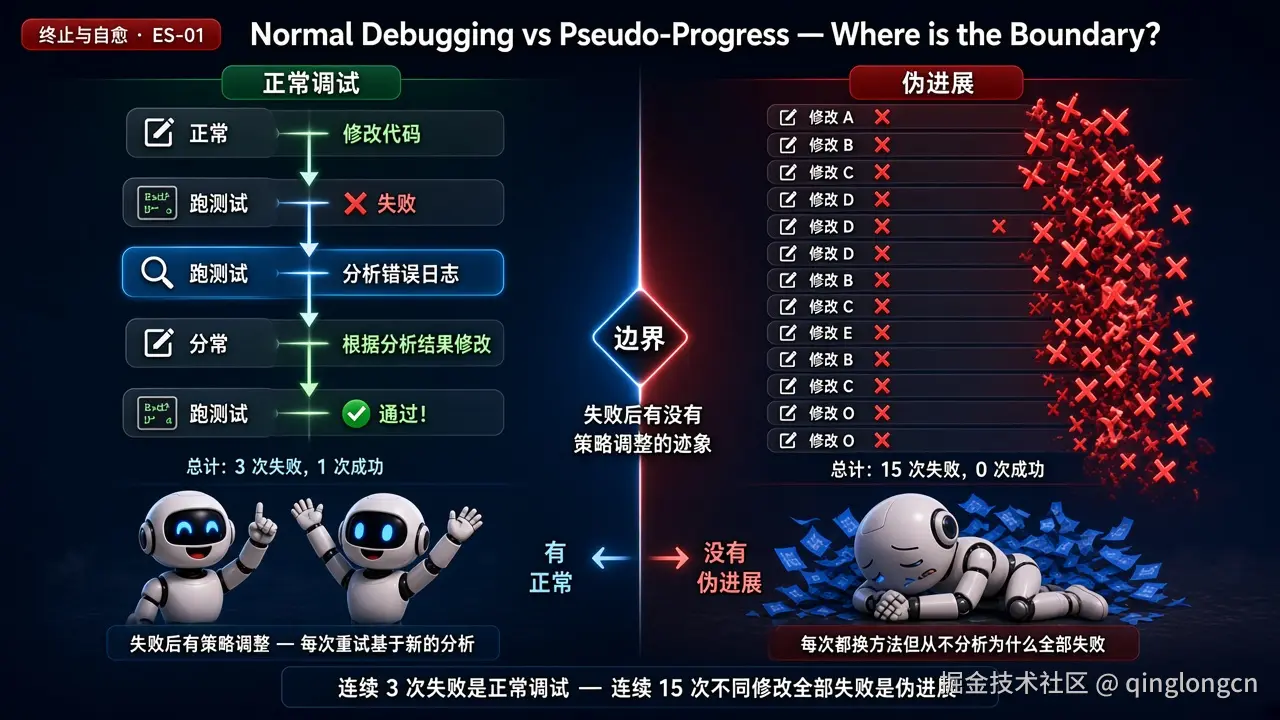
从任何单一轮次看------Agent 在正常工作:读文件、改代码、跑测试。每次的 patch 不同、每次的错误信息不同。CycleDetector 的 Identical Call 检测不触发(参数在变),Category Streak 检测也不触发(exploration 和 action 在交替)。
但从全局看------Agent 在"打地鼠"。 修了错误 A 引入了错误 B;修了 B 又引回了 A。测试错误数在 2 和 3 之间反复震荡,从未降到 0。20 轮的工具调用消耗了大量 token------但距离"测试通过"的目标没有任何接近。
这就是伪进展(Pseudo-Progress):操作在变化,但没有一次成功地推进了目标。
伪进展 vs 死循环------为什么 CycleDetector 抓不住
死循环和伪进展是两种不同形态的"Agent 在空转":
| 维度 | 死循环 | 伪进展 |
|---|---|---|
| 操作是否相同 | 完全相同(参数+结果相同) | 不同(参数在变) |
| 表面看起来 | "在重复同一件事" | "在尝试不同方法" |
| CycleDetector 检测 | ✅ Identical Call 触发 | ❌ 参数不同,不触发 |
| 人类的直觉判断 | 容易识别("它怎么又搜同一个东西") | 难识别("它在努力呢,再等等") |
| 对用户的误导性 | 低(明显在重复) | 高(看起来在做事) |
伪进展比死循环更危险------因为它更难被发现。 死循环的症状是"Agent 在重复"------用户一眼就能看出来。伪进展的症状是"Agent 在工作但进展慢"------用户可能等很久才意识到"它根本没有在接近目标"。
$47,000 事故中的 Analyzer-Verifier 循环就是一种伪进展------Analyzer 每次产出不同的分析报告(不重复),Verifier 每次给出不同的改进建议(不重复),但没有一次批准通过。从 CycleDetector 角度看------完全合法的工作过程。从 ErrorStreak 角度看------Verifier 对 Analyzer 输出的"拒绝"连续了 264 小时。
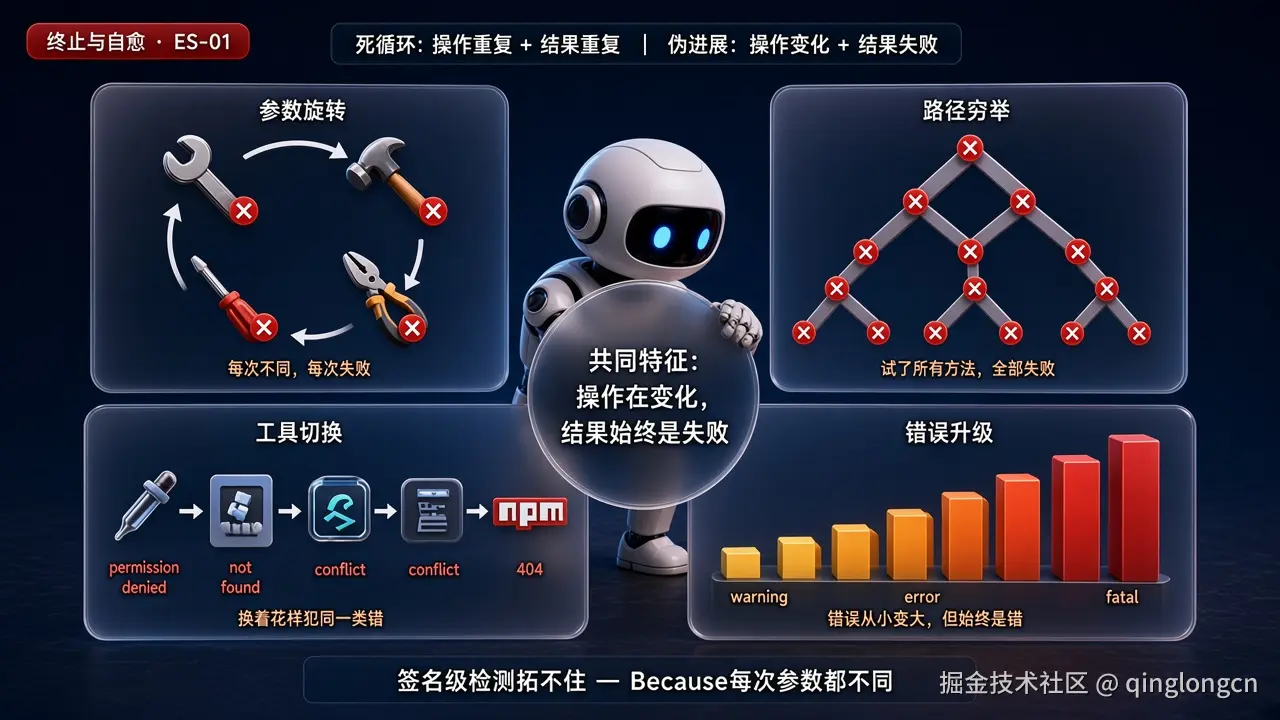
伪进展的常见模式
模式一:编译-修改震荡
Agent 改代码 → 编译失败 → 修一个错误 → 编译失败(不同的错误)→ 修这个错误 → 编译失败(之前的错误回来了)。
特征:测试/编译错误数在 N 和 N+1 之间震荡,从未单调递减到 0。
根因:Agent 在一个错误的假设下工作------比如它以为问题在 A 文件,但问题实际在 B 文件。它在 A 上的每次修改都引入新错误,因为 A 本身不该被改。
来自设计文档的真实案例------SWE-bench django-11734:Agent 在做评测任务时连续 20+ 轮在错误的环境假设下盲目重试。每次的修改不同但编译/测试一直失败。ErrorStreak 在 L2 阶段(6 次连续错误后)触发了 strategy reset------强制 Agent 退出当前修改策略、创建一个反思性的 Plan 重新分析问题。Agent 发现了之前的错误假设,换了正确的方向,最终在第 196 轮完成任务(10.2M tokens)。
如果没有 ErrorStreak :Agent 会继续在错误假设下重试------可能永远不会自行意识到假设错误。最终被 max_turns 或 token 预算强制停止,196 轮的有效工作全部浪费。
模式二:路径/名称猜测
Agent 尝试安装一个包、访问一个 API、读取一个文件------但用了错误的名字。它换不同的名字继续尝试:
bash
轮次 1: exec("npm install phantom-rendering")     → error: 404
轮次 2: exec("npm install phantom-render")         → error: 404
轮次 3: exec("npm install phantomjs-renderer")     → error: 404
轮次 4: exec("npm install phantomjs-prebuilt")     → error: deprecated
轮次 5: exec("pip install phantomjs")              → error: not found
轮次 6: exec("yarn add phantom-render-node")       → error: 404
每次的参数不同------CycleDetector 不触发。但 6 次连续 404/not found 说明模型在一条死路上:它猜测的包名全都不存在。
根因:模型幻觉了一个不存在的包名,然后在"也许拼写不对"的逻辑下反复变换拼写。正确的做法是用搜索引擎确认包名是否存在------而不是继续猜。
模式三:API 调用连续失败
bash
轮次 1: exec("curl -X POST https://api.example.com/v1/users ...")  → 401 Unauthorized
轮次 2: exec("curl -H 'Authorization: Bearer xxx' ...")             → 403 Forbidden
轮次 3: exec("curl -H 'X-API-Key: xxx' ...")                        → 403 Forbidden
轮次 4: exec("curl --user admin:password ...")                       → 401 Unauthorized
轮次 5: exec("curl -H 'Authorization: Basic xxx' ...")               → 403 Forbidden
模型在尝试不同的认证方式------但所有尝试都失败。它没有正确的凭据,再怎么换认证头格式也不会成功。
这是伪进展最具欺骗性的形态 ------每次尝试看起来都"合理"(尝试不同的认证方式是面对 401/403 的正常反应),但正确的做法是停下来问用户要凭据,而不是继续猜。
模式四:空响应连续出现
一种特殊的伪进展------模型返回了空响应:没有 tool_call、没有 text response。字面上"什么都没说"。
这不是"任务完成"------是 provider 暂态故障或模型困惑。引擎对空响应先重试(最多 3 次)。仍空则计入 ErrorStreak------因为连续空响应意味着模型陷入了一种"无法产出任何有用输出"的状态。
ErrorStreak 的检测算法
算法核心很简单------一个滑动窗口计数器:
bash
每次工具调用完成后:

if 结果是错误:
    if 和上一次失败的调用"相似"(同一类错误):
        consecutive_errors++     // 相似的错误累积
    else:
        consecutive_errors = 1   // 换了一种错误,重新开始计数
        lastFailedCall = 当前调用
else:
    consecutive_errors = 0       // 成功重置一切
    return

if consecutive_errors == WarnThreshold (默认 5):
    → 注入 system 警告:"你正在重复失败的操作。
       最近 5 次工具调用全部返回错误。
       请退一步重新分析问题,而不是继续用相似的参数重试。"

if consecutive_errors == TermThreshold (默认 8):
    → 进入两阶段协议(与 CycleDetector 共享)
    → 首次:strategy reset(强制 Plan 反思)
    → 二次:HITL 问用户 → 超时 60s → 终止
配置参数
| 参数 | 默认值 | 含义 |
|---|---|---|
ErrorStreakWarnThreshold |
5 | 连续 5 次错误 → 注入警告 |
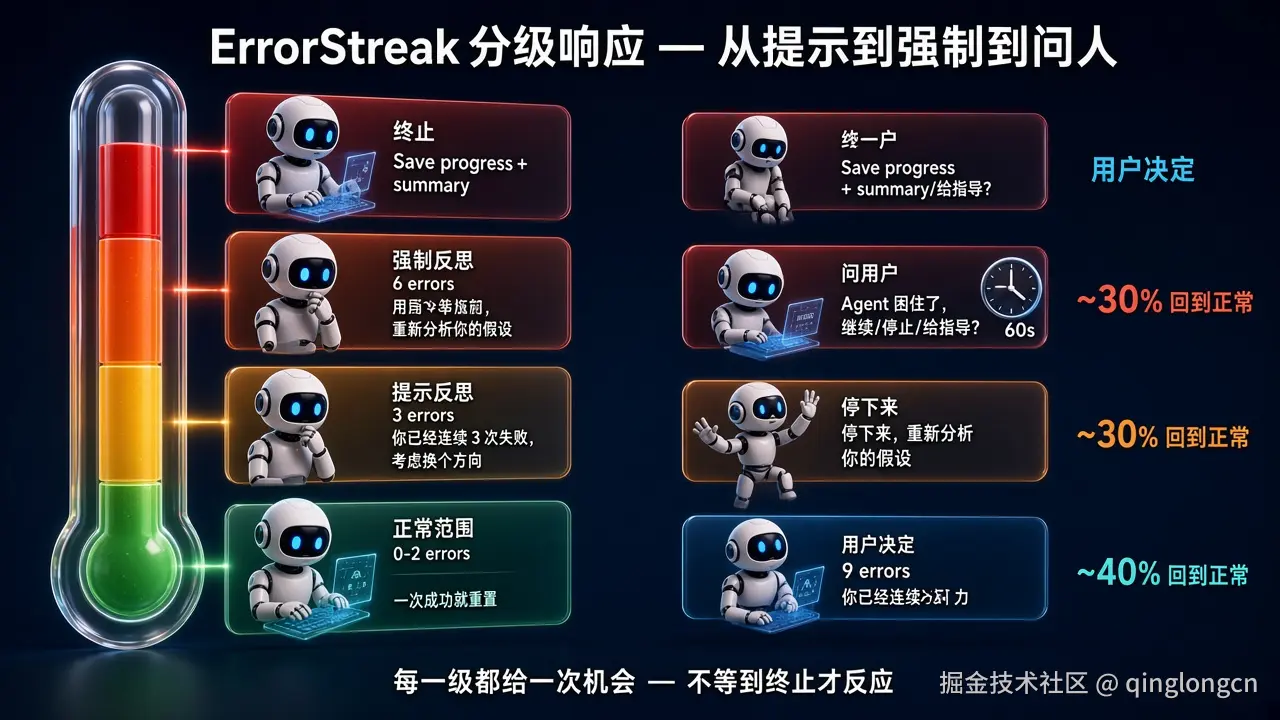
| ErrorStreakTermThreshold | 8 | 连续 8 次错误 → 进入两阶段协议 | | ErrorStreakWindowSize | 10 | 滑动窗口大小 |
重置条件
最重要的设计选择:一次成功就重置一切。
只要有一次工具调用成功(isError=false),连续错误计数归零。
这意味着------如果 Agent 在 8 次连续错误中的第 5 次夹了一次成功的 read 调用:
bash
exec("go build")      → error    streak=1
exec("go build")      → error    streak=2
exec("go build")      → error    streak=3
exec("go build")      → error    streak=4
read("error_log.txt") → success  streak=0  ← 重置!
exec("go build")      → error    streak=1  ← 从 1 重新开始
为什么一次成功就重置? 因为成功的工具调用意味着 Agent做了一件有用的事------即使它接下来又开始失败了,那也是一段新的失败序列,不是上一段的延续。Agent 从失败中收集了信息(读了错误日志),这改变了它的认知状态------后续的失败可能有不同的原因。
这和 CycleDetector 的 halving 设计理念一致------区分"盲目重复"和"在尝试中学习"。
"相似"的定义
ErrorStreak 在判断"和上一次失败是否相似"时用的是宽松标准------同一类工具 + 错误类型相近(都是 404、都是编译错误、都是权限拒绝)。不要求参数完全相同。
为什么宽松? 因为伪进展的特征就是"换着花样犯同一类错"------参数不同但错误相似。如果要求"完全相同"------那就变成了 CycleDetector 的 Identical Call 检测,两者重叠。
如果 Agent 真的换了一种完全不同 的策略(从 npm install 换到 pip install,错误类型从 404 变成了 "pip: command not found"),计数器重置为 1------新的策略值得给新的机会。
自愈策略:strategy reset
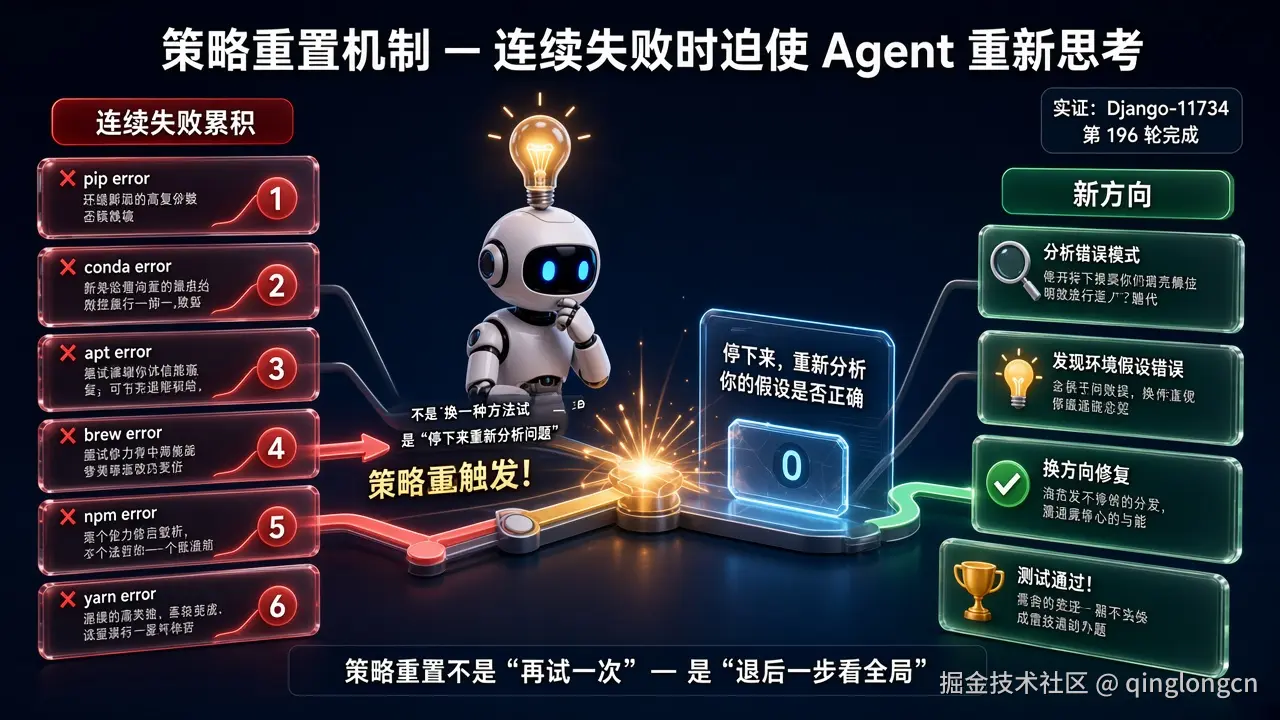
ErrorStreak 的自愈和 CycleDetector 的自愈不同。CycleDetector 注入"你在重复操作"的纠正消息------因为问题是"重复"。ErrorStreak 注入的是更强力的干预------强制 Plan 反思。
为什么 ErrorStreak 需要更强的自愈
CycleDetector 捕获的循环通常是"模型陷入了一个局部最优"------一条纠正消息就能把它推出来。
ErrorStreak 捕获的伪进展通常是"模型在一个根本错误的假设 下工作"------简单的"请换一种方法"不够,因为模型不知道自己的假设是错的。它需要退后一步重新分析问题。
strategy reset 的具体行为:
- 注入一条 system 消息:"你最近的 N 次工具调用全部失败。这可能意味着你当前的策略方向有根本性问题。请暂停当前操作,重新分析问题的根因------你的假设是否正确?是否需要换一种完全不同的方法?"
- 如果当前有活跃 Plan------在 Plan 中标记"strategy reset triggered",给模型一个"回到 Plan 视角审视全局"的信号
- 重置连续错误计数
SWE-bench django-11734 的 strategy reset 效果:Agent 在收到 strategy reset 后:
- 停止了在错误文件上的修改
- 重新读取了任务描述和错误信息
- 发现了之前的环境假设错误
- 换了正确的方向继续工作
- 最终在 196 轮完成任务
如果没有 strategy reset ------Agent 会继续在错误假设下修改代码。max_turns 最终停止它,但 196 轮中前 20+ 轮的浪费已经不可挽回。
行业中的连续错误处理
Claude Code auto mode:不检测连续错误
Claude Code 的 auto mode 分类器审查的是操作的安全性和方向性------"这个操作是否偏离用户请求""是否针对未识别的基础设施"。
但分类器不检测连续失败。 如果 Agent 反复用不同参数调用一个合法的工具(npm install 是安全的、符合方向的)------分类器会让每一次通过,即使连续 20 次都返回 404。
这是分类器方法和模式检测方法的根本差异------分类器看单次操作的"内容",ErrorStreak 看操作序列的"结果模式"。
Cursor Auto-review:同上
Cursor 的分类器也不检测连续失败------它检测的是单次操作的风险等级。连续失败的操作如果每次都是低风险的(exec("npm install xxx")),会被自动通过。
大多数框架:无此机制
翻看截至本文写作时的 LangGraph、CrewAI、OpenAI Agents SDK、Hermes Agent 等主流框架------均没有内置的连续错误检测 。唯一的兜底是 max_turns / max_iterations。
这意味着------一个 Agent 可以连续失败 100 次(但参数每次不同)而不被任何机制拦截。直到 max_turns 生效。
"When Errors Become Narratives"(arXiv:2606.14589)
2026 年 6 月发表的一篇生产 Agent 运行时静默失败分类学论文指出了一个更深层的问题------模型把错误转化为叙事:
"The system does not merely fail to report an error --- the LLM transforms it into fluent, plausible narrative delivered to the user."
当 Agent 的工具调用连续失败时,模型不会说"我失败了 8 次"------它会说"我正在系统性地排查问题,已经排除了 A、B、C 三种可能性"。从用户视角看------Agent 在做有用的排除法。从实际效果看------Agent 在同一面墙前反复撞头,只是每次撞的位置不同。
伪进展最危险的地方:模型会用合理的叙事包装自己的失败。 用户被叙事说服了------"它说在排查呢,再等等"。ErrorStreak 不看叙事------只看结果。连续 8 次错误就是连续 8 次错误,不管中间的解释多么合理。
你现在能做什么
1. 加一个"连续错误计数器"------即使只是最简单的版本。 每次工具调用返回错误 → counter++,成功 → counter=0。counter >= 5 → 注入一条"你的最近 5 次操作全部失败,请重新分析问题"的 system 消息。10 行代码,效果立竿见影。
2. 区分"单次错误"和"连续错误"。 单次编译失败是正常的------改一下再试。连续 5 次编译失败意味着模型的修复策略可能方向错了。不要对单次错误过度反应,但连续错误必须触发干预。
3. strategy reset 比简单纠正更有效。 ErrorStreak 的纠正不是"换一种方法试试"------是"停下来,重新分析你的假设是否正确"。后者迫使模型退后一步看全局,而不是在错误的路上继续跑。
4. 不要被模型的叙事误导。 模型说"正在系统性排查"不等于真的在进展。看结果------如果工具调用连续返回错误,不管模型怎么解释,它就是在失败。
5. 一次成功就重置计数器。 不要累积------成功意味着 Agent 做了一件有用的事。后续的失败是一段新的序列,不是上一段的延续。
引用来源
本文所有数据均可通过以下链接验证。
- Hermes StallDetector(签名重复检测,抓不住参数不同但全失败的伪进展) --- feat(agent): add stall detector to stop repeated tool calls (fix #41313) by liuhao1024 · Pull Request #41477 · NousResearch/hermes-agent · GitHub
- Hermes ToolLoopDetector poll_no_progress 策略(结果哈希重复检测) --- feat(agent): tool loop detection with context pruning by jbarket · Pull Request #6784 · NousResearch/hermes-agent · GitHub
- OpenAI Agents SDK 无内置连续错误检测,社区请求 BudgetGuard --- Proposal: per-run BudgetGuard for token / request / cost limits (follow-up to #2848) · Issue #3353 · openai/openai-agents-python · GitHub
- Codex Goal
blocked状态(模型主动声明"我卡住了") --- goal: pause continuation loops on usage limits and blockers by etraut-openai · Pull Request #23094 · openai/codex · GitHub - Agent 循环终止评分(detection / containment / response 三阶段) --- Stop an agent before a repeated tool call becomes a loop | QABattle
- vectara/awesome-agent-failures --- Analyzer-Verifier 伪进展模式($47K 案例)
- Cursor Plan Mode 伪进展(2-3 小时 echo/搜索无实际进展) --- Persistent "Extension Host Timeout" & Agent Execution Hang - Bug Reports - Cursor - Community Forum
- Aider max_reflections=3 (三次反射共享预算,结构性避免伪进展)--- How Aider works under the hood - DEV Community