上一篇写了 AI 代码审查的精确率:1919 行 Java,报 18 条,8 条真、8 条假、2 条待定,精确率 50%。
那篇只回答了"报得准不准"。这篇回答另一个问题:它会不会漏。
方法不是"找几个人评一评感受",是往代码里注入已知缺陷,让它盲审,数命中率。下面把设计、结果、漏检原因和成本全部摊开,方法可以照抄。
结论
- 注入 23 个变异体,3 个被现有单元测试抓住并淘汰,20 个进入盲测
- 盲测命中 13 个,召回率 65%
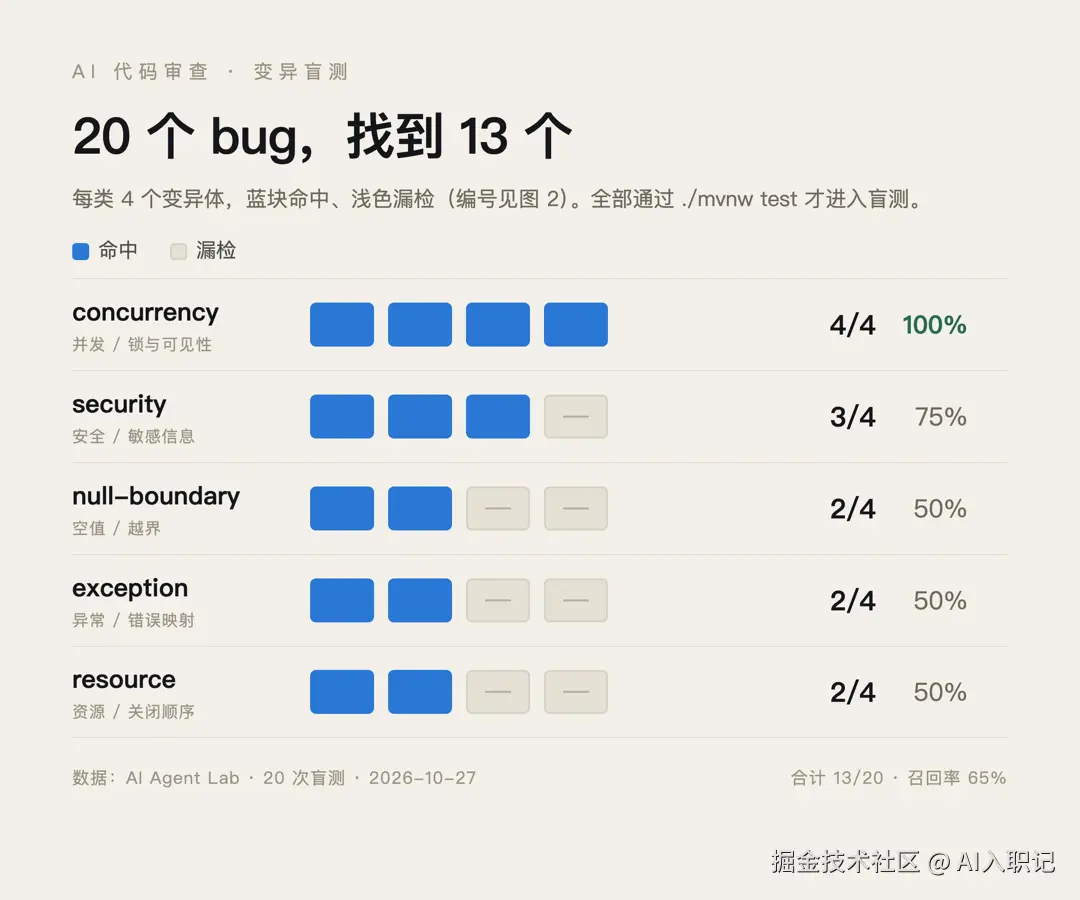
- 并发类 4/4 全中;安全 3/4,空值、异常、资源各 2/4
- 漏掉的 7 个里,5 个是"删掉或换掉一个防御步骤"
- 20 次盲测约 165 万 token,单次 5 万--15.4 万
为什么不测真实缺陷
最理想的语料是线上事故和人工评审记录。拿不到:项目是个人工程,25 个 commit 全是自己提交,没有一条评审意见,也就没有 ground truth。
退而求其次,用变异测试(mutation testing)的思路:自己注入缺陷,自己当裁判。 代价是变异体的分布和真实缺陷不同,结论只能说明"对哪类问题敏感",不等于真实漏检率。这一点后面还会再提一次。
实验对象
AI Agent Lab,一个 Spring AI 练习工程。Java 17、Spring Boot 4.1.1、Spring AI 2.0.1、DeepSeek、Spring MVC + SSE、Caffeine、ONNX Runtime。src/main/java 34 个文件、1919 行,34 个单元测试全绿。
基线快照打 tag review-baseline(commit c5477f4)。
实验设计
1. 变异体:5 类 × 4 个
五类缺陷,每类 4 个,每条只改一处,且必须能在本项目里自然落地:
| 类别 | 例子 | 候选落点 |
|---|---|---|
null-boundary |
空集合取首元素、越界读、拆箱 NPE | RagService 的 topK、LexicalReranker 的空候选 |
concurrency |
非线程安全集合、检查后执行、共享可变状态 | BoundedChatMemoryRepository、ModelFileCache |
exception |
吞异常、错误码映射错、catch 过宽 | ApiExceptionHandler、ChatService |
resource |
流未关闭、SSE 未释放、关闭顺序错 | ChatController、RagService |
security |
日志打印 PII / 签名 URL、输入未校验 | ChatController、ModelFileCache |
硬约束:变异体只放 src/main/java,不改测试;一条一个分支 exp/mutants/M-XX,从 review-baseline 拉出,不合并回 main。
2. 用测试筛掉"太容易"的
每个变异体应用后跑 ./mvnw test。测试变红即作废,在同类补一个更隐蔽的。
结果:23 个里 3 个被抓住,全部在安全类。
| mutant | 改法 | 为什么被抓住 |
|---|---|---|
| M-18 | error 事件发送 error.getMessage() 而不是通用文案 |
有断言校验对外错误文案 |
| M-20 | 去掉 ConversationIds 的 hasText 判断 |
有空会话 ID 用例 |
| M-20R | 路径拼接越界 | 有路径穿越用例 |
补了两条替补:M-18R(日志输出全量订单表)、M-20B(流式入口打印用户消息)。
现有测试唯一能主动抓住的,是有现成断言的那几条。 进入盲测的 20 个,正是测试覆盖不到的地方,AI 在这里补位才有意义。
3. 盲测协议
- 用固定种子(20261027)把 20 个变异体打乱成 B-01...B-20,映射表单独存,审查时不可见。
- 审查输入只包含被变异的文件,加上它直接依赖的接口签名;不给分支名、commit message、改法说明。
- 审查 prompt 冻结在 v1,与上一篇基线审查完全一致,不加"这里有没有 bug"之类的暗示。
- 模型固定(claude-sonnet),中途不换。
- 先全部注入、打乱,再统一审查------不做一条审一条,避免后一次受前一次影响。
- 判定完成后再对照映射表,记录
caught_by_ai。
一个必须说明的缺口:CLI 不暴露温度参数,原计划对同一模块跑 3 次量化方差,这次没做。所以下面没有重复运行的一致性数据。
结果
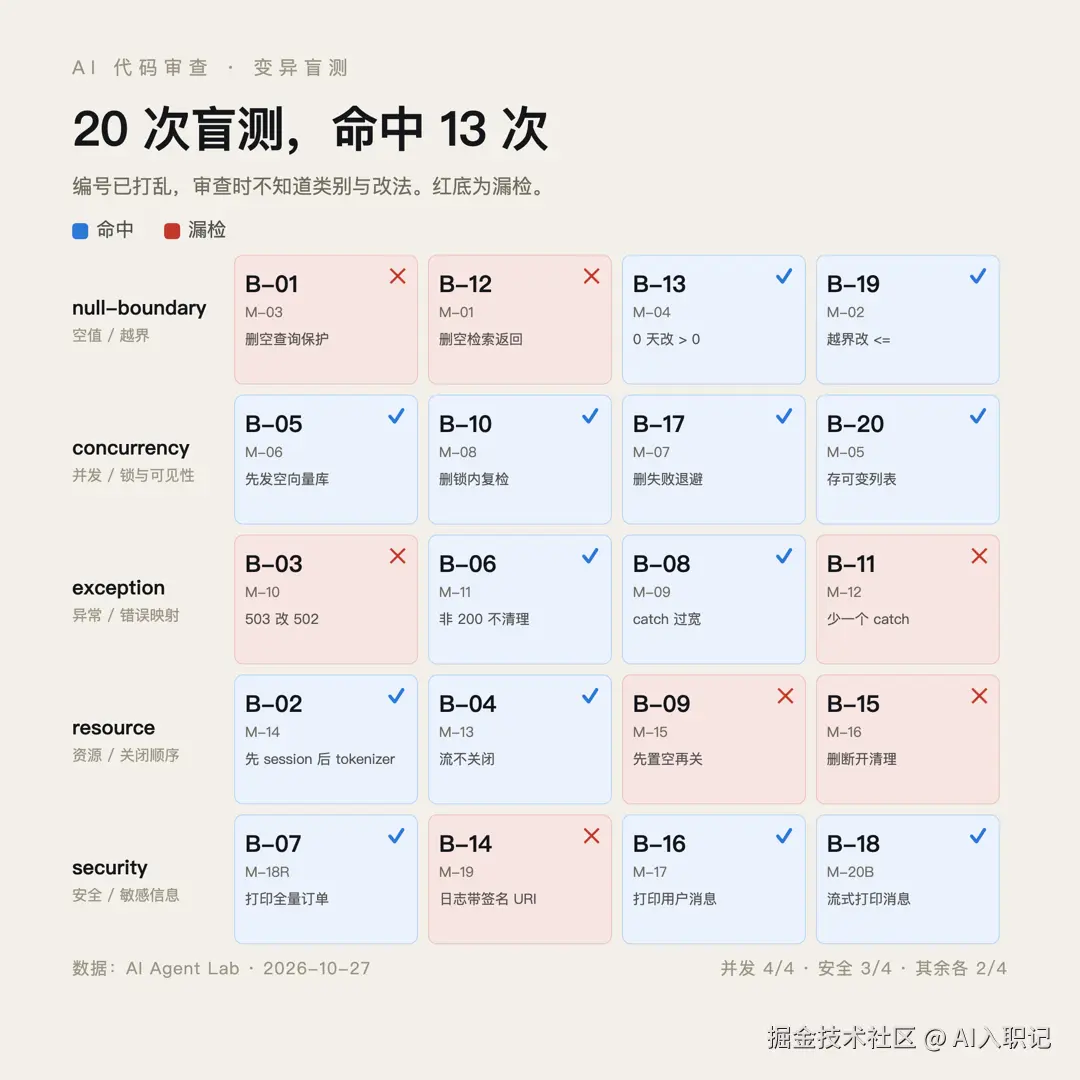
逐条判定
| blind | mutant | 类别 | 变异 | 命中 |
|---|---|---|---|---|
| B-01 | M-03 | null-boundary | 删除空查询保护 | ✗ |
| B-02 | M-14 | resource | 先发布 session 后发布 tokenizer | ✓ |
| B-03 | M-10 | exception | 可重试错误 503 → 502 | ✗ |
| B-04 | M-13 | resource | 不关闭知识库输入流 | ✓ |
| B-05 | M-06 | concurrency | 先发布空向量库 | ✓ |
| B-06 | M-11 | exception | 非 200 分支不清理 .part |
✓ |
| B-07 | M-18R | security | 日志输出全量订单表 | ✓ |
| B-08 | M-09 | exception | catch 扩大到 Exception |
✓ |
| B-09 | M-15 | resource | close() 先置空再关闭 |
✗ |
| B-10 | M-08 | concurrency | 删除锁内二次检查 | ✓ |
| B-11 | M-12 | exception | 去掉 IllegalStateException 捕获 |
✗ |
| B-12 | M-01 | null-boundary | 删除空候选提前返回 | ✗ |
| B-13 | M-04 | null-boundary | days >= 0 → days > 0 |
✓ |
| B-14 | M-19 | security | 日志追加完整签名 uri |
✗ |
| B-15 | M-16 | resource | 删除 onCompletion 清理 |
✗ |
| B-16 | M-17 | security | chat() 打印用户消息 |
✓ |
| B-17 | M-07 | concurrency | 删除失败退避读取 | ✓ |
| B-18 | M-20B | security | 流式入口打印用户消息 | ✓ |
| B-19 | M-02 | null-boundary | position <= candidates.size() |
✓ |
| B-20 | M-05 | concurrency | 存入调用方可变列表 | ✓ |
按类别
| 类别 | 命中 / 总数 | 召回率 |
|---|---|---|
concurrency |
4 / 4 | 100% |
security |
3 / 4 | 75% |
null-boundary |
2 / 4 | 50% |
exception |
2 / 4 | 50% |
resource |
2 / 4 | 50% |
| 合计 | 13 / 20 | 65% |
漏检分析
7 条漏检,逐条看。
1. B-12 删除空候选提前返回(RagService:99)
原来候选为空时提前返回,变异体删掉这段,空检索结果会继续走 LLM,答案凭空生成。AI 完全没提。
2. B-01 删除空查询保护(LexicalReranker:33)
空查询集导致除零,分数变成 NaN,排序结果随机。没提。
3. B-15 删除 onCompletion 清理(ChatController:64)
客户端断开后订阅不释放,模型继续生成。没提。
4. B-11 去掉 IllegalStateException 捕获(ChatController:156)
连接已关闭时抛出的 IllegalStateException 不再被吞,会往外抛。这一条最典型:AI 讨论了同一个方法的另一个问题(send 失败后没有 complete),说明方法读完了,只是没看出少了一个 catch 类型。
5. B-09 close() 先置空再关闭(CrossEncoderReranker:97)
并发请求在关闭窗口内拿到 null 或已关闭对象。注意:这条和本轮命中的 B-05(先发布空向量库)是同一个形状,一次中、一次漏------说明模式识别不是稳定规则。
6. B-03 状态码 503 → 502(ApiExceptionHandler:56)
可重试错误被映射成不可重试。代码里两个数都合法,看不出"错",错在客户端重试策略,那层不在输入里。
7. B-14 日志追加完整 uri(ModelFileCache:125)
签名参数进日志。另外三处日志泄露是新增整行打印,全部命中;往一行已有日志里加一个参数,漏了。
归纳
- 漏检的 7 条里,5 条是删掉或换掉一个防御步骤:B-01、B-09、B-11、B-12、B-15。代码本身完全合法,没有一处"看起来不对"。
- 命中的几乎都是"有形状"的东西:锁的位置、
volatile、set和add的先后、新增的日志行、收得过宽的catch。 - 它审的是写出来的代码,不是没写出来的代码。
另一个反例是数值改动:B-13(>= → >)命中了,因为数值被翻译成了语义("0 天被判成已过去");B-03(503 → 502)没中,因为字面差异不构成错。线索是语义,不是数值。
成本
| 指标 | 值 |
|---|---|
| 盲测 token 合计 | 约 165 万 |
| 单次 token 区间 | 5 万 -- 15.4 万 |
| 单次成本与文件大小的相关性 | 弱 |
比基线审查(10 次运行、58.7 万 token)贵将近三倍,原因是运行次数翻倍,且每次都带完整上下文。贵的还是读文件的轮次,不是代码行数。
局限
- 单项目、单人判定:一个 2000 行规模的项目,判定由作者一人完成,主观性无法消除。
- 变异体是人为构造的:分布与真实缺陷不同。65% 只说明"对这类注入缺陷的敏感度",不等于真实漏检率。
- 样本量小:20 个,单个命中就是 5 个百分点,不要把 65% 当成精确值。
- 两类指标语料不同 :上一轮的 50% 精确率来自真实代码,这一轮的 65% 召回率来自人工注入,不能合成 F1。
- 没有重复运行:单次运行,无稳定性数据。
工程建议
- 给 diff,不要只给文件。 删除型缺陷在 diff 里表现为"少了几行",可见;给整个文件,那几行根本不存在。
- 别指望它补"少写"的检查。 判空、
finally、清理回调、异常分支,要靠测试和 diff review 兜底。 - 用它补测试难写的部分。 并发、资源、异常路径测试成本高,AI 命中率最高------这次并发 4/4。
- 只采纳能落到行号、触发条件、后果的发现。 说不出来的当噪音。
- 先让测试筛一遍变异体。 测试能抓的交给测试,AI 只处理测试的盲区,这样两边的账都算得清。
复现线索
- 基线:tag
review-baseline,commitc5477f4 - 变异体:23 个分支
exp/mutants/M-01...M-20B,一条一个改法 - prompt:冻结的
review-prompt-v1.md,核心三条纪律------只报能指到行号的、写清触发条件与后果、需要未知代码才能判断的标needs_context不要假设 - 盲测:固定种子打乱编号,输入只给被变异文件 + 直接依赖接口,判定后再对映射表
- 成本记录:每次运行的输入/输出 token 与耗时
完整记录(含 prompt、原始输出 JSON、逐条判定理由)在项目 docs/experiments/ 下。
数据与判定由作者人工核对。这是一个个人项目的单次实验,样本量和语料都有明显边界,结论请按自己的工程形态打折使用。