AI写代码已经快得让人眼花,真正卡脖子的是另一件事:它写出来的东西,到底对不对,合不合需求?没有验证器,人就得一行行盯着看,AI再快也白搭。下面从为什么需要验证器讲起,再给出一条能快速起步的路线,最后梳理几种常见的落地方案。
🧭 为什么验证器是AI编码的地基
编码智能体生成代码很快,但如果它没法检查自己的成果,错误就会一路累积,最后全压到人身上。业内的共识越来越清晰,自我验证、测试和反馈回路是AI生成软件可靠的前提。
有开发者分享过一套验证层级的做法。AI负责直接输出,人负责设计和掌控验证系统。人的精力从逐行审查转到设计规则,让机器自己去跑、去判、去返工。
还有一个容易踩的坑。通过现有测试,不等于代码正确。已有测试只覆盖了过去想到的场景,对新需求可能完全没有约束力。所以验证器要回答的问题是产品是否符合需求,光看代码有没有跑通不够。
🔍 验证器的分层结构
验证器越便宜、越确定,就越应该放在前面。慢而贵的检查留给后面,只处理前面筛不掉的问题。
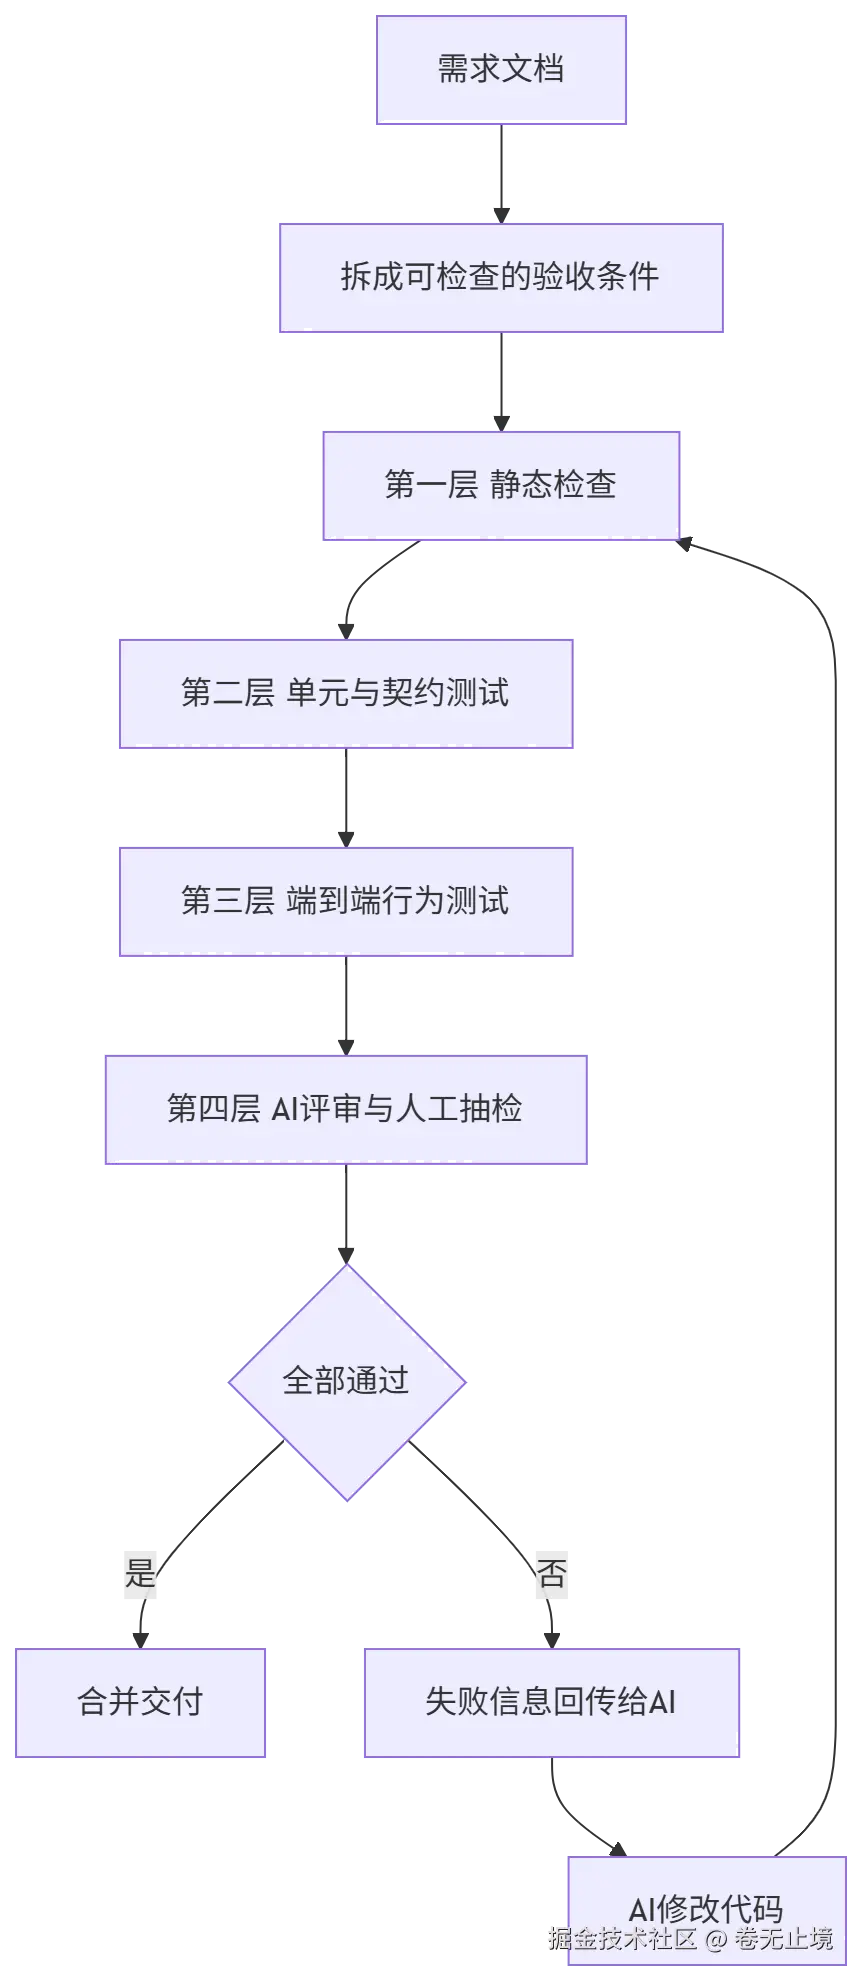
每一层各管什么
- 静态检查,包括类型检查、代码风格和安全扫描,几秒钟就能出结果,用来挡住低级错误。
- 单元与契约测试,检查函数、接口的输入输出是否符合约定,是需求落地的主战场。
- 端到端行为测试,模拟真实用户操作,验证整条链路能否走通。
- AI评审与人工抽检,处理难以量化的部分,比如交互是否顺手、文案是否得体。
这套层级的意义在于让失败信息可以自动回流。AI收到明确的报错,就能自己改,改完再跑,形成闭环。
🛠️ 快速构建的四步路线
第一步,把需求翻译成可执行的验收条件
模糊的需求没法验证。把一句话需求拆成输入、操作和预期结果三段,每条都能用代码判定真假。
比如需求是用户可以用邮箱注册,重复邮箱要被拒绝。它可以改写成下面的测试。
python
import pytest

def test_register_with_new_email_succeeds(client):
    resp = client.post("/register", json={"email": "a@x.com", "password": "Passw0rd!"})
    assert resp.status_code == 201

def test_register_with_duplicate_email_is_rejected(client):
    payload = {"email": "dup@x.com", "password": "Passw0rd!"}
    client.post("/register", json=payload)
    resp = client.post("/register", json=payload)
    assert resp.status_code == 409
这些测试最好在AI动手写实现之前就备好。AI拿到的是一把尺子,不是一个开放题。
第二步,把所有检查收拢到一个入口
AI最怕入口分散。一条命令跑完全部检查,输出统一格式,AI才容易读懂。
bash
#!/usr/bin/env bash
set -e
ruff check .
mypy src
pytest tests/unit -q
pytest tests/e2e -q
echo VERIFY_OK
第三步,让失败信息说人话
报错要带上哪条需求没满足、期望什么、实际得到什么。信息越具体,AI一轮修对的概率越高。
第四步,设置回路上限与通过率指标
给自动返工设一个最大轮数,避免AI陷入死循环。同时用一个简单指标衡量验证覆盖的程度。
需求覆盖率=需求总数有对应验证的需求数
覆盖率偏低,说明验证器还有盲区,回头补测试就是了。
📊 常见落地方案对比
不同团队的基础不同,下面几种方案可以按成本和收益组合着用。
| 方案 | 适用场景 | 搭建成本 | 主要优势 | 主要局限 |
|---|---|---|---|---|
| 测试先行加持续集成 | 已有测试体系的后端项目 | 低 | 确定性强,结果可复现 | 依赖需求拆得够细 |
| 行为驱动规格(Given-When-Then) | 需求方与研发要对齐语言 | 中 | 需求文档直接变成测试 | 需要维护规格文件 |
| 浏览器自动化端到端验证 | 前端或全流程产品 | 中 | 贴近真实用户行为 | 运行慢,偶发不稳定 |
| AI评审员 | 主观质量、代码可读性 | 低 | 覆盖规则写不出来的部分 | 有误判,需要抽检兜底 |
| 分层验证加自动返工 | 长时间无人值守的AI开发 | 较高 | 流水线闭环,省人力 | 前期设计投入大 |
选型时可以参考这个顺序。已有测试的团队直接接入持续集成。需求经常变的团队,行为驱动规格更省心。要让AI长时间自主开发,就得上分层验证加自动返工。
评估AI编码工具时的参照
挑选编码智能体本身,也可以用验证器来反推。有评测思路建议,用仓库级别的真实测试去考察自主性、上下文理解、验证能力、集成度和成本这几个维度。验证能力是其中一项硬指标。
💡 避坑与收尾
几个反复出现的坑,提前知道能省不少力气。
- 让AI自己写测试再自己验自己,容易出现测试迁就代码的情况,需求侧的测试最好由人把关。
- 只盯通过率,忽略测试质量,会得到一个看上去很美的绿灯。
- 验证太慢,AI每轮等得太久,整体效率反而下降,所以要把快检查放前面。
- 只验功能不验约束,性能、安全和兼容性同样要写进验收条件。
回头看,快速构建验证器的核心就是三件事。把需求写成能跑的检查,把检查收进一个入口,把失败信息送回给AI。先用一两个核心需求跑通闭环,再逐步加层,比一开始就追求大而全靠谱得多。AI负责写,验证器负责把关,人则回到更值钱的位置,去定义什么叫做对。
参考资料
How to choose an AI coding agent for real work | Octomind octomind.run/blog/ai-cod...
I built a verification hierarchy that lets AI write production code 24/7 www.reddit.com/r/SideProje...
Why AI Coding Agents Need a Way to Verify Their Own Work
How to verify correctness of AI-generated code beyond passing existing tests