Agent 语音引擎换心记:从「够用」到「稳且好」
一句话:给 Agent 做固定角色语音回复,先用 CosyVoice2 zero-shot 调到「够用」,再用一套测量脚本量出它的天花板(说话人余弦 0.06),最后换成 GPT-SoVITS 微调(余弦 0.89、合成快 5 倍、常驻内存从 5GB 压到 150MB)。这不是踩坑救火,是用量化提前换掉一个到顶的方案。
起因
给 QQ 上的 Agent 接语音回复,交互闭环是 STT 听懂 → LLM 想怎么回 → TTS 用角色音色说出来。第一个硬要求是:声音得是固定那个角色,不是每次随机一个近似音。这个角色原型选了 doro------一个公开的虚拟主播角色------音轨从她公开视频里扒(具体做法见幕一)。
最开始走 CosyVoice2 zero-shot------推理时贴一段参考音频,临时捏出音色。调完频响补偿(EQ)之后,日常用其实够用、基本能听清。
但「够用」底下到底稳不稳,耳朵说了不算,得量。于是我写了一套评估脚本,把同一段参考音频的合成结果量化成三个数:人声厚度(500--1000Hz 能量占比)、底噪、说话人相似度余弦。量完才发现,旧方案的「够用」坐在一个不稳定的天花板上。
幕一:把声音做到「够用」
音源。 最早用 QQ 语音(SILK 二次转码),合成底噪 p10 只有 -29dB,听着发闷。换成 B 站原视频音轨(一次解码、真数字静音),底噪直接到 -52.6dB,差 24dB。根因不是编码差,是参考音频的停顿段带底噪,模型把它当环境声一起克隆了。
EQ 修听感。 CosyVoice2 在 24kHz 宽带生成,参考只有 7kHz 带宽,于是 4--8kHz 被凭空补出来、500--1000Hz 反而塌陷------听感像老式收音机。加一条通用频响补偿:500--1000Hz 从 11.4% 拉到 36.0%,4--8kHz 从 13% 压到 2.8%。这一步让旧方案从「发闷」变成「够用」。
幕二:测量暴露天花板
量着量着,三个教训比结论更重要:
- 单次采样不可信。 同音色同文本合成 3 次,底噪 p10 最大差 30dB。任何音质评估必须多次采样取均值,否则会把运气好的一次当成改进(这次就误判过一次:单测到 -69dB 便宣布「与 demo 持平」)。
- 参考音频越长越糟。 10s 带停顿的参考合成后中频只有 11.4%(塌陷),5.5s 紧凑句能到 22%。给 CosyVoice2 的参考取 4--6s、完整句、紧凑。
- 静音门破坏性极大。 曾用能量门控削弱起尾音,合成断断续续无法收听,已回滚。参考音频只允许谱减,不做能量门控。
把旧方案按这套脚本和 GPT-SoVITS 微调做同脚本对照,差距才彻底显形:
| 样本 | 500--1000Hz | 底噪 p10 | 说话人余弦 |
|---|---|---|---|
| 参考音频(doro 音轨) | 45.8% | -90.6dB | 1.000 |
| GS 微调(短句) | 42.0% | 数字静音 | 0.894 |
| CosyVoice2 zero-shot(对照) | 11.1% | -5.7dB | 0.091 |
余弦用 ERes2NetV2 说话人嵌入,和早期 campplus 基准尺度不同,这里只做同脚本相对比较。
CosyVoice2 zero-shot 的余弦只有 0.06--0.09,正好落在跨音色区间------模型在说话人空间里不认为那是同一个人。注意:这是裸 zero-shot、无 EQ 的同脚本对照;实际上线版带 EQ,体验是「够用」,但测量说明它的「够用」底下是每次临时捏音色 + 变声器分布外,EQ 修的是听感,治不了根因。
幕三:换心
用同一条 B 站音轨的 ~102s 素材对 GPT-SoVITS v2 微调(18 段清洗后数据,s2 12 epoch + s1 30 epoch),把音色从「每次赌运气」变成「训练进权重」。参考音频只管韵律,不再决定音色------zero-shot 的三个问题(底噪抖动、中频塌陷、音色漂移)同时消失。
| 项 | GPT-SoVITS v2 微调 | CosyVoice2 zero-shot |
|---|---|---|
| 说话人余弦 | 0.85--0.89 | 0.06--0.09 |
| 500--1000Hz | 42--45% | 11% |
| RTF(热合成) | 0.32(3.4s 合 10.8s) | ~1.6 |
| 种子稳定性 | 余弦波动 ~0.03 | 底噪抖 30dB |
| 听感验收 | 比 CV 最好时好太多 | 够用(带 EQ) |
听感验收后拍板 CosyVoice2 退役。余弦从 0.06 到 0.89,合成快 5 倍,这不是「修好一个坏的」,是「突破一个到顶的」。
顺手做的:内存隔离
语音引擎权重 ~4GB,常驻会吃掉 backend 近 5GB 内存。实测同进程卸载(del + gc + empty_cache)后内存只回 11%------显存能回收,内存不能(torch CPU 分配器 + glibc 碎片 + ONNX arena 都不还给系统)。唯一彻底归还的办法是杀进程。
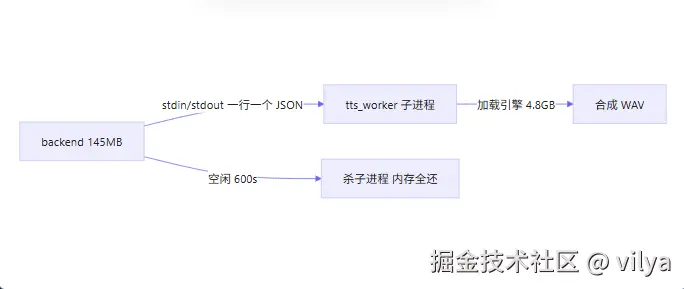
于是把引擎挪进可回收子进程:backend 只留 145MB 的转发层,收到语音消息转写成功后后台预热,合成时子进程加载 ~4.8GB 权重,空闲 600s 自动自杀。
css
graph LR
    A[backend 145MB] -->|stdin/stdout 一行一个 JSON| B[tts_worker 子进程]
    B -->|加载引擎 4.8GB| C[合成 WAV]
    A -->|空闲 600s| D[杀子进程 内存全还]
效果:纯文字聊天时语音子进程根本不存在(内存 0);用过语音后空闲回收,backend 常驻回到 145MB。和换心一起,把一个「够用但吃 5GB」的语音模块,变成「稳且好、常驻 150MB」。
几点说明(边界,老实说)
- 旧方案其实够用。 CosyVoice2 + EQ 日常能用、基本能听清,只是测量暴露它坐在不稳定天花板上。换引擎是「够用 → 稳且好」,不是「坏 → 修好」。
- GS 仍有 seed 抖动。 短句的频率占比在 26%--43% 间跳(3 seed),余弦稳(0.854--0.885)但频率会晃,没到完美。
- 唱歌另走 RVC。 TTS 不做旋律控制,唱歌需求单独管线,音色同源。
- 关于试听。 本文发布平台(掘金 / 小红书)均不支持直接挂音频文件,故不嵌入试听片段。固定角色音色的最终听感以文字描述:声音像 doro、清晰稳定,明显优于 CosyVoice2 最好时;量化对比见上文测量表(余弦 0.06→0.89、RTF 0.32 vs 1.6)。如需亲耳试听,GS 成品音频可随仓库发布或转短视频另行展示。
收尾
整套改动收敛在 plugins/voice/:删掉 CosyVoice2 适配(cosyvoice2_rt),新增 gptsovits_rt/ 薄适配(三方法契约 __init__ / list_voices() / synthesize(text, voice) 不变,调用方无感)+ tts_worker.py 子进程隔离 + eq.py 频响补偿。GPT-SoVITS 与 CosyVoice2 的推理代码都不进仓库,直接复用 external/GPT-SoVITS 上游------所谓「换心」,换的是适配层与微调权重,不是把引擎搬进搬出。仓库 momo-null/omniagent。