同一台 ESP32,GSM 能消回声,VoIP 为什么不行?
2026 年 10 月 13 日核对 GitHub 当前正文及两条评论,讨论仍为 open,但已有值得保留的调查进展。维护者回复以"I guess"提出 GSM 与 WhatsApp 可能使用不同 HFP codec,建议检查 CVSD/8 kHz 与 mSBC/16 kHz;报告者随后贴出 audio state connected 与 AFE sample rate 8000 片段,并追问声音没有明显失真为何仍有回声。前者是待核实猜测,后者是局部配置线索,没有构成两种会话的完整协商日志或成对 PCM,仍不能确定根因。不要遗漏这条已有线索,也不要把它升级为"VoIP 必然切到 16 kHz"。
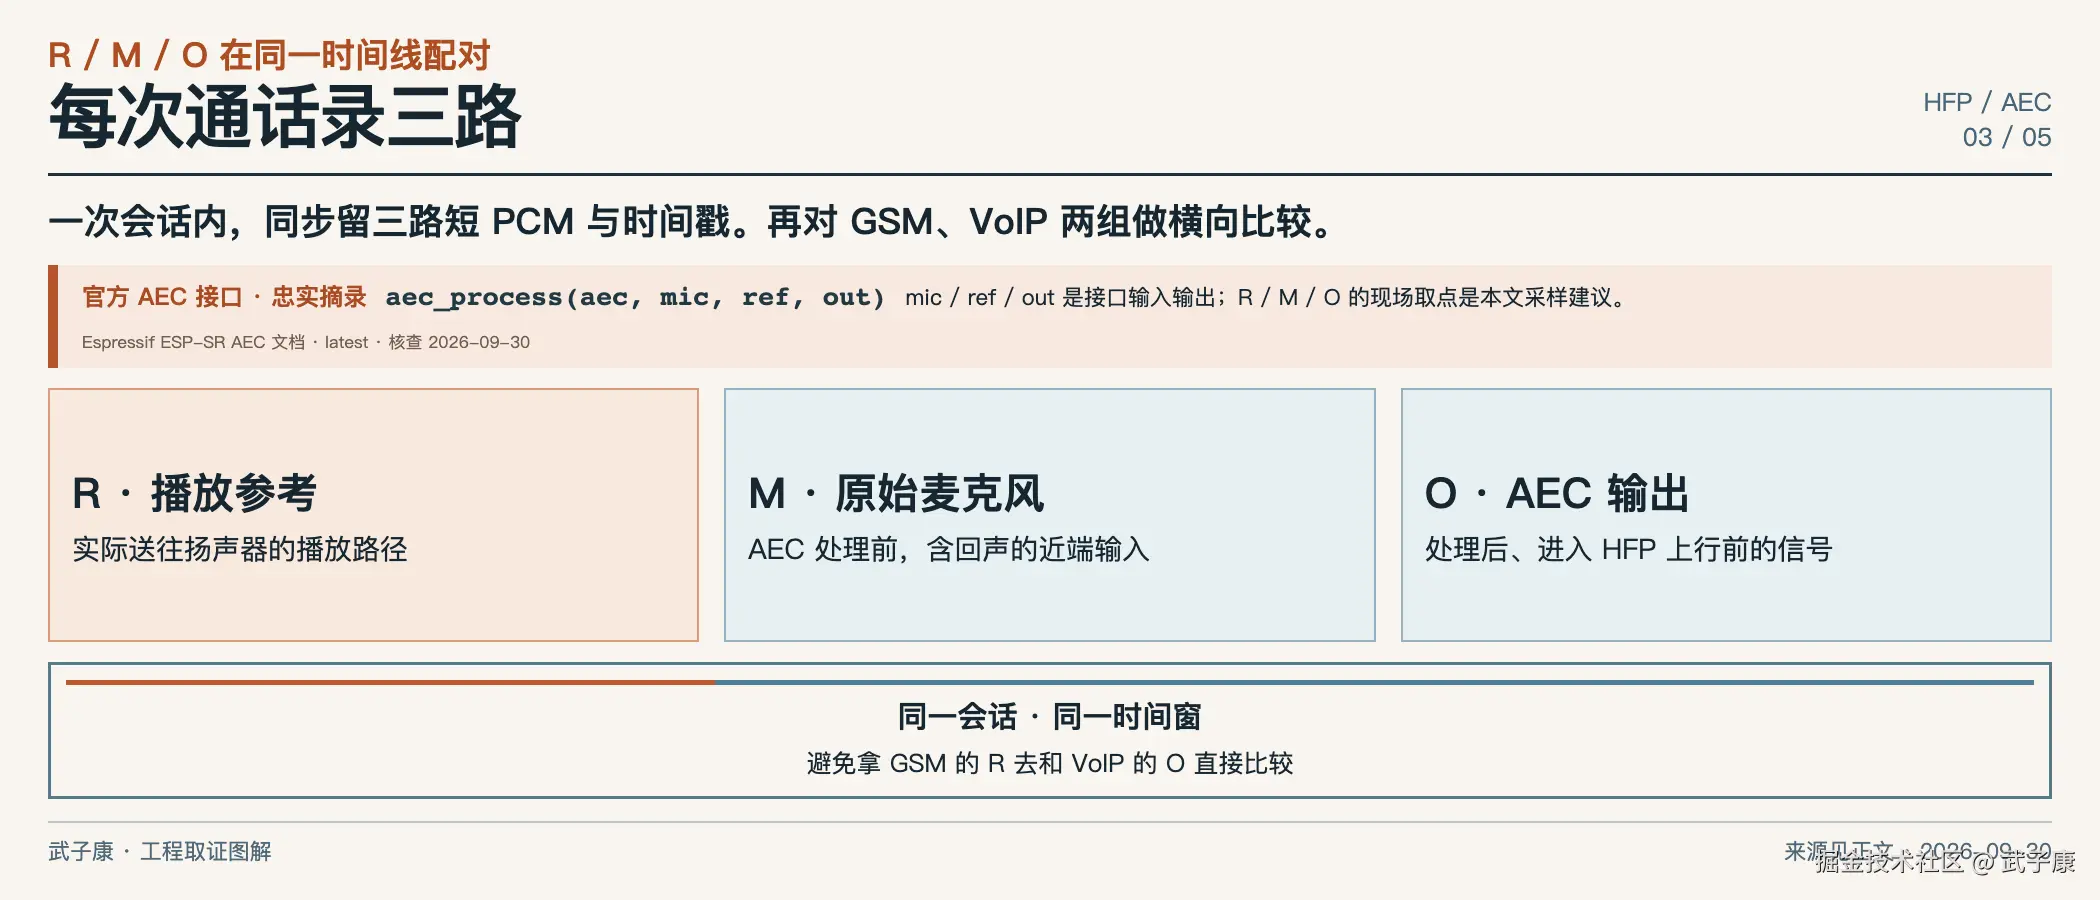
最容易犯的错,是把"硬件相同"扩写成"送进 AEC 的信号相同"。乐鑫的 AEC 接口说明明确把 mic、ref 和 out 分开:mic 是含回声的近端麦克风,ref 是扬声器播放参考,out 是处理结果。手机应用、蓝牙通话路径和设备播放链之间只要有一个环节改变,实际参考或其时间位置就值得重新核对;这句话是排查假设,不是对 issue #213 根因的判定。
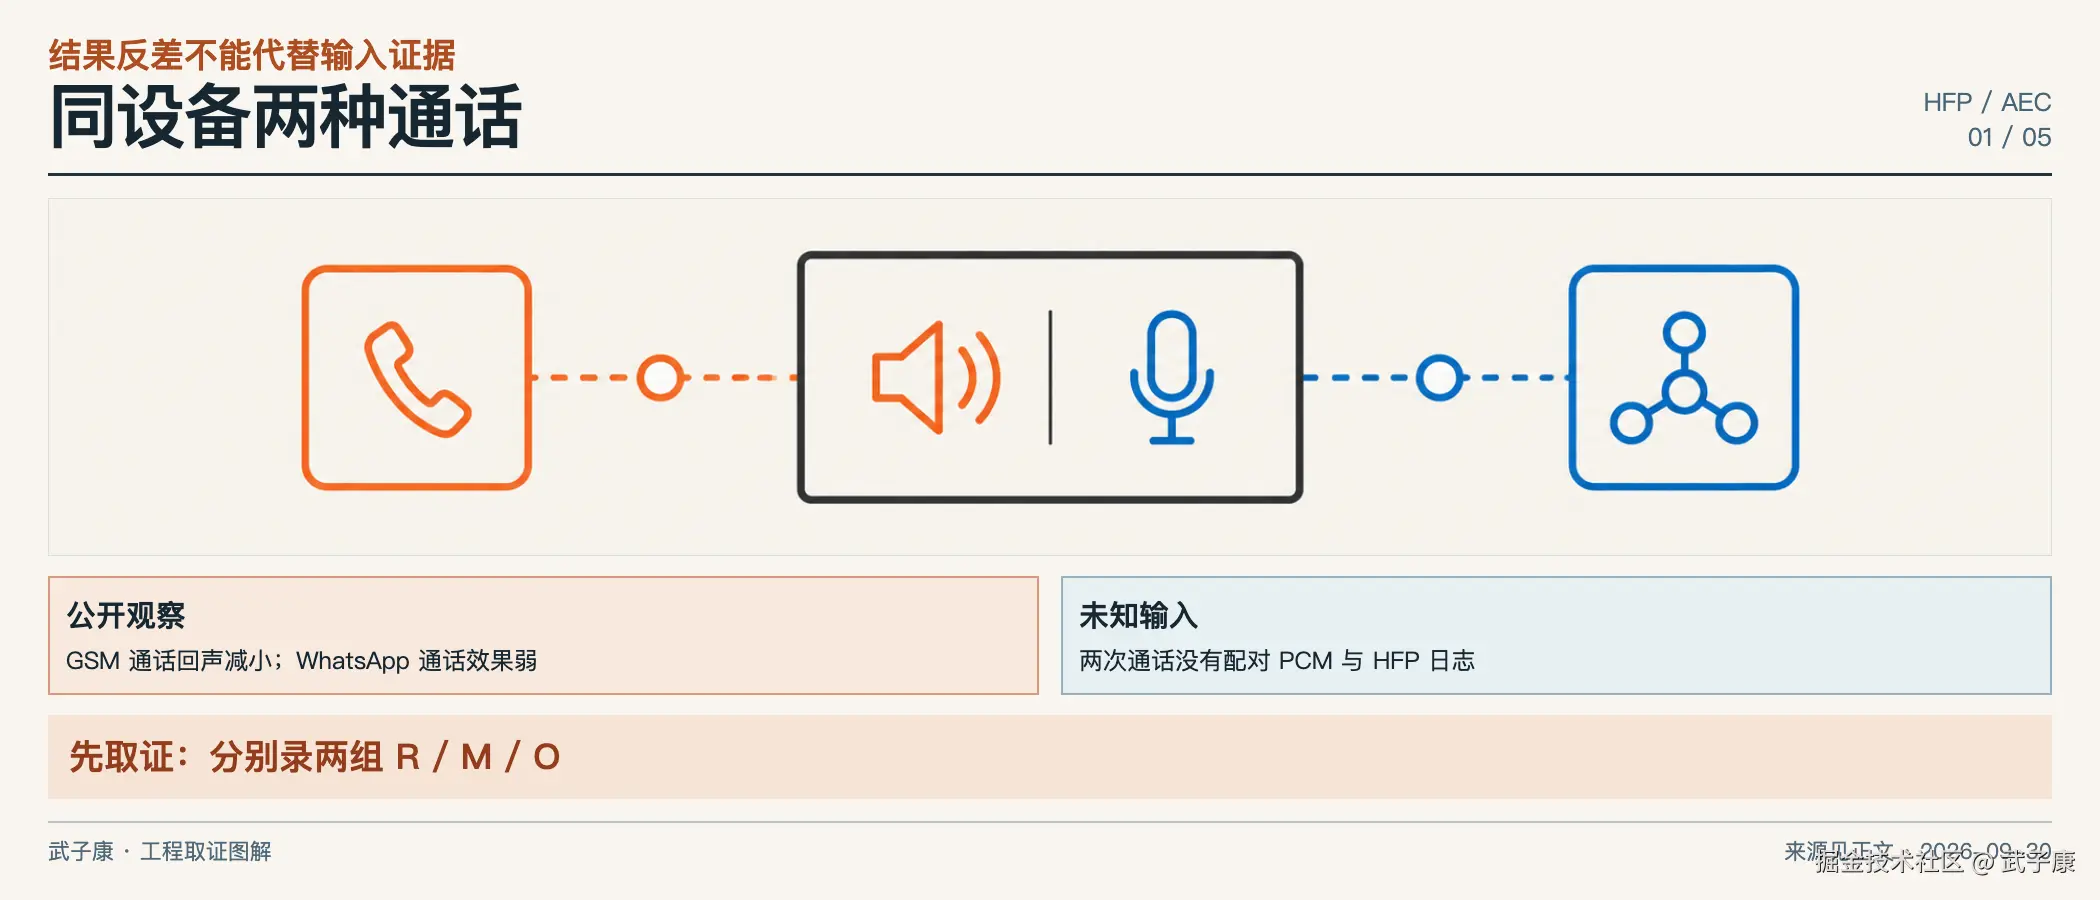
先画清哪一端听到了什么
在这起报告中,"远端用户听到回声"指通话对端的声音从 ESP32 扬声器播出,被本地麦克风再次拾取,沿上行音频送回对端。它不是设备本地扬声器里听到自己,也不是 ASR 将 TTS 当成人说话。对端听感是结果,AEC 输入是原因候选;如果只留对端一句"回声大",无法知道问题发生在播放参考缺失、PCM 错位、AEC 输出未被使用,还是更上游的通话处理。
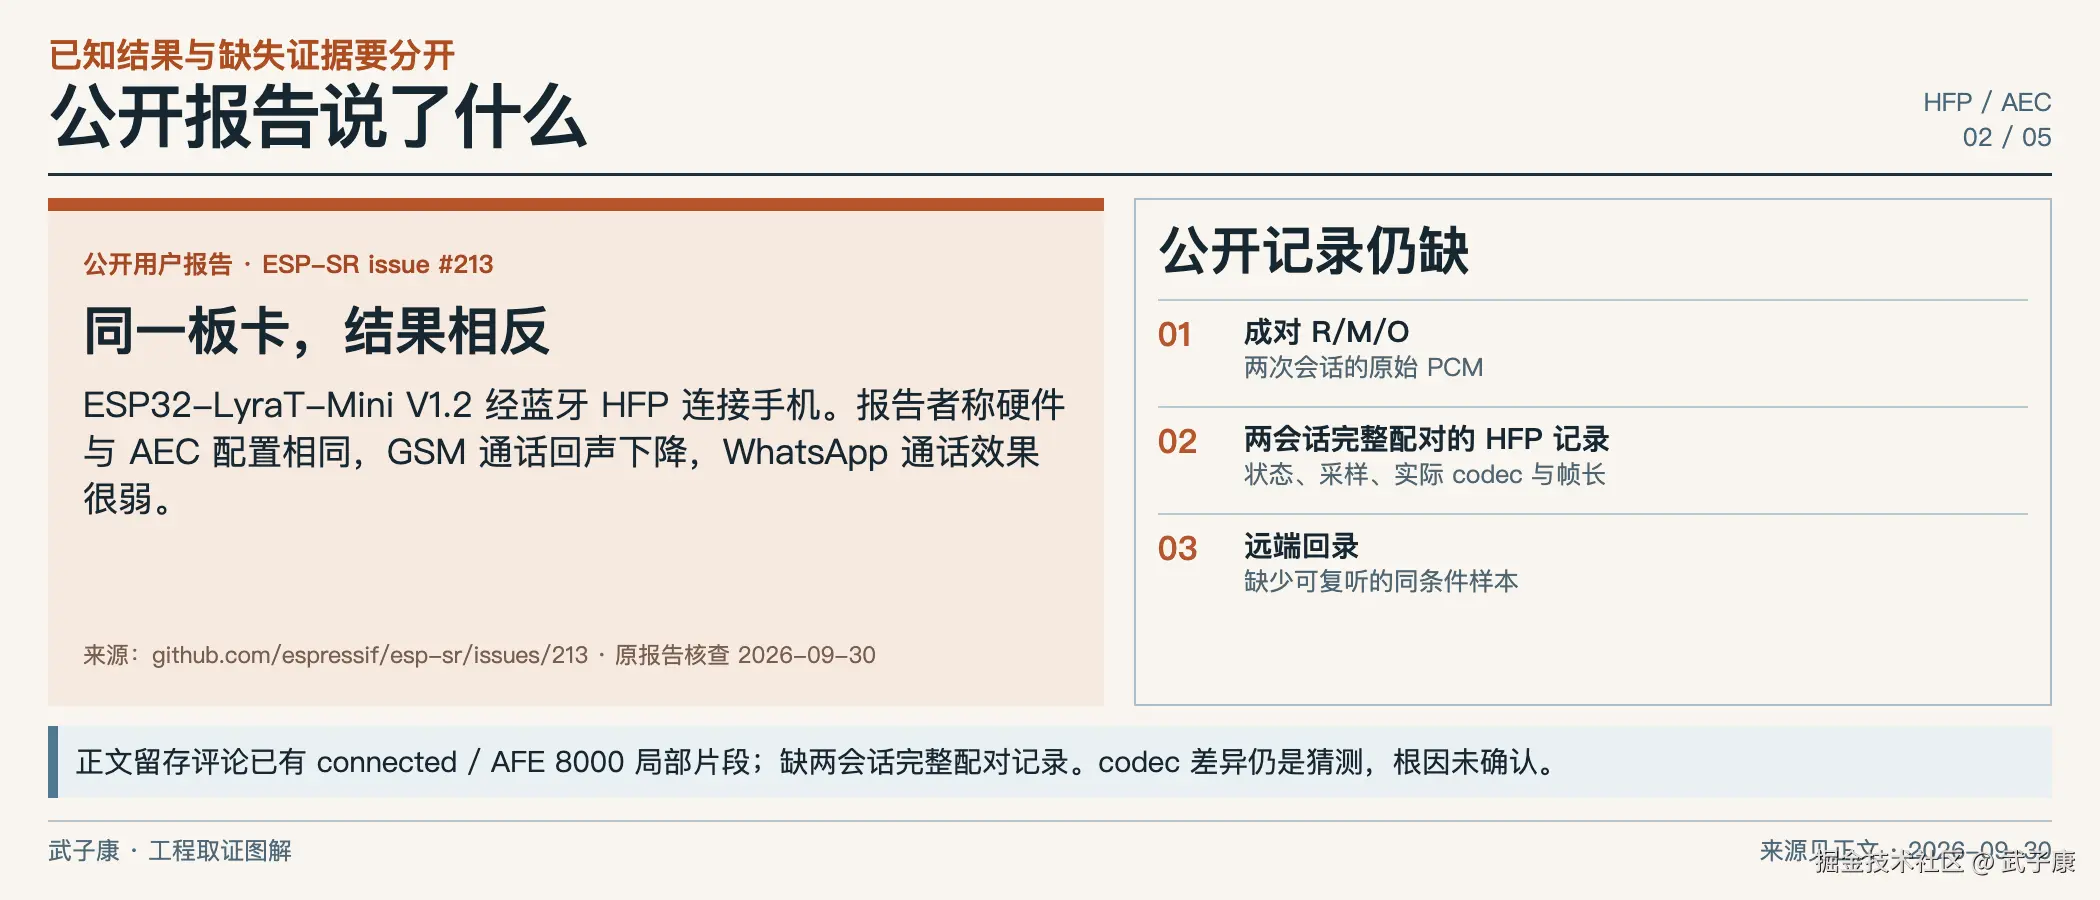
图02中的"HFP 音频状态"应限定为缺少 GSM 与 WhatsApp 两次会话完整配对的状态、codec 与采样记录,并非没有任何状态日志。 公开评论已经有 audio state connected 和 AFE sample rate:8000 的局部片段,但没有将它们与两次会话的完整记录对应。维护者提出的 codec 差异仍是待核实猜测,局部 8000 既不能证明两次协商相同或不同,也不能确认回声根因。
先把两条通话路径画成相同的四个观测点:手机下行经 HFP 到设备;设备实际送往扬声器的播放样本 R;同一时刻的原始麦克风 M;AEC 输出送往 HFP 上行前的样本 O。要求 R 是实际播放路径 的参考,不只是手机 App 曾生成过的音频或一个早于最终音量、解码步骤的缓冲。这个输入区分与前篇"设备开了 AEC 仍听到自己"的一般解释相同;本篇新增的是让 GSM 和 VoIP 各录一次,并把四个观测点放在同一张差分表里。
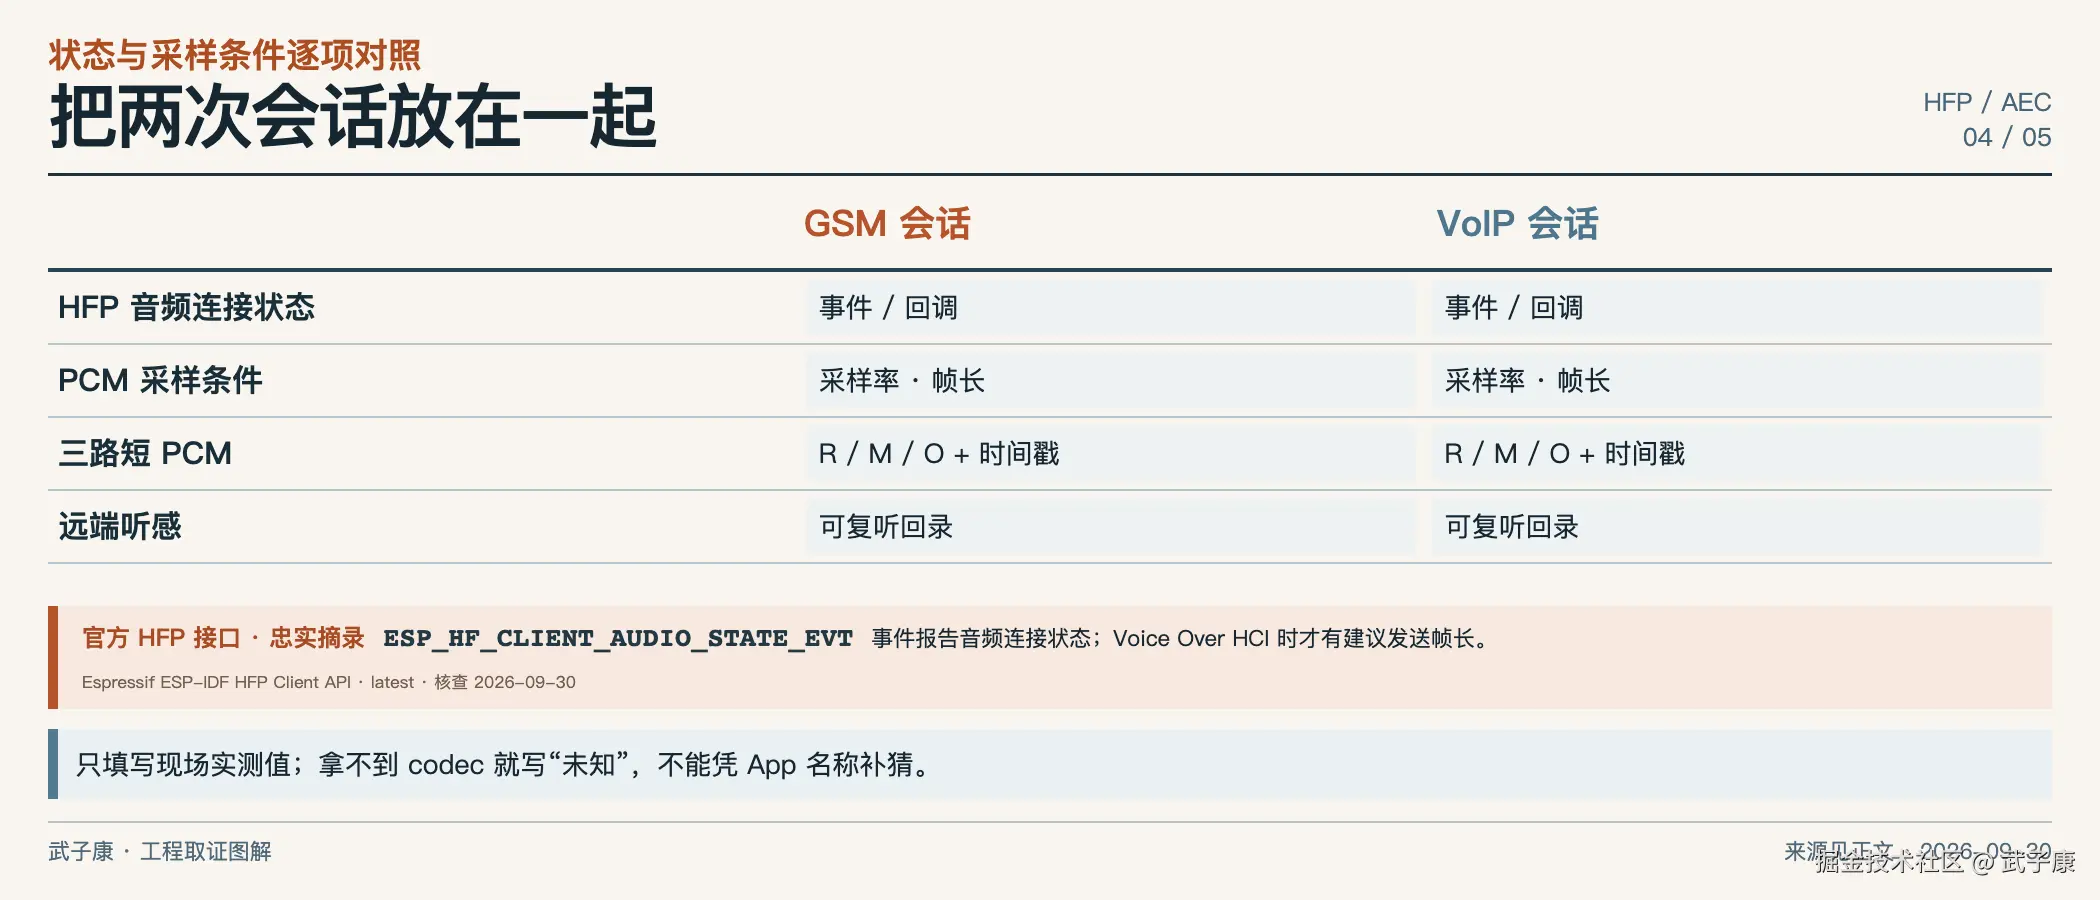
| 成对字段 | GSM 一次 | VoIP 一次 | 要判断的差异 |
|---|---|---|---|
| 手机、App/版本、板卡、固件与 AEC 配置 | 实际值 | 实际值 | "同配置"是否真的成立 |
| HFP 音频连接状态、可见的 codec/帧长信息 | 日志和接口回调 | 日志和接口回调 | 两次是否走了相同的音频连接条件 |
解码后送播放的 R、原始 M、处理后 O |
三路短 PCM 与时间戳 | 三路短 PCM 与时间戳 | 参考是否存在、帧是否对齐、输出是否下降 |
| 扬声器音量、麦克风增益、欠载/丢帧 | 实际记录 | 实际记录 | 参考幅度和连续性是否改变 |
| 远端回录或同一听审量表 | 可复听样本 | 可复听样本 | "效果差"是否可复现而非单次印象 |
表中的 codec 与帧长是建议记录的变量 ,不是本文已证实两种电话协商出了不同编码。ESP-IDF 的 HFP Client API提供音频连接状态事件;在 Voice Over HCI 情况下,其回调还有推荐发送帧长。该 API 也列出 codec negotiation 能力。它证明这些状态有可检查的接口,不证明 issue 报告者的手机在两种 App 下实际采用了什么 codec,也不保证所有集成路径都暴露相同字段。若现场拿不到 codec,只写"未知",保留 PCM 采样率和帧长实测,不能补猜。
同一块板,也可能接到了两种不同的音频事实
还应区分音频内容相同与表示形式相同。同一句远端语音可以经过不同采样率、帧分割或幅度处理,再到设备。若在保存时把一组PCM按错误采样率播放,听审者可能听到变速或失真,但这首先是记录解释错误,不能拿它给通话算法定责。每份留样都附采样率、位宽、声道与有效样本数,后续工具才能按正确格式打开它。
取点图应同时标明处理顺序。例如参考复制发生在解码后还是重采样后、最终音量调整前还是后,麦克风取样在任何前处理前还是后。没有必要猜测手机内部所有流程;先把项目自己可观察的设备边界画清。如果手机侧不可观察,说明该段未知,并在设备可见的输入与输出之间限定结论。未知的上游不能被一个推测的codec名称填满。
对远端回录也要记录它的位置。设备发出的上行、手机提交到通话应用的音频,以及对方最终录到的声音,是不同边界的结果。若只有最后一个可见,可以确认用户听感,却不能单独识别前面哪段引入了回声。若能取得设备上行样本,就将其与AEC输出关联,从而确认算法结果有没有真正进入通话路径。
这里的信号身份可以由会话编号、播放片段编号和逐帧序号共同表达。两次通话各建一条记录,再列字段差异;不要把时间接近的日志行自动拼在一起。如果通话期间重连过HFP或播放器重启过,就标出边界,并重新确认其后参考和上行的来源。它们是否导致故障仍待实验,记录边界只是避免把前后两种条件混成一段连续成功或失败。
用三路 PCM 把差异定位到一段链路
两组录音尽量固定同一个手机、位置、远端说话片段、扬声器音量和固件。各留至少一段远端单讲与一段本地双讲,记录每帧采样率、样本数和时间戳。这里的"至少"是本文实验设计,不是乐鑫官方验收门槛 。仅拿 GSM 的 R 与 VoIP 的 O 比较没有意义;必须让每次通话的 R/M/O 在自己的时间线内配对,再横向比对两次会话。
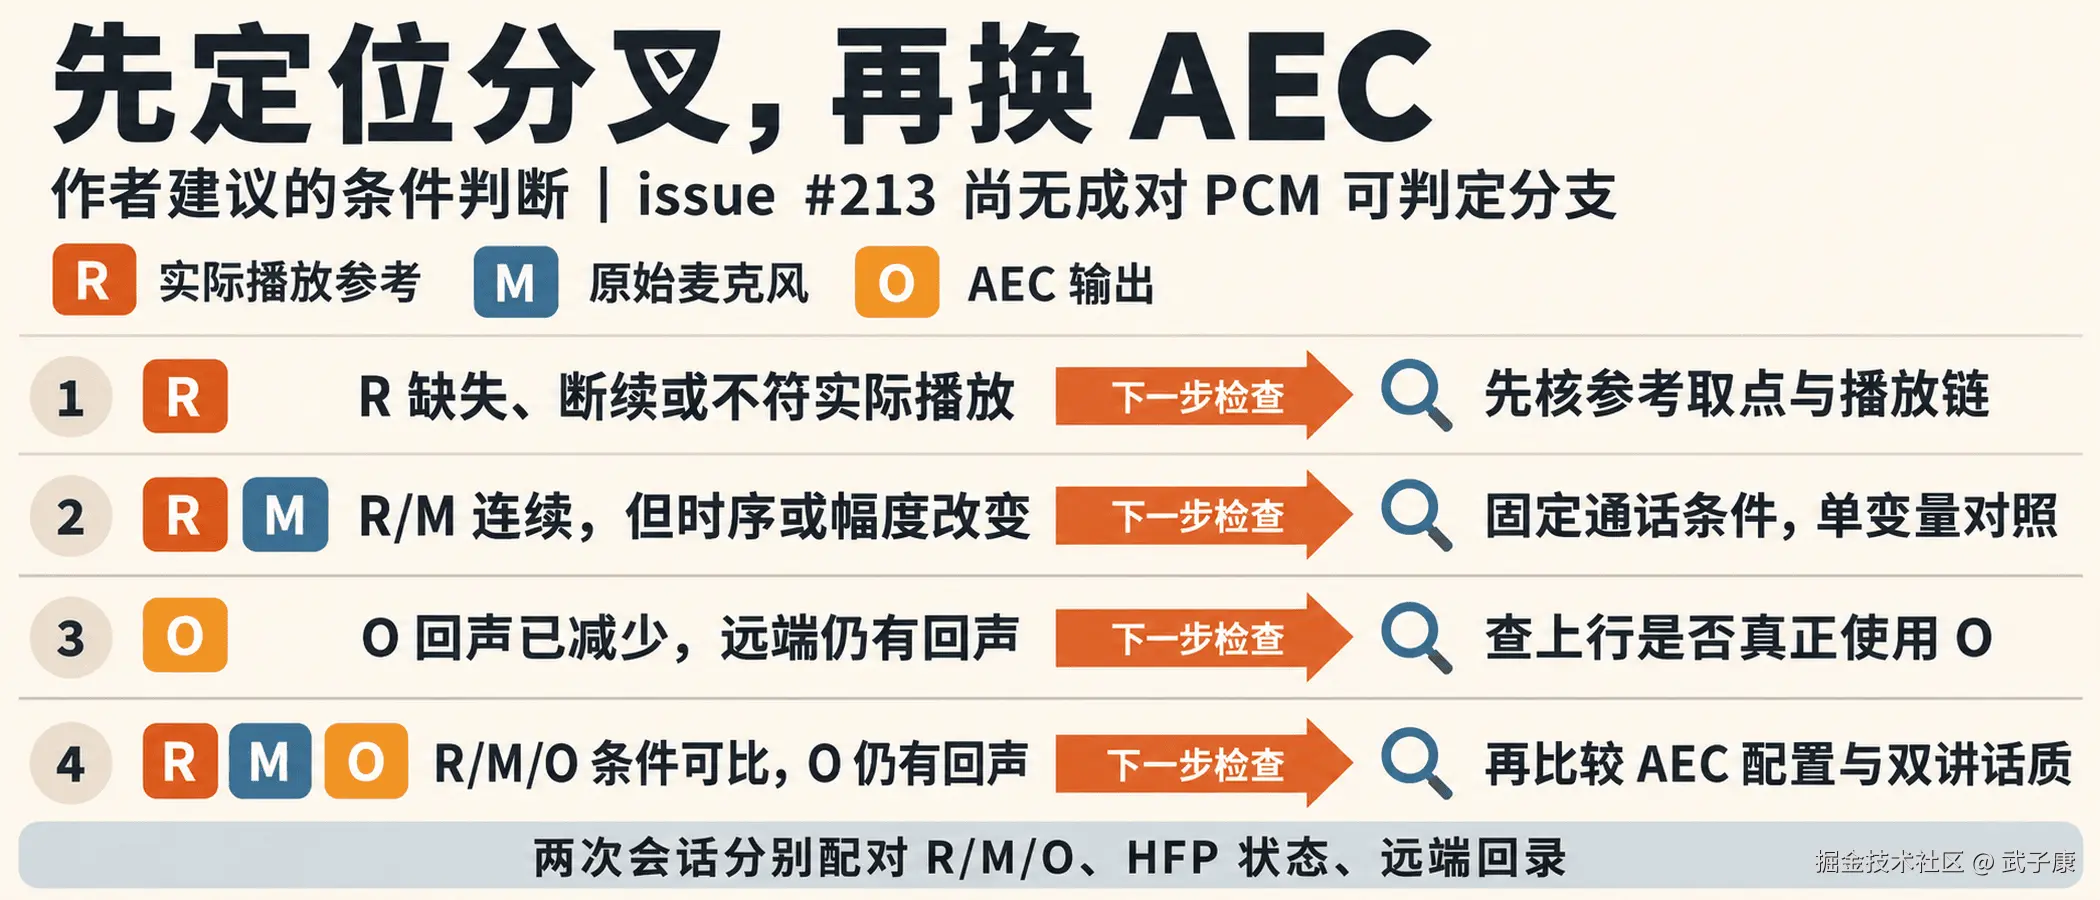
看结果时先定位分叉,而不是立刻换 AEC 模式:
- VoIP 的
R缺失、断续或与实际扬声器声音不同,而 GSM 的R正常:先修参考取点和播放链,暂时无法评价算法效果。 R和M都连续,VoIP 的两路相对时序或幅度与 GSM 明显不同:记录差异并做同一通话条件下的对齐、音量或重采样单变量实验;不能仅凭波形相关性给出通用毫秒阈值。O已明显减少回声,但远端回录仍有回声:检查 HFP 上行实际送出的是否为O、是否存在旁路或二次混音,而不是继续加重 AEC 抑制。R/M/O条件可比,而 VoIP 的O仍保留大量回声:再在固定输入上比较 AEC 配置、模式及资源占用,保留远端听感和双讲话音质量。
这些是条件判断,不是 issue #213 的已经观测到的分叉。尤其不能把"GSM 成功"当成 VoIP 失败必然由手机 App 造成:报告者只确认设备和连接在宏观层面相同,未提供进入 AEC 的成对 PCM。反过来,也不能看到 VoIP 回声就断定 ESP-SR 算法缺陷。
复制运行:同一硬件下,先核对样本身份
下面用 Python 标准库构造两次会话的有限 PCM 记录,检查实际播放、参考、麦克风、处理输出与上行来源是否对应。它不连接蓝牙、不处理 AEC,也不对波形做抑制或相关性估计。每帧 16 个整数、采样率 16000、两帧以及参考起点偏移 16,全部是方便自检的教学参数,不是 HFP/ESP-SR 的推荐帧长或实测延迟。
构造数据中 mic 是播放值的一半加一组近端标记,out 则直接预先填入近端标记,用来区分不同来源。这不是从 mic 推导出 out 的算法;设定一个看起来干净的 out,不证明任何 AEC 达到了相同效果。所有样本列表只保留在内存里,没有保存真实通话或音频二进制。
保存为 hfp_signal_pairing.py,用 Python 3.8 或以上运行,无需安装依赖。自检依赖 assert,不要用 -O。
bash
python3 hfp_signal_pairing.py
python
"""Constructed PCM records and path audit; no AEC, HFP, timing or ERLE measurement."""
from copy import deepcopy

ROLES = ("playback", "ref", "mic", "out", "uplink")


def audit(session):
    traces = session["traces"]
    missing = [role for role in ROLES if not traces.get(role)]
    if missing:
        return ["MISSING:" + ",".join(missing)]
    indexed = {}
    for role in ROLES:
        indexed[role] = {}
        for frame in traces[role]:
            if frame["seq"] in indexed[role]:
                raise ValueError("duplicate sequence in " + role)
            indexed[role][frame["seq"]] = frame
    sequences = set(indexed["playback"])
    if any(set(indexed[role]) != sequences for role in ROLES):
        return ["FRAME_COVERAGE_DIFFERS"]
    issues = set()
    for seq in sorted(sequences):
        played, reference, mic, output, uplink = [indexed[r][seq] for r in ROLES]
        frames = (played, reference, mic, output, uplink)
        if any(f["session"] != session["id"] for f in frames):
            issues.add("SESSION_ID_MISMATCH")
        if any(f["clock"] != played["clock"] for f in frames):
            issues.add("TIMELINE_CLOCK_MISMATCH")
        if any(f["rate"] != played["rate"] or len(f["samples"]) != len(played["samples"])
               for f in frames):
            issues.add("PCM_FORMAT_OR_LENGTH_DIFFERS")
        if reference["tap"] != "speaker_final":
            issues.add("REFERENCE_TAP_NOT_FINAL_PLAYBACK")
        if reference["start_sample"] != played["start_sample"]:
            issues.add("REFERENCE_SAMPLE_WINDOW_DIFFERS")
        if reference["samples"] != played["samples"]:
            issues.add("REFERENCE_BYTES_DIFFER")
        if uplink["source"] != output["id"] or uplink["samples"] != output["samples"]:
            issues.add("UPLINK_NOT_AEC_OUTPUT")
    return sorted(issues)


def constructed_session(session_id):
    traces = {role: [] for role in ROLES}
    for seq in range(2):
        played = [100 + 10 * seq + i for i in range(16)]
        near = [10 if i % 3 else -10 for i in range(16)]
        mic = [p // 2 + n for p, n in zip(played, near)]
        values = {"playback": played, "ref": played.copy(), "mic": mic,
                  "out": near.copy(), "uplink": near.copy()}
        for role in ROLES:
            traces[role].append({"id": f"{role}-{seq}", "seq": seq, "session": session_id,
                                 "clock": "demo-sample-counter", "start_sample": seq * 16,
                                 "rate": 16000, "samples": values[role],
                                 "tap": "speaker_final" if role == "ref" else role,
                                 "source": f"out-{seq}" if role == "uplink" else None})
    return {"id": session_id, "board": "same-demo-board", "traces": traces}


def main():
    gsm = constructed_session("demo-gsm")
    assert audit(gsm) == []
    print("baseline: sample records correspond (AEC performance NOT_TESTED)")
    voip = constructed_session("demo-voip")
    for frame in voip["traces"]["ref"]:
        frame["tap"] = "before_volume"
        frame["samples"] = [v // 2 for v in frame["samples"]]
    assert gsm["board"] == voip["board"]
    assert audit(voip) == ["REFERENCE_BYTES_DIFFER", "REFERENCE_TAP_NOT_FINAL_PLAYBACK"]
    print("same board/different reference: REFERENCE_BYTES_DIFFER, REFERENCE_TAP_NOT_FINAL_PLAYBACK")
    shifted = constructed_session("demo-shift")
    for frame in shifted["traces"]["ref"]:
        frame["start_sample"] += 16
    assert audit(shifted) == ["REFERENCE_SAMPLE_WINDOW_DIFFERS"]
    print("same values/different source window: REFERENCE_SAMPLE_WINDOW_DIFFERS")
    bypass = constructed_session("demo-bypass")
    for sent, mic in zip(bypass["traces"]["uplink"], bypass["traces"]["mic"]):
        sent["source"], sent["samples"] = mic["id"], mic["samples"].copy()
    assert audit(bypass) == ["UPLINK_NOT_AEC_OUTPUT"]
    print("constructed out differs from mic/but mic sent: UPLINK_NOT_AEC_OUTPUT")
    for role in ("ref", "uplink"):
        missing = constructed_session("demo-missing")
        del missing["traces"][role]
        assert audit(missing) == ["MISSING:" + role]
        print(f"missing {role}: comparison withheld")
    uncovered = constructed_session("demo-uncovered")
    uncovered["traces"]["ref"].pop()
    assert audit(uncovered) == ["FRAME_COVERAGE_DIFFERS"]
    print("missing frame sequence: FRAME_COVERAGE_DIFFERS")
    crossed = constructed_session("demo-cross")
    crossed["traces"]["ref"][0]["session"] = "old-session"
    assert audit(crossed) == ["SESSION_ID_MISMATCH"]
    clocked = deepcopy(gsm)
    clocked["traces"]["ref"][0]["clock"] = "another-clock"
    assert audit(clocked) == ["TIMELINE_CLOCK_MISMATCH"]
    print("old session or another clock: do not join records")
    wrong_rate = deepcopy(gsm)
    wrong_rate["traces"]["ref"][0]["rate"] = 8000
    assert audit(wrong_rate) == ["PCM_FORMAT_OR_LENGTH_DIFFERS"]
    print("unconverted 8k reference/16k playback: PCM_FORMAT_OR_LENGTH_DIFFERS")
    duplicated = deepcopy(gsm)
    duplicated["traces"]["ref"].append(duplicated["traces"]["ref"][0])
    try:
        audit(duplicated)
    except ValueError:
        print("duplicate sequence: REJECTED")
    else:
        raise AssertionError("duplicate record accepted")
    print("PASS: identity, input pairing and uplink-source assertions")


if __name__ == "__main__":
    main()
2026 年 10 月 13 日,本地实际运行 exit 0,stdout 为:
text
baseline: sample records correspond (AEC performance NOT_TESTED)
same board/different reference: REFERENCE_BYTES_DIFFER, REFERENCE_TAP_NOT_FINAL_PLAYBACK
same values/different source window: REFERENCE_SAMPLE_WINDOW_DIFFERS
constructed out differs from mic/but mic sent: UPLINK_NOT_AEC_OUTPUT
missing ref: comparison withheld
missing uplink: comparison withheld
missing frame sequence: FRAME_COVERAGE_DIFFERS
old session or another clock: do not join records
unconverted 8k reference/16k playback: PCM_FORMAT_OR_LENGTH_DIFFERS
duplicate sequence: REJECTED
PASS: identity, input pairing and uplink-source assertions
baseline 一行只表示样例记录能够对应,明确写着 AEC performance NOT_TESTED。参考来自本例声明的 speaker_final 取点,样本值与播放记录相同;上行来源指向 out 的帧身份且内容相同。检查的都是记录关系,没有听审结果、声学反馈路径、远端回录或真实设备输出,因此它不能让工程师宣布 GSM 已消回声。
同板不同参考组把板卡字段保持相同,参考改为音量处理前的取点、样本值减半。程序得到参考内容不同和取点不同两条线索。同一硬件没有变,但送到算法前的事实已变;这是原始对照表要捕获的差异。实际算法可能允许明确设计的前音量参考或增益补偿,本例只按"最终播放参考"这个声明合同核对,不裁决所有其他取点都错误。
样本值一样,也可能不是同一个时间窗口
偏移组保留参考值不变,只改变 start_sample,结果是 REFERENCE_SAMPLE_WINDOW_DIFFERS。start_sample 在此表示记录内容的源样本起点,clock 是统一的样本计数域;不是函数返回时间,也不是麦克风回声的实测声学传播时间。脚本只指出源窗口差异,不建议补偿多少毫秒,也不会自动移位音频。
真正的时序核对首先要定义每路时间戳的边界。如果参考记的是排队时间、播放记的是提交时间、麦克风记的是采样时间,直接相减可能混入不同含义。先记录这些映射,再在目标管线检查参考与近端帧如何关联;有已声明的补偿或缓存时也要保存。一个常量偏移可能是配置的一部分,不能仅凭本例标签就说 AEC 失效。
旧会话参考和另一时钟分别被标出。逐帧序号相同,不代表跨两次通话的样本同源;两个计数器的值相等,也不代表同一时间点。HFP 重连、播放器重启或音频格式变化后,应重新确认会话边界与计数域,不能把前后的帧接成一条看似完整的曲线。这一步取得的是配对资格,不是通话质量结论。
out 看起来更干净,为什么还要检查上行
旁路组保留预设的 out,却让 uplink 的 source 和样本都来自 mic,检查返回 UPLINK_NOT_AEC_OUTPUT。它复现的是一个数据流错误形态:查看处理输出很容易觉得已经改善,但真正发出去的可能是另一份音频。由于 out 只是构造值,这里没有证明回声被减少;它证明在这组记录中,上行没使用声明的处理输出。
检查同时看帧来源身份与内容。安静帧的不同来源可能恰好都是零,单靠波形相同不一定能确认调用链;反过来,真实上行可能在 out 之后有合法编码或重采样,字节自然不会相同。接入实际项目时,应按那个转换边界建立可核对的映射,而不是把本例 PCM 列表相等直接当作任意编码流的一致性证明。
缺 ref 或缺 uplink 时,脚本暂停比较,不用空数组当成静音,也不假定上行默认使用 out。丢掉某个序号则得到覆盖差异,重复序号直接拒绝。这些条件让故障样本能保留"仍不知道哪一段"的边界;它不妨碍先报告远端感知的失败,但不足以把责任分给 AEC 或手机 App。
8 kHz 与 16 kHz,先检查实际转换合同
最后一组把一条 reference 记录的 rate 改成 8000,其他记录仍为 16000,得到 PCM_FORMAT_OR_LENGTH_DIFFERS。这只是未做对应转换的构造输入,不表示两种采样率不能集成,也不证明 issue #213 两次电话使用了这个组合。真实管线若经过合法重采样,应在同一个算法入口口径下记录结果,并保留原 HFP 协商与转换关系。
维护者的 codec 猜测因此适合作为下一项要查的字段,而不是替现场补出的答案。报告者的 connected/8000 片段也需要绑定具体会话、当前组件版本与接收帧,不能让一段日志代表两种电话。拿不到 codec 时保留未知,先核已可观察的采样率、有效样本和取点,避免因一句"声音听着正常"就略过链路差异。
本例只审计字段完整的归一化记录,不是原始 HFP 日志解析器,也没有确定声学模型、ERLE、算法延迟或抑制强度。一次自检通过的交付是"这些源、窗口和上行关联被明确检查",随后仍要按原差分表取得配对录音与听审。与其立刻切换 VOIP 模式,不如先让第一次可见差异指向一个能继续取证的边界。
对照顺序要让下一次实验只回答一个问题
作者建议首先固定播放片段,分别建立两种会话内的远端单讲记录。近端保持不说话时,麦克风中的播放成分较容易与参考对应,能够先核查取点、连续性与输出使用。如果直接从双讲开始,回声和本地讲话同时变化,听感变差可能来自两个不同目标,很难据此安排下一步。先拆任务不是降低验收要求,而是让每个观察都有明确对象。
第二步再加入近端单讲,确认设备未播放时,上行链是否能保留本地人声。假设此时VoIP仍出现严重失真,应先查看AEC之外的上行表示、缓冲与通话路径,不能以"正在测试AEC"就忽略这些共同条件。该对照也不能证明双讲保真,只是为之后的失败提供一份近端声音基线。
第三步才将两端讲话重叠,并给近端发声一个独立标记。远端自己的声音是否被压低、本地人的句子是否可懂,分开保存和评价。如果最终录音变安静,但本地人声也消失,结果不应写为回声问题已修复。声学免提需要两端交流,单纯降低输出能量并不兑现这个目标。
对于音量实验,保留当前取点不变,仅改变设备真正播放的音量,并记录参考与麦克风幅度关系如何变化。如果一边改音量一边换参考位置,就无法解释改善来自哪一项。音量结果还需要在同一配置重复观察,不能根据一次较小的回声片段设立通用安全音量。空间位置、扬声器状态与输入内容都仍是结论条件。
对于时序实验,先确认时间戳代表同一种边界,再检查是否存在持续偏移、首帧缺口或运行中突变。假设只在首播时偏离,应回到播放器和参考缓冲启动;假设整个会话都有不同偏移,则另做固定路径的对照。两种观察不该统一归为"延迟太大",也不能直接从波形峰值差推导具体需要补偿的量。
对于模式实验,应记录创建参数、实际帧长与有效版本。只改UI选项但没有重新创建或实际应用配置,不构成两个模式的对照;是否必须重建实例取决于当前API,应先查锁定实现。没有可验证的配置变化,就把结果标为相同配置的重复运行,避免给未生效选项记一份虚假的效果差异。
每一次改动都保留原会话配置与失败片段,让复核者知道实验是在相同故障上验证候选,而不是不知不觉换到了更容易的输入。如果原目标条件仍失败,新的小音量或短片段结果可以作为定位线索,但不能替原场景签收。这个边界尤其适用于对外承诺"两类电话都可用"的设备。
"VoIP 通话"不自动等于切到 VOIP 模式
乐鑫 AEC 文档列出 SR、全双工 FD 和 VOIP 模式,VOIP 模式面向通话并支持 8/16 kHz;直接 API 示例还要求 int16_t 输入和明确的 mic/ref。这说明模式可以作为受控变量 ,不说明 WhatsApp 的 HFP 音频一定必须切换到某模式,也不说明报告者所用 ESP-SR、ESP-ADF 组合的实际 API 与 latest 文档完全一致。当前页面的 VOIP 模式表列出 8/16 kHz,直接 aec_create() 示例却注释"当前只支持 16000";模式适用表、具体调用接口和旧版 ADF 集成不能互相替代。因此要先记录当前版本、创建参数与 aec_get_chunksize() 返回值,核对实际接口支持,再确定是否能做合法的模式对照。
模式实验也要同时听近端说话。回声下降若以近端声音被压扁为代价,并不能称为可用;乐鑫文档明确提示更激进的非线性处理可能损伤近端语音。对于通话设备,远端单讲、近端单讲和双讲都应各自留样。资源占用、帧长和采样率需要按目标芯片及版本核对,不能直接搬用其他芯片的基准数字。
两种模式的结果,怎样形成可行动的结论
如果参考已经确认取自实际播放路径,也仍要核对其内容是否连续。播放队列有过欠载或补静音,AEC参考却继续提交原文件中的音频,就存在需要解释的差异;是否发生必须由本次记录证明。要保留设备真正输出的部分,而不是只附原始语音文件。否则复核者看到的是计划播放的内容,不是这次声学路径的条件。
如果现场无法取得某路数据,结论可以停在更宽的边界,例如"设备输入到最终上行之间存在差异,内部责任尚不能分段"。这比补猜codec或宣称App算法失效更有用:它明确告诉团队还缺哪个观察点。缺少材料也不妨碍先报告用户感知失败,只是不能把感知失败升级为内部根因。
完成修正后应回到原来那两类会话重新验证。只在离线固定PCM上改善,说明受控输入路径的变化值得采用,尚未证明实际HFP运行时的取点、时序和上行使用都正确。两类会话各保留完整记录,并检查近端语音是否仍可用,才有条件扩展设备承诺。测试失败仍可交付定位成果,没必要把"找到一个候选原因"包装成两类通话已经全部修好。
最终交给维护者或项目组的不是一句"GSM 好、WhatsApp 差",而是两次会话的固定配置、HFP 状态、成对 R/M/O 音频与时间戳、远端回录,以及只改变一个条件的复测结果。这些数据能把问题从 App 名称推进到可定位的信号分叉。公开 issue 目前没有提供这些数据;本文也没有对 ESP32-LyraT-Mini 做板卡实测,因此不宣布原因、修复或最终 AEC 效果。