当 AI 存储进入超大规模,架构会朝什么方向演进?
Meta 最近发布的《Meta's AI Storage Blueprint at Scale》提供了一个难得的参考样本。Meta 运营着总规模达数百 EB 级存储集群,文章重点介绍了其面向 AI 训练的 BLOB Storage 架构。
在这一规模下,数据访问路径上的延迟会被进一步放大:一次慢请求就可能让大量 GPU 等待,跨地域读取也会拖慢模型迭代。Meta 的应对思路可以概括为:简化元数据结构、缩短数据读取路径,并把缓存推近计算。
本文将选取 Meta 博客中的关键设计,梳理其 AI 存储架构的变化,再对照同样具备 EB 级生产实践的 JuiceFS 架构,希望为正在规划或建设大规模数据存储系统的团队提供架构参考。
01 为什么存储对 AI 工作负载如此重要
在深入讨论架构之前,我们有必要先理解:为什么存储已经成为 AI 基础设施中如此关键的一环。
Meta 用一句话概括得很直接:"如果 AI 是大脑,那么存储就是记忆。AI 的能力和速度,很大程度上取决于记忆容量以及数据读取速度。"
然而,AI 计算性能大约每两年就能提升三倍,而存储和互连性能的提升却要缓慢得多。这种增长速度上的差距,使存储瓶颈成为 AI 工作负载中导致 GPU 等待的主要因素之一,并直接影响基础设施成本以及模型的发布周期。
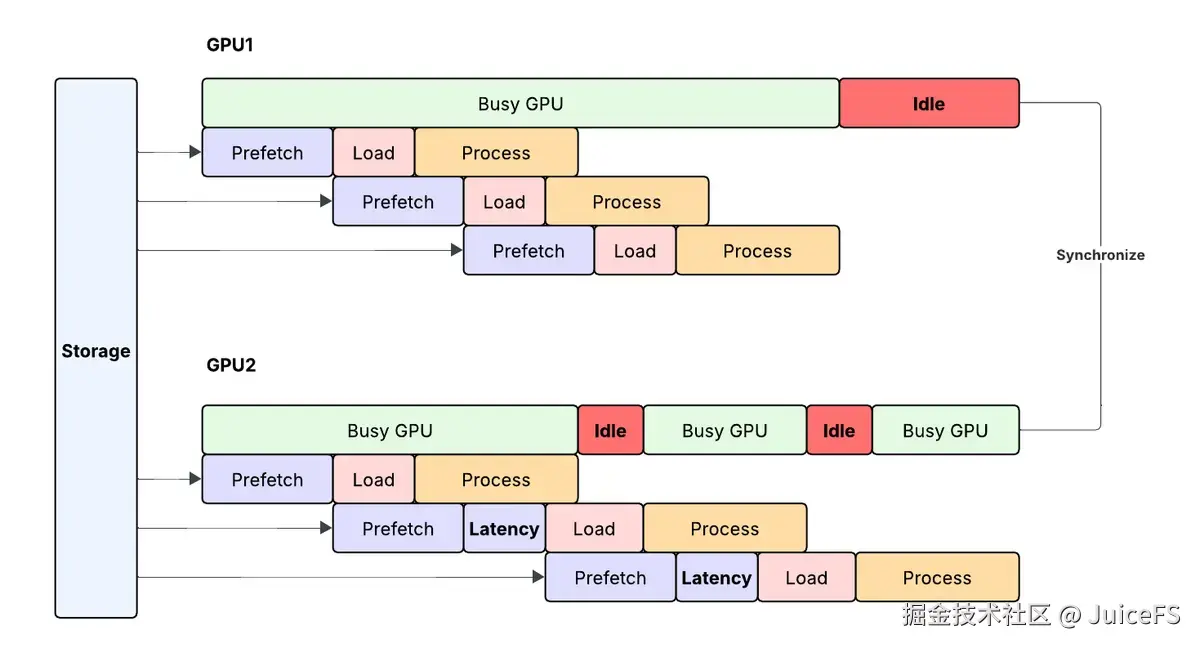
这种影响在大规模训练中会被迅速放大。模型训练过程中,数十万块 GPU 会在庞大的数据集上进行多轮迭代,并周期性同步状态。如果其中一块 GPU 因为存储速度过慢而停顿,整个训练任务都会被拖慢。Meta 在分享中提到,如果 GPU 大约有 20% 的时间处于空闲状态,那么对于一个规模相当于曼哈顿的数据中心来说:"20% 的停顿意味着每小时损失数千万美元。"
除了直接的经济成本之外,还有一个更加重要的因素:机会成本。AI 行业的发展速度前所未有。2020 至 2022 年间,大型模型的重要版本发布周期大约为 104 周;到 2026 年,这一周期已经压缩到约 4 周。前沿模型每推迟发布一周,都可能意味着市场份额流失、竞争优势削弱以及收入机会的错失。
简单来说,存储决定了一个模型是几周上线还是几个月上线,也决定了一个价值数十亿美元的数据中心究竟以 80% 还是接近 100% 的效率运行。
02 Meta AI 存储架构的演进
经过多轮存储基础设施迭代之后,Meta 逐渐形成了一套较为明确的架构方案,希望从根本上解决 GPU 因存储而停顿的问题,同时继续支撑现有的内外部产品。
在这套架构方案中,Meta 正在将训练技术栈的数据访问逐步统一到 BLOB Storage 接口。BLOB Storage 以对象为基本访问单位,可以减少传统目录层级解析和多次元数据查询带来的尾延迟。AI 工作负载需要可预测并且具有明确上界的 pMax 延迟,而传统的分层元数据查询每次请求可能额外增加数百毫秒,从而导致训练过程中 GPU 等待。通过这一调整,Meta 可以充分利用 Flash,为成千上万块 GPU 提供足够低且稳定可预测的延迟。
三大核心组件
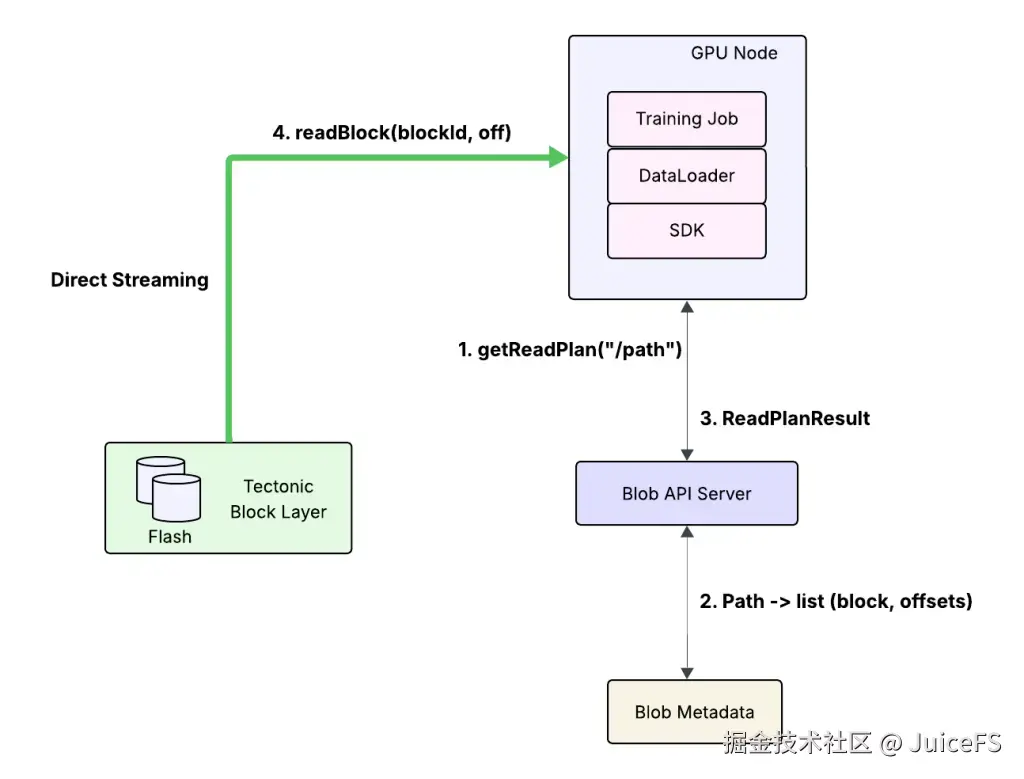
下图展示了 Meta BLOB Storage getObject API 的请求流程,以及整个系统的三大核心组件。
-
Tectonic 数据存储层:最底层是 Tectonic。Tectonic 是一个区域级、多租户的存储基础设施,通过纠删码提供高可靠性和高可用性。它支持 HDD 和 Flash 之间的多级存储,并能够根据数据冷热程度智能管理热数据、温数据和冷数据的放置。
-
BLOB Server 与元数据层:BLOB 层构建在 Tectonic 之上,负责处理 API 请求、存储元数据,并对外提供一个全局的、可无限扩展的存储架构;同时通过策略配置允许用户在持久性与可用性之间进行权衡,并隐藏底层块存储的复杂性。
-
富客户端 SDK:Meta 移除了数据平面的代理层,并构建了一个富客户端 SDK。SDK 内部直接嵌入 Tectonic BlockClient,因此客户端可以直接从 Tectonic 存储服务器读取数据。客户端还实现了 Hedged Reads(对冲读取)和动态并发控制,以进一步降低尾延迟。
为了最大化缓存效率,Meta 还利用 GPU 主机上的空闲内存用作分布式数据缓存,具体做法是将 Owl 子系统中的对等节点直接集成进 BLOB Storage 客户端 SDK,从而实现平均 80% 的缓存命中率。
通过多级缓存实现跨地域数据访问
Meta 的跨地域方案,本质上是将存储视为一个全局数据湖,同时利用多级缓存加速跨地域访问。
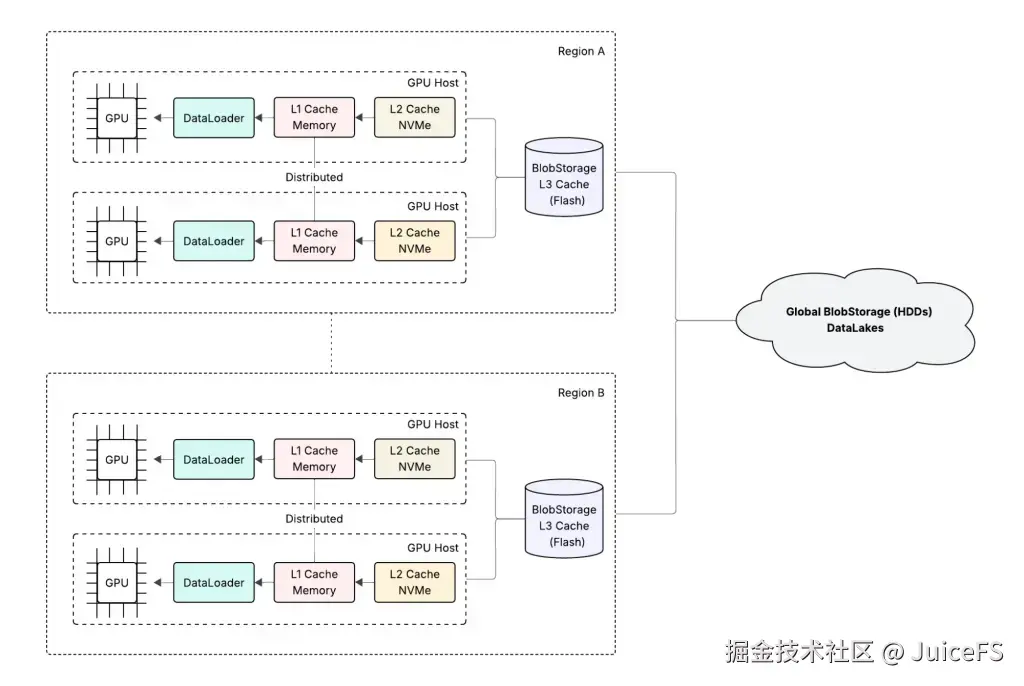
| 缓存层级 | 位置 | 作用 |
|---|---|---|
| L1 Cache | GPU 主机内存(RAM) | 缓存最热、访问最频繁的数据 |
| L2 Cache | GPU 主机 Flash(SSD) | 本地 Flash 层,用于温数据 |
| L3 Cache | 区域级、基于 Flash 的 BLOB Storage | 在回源到全局 BLOB Storage 之前提供区域缓存 |
采用多级缓存后,实际效果非常明显:平均数据加载时间下降 93%,最差情况下的数据加载时间下降 97%。这正是存储从 AI 系统的瓶颈,转变为提升 AI 研究效率的基础设施之后所带来的变化。
这些并不是全新的存储原理。**早在 AI 训练成为主流负载之前,JuiceFS 就已将对象存储、独立元数据引擎以及客户端缓存与预取组合在一套架构中。**如今,随着训练集群和数据规模持续扩大,这些设计开始更直接地影响 GPU 利用率和训练效率。
03 JuiceFS 的云原生架构及其 AI 场景适配
JuiceFS 的整体架构由对象存储、元数据引擎和客户端三个核心部分组成。
-
对象存储:JuiceFS 使用对象存储作为可靠、可扩展的数据存储后端。它支持主流公有云对象存储,包括 AWS S3、Alibaba OSS、Google Cloud Storage 等,同时也支持 Ceph、MinIO 等自建存储。这一层用于确保规模达到 PB 甚至 EB 级的 AI 数据集能够可靠保存、持续访问,并近乎不受容量限制地扩展。
-
元数据引擎 :元数据引擎负责存储所有文件系统元数据,包括文件名、文件大小、权限、目录结构,以及文件与底层数据块之间的映射关系。JuiceFS 支持多种元数据引擎,包括 Redis、MySQL、PostgreSQL、TiKV 等。针对超大规模部署,JuiceFS 企业版还提供自研、基于 Raft 的分布式元数据引擎,在多节点环境下提供高可用和强一致性。
-
JuiceFS 客户端:JuiceFS 客户端负责全部文件 I/O 逻辑,包括数据切片、数据合并、缓存和 POSIX 语义。客户端会同时直接与元数据引擎和对象存储通信,并协调完成数据读写。
跨地域策略:镜像与复制
JuiceFS 企业版原生支持跨地域、跨云的数据访问。
-
镜像文件系统:可以在镜像地域部署一套完整的元数据集群,并根据需要部署对象存储副本。在正常网络环境下,源地域的元数据会自动同步到镜像地域,同步延迟约为 1 秒。
-
异步数据复制:JuiceFS 支持跨地域和跨云的异步数据复制,并支持一对多拓扑。主地域写入的数据可以在后台自动复制到多个镜像地域,从而构建全球数据集,而不需要人工复制。
-
分布式缓存:部署在各挂载主机上的 JuiceFS 客户端,可以基于一致性哈希环组成一个分布式缓存组,彼此共享已经缓存的数据块。这一机制尤其适合模型训练场景,因为同一份训练数据通常会被多个 GPU 节点反复访问。
-
智能读取策略:客户端会优先从本地域读取数据。如果数据尚未完成同步,则可以自动回退到源地域读取。
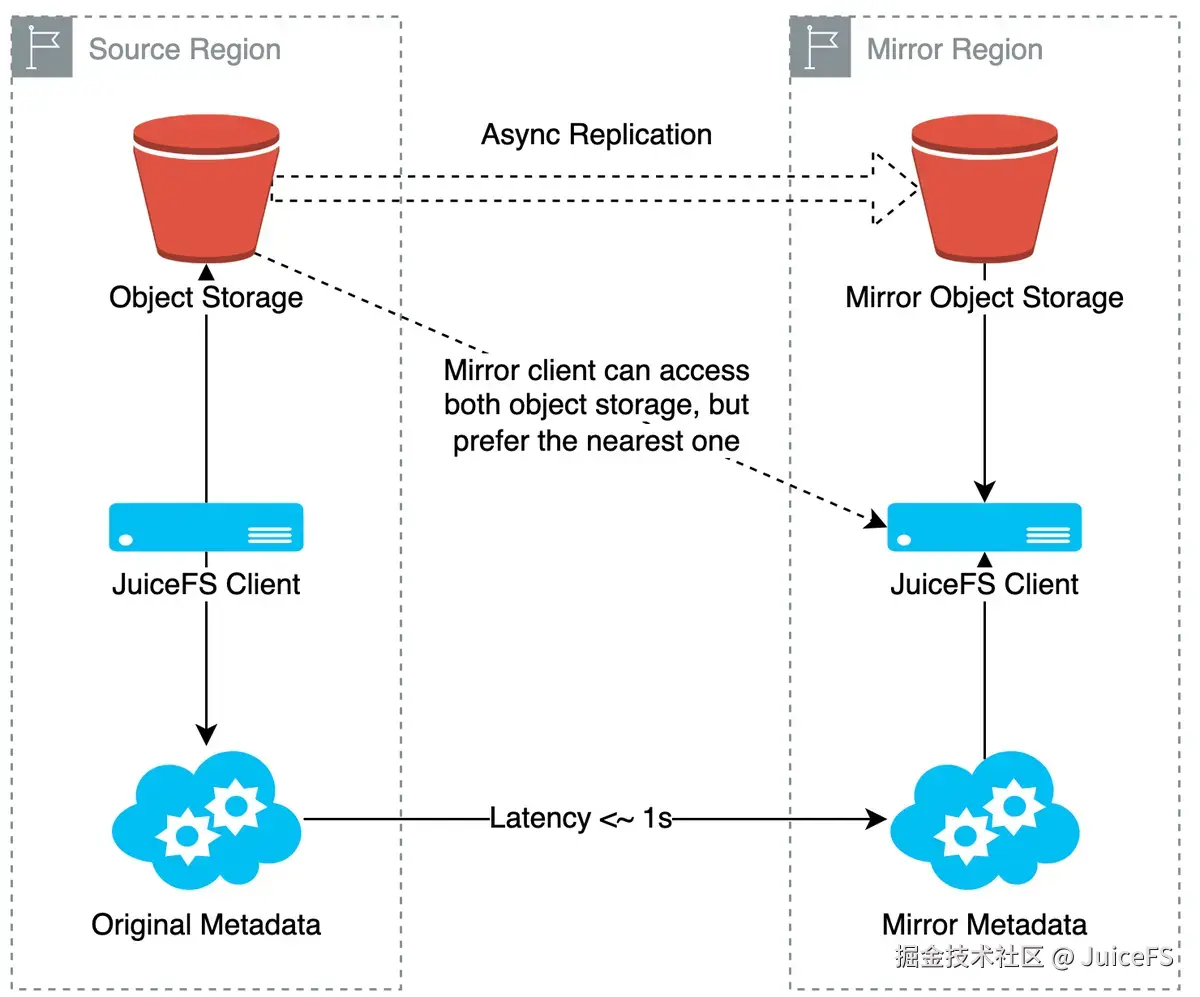
这一设计与 Meta 的"全局数据湖 + 多级缓存"方案不谋而合。不同之处在于,JuiceFS 通过镜像文件系统、异步复制和分布式缓存,支持公有云、私有数据中心及混合云等不同部署环境。
04 架构上的相似之处
Meta 主要提供 BLOB 风格的访问接口,而 JuiceFS 主要提供 POSIX 文件系统接口。但如果抛开协议层的不同,两者在底层架构上的相似之处非常明显。两个系统都采用了类似的三部分架构,同时具备完善的缓存体系和跨地域能力:
| 维度 | Meta BLOB Storage | JuiceFS |
|---|---|---|
| 数据存储层 | Tectonic:区域级块存储基础设施,采用纠删码,并支持 HDD / Flash 分层 | 对象存储:S3、OSS、GCS、Ceph、MinIO 等 |
| 元数据层 | 统一元数据方案,基于 ZippyDB,实现 O(1) Chunk 查询 | 元数据引擎:Redis、MySQL、PostgreSQL、TiKV、JuiceFS 自研元数据引擎 |
| 富客户端 | "Fat Client SDK",内嵌 Tectonic BlockClient,直接从存储服务器流式读取 | JuiceFS Client:处理全部 I/O、切片、合并和缓存;支持 FUSE、POSIX、Hadoop SDK、CSI、S3 Gateway |
| 分布式缓存 | 多级缓存 | 内存 + 本地缓存 + 分布式缓存组 |
| 跨地域 | 多级缓存 + 全局 BLOB Storage 数据湖 | 主地域 + 镜像文件系统 |
一个例子:缓存预热
一个很有意思的例子,是两套系统如何进行主动缓存预热------也就是在数据真正被使用之前,提前将其加载进缓存。
Meta 在 BLOB Storage SDK 中提供了 prefetch() API,而 JuiceFS 提供了 warmup 子命令。两者解决的是同一个问题:让客户端明确告诉存储系统接下来将访问哪些数据,从而在 GPU 完成当前计算之前,提前将这些数据加载到缓存。
这对于分布式训练尤其重要。当数千块 GPU 同时读取同一个数据集时,如果没有缓存预热,最初的一批请求都需要直接访问底层存储:Meta 对应 Tectonic,JuiceFS 对应对象存储,因此会带来更高的访问延迟。通过 prefetch() 或 juicefs warmup ,可以在 GPU 真正需要数据之前,提前将数据放入分布式缓存。从本质上来说,两套系统都认识到了网络存储和被动缓存自身存在的局限性,因此都提供了显式预取/预读机制,以弥补底层存储在冷读延迟上的不足。
05 结语
Meta 的 AI 存储架构展示了超大规模互联网公司将数据基础设施扩展到数百 EB 后形成的一种架构模式。从两套系统的设计来看,Meta BLOB Storage 与 JuiceFS 在若干关键方面呈现出明显共性:数据与元数据分离、由富客户端处理 I/O 逻辑、多级缓存以及跨地域能力。
这种架构模式并不只适用于超大规模公司。JuiceFS 通过对象存储、可选元数据引擎、分布式缓存和跨地域镜像等组件,将类似设计用于大数据与 AI 场景,并支持多云环境和多种访问协议。
对于 AI 训练系统而言,核心目标是让存储不再成为限制 GPU 利用率和模型迭代速度的瓶颈。
我们希望本文中的一些实践经验,能为正在面临类似问题的开发者提供参考,如果有其他疑问欢迎加入 JuiceFS 社区与大家共同交流。