一句话理解: CLIP 不直接学习"图片属于哪个固定类别",而是学习"哪段文本最匹配这张图片"。只要把这种匹配能力训练到足够强,就能获得可迁移的视觉-语言表示。
为什么 CLIP 要换一种训练方式?
传统监督分类通常把视觉任务写成"图片 → 类别 ID"。这种方式在封闭数据集里很有效,但类别空间是预先固定的:模型训练时没有见过的类别,通常无法直接作为新的输出类别使用。 CLIP 把监督信号从类别标签换成自然语言。它使用大量图像-文本对进行预训练,让模型学习"图像语义"和"文本语义"之间的对应关系。这样一来,文本就不再只是类别名字,而是一个可以自由描述概念的语义接口。
双塔结构:图像和文本先分别编码
CLIP 是典型的 Dual Encoder(双塔)结构。图像经过 Image Encoder,文本经过 Text Encoder,两侧互不共享主干;直到得到最终向量后,才在同一个特征空间中比较相似度。 图像侧在原始 CLIP 中可以使用 ResNet 或 Vision Transformer;文本侧使用 Transformer。无论内部结构如何,两侧最终都需要输出相同维度的向量,才能进行点积或余弦相似度计算。 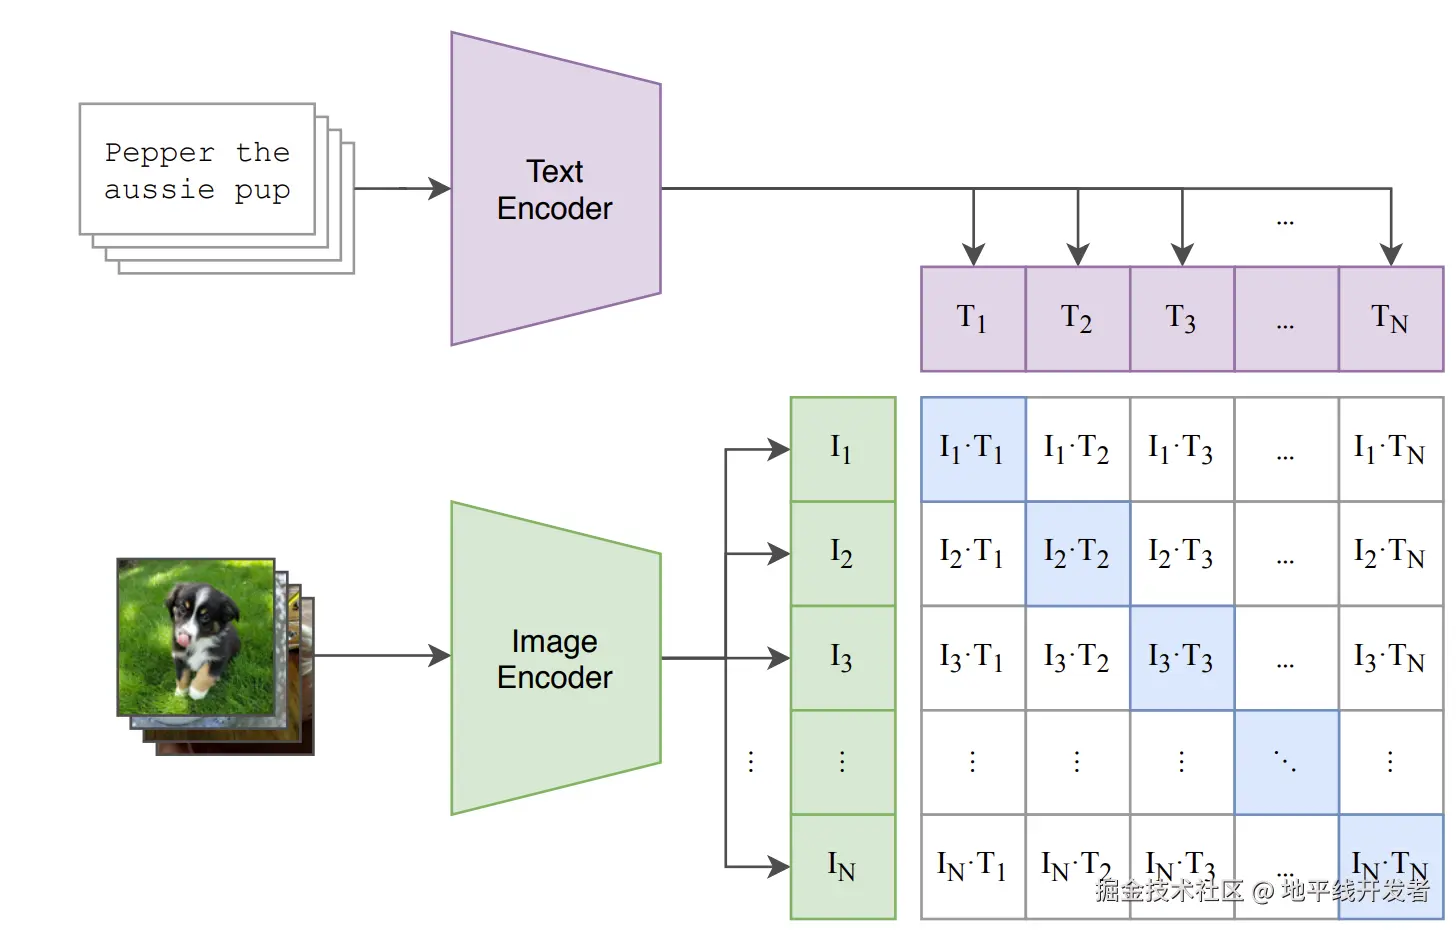 这里有一个很重要的区别:CLIP 的核心是"(Alignment)",不是把图像特征和文本特征在网络中反复交互融合。这个差异也是 CLIP 与后续生成式视觉语言模型的重要分界。
一个 Batch 如何变成对比学习任务?
假设一个 Batch 中有 N 组正确图文对:
css
(I₁,T₁), (I₂,T₂), ..., (Iₙ,Tₙ)经过两个 Encoder 后,得到 N 个图像向量和 N 个文本向量。CLIP 不只计算每个样本自己的配对,而是计算 Batch 内所有图片和所有文本的两两相似度,因此会自然得到一个 N×N 的矩阵。 其中,对角线上的 (Iᵢ,Tᵢ) 是已知正确配对;同一行或同一列中的其他组合暂时都被当作负样本。于是,一个 Batch 本身就同时提供了正样本和大量负样本。
为什么要做 L2 归一化?
L2 归一化的作用,就是把不同特征向量的长度统一起来,使后续比较主要反映它们在共享语义空间中的方向关系。如图所示,原始特征同时包含"长度 + 方向"信息,而归一化后的特征则只保留方向信息。因此,CLIP 后续的相似度计算本质上更接近于比较图像和文本特征的语义方向是否一致。 换句话说,L2 归一化使得 CLIP 的相似度计算从"比较大小"转向"比较方向",从而更稳定地完成图文对齐。 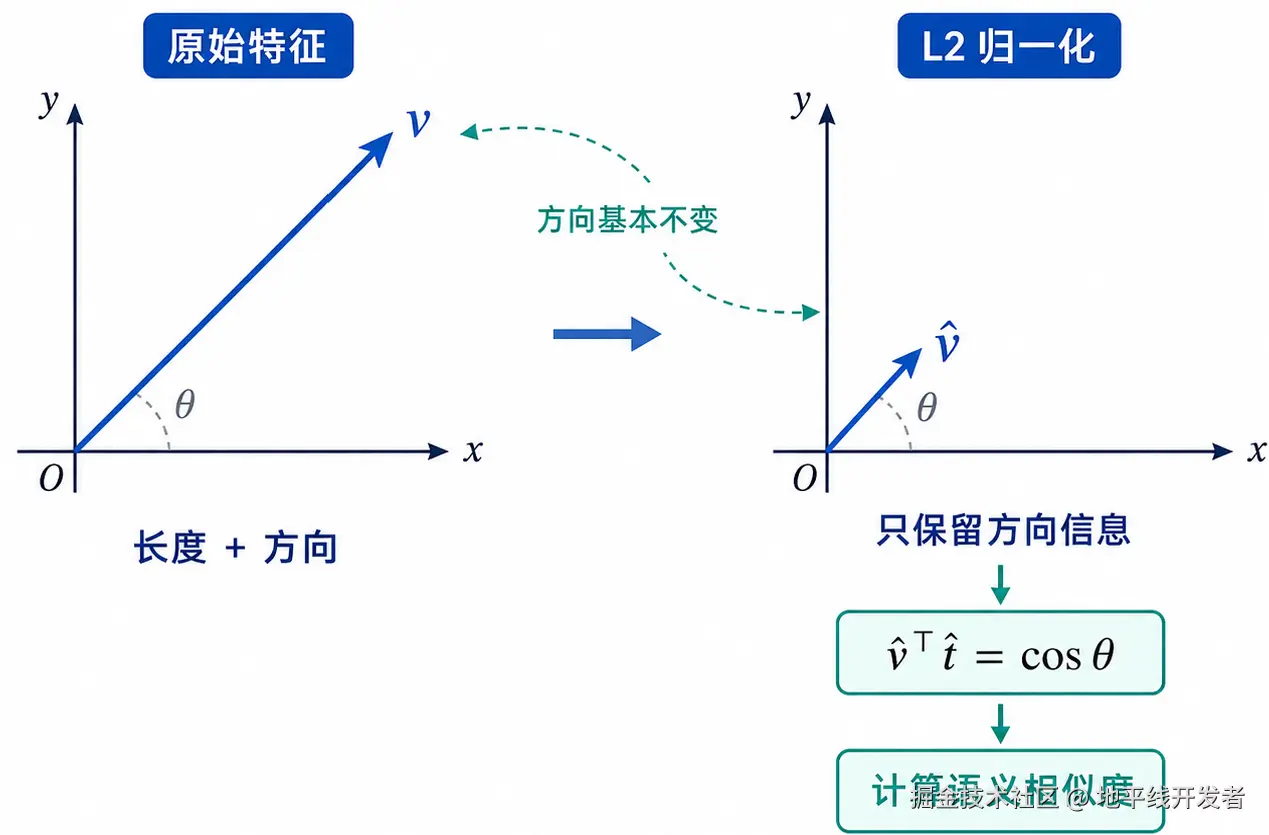
Temperature:让相似度差异更"尖锐"
余弦相似度通常落在较有限的范围内,如果直接送进 Softmax,正确文本和相似错误文本之间的概率差距可能不够明显。CLIP 因此引入温度系数 τ,对 logits 进行缩放:
scss
Sᵢⱼ = (v̂ᵢᵀ t̂ⱼ) / ττ 越小,Softmax 分布越尖锐,模型会更强烈地区分"最匹配"和"次匹配"的样本。官方实现中通常把对应的 logit_scale 设为可学习参数,让模型自己调整合适的缩放程度。
CLIP Loss:为什么要做双向训练?
相似度矩阵构建完成后,CLIP 同时从两个方向优化。第一个方向是 Image → Text:给定一张图片,从当前 Batch 的 N 段文本中找出正确文本;第二个方向是 Text → Image:给定一段文本,从 N 张图片中找出正确图片。
scss
Image → Text:把相似度矩阵的每一行看成一个 N 分类问题
Text → Image:把相似度矩阵的每一列看成一个 N 分类问题
两个方向分别计算 Cross Entropy,再求平均:
arduino
L_CLIP = 1/2 × (L_image→text + L_text→image)这种对称设计可以避免只优化单方向检索,使图像和文本两侧都被约束到同一个共享空间中。
为什么大 Batch 对 CLIP 很重要?
CLIP 的负样本主要来自当前 Batch。Batch 越大,每张图片同时需要区分的文本越多,反之亦然。例如 Batch Size=32 时,一张图片只有 31 个 Batch 内负样本;Batch Size=4096 时,候选负样本数量会大幅增加。 这会让训练任务变难,但也迫使模型学到更有区分性的语义表示。因此,大规模对比学习经常与多卡分布式训练、跨卡特征聚合(all-gather)一起出现。工程上,Global Batch Size 往往比单卡 Batch Size 更值得关注。
核心代码:CLIP Forward 其实并不复杂
把很多工程细节拿掉,CLIP 前向计算最核心的部分就是:两侧编码、归一化、矩阵乘法。
ini
image_features = image_encoder(images)
text_features  = text_encoder(texts)

image_features = image_features / image_features.norm(dim=-1, keepdim=True)
text_features  = text_features  / text_features.norm(dim=-1, keepdim=True)

logits = logit_scale.exp() * image_features @ text_features.T
这里的 logits 形状是 N, N。第 i 行表示第 i 张图片与 Batch 内所有文本的匹配分数;第 j 列则表示第 j 段文本与所有图片的匹配分数。 训练阶段的 Loss 也非常直接:
ini
labels = torch.arange(batch_size, device=logits.device)

loss_i = F.cross_entropy(logits, labels)
loss_t = F.cross_entropy(logits.T, labels)

loss = (loss_i + loss_t) / 2
labels = 0,1,2,...,N-1 的含义就是:Image 0 应该匹配 Text 0,Image 1 应该匹配 Text 1,以此类推。
对齐之后,模型到底学到了什么?
经过大量图文对训练后,CLIP 会逐渐形成一个共享语义空间。与"dog"相关的图片,会靠近 "a photo of a dog"、"golden retriever"、"a puppy running" 等语义相近的文本;汽车、飞机、植物等概念则会形成其他语义区域。 因此,CLIP 真正学习的并不是一个固定类别表,而是"视觉概念 ↔ 语言概念"的可比较表示。这也是它后续能够进行 Zero-shot 分类、图文检索和 Prompt-based 分类的基础。
总结
• CLIP 用双塔结构分别编码图像和文本,最终映射到同一个特征空间。 • 一个包含 N 个图文对的 Batch 会形成 N×N 相似度矩阵,对角线为正样本。 • L2 归一化让特征比较主要体现方向差异,Temperature 控制 Softmax 的区分强度。 • Image→Text 与 Text→Image 两个方向共同计算对比损失,完成双向语义对齐。 • 大 Batch 能提供更多 Batch 内负样本,是 CLIP 大规模对比学习的重要组成部分。 • 最终学到的共享语义空间,是 CLIP Zero-shot、Prompt 和迁移能力的基础。