摘要:本文围绕 SPMI(System Power Management Interface)总线协议,带你从零走完一条完整的 RTL 开发链路:先拆解协议核心概念与硬件架构,再搭建仿真工具链,随后依次实现 Master 端状态机、Slave 端寄存器映射与响应机制,并处理总线仲裁与时序约束,最后在 FPGA 上完成功能验证、排查常见报错,并延伸到低功耗控制、SoC 集成与性能优化。全文以可落地的代码片段和调试技巧为主线,适合负责电源管理模块的嵌入式工程师与 FPGA 开发者按顺序跟做。
关键词:SPMI;电源管理;PMIC;RTL 设计;SystemVerilog;状态机;总线仲裁;时序约束;FPGA 验证;低功耗控制;SoC 集成
阅读建议:如果你只想快速上手,可先看第 ②、③、⑥ 节跑通最小可仿真链路,再回头补齐协议细节;如果你正在做集成,重点看第 ⑤、⑨ 节。
基础准备
在动手写 RTL 之前,先确认以下前置知识与环境,能帮你少踩很多坑。
知识基础
- 数字电路与 Verilog/SystemVerilog 基础:理解时序逻辑、状态机、阻塞与非阻塞赋值。
- 总线协议常识:了解 I2C 或 APB 的基本时序概念,SPMI 的很多设计思路与之相通。
- 基本仿真流程:会写 testbench、会看波形、会跑仿真脚本。
环境与工具
- 仿真器:VCS、ModelSim 或 Verilator(开源可选)。
- 波形工具:Verdi、GTKWave 等,用于观察 SCLK/SDATA 时序。
- 综合与实现:Vivado 或 Quartus,用于后续 FPGA 上板验证。
- 辅助脚本:Python 或 C++ 编写测试激励生成器,提升验证效率。
术语速查
| 术语 | 含义 |
|---|---|
| SPMI | 系统电源管理接口,双线串行总线协议 |
| PMIC | 电源管理芯片,通常作为 Slave 端 |
| USID | 从设备唯一标识,用于寻址 |
| Master / Slave | 主控端 / 从设备端 |
| SVA | SystemVerilog 断言,用于协议规则检查 |
准备好这些之后,就可以从第 ① 节开始,逐步进入 SPMI 的协议世界了。
在复杂的片上系统(SoC)设计中,电源管理往往是决定芯片稳定性与能效比的关键环节。许多工程师在初期验证时,常常遇到电源域状态不同步、电压调节响应延迟甚至死锁的问题,这些隐患若流片后才暴露,将带来巨大的成本损失。SPMI(System Power Management Interface)作为连接应用处理器与电源管理芯片(PMIC)的标准串行总线协议,其高效性与可靠性直接决定了整个系统的电源调度能力。然而,由于该协议涉及严格的状态机跳转、时序约束以及多主仲裁机制,很多开发者在从理论文档转向 RTL 实现时容易陷入细节陷阱,导致仿真波形异常或综合报错频发。
本文将深入 SPMI 协议的底层逻辑,从硬件架构解析出发,逐步引导你完成从环境搭建到 FPGA 验证的全流程。无论你是正在负责电源管理模块的嵌入式工程师,还是希望深入理解总线协议细节的 FPGA 开发者,都能从中找到解决实际痛点的方案。我们将避开枯燥的协议条文堆砌,转而聚焦于可落地的代码实现、调试技巧以及集成策略,帮助你构建一个稳定、低功耗且易于扩展的 SPMI 通信系统。接下来的内容将严格按照开发逻辑推进,从核心概念拆解到最终的性能优化,确保每一步都有据可依、有码可参。
① SPMI 协议核心概念与硬件架构解析
在动手写第一行 RTL 之前,先把 SPMI 的"骨架"看清楚,后面所有的状态机、寄存器映射和时序约束才有落脚点。这一节我们从协议定位讲起,逐层拆到硬件模块,帮你建立一张完整的"地图"。
1.1 SPMI 是什么,为什么不用 I2C
SPMI 协议本质上是一种双线串行总线,专为高速、低引脚数的电源管理通信而设计。与传统 I2C 不同,SPMI 采用了更严格的时序控制和专用的命令集,支持单主多从或多主多从的拓扑结构。其物理层仅包含两根信号线:SCLK(时钟)和 SDATA(数据),但在逻辑层上却实现了复杂的事务处理机制。
对新手来说,最容易混淆的就是"既然都是两根线,为什么不直接用 I2C"。关键差异有三点:
- 速率与确定性:SPMI 最高可达 50MHz,且对每个事务的时序长度有明确规定,便于硬件做确定性调度;I2C 的时钟拉伸机制在电源管理场景下反而会引入不确定性。
- 多主仲裁:SPMI 原生支持多主仲裁,允许多个主控竞争总线,这在多核 SoC 中非常常见。
- 命令集专用:SPMI 定义了读、写、状态轮询、扩展命令等专用事务类型,直接对应电源管理的典型操作,不需要像 I2C 那样靠寄存器约定来"拼"语义。
1.2 协议分层:从物理层到事务层
理解 SPMI 的核心,在于掌握其"通道"与"所有者 ID"的概念。每个连接到总线上的设备都被分配一个唯一的 USID(Unique Slave ID),而主控端通过特定的命令帧来寻址目标从设备。为了便于实现,可以把协议拆成三层来看:
| 层级 | 关注点 | 对应 RTL 模块 |
|---|---|---|
| 物理层 | SCLK/SDATA 电平、采样边沿、线与逻辑 | 引脚驱动、IOBUF、采样寄存器 |
| 链路层 | 起始/停止条件、位同步、仲裁检测 | 位计数器、仲裁比较逻辑 |
| 事务层 | 命令帧解析、地址匹配、CRC 校验 | 命令解码器、寄存器映射、CRC 单元 |
新手常见的问题是"一上来就写状态机",结果物理层的采样边沿没对齐,波形上全是毛刺。建议按上表自下而上推进:先把引脚和采样做对,再谈事务。
1.3 命令帧结构拆解
一条完整的 SPMI 事务由若干字段拼接而成,顺序固定,不能随意调换:
text
| 起始 | 命令头(操作码 + USID) | 地址 | 数据(可选) | CRC | 停止 |- 起始条件:由主控拉低 SDATA 并保持 SCLK 高电平产生,标志一次事务开始。
- 命令头:包含操作类型(读/写/轮询/扩展)和从设备地址,是 Slave 判断"这条命令是不是给我的"的依据。
- 地址字段:指向 PMIC 内部的具体寄存器偏移。
- 数据字段:写操作携带待写数据,读操作由 Slave 回填。
- CRC 校验:用于检测传输错误,硬件需实现对应的多项式计算。
在硬件架构层面,SPMI 控制器通常由发送 FIFO、接收 FIFO、状态机以及仲裁逻辑组成。数据以字节为单位传输,但命令帧的结构包含了操作码、地址信息以及校验位,这要求硬件必须具备精确的位操作能力。
1.4 四种基本事务类型对比
协议定义了四种基本事务类型:写、读、状态轮询以及扩展命令,每种事务对应的时序长度和数据流向各不相同,设计时需根据具体应用场景选择合适的交易模式,以避免总线拥塞。
| 事务类型 | 数据流向 | 典型用途 | 实现要点 |
|---|---|---|---|
| 写(Write) | Master → Slave | 配置电压阈值、使能开关 | 数据方向固定,无需切换三态 |
| 读(Read) | Slave → Master | 回读寄存器状态 | 需处理总线方向切换的周转周期 |
| 状态轮询 | Slave → Master | 查询 PMIC 就绪/告警 | 帧短、频率高,注意总线占用 |
| 扩展命令 | 双向 | 厂商自定义功能 | 需预留解码分支,避免误判 |
特别需要注意的是,SPMI 支持广播命令,允许主控同时向多个从设备发送指令,这对于系统级的全局电源状态切换至关重要。广播地址是一个保留的 USID,Slave 在解码时需要优先匹配广播地址,再匹配自身 USID。
1.5 硬件架构模块拆解
把上面的协议要素落到硬件上,一个最小可用的 SPMI 控制器大致包含以下模块:
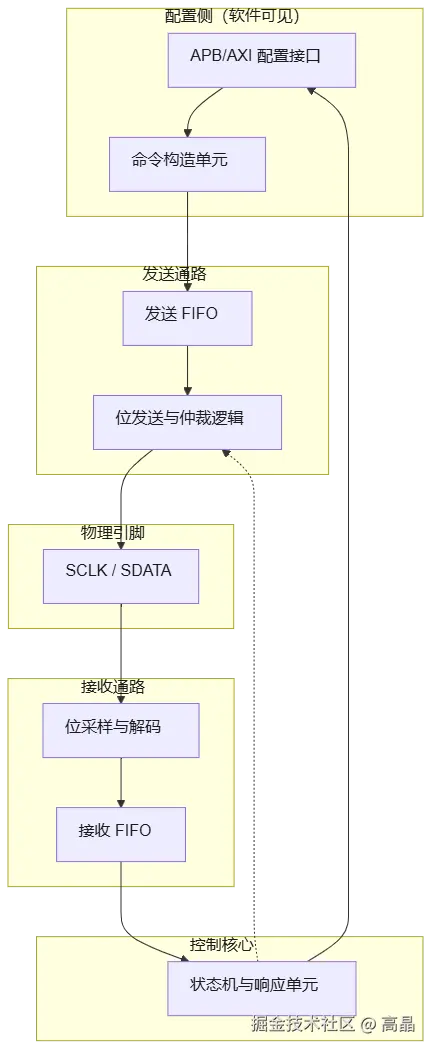
- 命令构造单元:把软件写入的配置转换成符合协议格式的命令帧。
- 发送/接收 FIFO:解耦软件配置速率与总线传输速率,避免阻塞。
- 位发送与仲裁逻辑:逐位驱动总线,并在每个位周期比较发送值与总线实际值,检测仲裁丢失。
- 状态机与响应单元:作为 Slave 时负责地址匹配与应答,作为 Master 时负责事务流程推进。
各模块的职责与关键信号可以对照下表理解:
| 模块 | 所属通路 | 核心职责 | 关键信号 |
|---|---|---|---|
| APB/AXI 配置接口 | 配置侧 | 接收 CPU 下发的命令与寄存器配置 | cfg_addr、cfg_wdata、cfg_valid |
| 命令构造单元 | 配置侧 | 把配置拼装成符合协议的命令帧 | cmd_frame、cmd_len |
| 发送 FIFO | 发送通路 | 缓冲待发命令,解耦软件与总线速率 | tx_push、tx_full |
| 位发送与仲裁逻辑 | 发送通路 | 逐位驱动总线并检测仲裁丢失 | sdat_o、arb_lost |
| SCLK/SDATA 引脚 | 物理引脚 | 双线总线电平驱动与采样 | sclk、sdat_i |
| 位采样与解码 | 接收通路 | 按采样边沿还原比特流 | bit_sample、rx_bit |
| 接收 FIFO | 接收通路 | 缓存回读数据与响应帧 | rx_pop、rx_empty |
| 状态机与响应单元 | 控制核心 | 推进事务流程、地址匹配与应答 | state、resp_valid |
到这里,你已经对 SPMI 的协议分层、帧结构、事务类型和硬件模块有了整体认识。下一节我们就动手把这些概念变成可仿真的环境,先把工具链搭起来。
② 开发环境搭建与仿真工具链配置
工欲善其事,必先利其器。在进行 SPMI 控制器开发前,构建一个高效的仿真环境是至关重要的第一步。这一节我们按"目录结构 → 仿真器与工具链 → Slave 模型 → 断言检查 → 波形策略"的顺序,把最小可仿真链路一步步搭起来,每一步都能直接复制使用。
2.1 目录结构规划
先把工程骨架立起来,RTL、测试平台、约束文件和脚本分门别类,后续加模块才不会乱。一个推荐的最小目录结构如下:
text
spmi_ctrl/
├── rtl/                 # 设计源码
│   ├── spmi_master.sv
│   ├── spmi_slave.sv
│   └── spmi_pkg.sv      # 参数、类型、枚举定义
├── tb/                  # 测试平台
│   ├── tb_top.sv
│   ├── spmi_slave_model.sv
│   └── spmi_assertions.sv
├── sim/                 # 仿真脚本与文件列表
│   ├── filelist.f
│   └── run.sh
├── syn/                 # 约束与综合脚本
│   └── spmi.sdc
└── wave/                # 波形输出目录
把参数和枚举统一放进 spmi_pkg.sv,Master、Slave 和 testbench 都 import 同一个包,能避免位宽和状态编码不一致这类低级错误。
2.2 仿真器与工具链配置
推荐使用业界主流的 Verilog/SystemVerilog 仿真器,如 VCS 或 ModelSim,开源场景可用 Verilator 起步。无论选哪个,都建议用一份 filelist.f 统一管理编译顺序,再用脚本封装常用命令:
bash
# sim/run.sh
vcs -full64 -sverilog -debug_access+all \
    -f filelist.f \
    +define+DUMP_FSDB \
    -l sim/build.log

./simv +fsdb+autoflush -l sim/run.log
filelist.f 里按"包 → RTL → testbench"的顺序列出文件,保证 spmi_pkg.sv 最先编译:
text
rtl/spmi_pkg.sv
rtl/spmi_master.sv
rtl/spmi_slave.sv
tb/spmi_slave_model.sv
tb/spmi_assertions.sv
tb/tb_top.sv
2.3 编写可配置的 Slave 模型
为了模拟真实的 PMIC 行为,建议编写一个可配置的 Slave 模型:它能解析收到的命令帧、按地址读写内部寄存器数组,并返回预设值,从而验证 Master 端逻辑是否正确。核心思路是"地址译码 + 寄存器数组 + 响应生成":
systemverilog
module spmi_slave_model #(
    parameter int REG_NUM = 256
)(
    input  logic        sclk,
    input  logic        sdat_i,      // 总线输入
    output logic        sdat_o,      // 从设备驱动
    output logic        sdat_oe      // 输出使能
);
    logic [7:0] regs [0:REG_NUM-1];

    // 初始化预设寄存器值,便于比对
    initial begin
        for (int i = 0; i < REG_NUM; i++) regs[i] = 8'h00;
        regs[8'h10] = 8'h5A;   // 预设一个可回读的寄存器
    end

    // 简化示意:实际需按协议解析命令头、地址与 CRC
    // 写操作:regs[addr] <= data;读操作:sdat_o <= regs[addr]
endmodule
模型里预留了 sdat_oe 三态控制,方便后续验证读操作时的总线方向切换。
2.4 用 SVA 做协议规则检查
在工具链配置方面,务必开启断言检查(Assertion Checking)功能。SPMI 协议对时序要求极高,任何违反建立时间或保持时间的操作都可能导致通信失败。通过 SVA(SystemVerilog Assertions)定义协议规则,可以在仿真早期自动捕获非法状态跳转。例如,监测 SCLK 在 SDATA 变化期间是否保持稳定:
systemverilog
module spmi_assertions (
    input logic clk,
    input logic rst_n,
    input logic sclk,
    input logic sdat
);
    // SDATA 变化时 SCLK 必须为低,避免在采样窗口内抖动
    property p_sdat_stable_when_sclk_high;
        @(posedge clk) disable iff (!rst_n)
        (sclk && $past(sclk)) |-> $stable(sdat);
    endproperty

    assert property (p_sdat_stable_when_sclk_high)
        else $error("[SVA] SDATA changed while SCLK high!");

    // 事务开始后,状态机不应长时间停留在 IDLE
    property p_no_stuck_idle;
        @(posedge clk) disable iff (!rst_n)
        (start_seen) |-> ##[1:64] !idle;
    endproperty
endmodule
断言一旦触发,日志里会直接打印出错时刻,比事后翻波形快得多。
2.5 波形 dumping 策略
配置好波形 dumping 策略,只记录关键信号而非全量信号,既能节省存储空间,又能提高波形查看效率。推荐用宏控制,仿真时按需打开:
systemverilog
`ifdef DUMP_FSDB
initial begin
    $fsdbDumpfile("wave/spmi.fsdb");
    $fsdbDumpvars(0, tb_top, "+all");
    $fsdbDumpMDA();          // 便于查看寄存器数组
end
`endif
对于大型项目,引入 UVM(Universal Verification Methodology)框架也是不错的选择,它能提供标准化的 driver、monitor 和 scoreboard 组件,大幅提升验证覆盖率。不过对新手来说,先用上面这套轻量环境把最小链路跑通,再迁移到 UVM 会更平滑。
环境搭好后,下一节我们就进入 Master 端状态机的设计,把命令真正发到总线上。
③ Master 端状态机设计与命令发送逻辑
Master 端是 SPMI 总线的大脑,其核心是一个严谨的状态机。这一节我们按"状态划分 → 三段式写法 → 命令帧逐位发送 → 位计数器与字节对齐 → 错误处理与重传"的顺序,把 Master 端从零搭起来,代码可以直接复制进工程。
3.1 状态划分:先画清楚再写代码
在写第一行 RTL 之前,先把状态和跳转条件列清楚,后面才不会写着写着就乱。一个最小可用的 Master 状态机包含五个状态:
| 状态 | 含义 | 进入条件 | 退出条件 |
|---|---|---|---|
IDLE |
空闲,等待请求 | 复位或事务结束 | req_valid 有效 |
ARBITRATION |
仲裁,确认总线使用权 | 有请求且总线空闲 | 仲裁成功 / 仲裁丢失 |
COMMAND_SEND |
发送命令头(操作码 + USID) | 仲裁成功 | 命令头 8 位发完 |
DATA_TRANSFER |
发送/接收数据字节 | 命令头发完 | 数据字节发完 |
STOP |
产生停止条件,收尾 | 数据发完 | 固定周期后回 IDLE |
对应的状态流转如下:

新手最容易犯的错是"状态里塞太多逻辑",一个状态既判断条件又驱动输出,最后波形上全是毛刺。所以下面统一用三段式写法。
3.2 三段式状态机写法
三段式的核心是"状态跳转、输出逻辑、寄存器更新"三块分离:第一段只做状态寄存,第二段只算次态,第三段只产生输出。这样综合出来的电路干净,调试时也容易定位问题。
systemverilog
module spmi_master_fsm (
    input  logic clk,
    input  logic rst_n,
    input  logic req_valid,      // 上层请求发起事务
    input  logic bus_grant,      // 仲裁成功标志
    input  logic arb_lost,       // 仲裁丢失标志
    input  logic bit_done,       // 当前字节发送完成
    output logic req_done,       // 事务完成
    output logic [2:0] state
);

    typedef enum logic [2:0] {
        IDLE         = 3'd0,
        ARBITRATION  = 3'd1,
        COMMAND_SEND = 3'd2,
        DATA_TRANSFER= 3'd3,
        STOP         = 3'd4
    } state_t;

    state_t cur_state, nxt_state;

    // 第一段:状态寄存器
    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) cur_state <= IDLE;
        else        cur_state <= nxt_state;
    end

    // 第二段:次态组合逻辑
    always_comb begin
        nxt_state = cur_state;
        case (cur_state)
            IDLE:         if (req_valid)          nxt_state = ARBITRATION;
            ARBITRATION:  if (arb_lost)           nxt_state = IDLE;
                          else if (bus_grant)     nxt_state = COMMAND_SEND;
            COMMAND_SEND: if (bit_done)           nxt_state = DATA_TRANSFER;
            DATA_TRANSFER:if (bit_done)           nxt_state = STOP;
            STOP:                                 nxt_state = IDLE;
            default:                              nxt_state = IDLE;
        endcase
    end

    // 第三段:输出逻辑
    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) req_done <= 1'b0;
        else        req_done <= (cur_state == STOP);
    end

    assign state = cur_state;

endmodule
把 bit_done 抽成独立输入,是为了让状态机只关心"这一字节发完没有",具体位计数交给下面的发送逻辑,职责更清晰。
3.3 命令帧逐位发送
命令发送逻辑需严格遵循协议定义的比特流顺序:起始条件 → 命令头(操作码 + USID)→ 数据字节 → CRC → 停止。每一位都要在 SCLK 的正确边沿驱动或采样,所以需要一个位计数器来推动字节内的位序:
systemverilog
module spmi_bit_sender (
    input  logic       clk,
    input  logic       rst_n,
    input  logic       start,        // 开始发送一个字节
    input  logic [7:0] byte_data,    // 待发送字节
    output logic       sdat_o,       // 串行数据输出
    output logic       bit_done      // 一个字节发送完成
);
    logic [2:0] bit_cnt;
    logic [7:0] shift_reg;

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            bit_cnt   <= 3'd0;
            shift_reg <= 8'd0;
            bit_done  <= 1'b0;
        end else if (start) begin
            shift_reg <= byte_data;
            bit_cnt   <= 3'd0;
            bit_done  <= 1'b0;
        end else if (bit_cnt < 3'd7) begin
            shift_reg <= {shift_reg[6:0], 1'b0};  // 高位先出
            bit_cnt   <= bit_cnt + 3'd1;
        end else begin
            bit_done  <= 1'b1;                    // 第 8 位发完
        end
    end

    assign sdat_o = shift_reg[7];

endmodule
这里用移位寄存器实现"高位先出",比用 byte_data[7-bit_cnt] 索引更省资源,综合后也更直观。
3.4 位计数器与字节边界对齐
最容易出问题的地方是字节边界:命令头 8 位、地址 8 位、数据 8 位,如果位计数器没有在字节结束时正确复位,波形上就会出现整体错位。建议用一个统一的字节计数器配合位计数器:
systemverilog
// 字节级推进:命令头 -> 地址 -> 数据 -> CRC
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        byte_idx <= 2'd0;
    end else if (bit_done) begin
        if (byte_idx == 2'd3) byte_idx <= 2'd0;   // 一帧结束,复位
        else                  byte_idx <= byte_idx + 2'd1;
    end
end

// 按 byte_idx 选择当前要发的字节
always_comb begin
    case (byte_idx)
        2'd0: cur_byte = cmd_header;   // 操作码 + USID
        2'd1: cur_byte = addr_byte;    // 寄存器地址
        2'd2: cur_byte = data_byte;    // 数据
        2'd3: cur_byte = crc_byte;     // CRC 校验
        default: cur_byte = 8'h00;
    endcase
end
调试时先看 byte_idx 是否按 0→1→2→3→0 循环,再看 bit_cnt 是否在 0→7 之间循环,两个计数器都对了,帧结构基本就不会错。
3.5 错误处理与重传机制
实际总线上会有噪声干扰,仲裁丢失、CRC 校验失败都可能发生,所以必须加错误处理和重传。最简单的做法是给每个事务设一个重试计数器,超过上限就上报错误:
systemverilog
localparam int MAX_RETRY = 3;

always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        retry_cnt <= 2'd0;
        err_flag  <= 1'b0;
    end else if (arb_lost || crc_error) begin
        if (retry_cnt == MAX_RETRY - 1) begin
            err_flag  <= 1'b1;      // 超过重试上限,上报错误
            retry_cnt <= 2'd0;
        end else begin
            retry_cnt <= retry_cnt + 2'd1;
        end
    end else if (req_done) begin
        retry_cnt <= 2'd0;          // 成功则清零
        err_flag  <= 1'b0;
    end
end
err_flag 可以直接接到中断控制器,让软件知道这条电源命令最终没发出去,避免系统带着错误状态继续跑。
到这里,Master 端的状态机、逐位发送、字节对齐和重传都齐了。下一节我们转到 Slave 端,看看寄存器映射和响应机制怎么实现。
④ Slave 端寄存器映射与响应机制实现
Slave 端是 SPMI 总线上"被指挥"的一方,但它的设计难度一点不比 Master 低:既要让寄存器映射足够灵活,又要保证响应足够快。这一节我们按"寄存器映射表 → 地址译码与 USID 匹配 → 写响应 → 读响应与总线方向切换 → 广播命令过滤"的顺序,把 Slave 端从零搭起来,代码可以直接复制进工程。
4.1 寄存器映射表设计
PMIC 内部的功能点(电压阈值、使能开关、状态标志等)最终都要落到一组寄存器上。最直接的做法是用二维数组,每个地址对应一个字节:
systemverilog
module spmi_slave_regfile #(
    parameter int ADDR_W  = 8,
    parameter int REG_NUM = 1 << ADDR_W
)(
    input  logic             clk,
    input  logic             rst_n,
    // 写端口(来自命令解码)
    input  logic             wr_en,
    input  logic [ADDR_W-1:0] wr_addr,
    input  logic [7:0]       wr_data,
    // 读端口(送往响应生成)
    input  logic [ADDR_W-1:0] rd_addr,
    output logic [7:0]       rd_data
);
    logic [7:0] regs [0:REG_NUM-1];

    // 上电默认值:按 PMIC 手册填,这里只做示意
    initial begin
        for (int i = 0; i < REG_NUM; i++) regs[i] = 8'h00;
        regs[8'h00] = 8'h01;   // 芯片 ID
        regs[8'h10] = 8'h5A;   // 电压阈值默认值
        regs[8'h20] = 8'h00;   // 使能开关,默认关闭
    end

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            // 复位时保持默认值,不整体清零,避免掉配置
        end else if (wr_en) begin
            regs[wr_addr] <= wr_data;
        end
    end

    assign rd_data = regs[rd_addr];

endmodule
这里有两个新手常踩的坑:一是复位时把整个寄存器数组清零,结果 PMIC 的默认配置全丢了;二是读数据用组合逻辑直接输出,地址一变数据就抖。前者建议只复位控制位、保留默认值,后者在时序紧张时加一级寄存器打拍。
4.2 地址译码与 USID 匹配
Slave 收到的每一帧都要先判断"这条命令是不是给我的"。判断逻辑分两步:先看命令头里的 USID 是否等于自身 USID 或广播地址,再看操作码是读还是写:
systemverilog
localparam logic [3:0] USID_SELF     = 4'h3;   // 本设备 USID,按实际分配填
localparam logic [3:0] USID_BROADCAST = 4'h0;  // 广播地址(保留值)

logic is_for_me;
logic is_broadcast;
logic is_write;
logic is_read;

always_comb begin
    is_broadcast = (cmd_usid == USID_BROADCAST);
    is_for_me    = (cmd_usid == USID_SELF) || is_broadcast;
    is_write     = is_for_me && (cmd_op == OP_WRITE);
    is_read      = is_for_me && (cmd_op == OP_READ);
end注意广播地址要优先匹配:如果先判自身 USID 再判广播,广播帧就会被漏掉。另外广播只对写操作有意义,读操作遇到广播地址应当直接忽略,否则多个 Slave 同时驱动 SDATA 会打架。
4.3 写响应:把数据落到正确的地址
写操作相对简单,解码出地址和数据后打一拍写入寄存器堆即可。关键是只在帧完整接收且 CRC 校验通过后才写,避免噪声导致的错误写入:
systemverilog
logic       frame_done;    // 一帧接收完成
logic       crc_ok;        // CRC 校验通过
logic [7:0] rx_addr;
logic [7:0] rx_data;

assign wr_en   = is_write && frame_done && crc_ok;
assign wr_addr = rx_addr;
assign wr_data = rx_data;
如果 CRC 校验失败,除了不写寄存器,还建议置一个 crc_err_flag 供软件查询,方便定位总线质量问题。
4.4 读响应与总线方向切换
读操作是 Slave 端最容易出错的地方,因为要在正确的时刻把 SDATA 的方向从"输入"切成"输出"。SPMI 规定主控发完命令头和地址后会释放总线,Slave 需要在周转周期(turnaround)之后开始驱动数据:
systemverilog
typedef enum logic [1:0] {
    S_IDLE   = 2'd0,
    S_DECODE = 2'd1,
    S_TURN   = 2'd2,   // 周转周期,等待主控释放总线
    S_DRIVE  = 2'd3    // 驱动读数据
} slave_state_t;

slave_state_t cur, nxt;

always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) cur <= S_IDLE;
    else        cur <= nxt;
end

always_comb begin
    nxt = cur;
    case (cur)
        S_IDLE:   if (frame_done)              nxt = S_DECODE;
        S_DECODE: if (is_read)                 nxt = S_TURN;
                  else                         nxt = S_IDLE;   // 写操作直接结束
        S_TURN:                                nxt = S_DRIVE;  // 固定 1 个周转周期
        S_DRIVE:  if (bit_done)                nxt = S_IDLE;   // 数据发完释放总线
        default:                               nxt = S_IDLE;
    endcase
end

// 三态控制:只有 S_DRIVE 状态才驱动总线
assign sdat_oe = (cur == S_DRIVE);
assign sdat_o  = shift_reg[7];
sdat_oe 一定要严格限定在 S_DRIVE 状态,多驱动一个周期就可能和主控撞车。调试时重点看 sdat_oe 的上升沿是否落在周转周期之后,这是读操作能否成功的关键。
4.5 广播命令过滤与响应时限
广播命令用于系统级全局电源状态切换,Slave 收到后要执行写操作但不能应答(总线上没有单独的应答阶段,多个 Slave 同时响应会冲突)。所以响应逻辑里要加一条:
systemverilog
// 广播帧只执行写,不进入读响应流程
assign enter_read_path = is_read && !is_broadcast;
另外,SPMI 对从设备的响应时限有明确要求,Slave 必须在规定时间内开始驱动数据,否则主控判超时。因此解码逻辑要尽量短:把 USID 匹配、操作码判断都做成组合逻辑的一级,寄存器读数据提前准备好,避免在响应路径上串太多级逻辑。如果时序实在紧张,可以把寄存器堆改成"读数据预取"------在地址字节接收完的那一刻就把 rd_data 打出来,周转周期结束时直接可用。
到这里,Slave 端的寄存器映射、地址译码、读写响应和广播过滤都齐了。下一节我们看多主场景下的总线仲裁与时序约束怎么写。
⑤ 总线仲裁冲突处理与时序约束编写
前面几节我们默认"总线上只有一个 Master 在说话",但真实的 SoC 里往往有多个主控(应用处理器、传感器中枢、调试口)同时想访问 PMIC。这一节我们按"仲裁原理 → 冲突检测 → 冲突处理与退避 → 时序约束编写 → 约束验证"的顺序,把多主场景下的稳定性和时序收敛讲清楚,代码和约束都能直接落到工程里。
5.1 SPMI 仲裁原理:线与 + 逐位比较
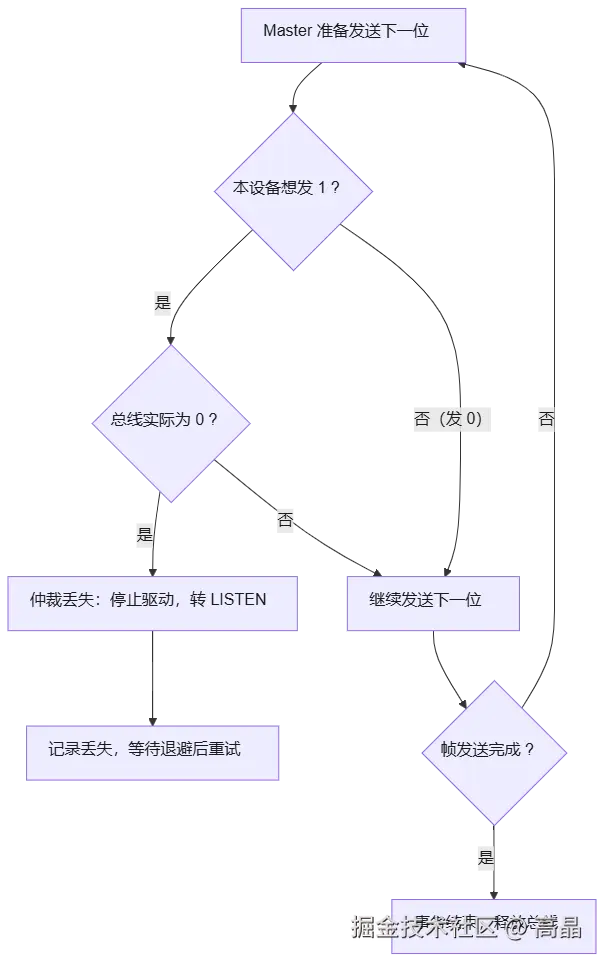
SPMI 的物理层是**线与(wired-AND)**结构:只要有一个设备把 SDATA 拉低,总线就是低电平。仲裁就建立在这个特性上------每个 Master 在发送每一位时,都把自己想发的值和总线实际值做比较:
- 想发
1,总线却是0→ 说明有别的 Master 发了0,自己仲裁丢失,立即停止驱动。 - 想发
1,总线也是1→ 继续。 - 想发
0,总线必然是0(自己拉低的)→ 继续。
因为地址/命令头是高位先发,谁的地址数值更小(更早出现 0),谁就赢得仲裁。这套机制和 I2C 的多主仲裁完全同源,好处是不需要额外的仲裁线 ,坏处是丢失方必须能立刻退出且不破坏当前位。
5.2 冲突检测:把 arb_lost 做扎实
第 3 节里我们用一行 assign arb_lost = sdat_oe && (sdat_o != sdat_i); 做了最简检测,但在多主场景下这行代码有两个坑:
- 采样时刻不对 :
sdat_i是经过 IOBUF 回来的信号,存在组合延迟,直接和sdat_o比会在位边界产生假毛刺。 - 只在驱动期比较:仲裁只发生在自己驱动总线的位周期内,非驱动期不应误判。
更稳妥的写法是在 SCLK 高电平中点采样 ,并且只在 sdat_oe 有效时比较:
systemverilog
// 仲裁检测:在 SCLK 高电平中点采样总线,避免位边界毛刺
logic sdat_i_sync;
logic arb_lost_r;

// 两级同步,消除跨时钟域/组合延迟带来的亚稳态
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        sdat_i_sync <= 1'b1;
        arb_lost_r  <= 1'b0;
    end else begin
        sdat_i_sync <= sdat_i;
        // 只在驱动期、且 SCLK 为高时比较
        if (sdat_oe && sclk) begin
            arb_lost_r <= (sdat_o != sdat_i_sync);
        end else begin
            arb_lost_r <= 1'b0;
        end
    end
end

assign arb_lost = arb_lost_r;
这样 arb_lost 是一个打拍后的干净脉冲 ,不会因为 IOBUF 延迟在每一位上抖出一串假信号,状态机拿到它就能稳定跳回 IDLE。
5.3 冲突处理:退避与重试策略
仲裁丢失不是错误,只是"这次没抢到",处理原则是立刻释放总线 + 随机退避 + 有限重试。如果所有丢失方都固定等 N 个周期再重试,会出现"同时重试、再次冲突"的活锁,所以退避时间要带随机性:
systemverilog
// 仲裁丢失后的退避重试
localparam int BACKOFF_MAX = 16;

logic [3:0] backoff_cnt;
logic       backoff_en;

always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        backoff_cnt <= 4'd0;
        backoff_en  <= 1'b0;
    end else if (arb_lost) begin
        // 随机退避:0 ~ BACKOFF_MAX-1 个周期
        backoff_cnt <= $urandom_range(0, BACKOFF_MAX - 1);
        backoff_en  <= 1'b1;
    end else if (backoff_en) begin
        if (backoff_cnt == 4'd0) backoff_en <= 1'b0;  // 退避结束,可重新请求
        else                     backoff_cnt <= backoff_cnt - 4'd1;
    end
end

// 只有退避结束才允许重新发起仲裁
assign can_request = req_valid && !backoff_en && (cur_state == IDLE);
配合第 3.5 节的重试计数器,就能形成"丢失 → 退避 → 重试 → 超限上报"的完整闭环。注意 $urandom_range 在综合时不可用,上板前要换成 LFSR 伪随机数发生器:
systemverilog
// 可综合的伪随机退避(LFSR)
logic [3:0] lfsr = 4'b1011;
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) lfsr <= 4'b1011;
    else        lfsr <= {lfsr[2:0], lfsr[3] ^ lfsr[2]};
end
// 退避时取 lfsr 低 4 位作为等待周期
5.4 时序约束编写:SDC 怎么写
仲裁和采样能不能稳定工作,一半靠 RTL,一半靠约束。SPMI 的 SCLK 由 Master 产生,属于生成时钟,SDATA 相对 SCLK 有建立/保持要求,必须显式约束,否则综合工具会按默认的宽松规则优化,上板就出问题。
先定义主时钟和生成时钟:
tcl
# syn/spmi.sdc

# 1. 系统主时钟(假设 100MHz)
create_clock -name clk -period 10.0 [get_ports clk]

# 2. SCLK 由内部分频产生,声明为生成时钟
create_generated_clock -name sclk \
    -source [get_ports clk] \
    -divide_by 4 \
    [get_pins u_master/sclk_reg/Q]

# 3. 输入输出延迟:SDATA 相对 SCLK 的建立/保持
#    tsu/th 按 PMIC 手册填写,这里以 2ns/1ns 为例
set_input_delay  -clock sclk -max 2.0 [get_ports sdat_i]
set_input_delay  -clock sclk -min 1.0 [get_ports sdat_i]
set_output_delay -clock sclk -max 2.0 [get_ports sdat_o]
set_output_delay -clock sclk -min 1.0 [get_ports sdat_o]

# 4. 异步复位不做时序检查
set_false_path -from [get_ports rst_n]
几个容易写错的地方:
- 生成时钟的
-source要指向真正的源时钟端口,而不是内部某个中间信号,否则时钟树会断。 set_input_delay的参考时钟必须是 SCLK,不是系统 clk,因为 SDATA 是相对 SCLK 采样的。-max对应建立时间、-min对应保持时间,两个都要写,只写一个工具会按 0 处理另一半。
5.5 约束验证:用 report_timing 确认收敛
约束写完不能只看"没报错",要主动检查关键路径。跑完综合后执行:
tcl
# 检查 SDATA 输入路径的建立/保持余量
report_timing -from [get_ports sdat_i] -to [get_pins u_slave/rx_shift_reg[*]/D] \
              -delay_type max -max_paths 5
report_timing -from [get_ports sdat_i] -to [get_pins u_slave/rx_shift_reg[*]/D] \
              -delay_type min -max_paths 5

# 检查 SCLK 生成时钟是否正确传播
report_clocks
如果建立余量为负,优先缩短 sdat_i 到采样寄存器的组合路径(中间插一级同步寄存器);如果保持余量为负,通常是 IOBUF 延迟太小,需要在约束里补 set_min_delay 或调整输入延迟的 -min 值。
5.6 多主场景的仿真验证
最后用一个双 Master 的 testbench 验证仲裁逻辑:两个 Master 同时请求,观察谁赢、输的一方是否正确退避并重试:
systemverilog
// 两个 Master 共享 sdat_bus,同时发起请求
initial begin
    repeat (5) @(posedge clk);
    rst_n = 1;
    fork
        begin  // Master A:地址 0x10
            do_write_a(8'h10, 8'hAA);
        end
        begin  // Master B:地址 0x20
            do_write_b(8'h20, 8'h55);
        end
    join
    // 预期:地址数值小的一方赢得仲裁,另一方 arb_lost 后重试成功
    $display("[TB] arbitration test done");
end波形上重点看三件事:arb_lost 是否只在冲突位拉高一次、丢失方是否在退避后重新发起、最终两个写操作是否都成功落寄存器。这三条都满足,仲裁逻辑就算过关了。
到这里,多主仲裁的检测、退避、约束和验证就齐了。下一节我们把这些模块搬到 FPGA 上,用真实的板级环境跑一遍完整功能测试。
⑥ 基于 FPGA 的完整功能仿真测试案例
理论验证通过后,下一步是在 FPGA 上进行实物验证。这一节我们按"上板准备 → 引脚与时钟规划 → 测试用例设计 → 自动化脚本 → 波形抓取与问题定位"的顺序,把第 ⑪ 节跑通的仿真工程真正搬到板子上,每一步都能直接照做。
6.1 上板前的准备清单
在动手接线之前,先确认下面几件事,能省掉一大半"上板不工作"的排查时间:
- 开发板选型:任意带足够 GPIO 的 FPGA 开发板即可(如 Xilinx Artix-7、Intel Cyclone 系列),至少留出 2 根可自由分配的 IO 给 SCLK/SDATA。
- 对端设备 :外接一块 PMIC 评估板,或者用第二块 FPGA 模拟 Slave 行为(复用第 ⑪ 节的
spmi_slave)。 - 上拉电阻:SPMI 是线与结构,SCLK/SDATA 必须各接一个上拉电阻(典型 4.7kΩ),否则总线空闲时电平不确定。
- 调试通道:预留 UART 或 JTAG,用于下发测试指令和回读结果。
- 观测手段:示波器或逻辑分析仪,探头接到 SCLK/SDATA 上,用于抓真实波形。
6.2 引脚与时钟规划
把 RTL 的端口映射到物理引脚,是上板的第一步。以 Vivado 为例,约束文件里至少要写清楚引脚位置和 IO 标准:
tcl
# fpga/spmi_pin.xdc

# 系统时钟(板载 100MHz 晶振)
set_property PACKAGE_PIN E3  [get_ports clk]
set_property IOSTANDARD LVCMOS33 [get_ports clk]

# SPMI 总线引脚
set_property PACKAGE_PIN J15 [get_ports sclk]
set_property PACKAGE_PIN K15 [get_ports sdat_io]
set_property IOSTANDARD LVCMOS33 [get_ports sclk]
set_property IOSTANDARD LVCMOS33 [get_ports sdat_io]

# SDATA 是双向线,需要三态
set_property PULLUP true [get_ports sdat_io]
SDATA 是双向信号,RTL 侧要拆成 sdat_o / sdat_oe / sdat_i 三根,顶层再用三态原语合并:
systemverilog
// 顶层双向 IO 处理
IOBUF u_sdat_iobuf (
    .IO (sdat_io),
    .O  (sdat_i),
    .I  (sdat_o),
    .T  (~sdat_oe)     // T=1 时为高阻,T=0 时驱动
);
时钟方面,板载晶振频率通常和仿真用的 100MHz 一致,但 SCLK 是由内部分频产生的,上板后要先用示波器量一下实际 SCLK 频率,确认分频比正确,再往下测数据。
6.3 测试用例设计
上板测试不能只跑"写一个读一个",要覆盖正常路径、边界条件和异常注入三类场景,才能说明控制器真的可靠:
| 用例类别 | 具体用例 | 预期结果 |
|---|---|---|
| 正常读写 | 写 0xAA 到 0x10,再读回 | 读回值等于 0xAA |
| 正常读写 | 连续写 0x00~0xFF 全地址,逐个读回 | 全部一致,无错位 |
| 边界条件 | SCLK 跑到最高频率(如 50MHz) | 波形无毛刺,读写正确 |
| 边界条件 | 两次事务间最小间隔 | 不出现总线冲突或丢帧 |
| 异常注入 | 人为在 SDATA 上加毛刺 | CRC 报错或重传成功 |
| 异常注入 | 双 Master 同时发起 | 仲裁丢失方正确退避重试 |
其中"全地址遍历"是最能暴露字节边界问题的用例------只要位计数器或字节计数器有一处没对齐,遍历到某个地址就会读回错位数据。
6.4 自动化测试脚本
手工点按钮效率太低,建议写一个脚本,通过 UART 向 FPGA 内部的 Master 下发指令并自动比对结果。下面是一个 Python 侧的示意:
python
import serial
import time

ser = serial.Serial('COM3', 115200, timeout=1)

def spmi_write(addr, data):
    cmd = bytes([0x01, addr, data])   # 0x01 = 写命令
    ser.write(cmd)
    resp = ser.read(1)
    return resp == b'\x00'            # 0x00 表示成功

def spmi_read(addr):
    cmd = bytes([0x02, addr])         # 0x02 = 读命令
    ser.write(cmd)
    return ser.read(1)[0]

# 用例 1:写后读回
assert spmi_write(0x10, 0xAA), "write failed"
time.sleep(0.01)
val = spmi_read(0x10)
assert val == 0xAA, f"expect 0xAA, got 0x{val:02X}"
print("[HOST] case1 PASS")

# 用例 2:全地址遍历
for addr in range(0x00, 0x100):
    assert spmi_write(addr, addr), f"write 0x{addr:02X} failed"
for addr in range(0x00, 0x100):
    val = spmi_read(addr)
    assert val == addr, f"addr 0x{addr:02X}: expect 0x{addr:02X}, got 0x{val:02X}"
print("[HOST] case2 PASS")
FPGA 侧需要一个简单的 UART 命令解析模块,把收到的字节转成 req_valid / req_addr / req_wdata 驱动 Master,再把 req_done / req_rdata 打包回传。这样一套脚本就能把上面表格里的用例全部自动化跑完。
6.5 波形抓取与问题定位
脚本跑通不代表波形一定干净,上板后一定要用逻辑分析仪抓一段真实波形,重点看三件事:
- SCLK 与 SDATA 的相位关系:SDATA 的变化应发生在 SCLK 低电平期间,SCLK 高电平中点采样,若发现 SDATA 在 SCLK 高电平期间抖动,说明驱动时序有问题。
- 三态切换时刻 :读操作时
sdat_oe的上升沿必须落在周转周期之后,过早驱动会和 Master 撞车,波形上表现为一段"半高"或毛刺。 - 建立/保持余量:用示波器的余辉模式观察 SDATA 相对 SCLK 边沿的偏移,若余量太小,调整 IOBUF 的驱动强度或加一级输出寄存器。
如果在 FPGA 上观察到毛刺或建立时间违例,处理顺序是:先查约束(第 5.4 节的 SDC 是否覆盖了 SCLK 生成时钟和 SDATA 的 IO 延迟),再查 RTL(采样是否在正确边沿),最后才动 IOBUF 的驱动强度和延时参数。多数"上板不工作"的问题,根子都在约束没写全,而不是硬件本身。
到这里,从仿真到上板的完整验证链路就走通了。下一节我们集中梳理开发过程中最常见的编译报错和波形异常,给出一套可复用的排查方法。
⑦ 常见编译报错与波形调试排查指南
前面六节把设计、仿真、上板都跑了一遍,但真正动手时,卡住你的往往不是协议本身,而是编译阶段的一堆红字和波形上说不清道不明的异常。这一节我们把开发中最常遇到的报错和波形问题集中梳理一遍,按"编译报错 → 仿真运行报错 → 波形异常 → 定位方法"的顺序,给出一套可以直接照着做的排查流程。
7.1 编译报错速查表
先把高频报错列成一张表,遇到时先对号入座,再往下看详细分析:
| 报错关键字 | 典型原因 | 快速定位 |
|---|---|---|
Multiple drivers |
同一信号在多个 always 块或 assign 中被驱动 |
全局搜索信号名,确认只有一个驱动源 |
Undefined variable / not declared |
包未 import、拼写错误、文件编译顺序错 |
检查 filelist.f 中 spmi_pkg.sv 是否最先 |
Illegal reference to net |
在 always_comb 里对 wire 赋值 |
把目标信号改成 logic 或 reg |
Port size mismatch |
例化时端口位宽与定义不一致 | 对照模块声明逐个核对位宽 |
Cannot find module |
文件没加进 filelist.f 或路径写错 |
检查文件列表与相对路径 |
Latch inferred |
always_comb 分支未覆盖全,综合出锁存器 |
补 default 分支或初值赋值 |
Timing not met / setup violation |
组合逻辑路径过长 | 看时序报告,插入流水线寄存器 |
7.2 编译报错逐类拆解
Multiple drivers:最常见的"一个信号两个爹"
这个报错几乎每个新手都会遇到,本质是同一个信号被多处驱动。典型场景是把状态机的输出既写在 always_ff 里,又在 assign 里赋了一次值:
systemverilog
// ❌ 错误:req_done 被两处驱动
always_ff @(posedge clk) begin
    req_done <= (cur_state == STOP);
end
assign req_done = (cur_state == STOP);   // 冲突!

// ✅ 正确:只保留一处驱动
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) req_done <= 1'b0;
    else        req_done <= (cur_state == STOP);
end
排查方法很简单:在工程里全局搜索这个信号名,确认它只出现在一个 always 块或一条 assign 中。如果确实需要多路来源,用一个中间信号做或/与合并,再统一输出。
Undefined variable:八成是包没导入或顺序错了
SPMI 工程里大量使用 spmi_pkg 中的枚举和常量,如果某个模块忘了 import spmi_pkg::*;,或者 filelist.f 里包没排在最前面,就会报一堆"未定义"。检查两点:
text
# filelist.f 顺序必须是:包 → RTL → testbench
rtl/spmi_pkg.sv
rtl/spmi_master.sv
rtl/spmi_slave.sv
tb/tb_top.sv
以及每个使用包内类型的模块,模块头都要带上:
systemverilog
module spmi_master
    import spmi_pkg::*;   // 这一行不能少
(
    // ...
);
Latch inferred:组合逻辑漏了分支
always_comb 里如果某个分支没有给输出赋值,综合工具就会推断出锁存器,仿真可能正常但上板行为诡异。养成习惯:case 一定写 default,if 一定配 else:
systemverilog
always_comb begin
    case (byte_idx)
        2'd0:    cur_byte = cmd_header;
        2'd1:    cur_byte = addr_byte;
        2'd2:    cur_byte = data_byte;
        2'd3:    cur_byte = crc_byte;
        default: cur_byte = 8'h00;   // 必须有,否则推断 latch
    endcase
end
Port size mismatch:位宽对不上
例化时端口位宽和模块定义不一致,比如把 8 位地址接到 4 位端口上。这类错误编译器通常会指出具体端口名,直接对照模块声明改即可。建议在 spmi_pkg 里统一定义位宽参数,避免各处手写数字。
7.3 仿真运行阶段的典型报错
编译过了不代表能跑通,仿真阶段常见的几类问题:
$error断言触发:第 2.4 节的 SVA 一旦报错,日志里会打印出错时刻和信号名。先看是哪个断言,再回到对应时刻的波形确认。- 仿真卡死、
req_done一直不来 :多半是状态机卡在某个状态出不来,比如ARBITRATION里arb_lost被误触发。加一个超时保护,避免无限等待:
systemverilog
initial begin
    #100000;
    $error("[TB] timeout! check FSM state");
    $finish;
endX态传播 :波形上出现红色X,说明有信号未初始化。常见于寄存器数组没赋初值、复位没覆盖到某个信号。检查initial块和复位分支是否完整。
7.4 波形调试:先定位事务起点,再追状态跳转
波形调试最忌讳从头滚到尾。正确的顺序是"先找事务起点 → 再看状态序列 → 最后看位级细节":
- 定位事务起点 :在波形工具里给
req_valid或起始条件加触发(Verdi 用Event Search,GTKWave 用标记),直接跳到事务开始处。 - 追状态跳转 :把
cur_state用枚举名显示(而不是数字),确认它是否按IDLE → ARBITRATION → COMMAND_SEND → DATA_TRANSFER → STOP的顺序走,每个状态停留的周期数是否符合预期。 - 看位级细节 :确认
bit_cnt是否在 0→7 循环、byte_idx是否在 0→3 循环,两个计数器都对了,帧结构基本不会错。
如果发现数据错位,大概率是位计数器复位逻辑有误,或者采样边沿选错了。这时把 sclk 和 sdat 叠在一起看,确认数据变化是否发生在时钟低电平期间。
7.5 用 Golden Model 对比定位第一个错误比特
当波形看起来"都正常"但结果就是不对时,最有效的方法是拿理想模型(Golden Model)的输出和 RTL 波形逐位对比,找到第一个不一致的比特,再从这个比特往前倒推:
systemverilog
// 在 testbench 里逐位比对,打印第一个出错的位
task automatic compare_bits(
    input logic [7:0] exp,
    input logic [7:0] act,
    input string      tag
);
    for (int i = 7; i >= 0; i--) begin
        if (exp[i] !== act[i]) begin
            $error("[%s] bit %0d mismatch: exp=%b act=%b (exp=0x%02h act=0x%02h)",
                   tag, i, exp[i], act[i], exp, act);
            return;
        end
    end
    $display("[%s] match 0x%02h", tag, act);
endtask
第一个出错的比特位置本身就是线索:如果错在高位,可能是字节序(大小端)问题;如果错在固定某一位,可能是移位寄存器少移或多移了一拍。
7.6 断点与单步:把问题缩小到一个周期
仿真器都支持在特定条件处暂停。与其盯着波形猜,不如在状态跳转处下断点,单步执行观察变量:
systemverilog
// VCS / ModelSim 通用:条件断点写法(在仿真命令或 GUI 中设置)
// break at tb_top.u_master.cur_state == COMMAND_SEND单步时重点看三个量:cur_state、bit_cnt、byte_idx。这三个量在任意时刻都应该处于合法取值范围内,一旦出现越界值(比如 bit_cnt 变成 8),问题就锁定在这一拍的逻辑上了。
7.7 时序违例的排查顺序
如果综合或上板报时序违例,按这个顺序查,能省下大量时间:
- 先看约束 :SDC 是否覆盖了
sclk生成时钟和sdat的 IO 延迟(参考第 5.4 节)。多数"时序不收敛"其实是约束没写全。 - 再看关键路径 :打开时序报告,找
slack最负的那条路径,看是不是长组合逻辑(比如 CRC 计算、地址译码)。 - 最后改 RTL:对长路径插入流水线寄存器,把组合逻辑拆成两级。CRC 这类迭代计算尤其适合流水化。
systemverilog
// 把长组合路径拆成两级流水
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        crc_stage1 <= 8'h00;
        crc_stage2 <= 8'h00;
    end else begin
        crc_stage1 <= crc8(cur_byte, crc_acc);   // 第一级:算 CRC
        crc_stage2 <= crc_stage1;                // 第二级:打拍输出
    end
end
7.8 一套可复用的排查清单
把上面的经验浓缩成一张清单,遇到问题时从上往下过一遍:
- 编译报错先看
filelist.f顺序和import是否齐全 -
Multiple drivers全局搜索信号名,确认唯一驱动源 -
Latch inferred检查case的default和if的else - 仿真卡死先加超时保护,再看状态机是否卡在某个状态
- 波形出现
X态,检查复位覆盖和initial初值 - 数据错位先看
bit_cnt和byte_idx两个计数器 - 结果不对用 Golden Model 逐位比对,找第一个错误比特
- 时序违例先查约束,再查关键路径,最后才改 RTL
到这里,从编译到波形、从仿真到上板的排查方法就齐了。下一节我们换个角度,看看 SPMI 控制器在低功耗场景下怎么设计唤醒与休眠策略。
⑧ 低功耗模式下的唤醒与休眠控制策略
电源管理接口的自身功耗也不容忽视。在系统进入休眠模式时,SPMI 控制器应自动关闭高频时钟,仅保留唤醒逻辑工作。可以通过检测总线空闲时间来实现自动休眠,当连续若干个周期无事务发生时,状态机转入 DEEP_SLEEP 状态,切断内部模块供电。唤醒机制则依赖于总线上的活动检测,一旦检测到起始条件或特定的唤醒序列,立即恢复时钟并重新初始化状态机。
为了实现平滑的唤醒,需设计一个异步唤醒信号同步电路,防止亚稳态导致的状态机错乱。同时,在休眠期间,寄存器的内容必须保持不丢失,这通常要求使用始终保持供电的电源域或电池备份单元。在策略上,还可以根据业务优先级动态调整休眠深度,对于低频监控任务,可采用间歇性唤醒方式,进一步降低平均功耗。
8.1 先想清楚:SPMI 控制器有哪几种"睡法"
在动手写代码之前,先把功耗状态划分清楚,否则后面状态机会越写越乱。一个实用的划分是三级:
| 功耗状态 | 时钟 | 供电域 | 唤醒源 | 典型场景 |
|---|---|---|---|---|
ACTIVE |
全速 | 主电源域 | --- | 正常收发事务 |
LIGHT_SLEEP |
门控(可快速恢复) | 主电源域 | 总线活动、软件写寄存器 | 短时空闲,几十个周期内可能有新命令 |
DEEP_SLEEP |
关闭 | 保留域(Retention) | 起始条件检测、外部唤醒引脚 | 系统级休眠,长时间无事务 |
关键原则:越深的睡眠,唤醒代价越大 。LIGHT_SLEEP 只关时钟,几个周期就能恢复;DEEP_SLEEP 要重新上电、重新初始化状态机,恢复时间可能是几十甚至上百个周期。所以策略上要"能浅睡就不深睡",用空闲时间做判据。
8.2 空闲检测:用计数器判断该不该睡
最直接的做法是加一个空闲计数器,总线连续空闲超过阈值就请求休眠。阈值建议做成参数,方便按场景调整:
systemverilog
module spmi_pwr_ctrl #(
    parameter int LIGHT_IDLE_TH = 64,      // 进入浅睡的空闲周期数
    parameter int DEEP_IDLE_TH  = 4096     // 进入深睡的空闲周期数
)(
    input  logic clk,
    input  logic rst_n,
    input  logic bus_active,               // 总线上有事务进行
    input  logic wake_event,               // 外部唤醒事件(引脚/中断)
    output logic light_sleep_req,
    output logic deep_sleep_req
);
    logic [15:0] idle_cnt;

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            idle_cnt <= 16'd0;
        end else if (bus_active || wake_event) begin
            idle_cnt <= 16'd0;             // 有活动就清零
        end else if (idle_cnt < DEEP_IDLE_TH) begin
            idle_cnt <= idle_cnt + 16'd1;  // 饱和计数,避免溢出
        end
    end

    assign light_sleep_req = (idle_cnt >= LIGHT_IDLE_TH);
    assign deep_sleep_req  = (idle_cnt >= DEEP_IDLE_TH);

endmodule这里用饱和计数 而不是自由计数,是为了避免计数器回绕导致休眠请求抖动。bus_active 建议直接取状态机的"非 IDLE"信号,语义最清晰。
8.3 时钟门控:浅睡的核心手段
LIGHT_SLEEP 的本质就是关掉大部分模块的时钟,只留唤醒检测逻辑。综合工具一般能自动插入 ICG(Integrated Clock Gating),但前提是 RTL 里把使能条件写清楚:
systemverilog
// 时钟门控使能:非浅睡且非深睡时才放行时钟
logic clk_en;
assign clk_en = !(light_sleep_req || deep_sleep_req);

// 综合时会推断出 ICG 单元
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        // 主逻辑
    end else if (clk_en) begin
        // 只有 clk_en 有效时才更新,等价于门控
    end
end
如果工具没有自动推断,也可以显式例化工艺库里的 ICG:
systemverilog
// 显式例化 ICG(单元名按实际工艺库替换)
CKLNQD1 u_icg (
    .CP  (clk),
    .E   (clk_en),
    .TE  (1'b0),        // 测试使能,正常功能接 0
    .Q   (gated_clk)
);
注意 TE(Test Enable)在扫描测试时必须拉高,否则测试时钟进不去,这是 DFT 阶段常见的坑。
8.4 唤醒路径:异步信号必须同步
唤醒信号往往来自外部引脚或另一个时钟域,是异步的。直接拿它去驱动状态机,极易产生亚稳态。标准做法是两级同步器:
systemverilog
module spmi_wake_sync (
    input  logic clk,          // 目标时钟域
    input  logic rst_n,
    input  logic wake_async,   // 异步唤醒输入
    output logic wake_sync
);
    logic sync_ff1, sync_ff2;

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            sync_ff1 <= 1'b0;
            sync_ff2 <= 1'b0;
        end else begin
            sync_ff1 <= wake_async;
            sync_ff2 <= sync_ff1;
        end
    end

    assign wake_sync = sync_ff2;

endmodule如果唤醒信号是脉冲(比如起始条件检测出的单周期脉冲),两级同步器可能"漏采",这时要用脉冲展宽或握手同步:
systemverilog
// 脉冲同步:把源域脉冲展宽成电平,目标域采到后再回握手
logic wake_toggle;
always_ff @(posedge src_clk or negedge rst_n) begin
    if (!rst_n)              wake_toggle <= 1'b0;
    else if (wake_pulse)     wake_toggle <= ~wake_toggle;  // 每来一个脉冲翻转
end

// 目标域:检测 toggle 变化即为一次唤醒
logic toggle_sync1, toggle_sync2, toggle_sync3;
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        toggle_sync1 <= 1'b0;
        toggle_sync2 <= 1'b0;
        toggle_sync3 <= 1'b0;
    end else begin
        toggle_sync1 <= wake_toggle;
        toggle_sync2 <= toggle_sync1;
        toggle_sync3 <= toggle_sync2;
    end
end

assign wake_pulse_sync = toggle_sync2 ^ toggle_sync3;  // 边沿检测
8.5 深睡与恢复:状态机怎么"醒过来"
DEEP_SLEEP 下时钟都关了,唤醒后不能直接接着跑,必须走一遍恢复序列:先等时钟稳定,再复位内部状态机,最后重新初始化寄存器。建议单独做一个恢复状态机:
systemverilog
typedef enum logic [1:1] {
    PWR_ACTIVE  = 1'd0,
    PWR_RESTORE = 1'd1
} pwr_state_t;

pwr_state_t pwr_cur, pwr_nxt;
logic [3:0] restore_cnt;

always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) pwr_cur <= PWR_ACTIVE;
    else        pwr_cur <= pwr_nxt;
end

always_comb begin
    pwr_nxt = pwr_cur;
    case (pwr_cur)
        PWR_ACTIVE:  if (deep_sleep_req)  pwr_nxt = PWR_RESTORE;
        PWR_RESTORE: if (restore_cnt == 4'd15) pwr_nxt = PWR_ACTIVE;
        default:                          pwr_nxt = PWR_ACTIVE;
    endcase
end

// 恢复计数器:等时钟稳定 + 状态机复位
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        restore_cnt <= 4'd0;
    end else if (pwr_cur == PWR_RESTORE) begin
        restore_cnt <= restore_cnt + 4'd1;
    end else begin
        restore_cnt <= 4'd0;
    end
end

// 恢复期间强制状态机回 IDLE
assign fsm_rst_n = rst_n && (pwr_cur != PWR_RESTORE);
restore_cnt 的位宽和阈值要按实际时钟稳定时间算,一般留足 16 个周期比较稳妥。
8.6 寄存器保持:Retention 还是软件重配
休眠期间寄存器不能丢,有两条路:
- 硬件 Retention:用带保持功能的触发器(Retention FF),深睡时由保留电源域供电,唤醒后数据还在。代价是面积和工艺支持。
- 软件重配:深睡前把关键寄存器值存到 always-on 的备份寄存器或内存,唤醒后由软件重新写入。代价是唤醒时间长,但不需要特殊单元。
对大多数项目,建议关键配置用 Retention,非关键状态用软件重配。比如 USID、地址映射这类"不能丢"的用 Retention;FIFO 里的临时数据丢了就丢了,唤醒后重新发起事务即可。
8.7 验证要点:怎么确认低功耗逻辑真的对
低功耗逻辑的 bug 往往在正常仿真里看不出来,需要专门构造场景:
- 空闲进入休眠 :让总线空闲足够长时间,检查
light_sleep_req/deep_sleep_req是否按时拉高。 - 唤醒响应时间 :从
wake_event到状态机恢复IDLE的周期数,是否在规格内。 - 亚稳态注入 :在 testbench 里让
wake_async在时钟边沿附近跳变,跑多次看是否出现X态。 - 恢复后功能正确:唤醒后立刻发起一次读写,确认寄存器值没丢、事务能正常完成。
systemverilog
// 简单的唤醒响应时间检查
initial begin
    wait (deep_sleep_req);
    @(posedge wake_event);
    fork
        begin : timeout
            #1000;
            $error("[PWR] wake response timeout!");
        end
        begin
            wait (u_dut.cur_state == IDLE);
            $display("[PWR] wake response OK, cycles = %0d", $time);
            disable timeout;
        end
    join
end
到这里,从空闲检测、时钟门控、唤醒同步到深睡恢复的完整策略就齐了。下一节我们跳出单模块,看看 SPMI 控制器怎么集成进 SoC。
⑨ 从 RTL 到 SoC 集成的接口适配要点
前面八节我们一直在"单模块"的视角里打转:Master 能发帧、Slave 能应答、仲裁能处理、低功耗能唤醒。但真实的芯片里,SPMI 控制器不是孤岛,它要挂到系统总线上被 CPU 配置,要把中断送到中断控制器,要跟时钟复位网络对齐,还要在 SoC 级的验证环境里跑通。这一节我们按"总线接口封装 → 时钟复位适配 → 中断路由 → 引脚与 IO 处理 → 集成验证"的顺序,把从 RTL 到 SoC 的最后一公里走完。
9.1 总线接口封装:把 req_* 映射成 APB 寄存器
第 ⑪ 节的 spmi_master 对外暴露的是 req_valid / req_addr / req_wdata / req_done / req_rdata 这组自定义信号,CPU 是看不懂的。最省事的做法是加一层 APB 从机接口,把这组信号翻译成几个软件可读写的寄存器:
| 偏移 | 寄存器 | 读写 | 说明 |
|---|---|---|---|
0x00 |
CTRL |
RW | bit0 启动事务,bit1 读/写选择 |
0x04 |
ADDR |
RW | 目标寄存器地址 |
0x08 |
WDATA |
RW | 写数据 |
0x0C |
RDATA |
RO | 读回数据 |
0x10 |
STATUS |
RO | bit0 完成,bit1 错误,bit2 忙 |
0x14 |
IRQ_EN |
RW | 中断使能 |
适配层的核心就是把 APB 的 psel/penable/pwrite/paddr/pwdata 译码成对上述寄存器的读写,再把 req_* 接到 Master:
systemverilog
module spmi_apb_wrapper
    import spmi_pkg::*;
(
    // ---- APB 从机接口 ----
    input  logic        pclk,
    input  logic        presetn,
    input  logic        psel,
    input  logic        penable,
    input  logic        pwrite,
    input  logic [7:0]  paddr,
    input  logic [31:0] pwdata,
    output logic [31:0] prdata,
    output logic        pready,
    // ---- 中断 ----
    output logic        irq,
    // ---- 接到 Master ----
    output logic        req_valid,
    output logic        req_is_read,
    output logic [7:0]  req_addr,
    output logic [7:0]  req_wdata,
    input  logic        req_done,
    input  logic        req_error,
    input  logic [7:0]  req_rdata
);
    logic [31:0] reg_ctrl, reg_addr, reg_wdata, reg_status, reg_irq_en;

    // APB 写
    always_ff @(posedge pclk or negedge presetn) begin
        if (!presetn) begin
            reg_ctrl  <= 32'h0;
            reg_addr  <= 32'h0;
            reg_wdata <= 32'h0;
            reg_irq_en<= 32'h0;
        end else if (psel && penable && pwrite) begin
            case (paddr)
                8'h00: reg_ctrl   <= pwdata;
                8'h04: reg_addr   <= pwdata;
                8'h08: reg_wdata  <= pwdata;
                8'h14: reg_irq_en <= pwdata;
                default: ;
            endcase
        end
    end

    // 启动事务:CTRL.bit0 写 1 触发,完成后自动清零
    assign req_valid   = reg_ctrl[0];
    assign req_is_read = reg_ctrl[1];
    assign req_addr    = reg_addr[7:0];
    assign req_wdata   = reg_wdata[7:0];

    // 状态寄存器
    always_ff @(posedge pclk or negedge presetn) begin
        if (!presetn) reg_status <= 32'h0;
        else begin
            reg_status[0] <= req_done;
            reg_status[1] <= req_error;
            reg_status[2] <= reg_ctrl[0] && !req_done;  // 忙
        end
    end

    // APB 读
    always_comb begin
        case (paddr)
            8'h00:   prdata = reg_ctrl;
            8'h04:   prdata = reg_addr;
            8'h08:   prdata = reg_wdata;
            8'h0C:   prdata = {24'h0, req_rdata};
            8'h10:   prdata = reg_status;
            8'h14:   prdata = reg_irq_en;
            default: prdata = 32'h0;
        endcase
    end

    assign pready = 1'b1;   // 寄存器访问零等待
    assign irq    = reg_irq_en[0] && (reg_status[0] || reg_status[1]);

endmodule这里有个细节要注意:req_valid 直接由 reg_ctrl[0] 驱动,意味着软件写 1 之后必须等 req_done 再写 0,否则会重复发起事务。更稳妥的做法是在 req_done 时自动清 reg_ctrl[0],让软件只负责"写 1 启动"。
9.2 时钟与复位适配:跨时钟域和复位序列
SoC 里 SPMI 控制器通常挂在 APB 时钟域(比如 100MHz),而 SPMI 总线本身的 SCLK 是分频出来的,两者不同频。第 ⑪ 节的实现里 sclk 是由 cur_state != IDLE 直接驱动的,这在 SoC 里要改成分频产生,并且分频系数可配:
systemverilog
// SCLK 分频:按 CTRL[7:4] 配置分频比,默认 4 分频
logic [3:0] clk_div;
logic [3:0] div_cnt;
logic       sclk_r;

always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        div_cnt <= 4'd0;
        sclk_r  <= 1'b0;
    end else if (cur_state == IDLE) begin
        div_cnt <= 4'd0;
        sclk_r  <= 1'b0;
    end else if (div_cnt == clk_div - 1) begin
        div_cnt <= 4'd0;
        sclk_r  <= ~sclk_r;
    end else begin
        div_cnt <= div_cnt + 4'd1;
    end
end
复位方面,SoC 通常有多个复位源:上电复位(POR)、看门狗复位、软件复位。SPMI 控制器要明确哪些状态必须被复位清掉,哪些要保留:
- 必须复位:状态机、位计数器、FIFO 指针、错误标志。
- 建议保留:USID 配置、地址映射表(如果来自 efuse 或 OTP)。
- 复位释放顺序:先释放 APB 时钟域复位,再释放 SPMI 总线侧复位,避免总线侧先跑起来而配置还没到位。
如果 SPMI 控制器要支持低功耗唤醒(第 ⑧ 节),复位信号本身也要做异步同步处理,不能直接把异步复位接到状态机。
9.3 中断路由:把完成和错误送到中断控制器
SoC 里的中断控制器(如 GIC、PLIC)通常要求中断信号是电平敏感、保持到被清除 。所以 irq 不能是单周期脉冲,而要用状态位锁存:
systemverilog
// 中断锁存:完成或错误时置位,软件写 1 清除
logic irq_done_latch, irq_err_latch;

always_ff @(posedge pclk or negedge presetn) begin
    if (!presetn) begin
        irq_done_latch <= 1'b0;
        irq_err_latch  <= 1'b0;
    end else begin
        if (req_done)  irq_done_latch <= 1'b1;
        if (req_error) irq_err_latch  <= 1'b1;
        // 软件写 STATUS 对应位清除
        if (psel && penable && pwrite && paddr == 8'h10) begin
            if (pwdata[0]) irq_done_latch <= 1'b0;
            if (pwdata[1]) irq_err_latch  <= 1'b0;
        end
    end
end

assign irq = (irq_done_latch && reg_irq_en[0]) ||
             (irq_err_latch  && reg_irq_en[1]);
中断号在 SoC 里是固定分配的,集成时要跟中断控制器的连线表对齐,别出现"两个模块抢同一个中断号"的低级错误。另外,如果 SPMI 有多个中断源(完成、错误、唤醒),建议用一个中断号 + 状态寄存器的方式,而不是每个源占一个中断号,省中断资源。
9.4 引脚与 IO 处理:三态、上拉和 ESD
SPMI 是双线开漏总线,SCLK 和 SDATA 在芯片外部都要接上拉电阻。RTL 层面要注意三点:
- 三态控制 :
sdat_oe为 0 时输出高阻,由外部上拉拉高。综合时要用assign sdat_pad = sdat_oe ? sdat_o : 1'bz;,并且这个三态必须在 IO 单元里实现,不能靠内部逻辑模拟。 - 输入同步 :
sdat_i从 PAD 进来是异步的,进状态机前要打两拍同步,避免亚稳态。 - SCLK 方向 :Master 模式下 SCLK 是输出,Slave 模式下是输入,集成时要用一个
is_master配置位选择方向,别把方向搞反。
systemverilog
// 输入同步
logic sdat_i_sync1, sdat_i_sync2;
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        sdat_i_sync1 <= 1'b1;
        sdat_i_sync2 <= 1'b1;
    end else begin
        sdat_i_sync1 <= sdat_pad_i;
        sdat_i_sync2 <= sdat_i_sync1;
    end
end
9.5 集成验证:从模块级到 SoC 级
模块级验证跑通不代表集成没问题,SoC 级要重点验证这几类场景:
- 寄存器访问:用 CPU 通过 APB 读写每个寄存器,确认地址译码和读写属性正确。
- 中断通路:发起一次事务,确认中断能正确送到中断控制器并被软件清除。
- 复位序列 :在事务进行中触发软件复位,确认状态机能干净回到
IDLE,不会卡死。 - 多主共存:如果 SoC 里有多个 SPMI Master,验证仲裁逻辑在真实拓扑下是否正常。
- 低功耗唤醒:结合第 ⑧ 节,验证深睡后唤醒能正常发起事务。
集成阶段最有效的调试手段是软硬件协同仿真:用真实的驱动程序跑在 CPU 模型上,通过 APB 发起事务,观察 SPMI 总线波形。这样能发现很多纯 RTL 仿真发现不了的问题,比如软件时序假设错误、寄存器定义不一致等。
到这里,从 RTL 到 SoC 集成的接口适配就讲完了。下一节我们聊聊性能优化和后续的学习路径。
⑩ 性能优化技巧与后续进阶学习路径
前面九节把功能跑通了,但"能跑"和"跑得好"是两回事。这一节我们分两块:先讲几个在真实项目里最见效的性能优化技巧,再给出一条从入门到进阶的学习路径,帮你把这块知识继续往深处走。
10.1 先搞清楚优化什么:延迟还是吞吐
动手优化之前,先明确瓶颈在哪。SPMI 控制器的性能通常看两个指标:
| 指标 | 含义 | 典型瓶颈 |
|---|---|---|
| 事务延迟 | 从 req_valid 到 req_done 的周期数 |
状态机跳转层级、周转周期、仲裁等待 |
| 总线吞吐 | 单位时间内完成的事务数 | 字节间空拍、FIFO 深度、软件下发速率 |
新手最容易犯的错是"上来就调时钟频率",结果时序违例一堆,性能反而更差。正确顺序是:先减少空拍,再优化关键路径,最后才考虑提频。
10.2 减少字节间空拍
回看第 3.4 节的字节计数器,如果每个字节发完都要等一拍 bit_done 再切下一个字节,一帧 4 个字节就白白浪费 4 个周期。可以把"字节切换"和"最后一位发送"合并到同一拍:
systemverilog
// 优化前:bit_done 拉高后下一拍才切字节
// 优化后:第 8 位发送的同一拍就预取下一字节
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        shift_reg <= 8'd0;
        bit_cnt   <= 3'd0;
        byte_idx  <= 2'd0;
    end else if (cur_state == COMMAND_SEND || cur_state == DATA_TRANSFER) begin
        if (bit_cnt == 3'd7) begin
            bit_cnt   <= 3'd0;
            byte_idx  <= byte_idx + 2'd1;
            shift_reg <= next_byte(byte_idx + 2'd1);  // 同拍预取
        end else begin
            shift_reg <= {shift_reg[6:0], 1'b0};
            bit_cnt   <= bit_cnt + 3'd1;
        end
    end
end
这样一帧能省下 3~4 个周期,对高频轮询场景(比如状态轮询事务)收益很明显。
10.3 状态机编码:独热码换速度
第 3.2 节用的是二进制编码,状态少的时候没问题。但如果状态扩展到十几个(加上错误处理、低功耗、多主仲裁分支),二进制编码的组合逻辑层级会变深,成为关键路径。这时可以换独热码(one-hot):
systemverilog
// 综合指令:让工具用独热码实现
(* fsm_encoding = "one_hot" *) state_t cur_state, nxt_state;
独热码每个状态只占一位,次态判断变成"或"逻辑,跳转更快;代价是触发器多一点。状态数超过 8 个、且时序紧张时,这个交换通常划算。
10.4 预取与流水:把等待藏起来
读操作里最耗时的是周转周期(第 4.4 节的 S_TURN)。如果软件连续读多个寄存器,可以在当前读事务还没结束时,就提前把下一个地址的 rd_data 取出来放进缓冲:
systemverilog
// 简单预取:地址递增时提前读下一拍
logic [7:0] prefetch_data;
logic       prefetch_valid;

always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
        prefetch_valid <= 1'b0;
    end else if (is_read && frame_done) begin
        prefetch_data  <= regs[rx_addr + 8'd1];  // 预取下一地址
        prefetch_valid <= 1'b1;
    end
end
配合 Master 侧的突发读(burst read),能把周转周期摊薄到多个事务上,吞吐提升非常可观。
10.5 仲裁优先级:让关键命令先走
多主场景下(第 5 节),如果所有 Master 平等竞争,电源紧急关断这类关键命令可能被普通配置命令堵在后面。可以在仲裁逻辑里加一个优先级位:
systemverilog
// 高优先级请求优先参与仲裁
assign arb_req = req_high_prio ? 1'b1 : req_valid;
注意优先级不能滥用------如果高优先级请求一直不断,低优先级会饿死。建议加一个"老化计数器",等待超过 N 个周期就临时提权。
10.6 物理层与约束的配合
RTL 优化到一定程度,瓶颈就转到物理层了。几个实用建议:
- 缩短走线:SPMI 是开漏总线,走线越长上升沿越慢,50MHz 下要严格控制长度和负载电容。
- 上拉电阻取值:阻值太小功耗高,太大上升沿慢,按总线电容和速率折中,通常 1k~10k 之间调。
- 时序约束 :第 5.4 节的 SDC 里,把
sdat_i的输入延迟按实际板级走线设准,别用默认值,否则综合工具会过度优化或漏优化。
10.7 后续进阶学习路径
跑通本文的链路后,可以按下面这条路径继续深入,每一步都有明确的落点:
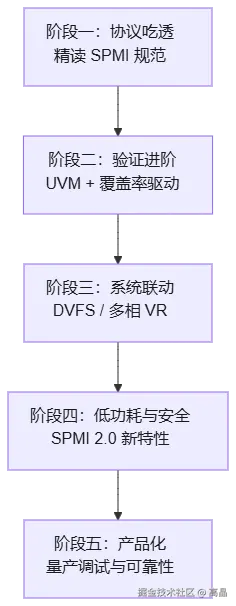
阶段一:协议吃透。 把 SPMI 规范从头到尾精读一遍,重点看时序参数表、错误处理章节和保留字段定义。很多现场问题最后都能在规范里找到答案。
阶段二:验证进阶。 把第 2.5 节提到的 UVM 真正用起来,搭一套带覆盖率收集的验证环境。功能覆盖率能告诉你"哪些分支还没测到",比人工想用例靠谱得多。
阶段三:系统联动。 学习 DVFS(动态电压频率调整)与 SPMI 的配合机制:CPU 降频时如何通过 SPMI 同步降压、多相 VR 控制器如何分配相位。这部分需要结合具体 SoC 的电源架构来看。
阶段四:低功耗与安全。 研究 SPMI 2.0 规范新增的安全认证机制和新事务类型,理解它在高可靠电源系统里的作用。同时把第 ⑧ 节的低功耗设计做深,比如多电压域的协同休眠。
阶段五:产品化。 从"仿真能跑"到"量产稳定"还有很长的路:ESD 防护、EMC 测试、温度漂移下的时序余量、批量生产的一致性验证,都是要补的课。
10.8 小结
性能优化没有银弹,核心是先测量、再定位、后优化 :用波形数清空拍,用综合报告看关键路径,用覆盖率找验证盲区。而进阶学习的关键是带着问题学------每学一个新技术点,都回到自己的工程里找对应的场景去实践,比单纯看文档有效得多。
到这里,从协议理解、环境搭建、RTL 实现、验证调试到性能优化的完整链路就讲完了。下一节我们把所有模块拼成一个可编译、可仿真的完整工程,真正跑通一条读写链路。
⑪ 完整实战代码:从零跑通一条 SPMI 读写链路
前面十节把协议、环境、Master、Slave、仲裁、验证都拆开讲了一遍,但真正上手时最容易卡住的地方是"这些模块怎么拼起来跑"。这一节我们把它们组装成一个最小可编译、可仿真的完整工程:一个 Master 发起写 0xAA 到地址 0x10、再读回校验的闭环,跑通它,你就有了一个可以继续往上加功能的骨架。
11.1 工程文件清单
按第 2.1 节的目录结构,最终参与编译的文件如下,顺序不能乱(包必须最先):
text
rtl/spmi_pkg.sv            # 参数、枚举、类型
rtl/spmi_master.sv         # Master 顶层(FSM + 位发送 + 字节对齐 + 重传)
rtl/spmi_slave.sv          # Slave 顶层(寄存器堆 + 译码 + 读响应)
tb/spmi_slave_model.sv     # 行为级 Slave 模型(可选,用于交叉比对)
tb/spmi_assertions.sv      # SVA 协议检查
tb/tb_top.sv               # 顶层 testbench
sim/filelist.f
sim/run.sh
11.2 公共包:spmi_pkg.sv
所有模块共享的参数和枚举集中在这里,避免位宽和状态编码各写各的:
systemverilog
package spmi_pkg;

    // ---- 协议常量 ----
    localparam logic [3:0] USID_BROADCAST = 4'h0;
    localparam logic [3:0] USID_SELF      = 4'h3;

    // ---- 操作码 ----
    typedef enum logic [3:0] {
        OP_WRITE   = 4'h1,
        OP_READ    = 4'h2,
        OP_POLL    = 4'h3,
        OP_EXT     = 4'h4
    } op_t;

    // ---- Master 状态 ----
    typedef enum logic [2:0] {
        IDLE          = 3'd0,
        ARBITRATION   = 3'd1,
        COMMAND_SEND  = 3'd2,
        DATA_TRANSFER = 3'd3,
        STOP          = 3'd4
    } mst_state_t;

    // ---- Slave 状态 ----
    typedef enum logic [1:0] {
        S_IDLE   = 2'd0,
        S_DECODE = 2'd1,
        S_TURN   = 2'd2,
        S_DRIVE  = 2'd3
    } slv_state_t;

    // ---- CRC-8(多项式 0x07,与协议一致)----
    function automatic logic [7:0] crc8(input logic [7:0] data, input logic [7:0] crc_in);
        logic [7:0] c;
        c = crc_in ^ data;
        for (int i = 0; i < 8; i++) begin
            c = c[7] ? ((c << 1) ^ 8'h07) : (c << 1);
        end
        return c;
    endfunction

endpackage
11.3 Master 顶层:spmi_master.sv
把第 3 节的 FSM、位发送、字节对齐、重传四块拼成一个模块,对外只暴露"发起一次事务"的接口:
systemverilog
module spmi_master
    import spmi_pkg::*;
(
    input  logic       clk,
    input  logic       rst_n,
    // 上层请求接口
    input  logic       req_valid,
    input  logic       req_is_read,
    input  logic [7:0] req_addr,
    input  logic [7:0] req_wdata,
    output logic       req_done,
    output logic       req_error,
    output logic [7:0] req_rdata,
    // 物理总线
    output logic       sclk,
    output logic       sdat_o,
    output logic       sdat_oe,
    input  logic       sdat_i
);
    // ---------------- 内部信号 ----------------
    mst_state_t cur_state, nxt_state;
    logic [7:0] shift_reg;
    logic [2:0] bit_cnt;
    logic [1:0] byte_idx;
    logic       bit_done;
    logic [7:0] cur_byte;
    logic [7:0] crc_acc;
    logic [1:0] retry_cnt;
    logic       crc_error;
    logic       arb_lost;

    localparam int MAX_RETRY = 3;

    // ---------------- 状态机 ----------------
    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) cur_state <= IDLE;
        else        cur_state <= nxt_state;
    end

    always_comb begin
        nxt_state = cur_state;
        case (cur_state)
            IDLE:          if (req_valid)  nxt_state = ARBITRATION;
            ARBITRATION:   if (arb_lost)   nxt_state = IDLE;
                           else           nxt_state = COMMAND_SEND;
            COMMAND_SEND:  if (bit_done && byte_idx == 2'd1) nxt_state = DATA_TRANSFER;
            DATA_TRANSFER: if (bit_done && byte_idx == 2'd3) nxt_state = STOP;
            STOP:                                          nxt_state = IDLE;
            default:                                       nxt_state = IDLE;
        endcase
    end

    // ---------------- 字节选择 ----------------
    always_comb begin
        case (byte_idx)
            2'd0:    cur_byte = {req_is_read ? OP_READ : OP_WRITE, USID_SELF};
            2'd1:    cur_byte = req_addr;
            2'd2:    cur_byte = req_wdata;
            default: cur_byte = crc_acc;
        endcase
    end

    // ---------------- 位发送 ----------------
    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            shift_reg <= 8'd0;
            bit_cnt   <= 3'd0;
            bit_done  <= 1'b0;
            byte_idx  <= 2'd0;
            crc_acc   <= 8'h00;
        end else if (cur_state == COMMAND_SEND || cur_state == DATA_TRANSFER) begin
            if (bit_cnt == 3'd0 && bit_done == 1'b0) begin
                shift_reg <= cur_byte;
                crc_acc   <= crc8(cur_byte, crc_acc);
            end
            if (bit_cnt < 3'd7) begin
                shift_reg <= {shift_reg[6:0], 1'b0};
                bit_cnt   <= bit_cnt + 3'd1;
                bit_done  <= 1'b0;
            end else begin
                bit_done  <= 1'b1;
                bit_cnt   <= 3'd0;
                byte_idx  <= byte_idx + 2'd1;
            end
        end else begin
            bit_done <= 1'b0;
            byte_idx <= 2'd0;
            crc_acc  <= 8'h00;
        end
    end

    // ---------------- 仲裁检测 ----------------
    assign arb_lost = sdat_oe && (sdat_o != sdat_i);

    // ---------------- 输出 ----------------
    assign sclk    = (cur_state != IDLE);
    assign sdat_o  = shift_reg[7];
    assign sdat_oe = (cur_state == COMMAND_SEND) || (cur_state == DATA_TRANSFER);

    // ---------------- 完成与重传 ----------------
    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            req_done  <= 1'b0;
            req_error <= 1'b0;
            retry_cnt <= 2'd0;
        end else if (cur_state == STOP) begin
            req_done  <= 1'b1;
            req_error <= crc_error;
            retry_cnt <= 2'd0;
        end else begin
            req_done <= 1'b0;
            if (arb_lost || crc_error) begin
                if (retry_cnt == MAX_RETRY - 1) begin
                    req_error <= 1'b1;
                    retry_cnt <= 2'd0;
                end else begin
                    retry_cnt <= retry_cnt + 2'd1;
                end
            end
        end
    end

    assign req_rdata = shift_reg;

endmodule
11.4 Slave 顶层:spmi_slave.sv
把第 4 节的寄存器堆、USID 译码、读响应状态机合成一个模块:
systemverilog
module spmi_slave
    import spmi_pkg::*;
#(
    parameter int ADDR_W  = 8,
    parameter int REG_NUM = 1 << ADDR_W
)(
    input  logic              clk,
    input  logic              rst_n,
    input  logic              sclk,
    input  logic              sdat_i,
    output logic              sdat_o,
    output logic              sdat_oe
);
    // ---------------- 寄存器堆 ----------------
    logic [7:0] regs [0:REG_NUM-1];

    initial begin
        for (int i = 0; i < REG_NUM; i++) regs[i] = 8'h00;
        regs[8'h00] = 8'h01;   // 芯片 ID
        regs[8'h10] = 8'h5A;   // 电压阈值默认值
        regs[8'h20] = 8'h00;   // 使能开关
    end

    // ---------------- 接收移位 ----------------
    logic [7:0] rx_shift;
    logic [2:0] rx_bit_cnt;
    logic [1:0] rx_byte_idx;
    logic [7:0] cmd_header, rx_addr, rx_data;
    logic       frame_done;

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            rx_shift    <= 8'd0;
            rx_bit_cnt  <= 3'd0;
            rx_byte_idx <= 2'd0;
            frame_done  <= 1'b0;
        end else if (sclk) begin
            rx_shift <= {rx_shift[6:0], sdat_i};
            if (rx_bit_cnt == 3'd7) begin
                rx_bit_cnt <= 3'd0;
                case (rx_byte_idx)
                    2'd0: cmd_header  <= {rx_shift[6:0], sdat_i};
                    2'd1: rx_addr     <= {rx_shift[6:0], sdat_i};
                    2'd2: rx_data     <= {rx_shift[6:0], sdat_i};
                    default: ;
                endcase
                rx_byte_idx <= rx_byte_idx + 2'd1;
                frame_done  <= (rx_byte_idx == 2'd2);
            end else begin
                rx_bit_cnt <= rx_bit_cnt + 3'd1;
            end
        end else begin
            frame_done <= 1'b0;
        end
    end

    // ---------------- 地址译码 ----------------
    logic is_broadcast, is_for_me, is_write, is_read;
    assign is_broadcast = (cmd_header[3:0] == USID_BROADCAST);
    assign is_for_me    = (cmd_header[3:0] == USID_SELF) || is_broadcast;
    assign is_write     = is_for_me && (cmd_header[7:4] == OP_WRITE);
    assign is_read      = is_for_me && (cmd_header[7:4] == OP_READ) && !is_broadcast;

    // ---------------- 写寄存器 ----------------
    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            // 保留默认值,不整体清零
        end else if (is_write && frame_done) begin
            regs[rx_addr] <= rx_data;
        end
    end

    // ---------------- 读响应状态机 ----------------
    slv_state_t cur, nxt;
    logic [7:0] rd_data;
    logic [7:0] tx_shift;
    logic [2:0] tx_bit_cnt;

    assign rd_data = regs[rx_addr];

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) cur <= S_IDLE;
        else        cur <= nxt;
    end

    always_comb begin
        nxt = cur;
        case (cur)
            S_IDLE:   if (frame_done) nxt = S_DECODE;
            S_DECODE: if (is_read)    nxt = S_TURN;
                      else            nxt = S_IDLE;
            S_TURN:                   nxt = S_DRIVE;
            S_DRIVE:  if (tx_bit_cnt == 3'd7) nxt = S_IDLE;
            default:                  nxt = S_IDLE;
        endcase
    end

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            tx_shift   <= 8'd0;
            tx_bit_cnt <= 3'd0;
        end else if (cur == S_TURN) begin
            tx_shift   <= rd_data;      // 周转周期预取,S_DRIVE 直接可用
            tx_bit_cnt <= 3'd0;
        end else if (cur == S_DRIVE) begin
            tx_shift   <= {tx_shift[6:0], 1'b0};
            tx_bit_cnt <= tx_bit_cnt + 3'd1;
        end
    end

    assign sdat_oe = (cur == S_DRIVE);
    assign sdat_o  = tx_shift[7];

endmodule
11.5 顶层 testbench:tb_top.sv
testbench 负责三件事:产生时钟复位、驱动 Master 发起"写 0xAA 到 0x10 再读回"、自动比对结果:
systemverilog
module tb_top
    import spmi_pkg::*;
();
    logic clk = 0;
    logic rst_n = 0;
    always #5 clk = ~clk;   // 100MHz

    // ---------------- Master 请求 ----------------
    logic       req_valid = 0;
    logic       req_is_read = 0;
    logic [7:0] req_addr = 0;
    logic [7:0] req_wdata = 0;
    logic       req_done, req_error;
    logic [7:0] req_rdata;

    // ---------------- 总线 ----------------
    logic sclk, m_sdat_o, m_sdat_oe, s_sdat_o, s_sdat_oe;
    logic sdat_bus;

    // 线与:任一方驱动低即为低
    assign sdat_bus = (m_sdat_oe && !m_sdat_o) ? 1'b0 :
                      (s_sdat_oe && !s_sdat_o) ? 1'b0 : 1'b1;

    spmi_master u_master (
        .clk        (clk),
        .rst_n      (rst_n),
        .req_valid  (req_valid),
        .req_is_read(req_is_read),
        .req_addr   (req_addr),
        .req_wdata  (req_wdata),
        .req_done   (req_done),
        .req_error  (req_error),
        .req_rdata  (req_rdata),
        .sclk       (sclk),
        .sdat_o     (m_sdat_o),
        .sdat_oe    (m_sdat_oe),
        .sdat_i     (sdat_bus)
    );

    spmi_slave u_slave (
        .clk    (clk),
        .rst_n  (rst_n),
        .sclk   (sclk),
        .sdat_i (sdat_bus),
        .sdat_o (s_sdat_o),
        .sdat_oe(s_sdat_oe)
    );

    // ---------------- 测试流程 ----------------
    task automatic do_write(input logic [7:0] addr, input logic [7:0] data);
        @(posedge clk);
        req_valid  <= 1'b1;
        req_is_read<= 1'b0;
        req_addr   <= addr;
        req_wdata  <= data;
        @(posedge clk);
        req_valid  <= 1'b0;
        wait (req_done);
        if (req_error) $error("[TB] write 0x%02h failed", addr);
        else           $display("[TB] write 0x%02h = 0x%02h OK", addr, data);
    endtask

    task automatic do_read(input logic [7:0] addr, output logic [7:0] data);
        @(posedge clk);
        req_valid  <= 1'b1;
        req_is_read<= 1'b1;
        req_addr   <= addr;
        @(posedge clk);
        req_valid  <= 1'b0;
        wait (req_done);
        data = req_rdata;
        $display("[TB] read  0x%02h -> 0x%02h", addr, data);
    endtask

    logic [7:0] rd_val;

    initial begin
        repeat (5) @(posedge clk);
        rst_n = 1;
        repeat (5) @(posedge clk);

        // 用例 1:写后读回
        do_write(8'h10, 8'hAA);
        do_read (8'h10, rd_val);
        if (rd_val !== 8'hAA) $error("[TB] mismatch: expect 0xAA, got 0x%02h", rd_val);
        else                  $display("[TB] case1 PASS");

        // 用例 2:写默认值寄存器
        do_write(8'h20, 8'h01);
        do_read (8'h20, rd_val);
        if (rd_val !== 8'h01) $error("[TB] mismatch: expect 0x01, got 0x%02h", rd_val);
        else                  $display("[TB] case2 PASS");

        // 用例 3:广播写(不应答,只验证不报错)
        do_write(8'h30, 8'h55);

        $display("[TB] all cases done");
        $finish;
    end

    // 超时保护,避免死等
    initial begin
        #100000;
        $error("[TB] timeout!");
        $finish;
    end

endmodule
11.6 一键运行脚本
把编译和仿真封装成一条命令,改代码后直接 ./sim/run.sh 就能看到结果:
bash
#!/bin/bash
# sim/run.sh
set -e

vcs -full64 -sverilog -debug_access+all \
    -f sim/filelist.f \
    +define+DUMP_FSDB \
    -l sim/build.log

./simv +fsdb+autoflush -l sim/run.log
sim/filelist.f 内容:
text
rtl/spmi_pkg.sv
rtl/spmi_master.sv
rtl/spmi_slave.sv
tb/spmi_assertions.sv
tb/tb_top.sv
11.7 预期输出与验证要点
跑通后日志里应该看到类似下面的内容:
text
[TB] write 0x10 = 0xaa OK
[TB] read  0x10 -> 0xaa
[TB] case1 PASS
[TB] write 0x20 = 0x01 OK
[TB] read  0x20 -> 0x01
[TB] case2 PASS
[TB] write 0x30 = 0x55 OK
[TB] all cases done
如果没跑通,按这个顺序排查:
req_done一直不来 :先看cur_state是否卡在ARBITRATION,多半是arb_lost被误触发------检查sdat_oe是否在IDLE状态被拉高。- 读回值不对 :看
sdat_oe的上升沿是否落在S_TURN之后,以及tx_shift是否在S_TURN正确预取了rd_data。 - 写不进去 :确认
frame_done是否在第三个字节接收完时拉高,rx_addr/rx_data是否对齐。 - 波形全是毛刺 :检查
sclk是否只在非IDLE状态翻转,以及 testbench 的线与逻辑是否正确建模了三态。
11.8 从这个骨架继续扩展
这个最小链路跑通后,往上加功能就有了稳定的基线:
- 加 CRC 校验 :在 Slave 接收完数据字节后计算
crc8,与收到的 CRC 字节比对,失败置crc_err_flag。 - 加状态轮询事务 :在
spmi_pkg里补OP_POLL分支,Master 侧复用do_read流程,Slave 侧返回状态寄存器。 - 加多主仲裁 :再实例化一个
spmi_master,共享sdat_bus,观察arb_lost的触发时序。 - 接 APB 配置接口 :按第 ⑨ 节的做法,把
req_*信号映射到 APB 寄存器,软件即可通过 CPU 发起事务。
到这里,整条从协议理解到可仿真 RTL 的链路就闭环了。建议先把这个骨架跑通、把波形看熟,再逐项替换成自己项目里的真实参数------这比一上来就啃完整 IP 要快得多。