面试官让你把 LLM、RAG、Agent、MCP 串起来讲清楚,90% 的 Java 工程师当场露馅
📌 本文导读(建议先花 60 秒)
说句扎心的:LLM、RAG、Agent、MCP、向量、余弦相似度......这些词你个个都听过,但面试官让你"串起来讲一遍"的时候,是不是瞬间就卡壳了?
别慌,这恰恰说明你缺的不是知识点,而是一张全景图。
这篇文章不堆概念、不背定义,用一条真实的电商客服请求做主线,带你从"用户问:我的订单为什么还没发货"一路走到最后流式输出的答复,中间每个环节用到的技术、写的 Java 代码、踩过的坑,全都摆到台面上。
读完这篇,你能带走什么?
- 🧭 一句话隐喻串起所有概念:LLM 是发动机,Embedding 是坐标系,余弦相似度是尺子,向量库是图书馆索引卡,RAG 是外挂资料室,Tool 是手脚,MCP 是 USB-C 插座,Skills 是岗位手册,Agent 是那个会自己干活的数字员工
- 🏗️ 五层架构 + 依赖关系两张图:搞清每一层是谁的活,顺便把"为什么招 Java 而不是招算法"这句话说到位
- 🧮 余弦相似度的三个数学关系:归一化后余弦 == 内积、余弦越大 L2 越小、排序等价 ≠ 阈值通用------面试答不出来基本就露馅的那几个点
- 💻 可以直接抄的生产级代码 :
float存储double累加防精度污染、零向量短路防 NaN、JDK Vector API 上 SIMD、RRF 融合、带四道防护的 ReAct 循环、三分钟把 Spring Boot 服务变成 MCP Server - ⚡ 反直觉但救命的结论 :RAG 的瓶颈在检索 不在生成;Skills 别塞进 System Prompt 要用渐进式披露 ;工具集要从 28 个收敛到 5~8 个;MCP 的 HTTP 端点默认无鉴权,裸暴露就是裸奔
- 🕳️ 16 个生产踩坑对照表 + 13 个面试连环追问速答:建议直接收藏当检查清单,改分块、换模型、调阈值之前先过一遍
这篇适合谁? 想转 AI 方向的后端、正在做企业知识库或智能客服的 Java 研发、以及下周就要面试、现在有点慌的朋友。
这篇不适合谁? 想学怎么训练大模型、调 LoRA 的------这里一个梯度都不推。本文只讲一件事:怎么把不确定的模型能力,装进确定的工程系统里。
⏱️ 全文约 1.5 万字,建议先收藏、再细看,通勤路上刷不完的。
看到最后有个小彩蛋:文末问了大家"做 RAG 或 Agent 落地时踩过最疼的坑",评论区聊两句,我看到会挨个回。觉得有用的话,点个赞、点个在看,别让这篇在收藏夹里吃灰 👇
--
一个请求串起 LLM、RAG、Agent、MCP:Java 工程师的 AI 工程化落地全景
面试里有道高频题:把 LLM、Agent、Skills、MCP、RAG、向量、余弦相似度串起来讲清楚。大多数人单个概念都能背,一连起来就露馅。这篇文章用一条真实的客服请求做主线,结合我们在电商客服、企业知识库项目里的落地经验,讲透每个概念的原理、Java 实现和踩过的坑。适合想转 AI 方向的后端朋友,建议先收藏再细看。
一、先立全景:一句话 + 两张图串起所有概念
学 AI 概念最大的痛点是"每个都听过,串不起来"。别急着一头扎进细节,先花三分钟建立全局认知,后面怎么学都不会迷路。
先用一句话把所有概念放进同一个隐喻体系:
LLM 是发动机;Embedding 是语言的坐标系;余弦相似度是尺子;向量库是图书馆的索引卡;RAG 是给模型配的"外挂资料室";Tool 是模型的手脚;MCP 是统一的 USB 插座;Skills 是岗位行为手册;Agent 是那个会自己拆任务、干完还会复盘的数字员工。
而 Java 工程师的价值,从来不在"造发动机",而在造整车、修高速、建加油站。
再来一张"人话版"速查表:
| 概念 | 一句话人话 | 类比 | Java 侧抓手 | ||||
|---|---|---|---|---|---|---|---|
| LLM | 只会预测下一个 token 的续写机器 | 大脑 / 发动机 | Spring AI、LangChain4j、WebClient 调 API + SSE 流式 | ||||
| 向量 Embedding | 把文本变成语义坐标 | 坐标系 | EmbeddingModel 输出 float[],存 pgvector / Milvus |
||||
| 余弦相似度 | 看两个向量方向像不像 | 尺子 / 罗盘 | `cos = A·B / ( | A | B | )`,用于 TopK 召回 | |
| RAG | 开卷考试:先查资料再回答 | 外挂资料室 | 切块 → 向量化 → 检索 → 拼 Prompt | ||||
| Skills | 某类任务的标准作业流程 | 岗位手册 / 工具箱 | @Tool 方法 + 按需加载的 SKILL.md |
||||
| MCP | 工具接入的统一协议 | USB-C 插座 | spring-ai-starter-mcp-server-* |
||||
| Agent | 会拆任务、调工具、循环决策 | 数字员工 | AiServices + ReAct 循环 / 状态机 |
1.1 五层架构:搞清楚每一层是谁的活
把概念放进分层架构里看,职责一目了然------这和咱们熟悉的 MVC 分层是一个思路:
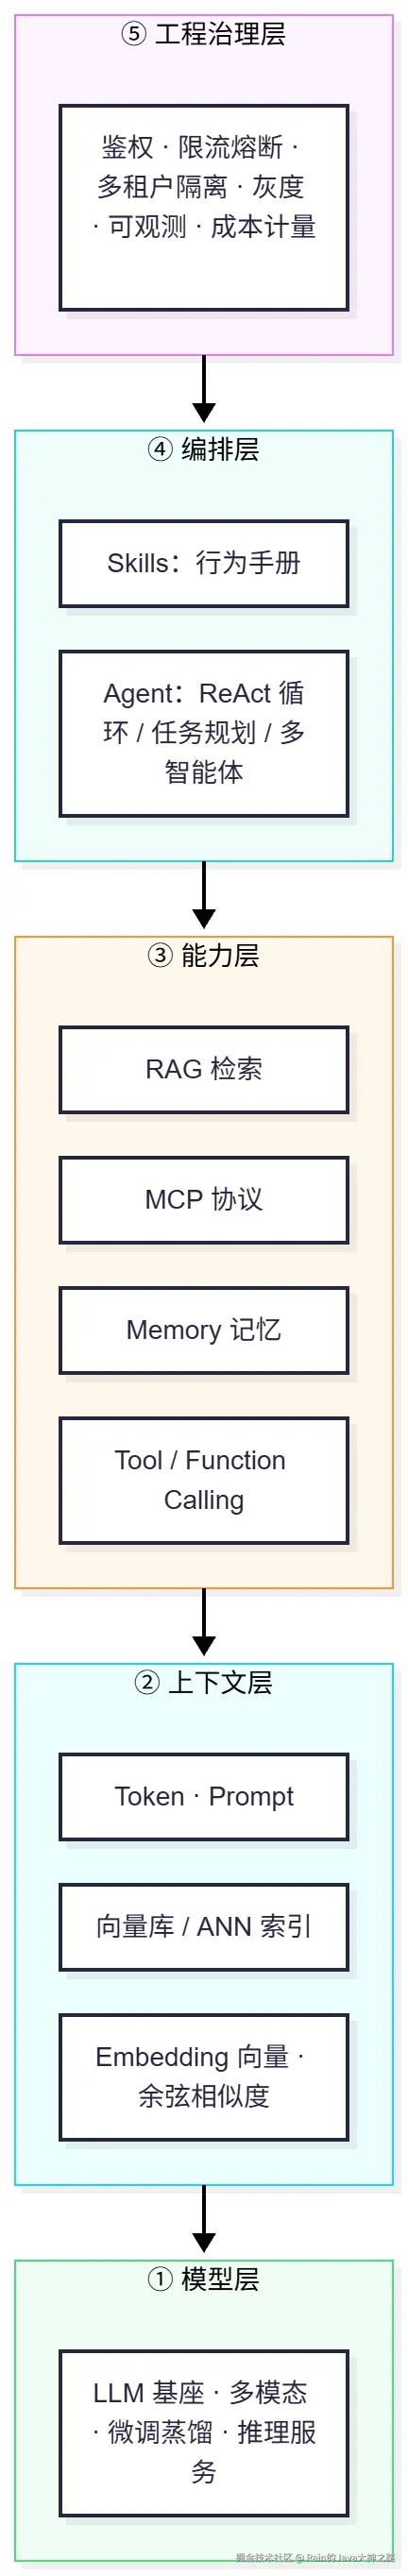
| 层 | 一句话职责 | Java 侧抓手 |
|---|---|---|
| ① 模型层 | 提供"理解与生成"的算力 | HTTP/SSE 调用、Spring AI ChatModel |
| ② 上下文层 | 把语义变成可计算的距离 | MilvusVectorStore、PgVectorStore、ES 8.x dense_vector |
| ③ 能力层 | 让模型看得见知识、摸得着系统 | LangChain4j ContentRetriever、Spring AI ToolCallback |
| ④ 编排层 | 让模型自己决定下一步干什么 | AiServices、Spring StateMachine、ToolProvider |
| ⑤ 工程治理层 | 让 AI 稳定、安全、便宜地上线 | WebFlux + SSE、Redis 令牌桶、Micrometer、网关 |
💡 技术亮点(面试加分句) :这五层里,①②是买来的,③④是框架给的,⑤才是企业自己的护城河。这一句话,基本就把"为什么招 Java 而不是招算法"说透了。
1.2 概念依赖关系:它们是怎么咬合的
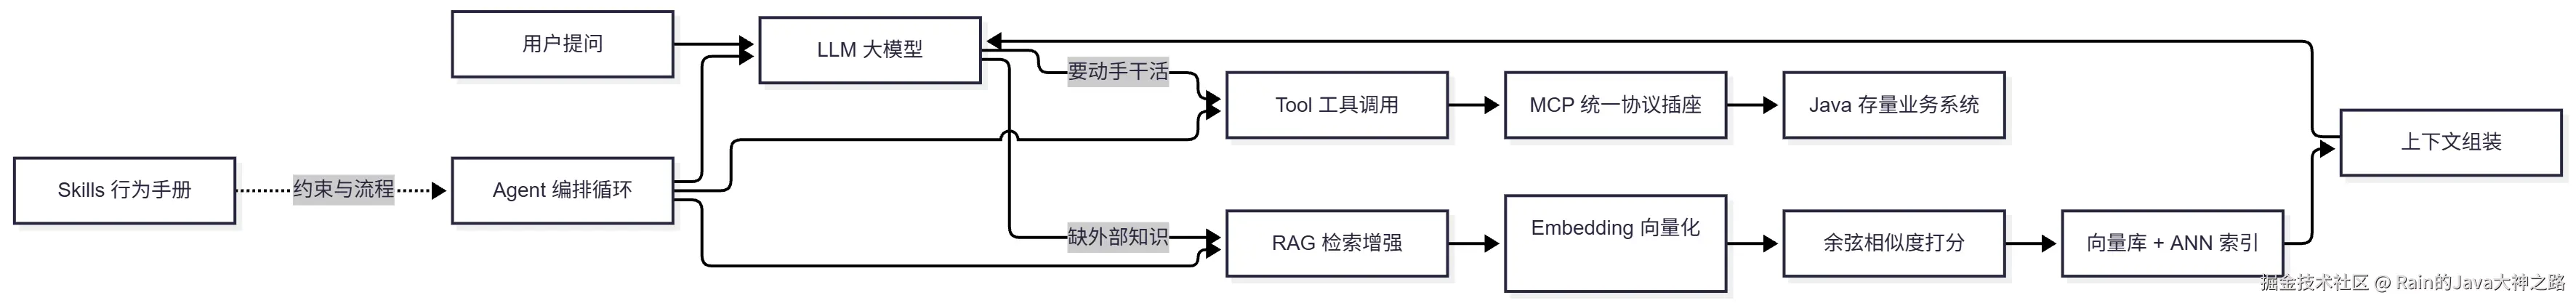
一句话串完:向量和余弦相似度是语义计算的地基,RAG 给大模型装知识库,Skills 和 MCP 给大模型接业务手脚,Agent 把所有能力组装成能自主完成任务的智能体。
接下来自底向上逐个拆。先从不那么性感、但决定一切的地基讲起。
二、LLM:别神化,它就是个"下一个 token 预测器"
很多人把大模型当百科全书用,这是所有工程问题的根源。先把三个关键认知钉死:
- 它是概率生成器,不是数据库 。LLM 本质是函数
f(文本上下文) → 下一个 token 的概率分布,它生成的是最像样的文本 ,不是最真实的文本; - 知识冻结:训练完那一天,参数里的知识就冻住了。你上周发的产品文档,它天然不知道;
- 幻觉的根因 :模型优化的是流畅度 而不是真实性,不知道又必须答的时候,它会用概率分布"编一个最像样的"。
再加两条:它没有记忆 ,所谓多轮对话,全靠我们把历史消息一遍遍塞进 messages 数组;它不联网、不查数据库,强在语言理解与生成,弱在精确计算、实时数据和私域知识。
想明白这些,Java 研发的定位就清楚了:
💡 一句话记忆 :大模型在 Java 世界里,本质上就是另一个能聊天的第三方 REST 服务------只是它特别慢、特别贵、还偶尔胡说八道。我们要做的不是转行搞算法,而是当一名 LLM Application Engineer:像治理任何"不可靠依赖"一样,做超时、重试、熔断、降级、可观测。
2.1 Token、上下文、Temperature:都是预算
| 概念 | 本质 | 工程含义 |
|---|---|---|
| Token | 模型最小计费与处理单位,是子词不是字 | 中文约 1 字 ≈ 1~1.5 token(不同分词器有差异),成本与延迟都按 token 计 |
| Prompt | 发给模型的输入模板 | Prompt 也是"代码":要版本化、要评测、要回归 |
| 上下文窗口 | 模型一次能看见的全部内容 | 是预算而非容量:检索塞多少、历史留多少、输出留多少,都要算账 |
| Temperature | 控制概率分布的"锐度" | 抽取/分类/事实问答用 0~0.3,创意写作 0.7+ |
| 结构化输出 | 让模型吐合法 JSON 对接 Java 类型 | BeanOutputConverter + 校验 + 失败重试 |
上下文越长越贵,也越容易"迷失中间信息"(Lost in the Middle)。所以别把上下文当硬盘用,它是稀缺资源------这个观点后面讲 Skills 时还会再用到。
2.2 别把 LLM 当数据库
这是我踩坑之后总结的分工原则,实际开发中非常管用:
事实数据 :查数据库 / 知识库;流程操作 :走业务接口 / MCP;语言表达:才交给 LLM。
LLM 擅长推理和组织表达,不擅长长期记忆和精确事实。让它干它不擅长的事,就是幻觉的开始。
模型本身这么多毛病,怎么补?答案是给它配外挂------先外挂知识(RAG),再外挂手脚(Tool/MCP)。但在那之前,得先解决一个数学问题:机器怎么理解"意思"?
三、向量 + 余弦相似度:把"语义"变成可计算的数字
3.1 为什么需要向量
传统 SQL 只擅长精确匹配和模糊匹配,like '%car%' 永远匹配不到 automobile。关键词检索匹配的是字 ,而我们要匹配的是意思。
Embedding 模型把一段文本压成一串高维浮点数(常见 768 / 1024 / 1536 / 3072 维),语义越近的文本,在向量空间里距离越近:
text
"如何申请年假"  → [0.012, -0.231,  0.548, ...]  ┐ 夹角很小 → 语义几乎等价
"年假怎么请"    → [0.009, -0.198,  0.561, ...]  ┘
"如何申请离职"  → [-0.34,  0.087, -0.112, ...]  → 夹角很大 → 语义不同
几个关键工程认知,都是血泪换来的:
- 不用关心每一维代表什么,只关心"距离能不能用";
- 向量是模型给的,不是算出来的 ------换 Embedding 模型,整个向量库必须全量重建,这是迁移成本的地雷;
- 入库和查询必须用同一个 Embedding 模型,否则坐标系都不一样,算出来的相似度是纯噪声;
- 生产上 Embedding 通常离线批量跑 + 增量幂等重放,别把它放进用户请求的同步链路。
维度怎么选?维度越高语义表达越细,但存储和计算成本线性增长。float 存储下 1536 维 × 4B ≈ 6KB/条,企业级常见选 1024 维再配 PQ 量化压缩。
3.2 余弦相似度:为什么不用欧氏距离
公式很简单,值域 [-1, 1]:
text
cos(θ) = (A·B) / (‖A‖ × ‖B‖) = Σ(aᵢbᵢ) / (√Σaᵢ² × √Σbᵢ²)分数怎么解读,心里要有杆秤:
| 相似度 | 含义 | 场景 |
|---|---|---|
| 1.0 | 完全同方向 | 同义句 |
| 0.7+ | 高度相关 | 常用的召回阈值 |
| 0.0 | 正交,无关 | --- |
| 负数 | 方向相反 | 文本向量中少见 |
为什么文本场景默认选余弦而不是欧氏距离?
| 度量 | 公式 | 区间 | 适用场景 |
|---|---|---|---|
| 余弦相似度 | Σ(aᵢbᵢ) / (‖a‖‖b‖) |
-1, 1 | 文本语义检索默认选它(只看方向,不看长度) |
| 内积 / 点积 | Σ(aᵢbᵢ) |
(-∞, +∞) | 推荐系统(模长可编码热度、置信度) |
| 欧氏距离 | √Σ(aᵢ-bᵢ)² |
[0, +∞) | 图像特征等模长本身有意义的场景 |
文本向量的模长受文本长度影响------"今天天气很好"和"今天天气很好很好很好"意思一样,欧氏距离却会变大;余弦只看方向,对长度不敏感。而且高维空间里欧氏距离有维度灾难,距离趋同,区分度越来越差。
3.3 三个数学关系:答不出来基本就露馅
⭐ 面试必答:
- 归一化后,余弦 == 内积 。做 L2 归一化使
‖a‖=‖b‖=1,代入公式即得cosθ = a·b。工程价值:查询时只需一次乘法累加,省掉每次开方和除法 。FAISS 里IndexFlatIP配归一化向量,算的就是余弦。- 归一化后,余弦越大 ⇔ L2 距离越小 。
‖a-b‖² = 2 - 2cosθ = 2(1-cosθ),三种度量的排序结果完全等价,只差一个分数刻度。- 排序等价 ≠ 阈值通用。如果拿余弦分数做绝对阈值过滤(比如"低于 0.6 判定无答案"),度量选择和归一化状态就至关重要------混用归一化/未归一化向量,阈值会直接失效。
3.4 三个容易被追问的坑
| 坑 | 现象 | 本质与应对 |
|---|---|---|
| 相似 ≠ 相关 | "苹果公司 CEO"和"Tim Cook"向量距离可能很远 | 向量衡量的是表述分布相似度,不是事实关联。靠混合检索 + Rerank + 知识图谱补 |
| Hubness 枢纽点 | 某些向量成为"万能近邻",谁查都排前面 | 高维空间固有现象。去重、聚类打散、结果多样性约束(MMR)缓解 |
| 重复文档刷分 | 同一文档存 10 份,更容易被召回 | 入库做内容指纹去重 ,召回后按 doc_id 聚合 |
3.5 生产级代码:三个细节比公式本身更重要
java
public final class CosineSimilarity {

    private CosineSimilarity() {}

    /**
     * 通用余弦相似度,三个工程细节:
     * ① 用 double 累加------1536 维 float 连续累加会丢精度,污染 Top-K 排序;
     * ② 零向量必须短路------否则 NaN 一路污染到排序结果,Comparator 行为不可预测;
     * ③ 维度校验------入库与查询的坐标系必须一致。
     */
    public static double cosine(float[] a, float[] b) {
        if (a.length != b.length) {
            throw new IllegalArgumentException("向量维度不一致: " + a.length + " vs " + b.length);
        }
        double dot = 0.0, na = 0.0, nb = 0.0;
        for (int i = 0; i < a.length; i++) {
            dot += (double) a[i] * b[i];   // 提升到 double 再累加
            na  += (double) a[i] * a[i];
            nb  += (double) b[i] * b[i];
        }
        if (na == 0.0 || nb == 0.0) {      // 零向量短路,防 NaN
            return 0.0;
        }
        return dot / (Math.sqrt(na) * Math.sqrt(nb));
    }

    /** 入库前 L2 归一化:之后检索退化为内积,省掉 2 次开方 + 1 次除法 */
    public static float[] l2Normalize(float[] v) {
        double n = 0.0;
        for (float x : v) n += (double) x * x;
        if (n == 0.0) return v;
        double inv = 1.0 / Math.sqrt(n);
        float[] out = new float[v.length];
        for (int i = 0; i < v.length; i++) out[i] = (float) (v[i] * inv);
        return out;
    }

    /** 归一化向量之间的内积 == 余弦相似度(检索热路径用这个) */
    public static double dot(float[] a, float[] b) {
        double s = 0.0;
        for (int i = 0; i < a.length; i++) {
            s += (double) a[i] * b[i];
        }
        return s;
    }
}
💡 技术亮点 :
float存储省一半内存与带宽,但累加用 double 防精度丢失;零向量返回 0 而不是NaN------NaN会让Comparator排序结果不可预测,这是真实踩过的坑。另外"写入时归一化、查询时退化为点积"这一招,实测百万级向量打分性能提升 2~3 倍,千万级批量检索能提升约 40%。
批量点积还可以交给 SIMD:
java
import jdk.incubator.vector.FloatVector;
import jdk.incubator.vector.VectorOperators;
import jdk.incubator.vector.VectorSpecies;

/**
 * JDK Vector API(jdk.incubator.vector,孵化阶段,需 --add-modules):
 * 让 JIT 生成 SIMD 指令,批量点积性能可达标量循环的数倍。
 * 定位:离线建库/重排序阶段的自研算子;在线检索一律交给向量库。
 */
public final class SimdDotProduct {

    private static final VectorSpecies<Float> SPECIES = FloatVector.SPECIES_PREFERRED;

    public static double dot(float[] a, float[] b) {
        int i = 0;
        int upperBound = SPECIES.loopBound(a.length);
        FloatVector acc = FloatVector.zero(SPECIES);

        for (; i < upperBound; i += SPECIES.length()) {
            FloatVector va = FloatVector.fromArray(SPECIES, a, i);
            FloatVector vb = FloatVector.fromArray(SPECIES, b, i);
            acc = acc.add(va.mul(vb));
        }

        double sum = acc.reduceLanes(VectorOperators.ADD);
        for (; i < a.length; i++) {         // 尾部不足一个向量宽度,标量兜底
            sum += (double) a[i] * b[i];
        }
        return sum;
    }
}
有了向量和尺子,下一个问题很现实:数据量上来之后,难道真的一条条 for 循环去算?
四、向量库与 ANN 索引:为什么不能自己 for 循环
先算一笔账 :100 万条 1024 维向量,每条查询要 1024 次乘加,单次查询约 20 亿次浮点运算;光把 4GB 向量从内存读一遍就够喝一壶。100 并发?CPU 排队到天亮。
破局思路 :允许自己"不算那么准"------ANN(近似最近邻)用少量召回率换数量级速度。
| 索引 | 核心思想 | 优点 | 代价 | 适用 |
|---|---|---|---|---|
| Flat | 暴力全量比对 | 召回率 100%,无需训练 | O(N×dim),慢 | < 10 万条,或作为召回基准 |
| IVF | K-means 聚类分桶,只搜 nprobe 个最近簇 |
内存友好、可扩展 | 边界向量易漏召 | 千万级以上、可接受离线重建 |
| HNSW | 分层可导航小世界图 | 召回/延迟综合最优,主流默认 | 内存占用高、构建慢、删除不友好 | 通用首选 |
| PQ | 乘积量化压缩向量 | 内存降一个数量级 | 精度损失,需重排补偿 | 亿级规模、内存受限 |
理解 HNSW 一句话就够:跳表解决"跳得远",小世界图解决"跳得准"------从高层入口大步跳,逐层下降、每层贪心走向更近的邻居,用 O(log N) 的访问路径逼近目标。
生产上用 recall@K(ANN 结果与暴力结果的 Top-K 重合比例)验收,一般调到 95%~99%,同时把延迟从秒级压到毫秒级。
4.1 Java 侧选型对照表
| 场景 | 选型 | 理由 |
|---|---|---|
| 已有 ES 集群 | Elasticsearch 8.x dense_vector |
一套系统同时吃 BM25 + 向量,混合检索最省事 |
| 已有 PostgreSQL | pgvector | 事务、权限、备份全复用,运维零新增 |
| 千万~亿级、要低延迟 | Milvus / Qdrant | 专业向量库,HNSW/PQ 参数可精细调 |
| 单元测试 / 小数据 | 内存 Map + 余弦 | 别引入重组件,SimpleVectorStore 足够 |
⚠️ 踩坑提醒 :不要自己去实现 ANN 索引。亮点应该是"怎么选索引、怎么调
nprobe/efSearch、怎么用 recall@K 验收",而不是手写 HNSW。千万级向量下检索延迟超 1s,标准解法是 HNSW 索引 + 热门向量本地缓存(Caffeine)+ 冷热数据分库。
pgvector 场景下,计算直接下沉到数据库,避免把全量向量拉到 Java 内存:
sql
-- <=> 是 pgvector 的余弦距离操作符,1 - 距离 = 余弦相似度
SELECT id, content, 1 - (embedding <=> :qvec) AS score
FROM doc_chunk
WHERE tenant_id = :tenantId
ORDER BY embedding <=> :qvec
LIMIT 5;
Spring Data JPA 里用原生查询包一层即可:
java
@Query(value = """
    SELECT id, content, 1 - (embedding <=> :queryVector) AS similarity
    FROM document_chunks
    WHERE 1 - (embedding <=> :queryVector) > :threshold
    ORDER BY similarity DESC
    LIMIT :topK
""", nativeQuery = true)
List<DocSimilarity> findTopKByCosine(@Param("queryVector") float[] queryVector,
                                     @Param("threshold") double threshold,
                                     @Param("topK") int topK);
Milvus 场景的声明式配置,注意维度必须和 Embedding 模型严格对齐:
java
@Configuration
public class MilvusVectorConfig {

    @Bean
    public VectorStore milvusVectorStore(EmbeddingModel embeddingModel) {
        return MilvusVectorStore.builder()
                .embeddingModel(embeddingModel)
                .host("milvus-internal-host")
                .port(19530)
                .collectionName("knowledge_base")
                .dimension(1536)                 // 与 Embedding 模型维度严格对齐
                .indexType(IndexType.HNSW)       // 高性能向量索引
                .metricType(MetricType.COSINE)   // 余弦度量
                .build();
    }
}
地基打完了,正式进入应用层。先讲面试第一关------RAG。
五、RAG:开卷考试,但瓶颈在检索不在生成
先纠正一个高频错误答案:
RAG 不是"向量库 + 大模型",而是"外部知识管理 + 检索系统 + 生成模型"的一整套协同机制。 它解决四个问题:知识不新、私有知识不知道、容易编(幻觉)、答案不可追溯。
5.1 完整链路:两阶段,必须按步骤讲
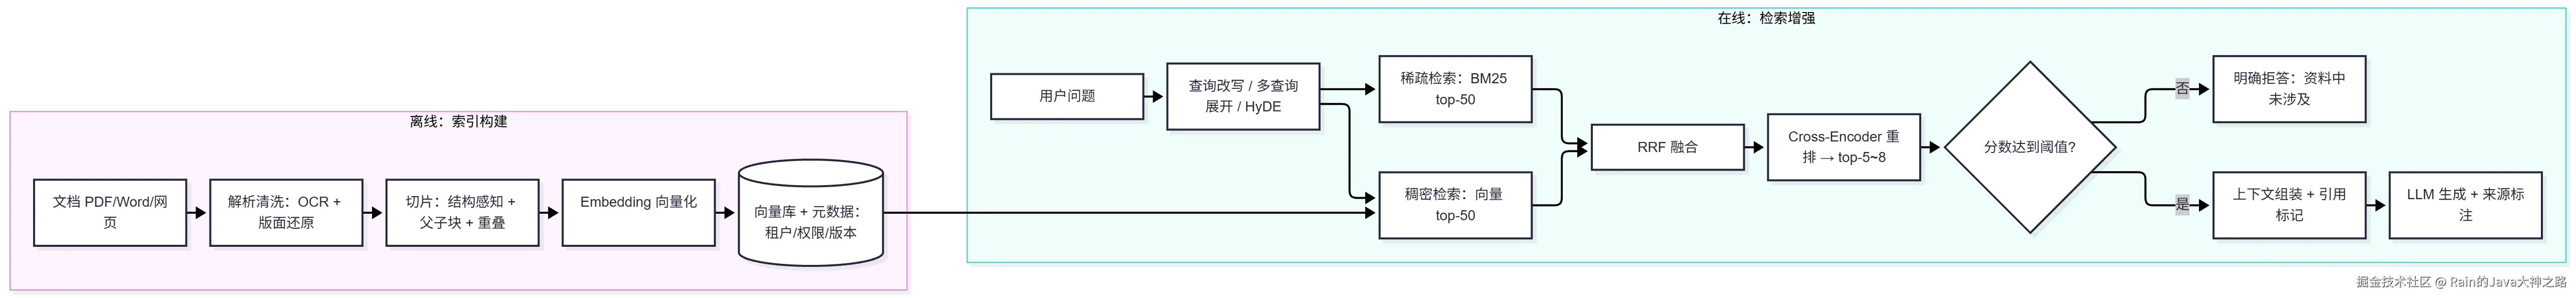
5.2 高分答法:先讲"朴素 RAG 为什么不行"
| 朴素 RAG 的失败模式 | 典型表现 | 对应解法 |
|---|---|---|
| 召回不准 | "苹果 CEO"召不回"Tim Cook" | 混合检索(Dense + BM25)、查询改写 |
| 语义 ≠ 相似 | 搜编号 AG-2024-001,召回一堆含"产品编号"字样但号不对的文档 |
BM25 精确匹配兜底,权重按场景调 |
| 上下文割裂 | 固定 512 字符硬切,论证被腰斩 | 结构感知切片、父子块、语义分块 |
| 多跳推理失败 | "X 公司 CEO 的母校的 QS 排名"查不到 | 查询分解、Agentic RAG 多轮检索 |
| 全局性问题崩溃 | "这批文档的核心主题是什么" | GraphRAG / 全局摘要,向量检索对此天然失效 |
| 召回多但噪音大 | Top-20 全塞进去,模型被干扰 | Rerank 精排,只送 top-5~8 |
把解法攒起来,就是 2026 年的生产级 RAG 公式:
Production RAG = 高级解析(OCR / 版面还原)+ 混合检索(BM25 + Dense,RRF 融合)+ 神经重排(Cross-Encoder)+ Agentic 路由(按问题复杂度动态决定检索深度)+ GraphRAG(全局/多跳问题)+ 持续评测(RAGAS / TruLens,量化 recall@k、忠实度、幻觉率)
📌 这里有个分水岭级别的认知:RAG 的瓶颈在检索,不在生成。朴素管道在检索这一步大约 40% 的概率会失败,检索入口错了,后面 rerank 和生成再优化都白搭。
顺带回答一个高频疑问:现在上下文都 1M 了,还要 RAG 吗?要。三个理由:成本与延迟 (每次全量灌入不可接受)、注意力衰减 (塞得多不代表记得住)、实时性与权限粒度 (知识库按条更新、按租户过滤)。正确姿势是:RAG 负责从海量里精准找,长上下文负责找到之后的精读推理。
5.3 五个关键设计决策
① 切块 :固定长度硬切是语义腰斩的元凶。实践参数:500~1000 token 一块、10%~20% 重叠、按标题/段落结构感知切分,再上父子块------子块用于向量匹配,命中后把父块完整内容送进上下文。标题和元数据也要带着走,检索时能做过滤,回答时能做溯源。
② Embedding 一致性:Query 和 Doc 必须同一模型同一维度,前面讲过,不再展开。
③ 混合检索 + RRF 融合 :纯向量会漏精确关键词(型号 RTX-5090、制度号 HR-2025-013),BM25 恰好互补。RRF(Reciprocal Rank Fusion)的打分公式是 score = Σ 1/(k + rank),不需要归一化两种量纲完全不同的分数,比加权求和稳得多。
④ 重排 :向量召回是"双塔模型",Query 和 Doc 独立编码,无法深度交互;Rerank 是交叉编码,把 Q+D 拼一起算相关性,准但慢,所以只对粗召回的 Top-50 精排,取 Top-5~8。
⑤ 生成约束:Prompt 写死"仅依据资料回答,没有就说不知道"+ 强制引用来源。这是抑制幻觉的第一道闸。
5.4 核心代码:一个能上线的 RAG 闭环
Spring AI 里,RAG 可以被一个 Advisor 织入,业务代码几乎无感:
java
@Configuration
public class RagConfig {

    /** 生产环境换成 PgVectorStore / MilvusVectorStore / ElasticsearchVectorStore */
    @Bean
    VectorStore vectorStore(EmbeddingModel embeddingModel) {
        return SimpleVectorStore.builder(embeddingModel).build();
    }

    /**
     * RAG 三个关键约束:
     * ① topK + similarityThreshold:控制上下文预算,宁少勿滥;
     * ② 系统提示写死"只依据资料回答,没有就说不知道"------抑制幻觉的第一道闸;
     * ③ 绑定引用来源,可追溯(企业合规刚需)。
     */
    @Bean
    ChatClient chatClient(ChatClient.Builder builder, VectorStore vectorStore) {
        return builder
                .defaultSystem("""
                        你是企业知识助手。只能依据【检索资料】回答问题,
                        并在答案末尾用 [来源: 文件名#片段号] 标注依据。
                        资料中没有相关信息时,直接回答「资料中未涉及」,禁止推测。
                        """)
                .defaultAdvisors(
                        QuestionAnswerAdvisor.builder(vectorStore)
                                .searchRequest(SearchRequest.builder()
                                        .topK(8)
                                        .similarityThreshold(0.6)
                                        .build())
                                .build())
                .build();
    }
}

// 调用侧:检索被 Advisor 织入,业务代码里几乎看不到 RAG 的存在
@RestController
public class KnowledgeController {

    private final ChatClient chatClient;

    public KnowledgeController(ChatClient chatClient) {
        this.chatClient = chatClient;
    }

    @GetMapping("/kb/ask")
    public String ask(@RequestParam String q) {
        return chatClient.prompt().user(q).call().content();
    }
}
📎 注:Spring AI 各小版本 API 略有差异(如
SimpleVectorStore.builder与旧版构造器),以所用版本的官方文档为准。
再往进一步,两阶段检索 + 流式输出:
java
@Service
@RequiredArgsConstructor
public class KnowledgeQAService {

    private final VectorStore vectorStore;
    private final RerankClient rerankClient;
    private final ChatModel chatModel;

    /** 两阶段检索:粗召回扩量 → 精排取 Top-5,各司其职 */
    public List<Document> retrieve(String query) {
        List<Document> candidates = vectorStore.similaritySearch(
                SearchRequest.builder()
                        .query(query)
                        .topK(20)                      // 扩大召回,给 Rerank 留空间
                        .similarityThreshold(0.6)      // 阈值过滤,别把噪声喂给模型
                        .build());
        return rerankClient.rerank(query, candidates, 5);
    }

    /** 流式问答:首字延迟从 3s 压到 300ms 量级 */
    public Flux<String> streamAnswer(String query) {
        List<Document> docs = retrieve(query);
        String context = docs.stream()
                .map(d -> "[%s] %s".formatted(d.getId(), d.getText()))
                .collect(Collectors.joining("\n---\n"));

        String systemPrompt = """
                你是企业知识库助手。规则:
                1. 仅依据【资料】回答,资料不足必须回答"暂无相关信息"
                2. 每条结论标注来源编号 [DOC-xxx]
                3. 禁止编造流程、人名、金额

                【资料】
                %s
                """.formatted(context);

        return chatModel.stream(new Prompt(
                new SystemMessage(systemPrompt),
                new UserMessage(query)))
            .mapNotNull(r -> r.getResult().getOutput().getText());
    }
}
如果检索源有多路,用虚拟线程并行召回 + RRF 融合:
java
@Service
public class HybridRetriever {

    private final VectorStore vectorStore;   // Spring AI 抽象:PGVector / Milvus / Redis
    private final Bm25Searcher bm25;
    private final ExecutorService vt = Executors.newVirtualThreadPerTaskExecutor();

    public List<Doc> retrieve(String query, int topK) {
        // 两路召回并行:虚拟线程让阻塞 IO 不占 OS 线程,万级并发也不炸线程池
        CompletableFuture<List<Doc>> semantic =
                CompletableFuture.supplyAsync(() -> vectorStore.similaritySearch(
                        SearchRequest.builder()
                                .query(query)
                                .topK(topK * 3)          // 多召回一些给 Rerank 用
                                .similarityThreshold(0.6)
                                .filterExpression("tenantId == '" + TenantContext.get() + "'") // 权限下推
                                .build())
                        .stream().map(Doc::from).toList(), vt);

        CompletableFuture<List<Doc>> lexical =
                CompletableFuture.supplyAsync(() -> bm25.search(query, topK * 3), vt);

        return rrf(List.of(semantic.join(), lexical.join()), 60).stream()
                .limit(topK).toList();
    }

    /** RRF:score = Σ 1/(k + rank),无需归一化分数,跨源可比 */
    private List<Doc> rrf(List<List<Doc>> ranks, int k) {
        Map<String, Double> score = new HashMap<>();
        Map<String, Doc> index = new HashMap<>();
        for (List<Doc> rank : ranks) {
            for (int i = 0; i < rank.size(); i++) {
                Doc d = rank.get(i);
                index.putIfAbsent(d.id(), d);
                score.merge(d.id(), 1.0 / (k + i + 1), Double::sum);
            }
        }
        return score.entrySet().stream()
                .sorted(Map.Entry.<String, Double>comparingByValue().reversed())
                .map(e -> index.get(e.getKey()))
                .toList();
    }
}
💡 技术亮点 :元数据过滤下推到向量库,先在租户/权限分区内检索,避免"检索到了但无权看"的越权泄漏;虚拟线程跑阻塞 IO,不用把全链路改造成 WebFlux 也能扛高并发。
5.5 入库侧:切分、异步向量化与缓存
java
@Service
public class IngestService {

    /** 离线入库:带重叠的切分,防止语义被腰斩 */
    public void ingest(List<Document> docs) {
        List<Document> chunks = new TokenTextSplitter(
                800, 200, 80, 5000, true).apply(docs);  // 块 800 token,重叠 200
        vectorStore.add(chunks);                        // 内部自动调 EmbeddingModel 向量化
    }
}

@Service
public class EmbeddingService {

    /** 异步向量化 + MD5 缓存:避免同一文本重复调 Embedding API */
    @Async
    public CompletableFuture<List<Float>> embedAsync(String text) {
        String cacheKey = DigestUtils.md5Hex(text);
        List<Float> cached = cacheService.get(cacheKey);
        if (cached != null) {
            return CompletableFuture.completedFuture(cached);
        }
        List<Float> vector = embeddingClient.embed(text).getResult().getOutput();
        cacheService.put(cacheKey, vector, Duration.ofHours(24));
        return CompletableFuture.completedFuture(vector);
    }
}
💡 技术亮点:异步非阻塞不卡主线程;MD5 缓存命中即跳过 API 调用,生产环境可省 30%+ 的 Embedding 费用。
5.6 两个绕不开的运维问题
知识库更新了,向量库还是旧的怎么办? 事件驱动 + 版本号对比 + 事务更新:
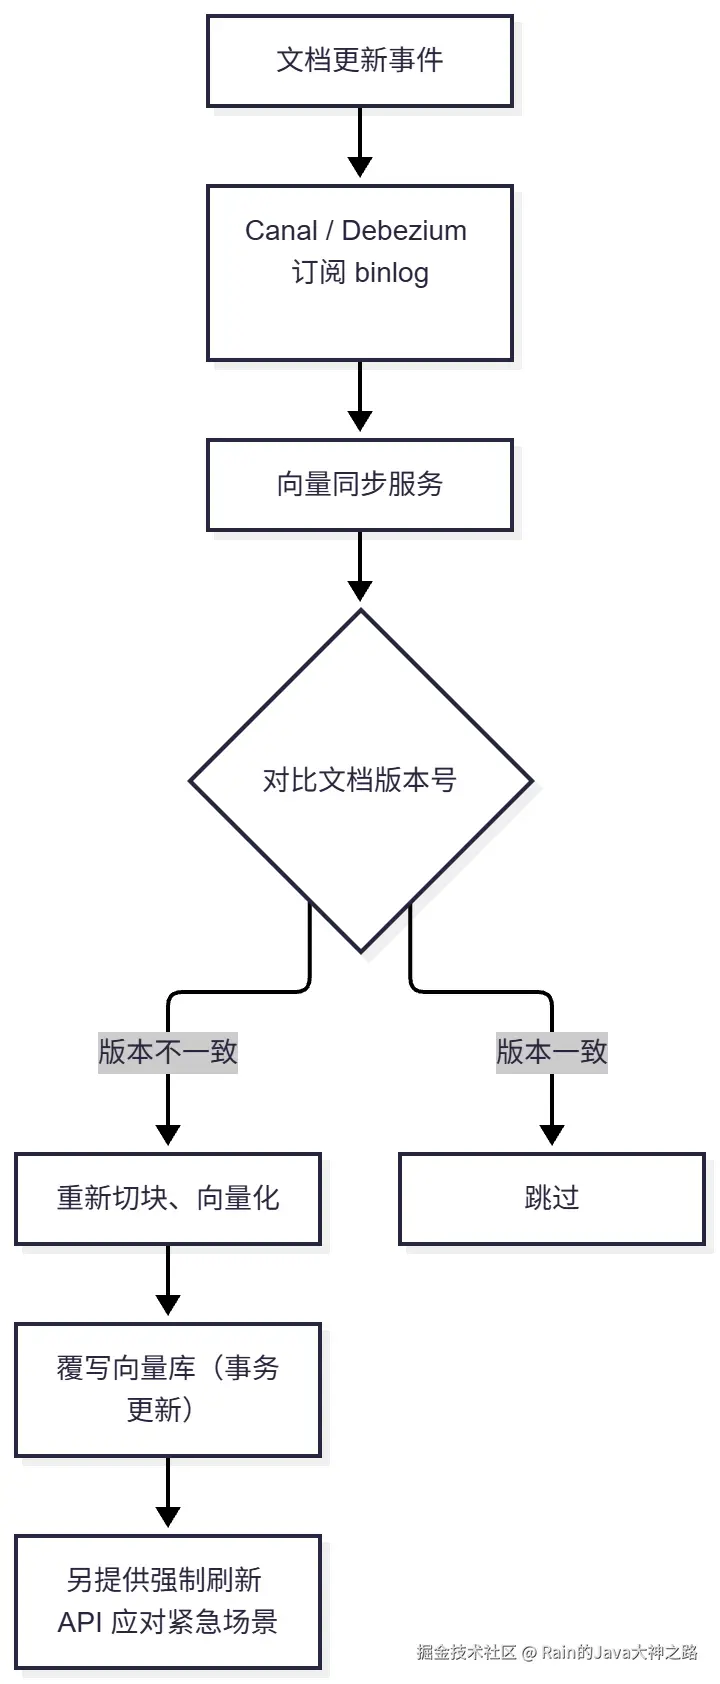
怎么证明你的 RAG 效果变好了? 建 golden 评测集(100~500 条问答对),盯三个指标:Recall@K (召没召回)、忠实度 Faithfulness (有没有编)、答案相关性 。每次改分块、改模型、改阈值都跑一遍回归,接进 CI 当门禁。RAG 不做自动评测就是信仰,靠数据说话,不靠感觉。
知识的问题解决了,但用户不只是来问问题的------他还想查订单、提工单、发起退款。这就轮到工具登场了。
六、Tool Calling:模型不执行工具,它只是"点了名"
这是最容易被答错的一个概念:
❌ 错误理解:AI 自己去调用接口。 ✅ 正确理解:AI 说"我需要调用
queryOrderStatus,参数orderId=SO2026...",真正执行的是我们的 Java 程序,执行完把结果回灌给模型,模型再组织语言。
text
用户提问 → AI 分析意图 → AI 输出「要调哪个工具 + 参数 JSON」
        → 我们的程序执行(含鉴权、限流、审计)→ 结果回灌 AI
        → AI 基于结果生成最终回答
这个"错位"恰恰是 Java 工程师的安全边界所在:所有真正的业务动作都在你的代码里,鉴权、幂等、审计、灰度,一个都跑不掉。
6.1 @Tool:描述就是给模型看的 API 文档
java
@Component
public class OrderTools {

    private final OrderService orderService;

    /** 工具描述就是给模型看的 API 文档,写不清楚模型必然误调用 */
    @Tool("按订单号查询订单状态与物流轨迹。只读操作,不会修改任何数据。")
    public String queryOrderStatus(
            @P("订单号,形如 SO202610150001") String orderId) {
        // 入参强校验:格式非法时返回明确错误文本,让模型有机会自我修正
        if (!orderId.matches("SO\\d{8,}")) {
            return "订单号格式非法,应为 SO 开头加数字,例如 SO202610150001";
        }
        return JsonUtils.toJson(orderService.queryStatus(orderId));
    }
}注解式声明零侵入,框架自动完成参数解析、类型转换、结果序列化。注意防御性校验的技巧:参数不合法时别抛异常了事,返回一段模型能看懂的错误说明,它会自己修正参数重试。
工具调不通、参数乱填是常态,生产上要加重试反馈闭环:
java
public ToolResult executeWithRetry(ToolCall call, int maxRetries) {
    for (int i = 0; i < maxRetries; i++) {
        try {
            Tool tool = toolRegistry.get(call.name());
            if (tool == null) throw new ToolNotFoundException("工具不存在:" + call.name());
            validateParams(tool.getInputSchema(), call.arguments());  // JSON Schema 强校验
            return tool.execute(call.arguments());
        } catch (ToolValidationException e) {
            call.setFeedback("参数错误:" + e.getMessage());          // 错误回灌,让模型自我修正
        }
    }
    return new ToolResult("error", "多次重试仍失败,请换个方式提问");
}
6.2 运行时收敛工具集:一个值回票价的优化
为什么不能把所有 @Tool 一次性挂给模型?三个理由:
- Token 成本爆炸:28 个工具能让单次请求从 800 Token 涨到 4200 Token;
- 模型选错:描述里"订单"出现 6 次,用户问"订单到哪了",它去调了退款接口;
- 权限边界失守:工具列表本身就是权限边界,写死在注解里等于把鉴权交给提示词------而提示词是拦不住越权的。
🚀 技术亮点 :用
ToolProvider按租户/角色/意图运行时动态下发工具集。我们把工具从 28 个收敛到 5~8 个后,单次请求 Token 从 4200 降到 1200,误调用率显著下降。
java
@Bean
ToolProvider scopedToolProvider(OrderTools orderTools, RefundTools refundTools) {
    return (ToolProviderRequest request) -> {
        UserContext ctx = UserContextHolder.current();   // 当前租户/角色,由网关透传
        ToolProviderResult.Builder builder = ToolProviderResult.builder();

        if (ctx.hasPermission("order:read") && looksLikeOrderQuestion(request.userMessage())) {
            builder.add(toolSpecification("queryOrderStatus"), executor(orderTools));
        }
        if (ctx.hasPermission("order:refund")) {         // 高危写操作单独授权,默认不给
            builder.add(toolSpecification("applyRefund"), executor(refundTools));
        }
        return builder.build();
    };
}
📎 注:
toolSpecification / executor为示意写法,实际用 LangChain4j 的ToolSpecifications等工具类生成,方法签名随版本变化,以官方文档为准。
工具是"手脚",那"这类活该按什么流程干"谁来管?答案是 Skills。
七、Skills:别把"操作手册"塞进 System Prompt
Skills 是把"某类任务该怎么做"沉淀成文件(
SKILL.md+ 脚本 + 参考资料),让 Agent 在需要时才加载的行为手册。
7.1 灵魂设计:渐进式披露(Progressive Disclosure)
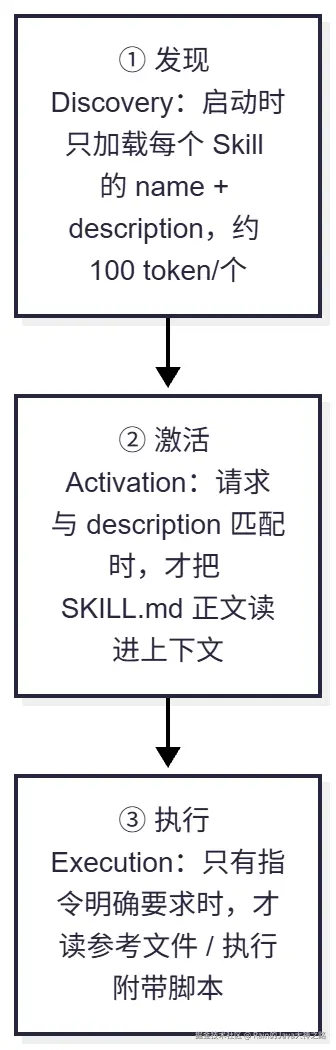
为什么这个设计值钱?看对比:
| 对比项 | 塞进 System Prompt | Skills |
|---|---|---|
| 加载时机 | 永远常驻,字字占预算 | 按需加载,不用就不花 Token |
| 规模上限 | 十几个流程就撑爆上下文 | 装 100 个 Skill 也只占摘要开销 |
| 可维护性 | 一改全乱、无法版本化 | 一个文件夹一个职责,可独立演进 |
用 Java 的类比:Skills 之于 Agent,就是"设计模式手册 + 操作规程"之于新员工。你不会让新员工入职第一天背完 500 页 SOP------你会给他一张清单,写明"遇到 XX 场景,去翻第 3 章"。反过来,System Prompt 就是"岗位 JD",必须常驻但必须极短。
7.2 落地三条硬规则
SKILL.md正文控制在 500 行以内,超了就拆;- 参考文件只放一层深------嵌套太深时 Agent 只会读到部分内容,拿到的信息是残缺的;
- 超过 100 行的参考文件,顶部必须放目录(TOC),让 Agent 在部分读取时也能看见全貌。
一个技能定义长这样:
yaml
# skill-definition.yaml ------ 一个「工单分类」技能
name: ticket-classifier
version: 1.2.0
description: 用户工单自动分类与优先级判定
prompt_template: prompts/classify.st        # 提示词模板
tools:                                      # 依赖的工具(MCP 暴露)
  - query_user_profile
  - lookup_sla_policy
inputs:  [ticket_content, user_level]
outputs: [category, priority, reason]
eval_dataset: eval/ticket-golden-500.jsonl  # 回归评测集
7.3 三组高频混淆,一次掰清
- Skills vs MCP :Skills 是"知道怎么做 "(SOP/流程),MCP 是"能碰到什么"(数据/动作)。Skill 的执行步骤里,通常会去调 MCP 工具;
- Skills vs Agent:Skill 是"会做某件事的工具人",被动调用、输入→输出;Agent 是"会自己决定做什么的员工",主动规划、循环、调用多个 Skill;
- Skills vs Prompt :Prompt 是这一次 要做什么,Skills 是这一类任务按什么流程做。
📎 趋势提示 :Agent Skills 已成为开放事实标准------同一套文件夹结构可被 Claude Code、Cursor、GitHub Copilot、Codex CLI、Gemini CLI 直接读取,"写一次,处处能跑"。JVM 侧也出现了对应抽象(如 LangChain4j 的
dev.langchain4j.skills),这个模式正在从"文档约定"走向"框架能力"。
Skills 管"怎么做",MCP 管"碰到什么",后者值得单独一大章------它是这两年 Java 圈最值得关注的新协议。
八、MCP:AI 世界的"USB-C 接口"
MCP(Model Context Protocol)是 Anthropic 于 2024 年底开源的开放标准,统一了"AI 应用如何安全、标准化地访问外部数据和工具"。 类比:HTTP 统一了 Web API 的发现与调用;MCP 统一了 AI 工具的发现(
tools/list)与调用(tools/call)。
8.1 它解决的是 M×N 集成灾难
在 MCP 之前:OpenAI Function Calling 一套、Claude 私有格式一套、LangChain 又一套------每个工具要写 N 套适配。在 MCP 之后:实现标准协议即可被任意支持 MCP 的客户端调用。
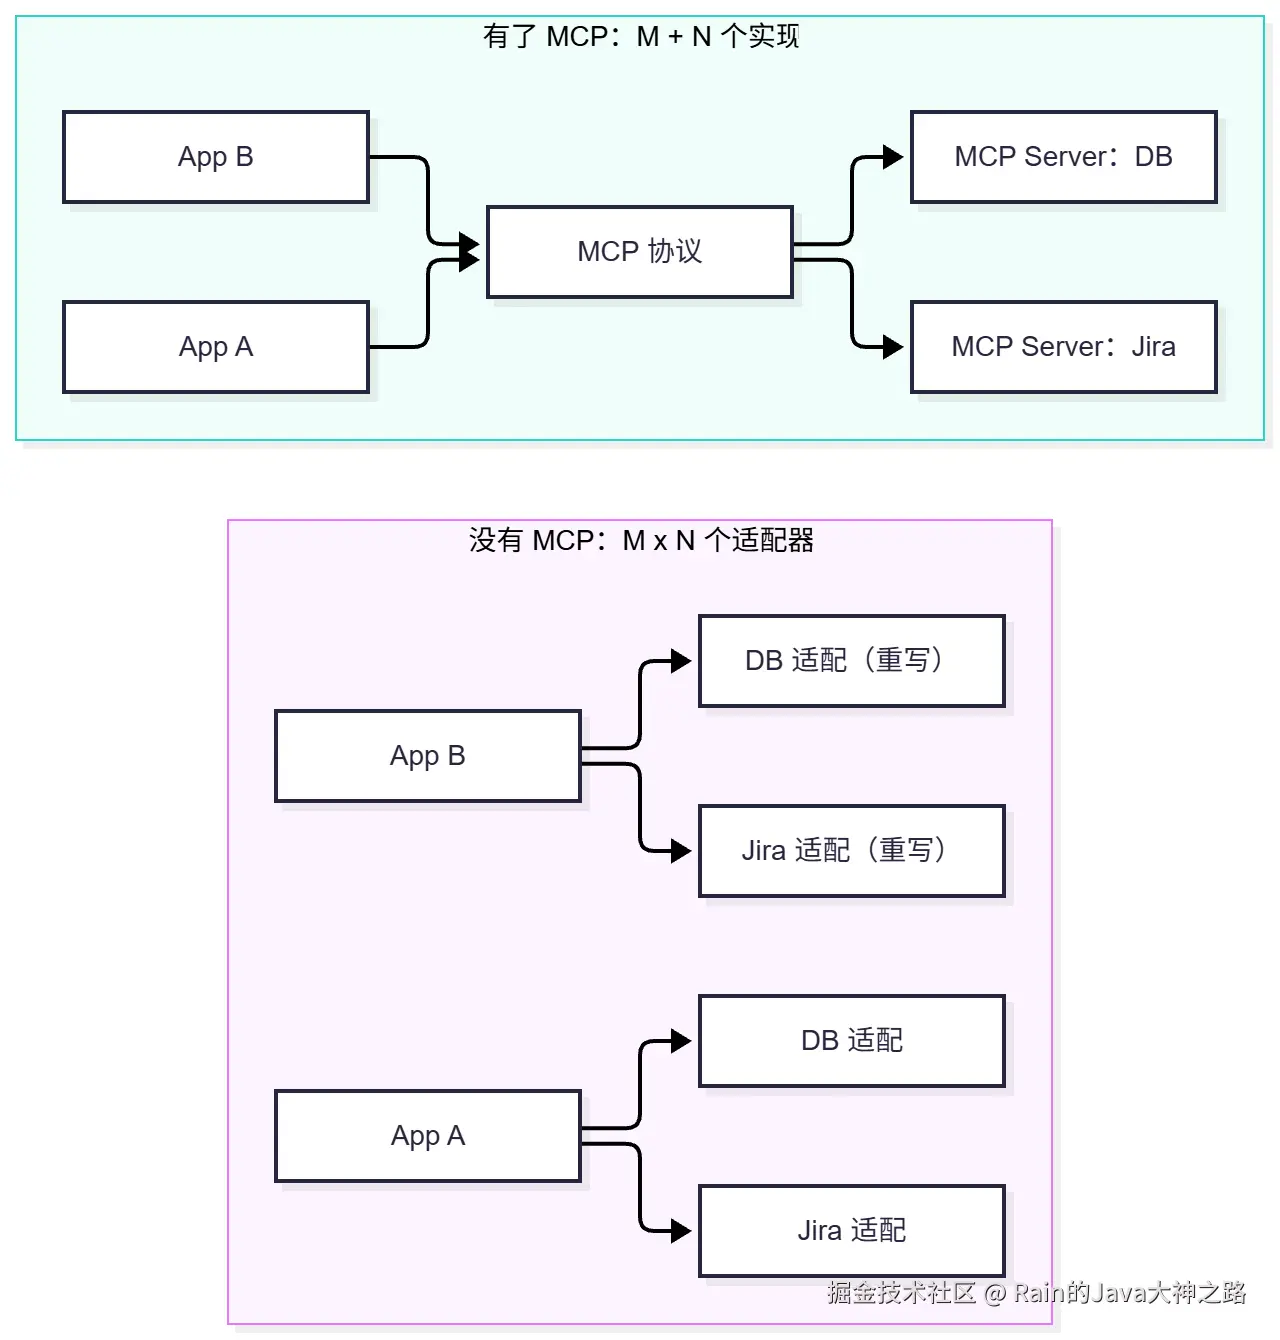
8.2 三个核心原语(基于 JSON-RPC 2.0)
| 原语 | 谁控制 | 含义 | 例子 |
|---|---|---|---|
| Tools | 模型控制 | 模型可调用的可执行函数 | 查询订单、写文件 |
| Resources | 应用控制 | 附加给模型的上下文数据 | 文件内容、配置、Git 历史 |
| Prompts | 用户控制 | 预定义提示模板 | 斜杠命令、菜单项 |
此外还有 Sampling:Server 反向请求 LLM 做推理,用于递归式智能任务。
8.3 传输方式演进(时效性知识,面试加分)
| 传输 | 场景 | 状态 |
|---|---|---|
| STDIO | 本地进程,客户端直接启动 Server | 适合本地 CLI 工具,无法跨网络 |
| SSE + HTTP | 远程部署 | 长连接占内存(约 80KB/连接)、弱网断线率高,Spring AI 2.0 起已标记废弃 |
| Streamable HTTP | 远程部署,首选 | 请求-响应与流式推送揉进同一套 HTTP 语义,网关/负载均衡/鉴权中间件都能正常介入 |
| Stateless Streamable HTTP | 无状态、Serverless | 内存 < 5KB/请求,请求可路由到任意实例 |
⏱️ 2026-07-28 新版规范(第 5 版,历次最大修订)三个关键变化:
- 从"有状态连接"全面转向"无状态核心"------取消协议级初始化握手、移除 Session ID,每个请求自包含,可水平扩展、可跑 Serverless;
- 引入版本化扩展框架 ,Extensions 成为一等公民(MCP Apps、Tasks),新增
server/discover能力发现、TTL/缓存语义;- 生产级加固 :强化 OAuth 2.0 / OIDC 适配,引入完整 JSON Schema 2020-12 和 W3C Trace Context 链路追踪------调用链和证据留存可追溯,对企业合规是决定性的。
8.4 MCP 和 Function Calling 到底啥关系
| Function Calling | MCP | |
|---|---|---|
| 定位 | 模型能力:输出结构化调用意图 | 工具供给协议:发现、传输、鉴权 |
| 耦合 | 绑定具体模型厂商 | 模型无关,换模型不用改工具 |
| 复用 | 每个应用各写一遍 | 一次实现,多应用/多模型复用 |
一句话:Function Calling 是动词,MCP 是 USB-C 接口。前者是模型侧"决定调哪个函数",后者是工程侧"函数/资源如何标准化接入",互补不冲突。
8.5 Java 程序员为什么必须关注
企业存量核心系统(订单、支付、风控、ERP、供应链)绝大多数是 Java 写的。MCP 的价值就在于让这些存量系统"零业务改动"地暴露给 AI。
三分钟把一个 Spring Boot 服务变成 MCP Server:
xml
<!-- 三选一:WebMVC 项目 / WebFlux 响应式项目 / 本地 STDIO 工具 -->
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-mcp-server-webmvc</artifactId>
</dependency>
yaml
# application.yml
spring:
  ai:
    mcp:
      server:
        name: order-mcp-server
        version: 1.0.0
        protocol: STREAMABLE            # 2.0 起 SSE 已废弃;可选 STREAMABLE / STATELESS
        streamable-http:
          mcp-endpoint: /api/mcp        # Streamable HTTP 端点
java
@SpringBootApplication
public class OrderMcpServerApplication {

    public static void main(String[] args) {
        SpringApplication.run(OrderMcpServerApplication.class, args);
    }

    /**
     * 存量 Service 一行不改,包一层就变成 AI 可调用的工具:
     * 自动配置会把所有 ToolCallback 合并注册为 MCP Tools。
     */
    @Bean
    ToolCallbackProvider orderTools(OrderService orderService) {
        return MethodToolCallbackProvider.builder()
                .toolObjects(orderService)      // 内部是 @Tool 标注的方法
                .build();
    }
}
客户端侧,一个 ToolProvider 可以同时挂多个 MCP Server:
java
// LangChain4j 风格:工具的召回交给模型运行时决策
@Bean
ToolProvider mcpToolProvider() {
    McpClient orderClient = new DefaultMcpClient.Builder()
            .transport(new HttpMcpTransport.Builder()
                    .sseUrl("http://order-mcp:8080/api/mcp")
                    .logRequests(true)
                    .logResponses(true)
                    .build())
            .build();

    return McpToolProvider.builder()
            .mcpClients(List.of(orderClient))
            .failIfOneServerFails(false)     // 单个 Server 挂了不影响其他工具
            .build();
}还可以运行时动态发现并注册新工具,新增外部工具只需部署一个 MCP Server,应用自动发现,无需重启,真正做到热插拔:
java
@Bean
public List<ToolCallback> dynamicMcpTools(McpClientManager manager) {
    return manager.getClients().stream()
            .flatMap(client -> client.listTools().stream())
            .map(tool -> (ToolCallback) tool)
            .collect(Collectors.toList());
}
8.6 安全红线与写操作纪律
⚠️ 安全红线 :Spring AI 官方文档明确------HTTP 传输的 MCP Server 默认暴露的是无鉴权的 JSON-RPC 端点 ,任何能访问到的客户端都能列出并调用全部工具。上线前必须前置安全边界 :OAuth2 / OIDC 鉴权、网关限流、工具级权限、调用审计。绝不能把 MCP Server 裸暴露在内网。
写操作工具还要守三条纪律:权限校验、二次确认(人在回路 HITL)、幂等:
java
/** 写操作工具:权限 + 二次确认 + 幂等 + 审计,一个都不能少 */
@Tool("提交报销单,写操作,需要用户确认")
public ExpenseResult submitExpense(SubmitExpenseRequest request) {
    // 幂等键控制:模型重试、网络抖动都不会导致重复提交
    return idempotentService.execute(
            request.idempotentKey(),
            () -> expenseService.submit(request));
}配套手段:idempotencyKey + 业务 outbox + 唯一索引;工具白名单、只读工具优先、高危写操作默认不开放。
手脚齐全了,最后需要一个"会自己干活的人"把它们组织起来------Agent 出场。
九、Agent:从"会思考"到"能交付"
Agent = LLM(大脑)+ Planning(规划)+ Memory(记忆)+ Tools(手脚) ,核心是自主决定下一步做什么。区别于 LLM 的"一问一答",Agent 是"给目标,自己完成"。
9.1 ReAct 循环:思考 → 行动 → 观察
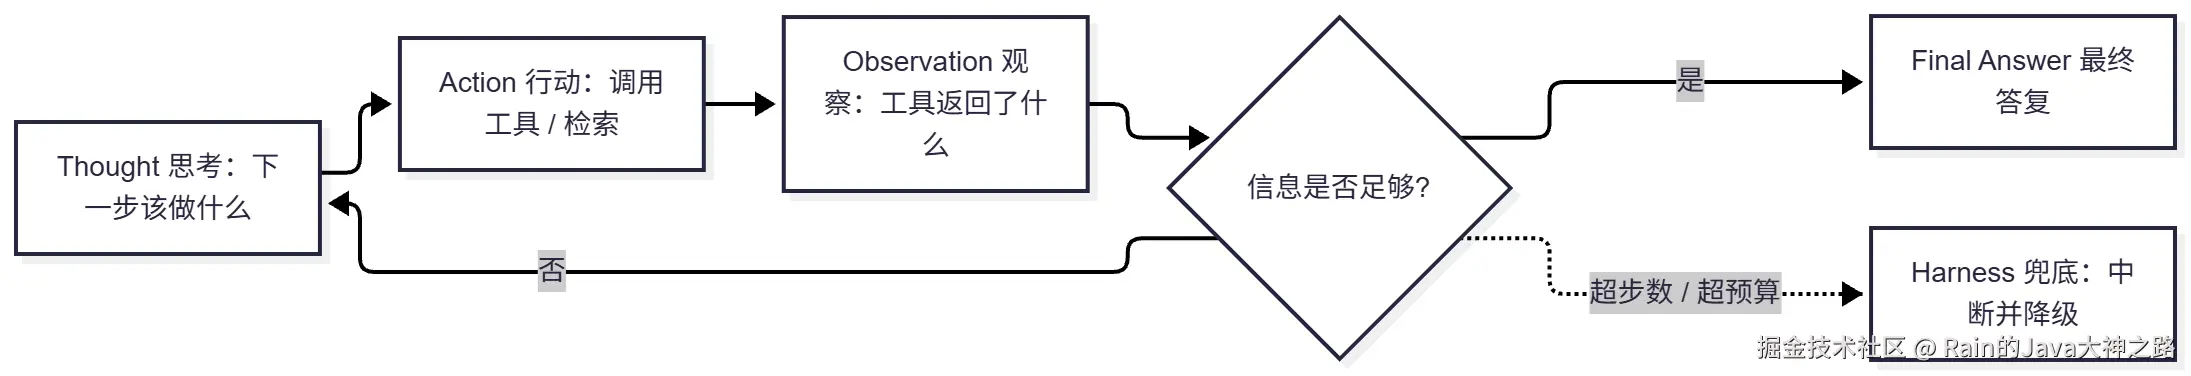
Java 里我们熟悉的责任链 + 策略模式,就很像这个决策循环:
java
while (未完成目标) {
    思考 nextStep;
    选择 tool;
    执行 tool.call(params);
    观察 toolResult;
    更新上下文;
}
9.2 三层递进范式:别混为一谈
| 层级 | 范式 | 解决什么问题 | 终止机制 | 风险 |
|---|---|---|---|---|
| 内层 · 推理 | ReAct(Thought → Action → Observation) | 单个智能体"怎么想、怎么动" | 模型自判断 | 易死循环、易提前终止 |
| 中层 · 调度 | 循环工程 Loop(图状态机 / 多智能体循环) | 多步骤任务"怎么跑完、怎么收敛" | 结构化规则 + 状态判断 | 无容错、无安全管控 |
| 外层 · 管控 | 驾驭工程 Harness(围栏、刹车、运维底座) | 生产环境"怎么可控、可上线" | 全局策略 | ------ |
公式 :
生产级多智能体 = 驾驭工程(外层管控)+ 循环工程(中层调度)+ ReAct(内层推理)
9.3 带"刹车和兜底"的 ReAct 循环
Demo 里只有一个 while(true),生产里它会死在第一道坎上。一个能上线的循环必须有四道防护:
java
/**
 * 四道防护:① 硬性步数上限 ② 工具异常转文本回灌 ③ 预算(时间/Token)熔断 ④ 兜底收敛话术
 */
public Answer run(String userInput, int maxSteps, long budgetMillis) {
    List<ChatMessage> messages = new ArrayList<>();
    messages.add(SystemMessage.from(REACT_PROMPT + renderToolSchemas()));
    messages.add(UserMessage.from(userInput));

    long deadline = System.currentTimeMillis() + budgetMillis;

    for (int step = 0; step < maxSteps; step++) {                    // ① 步数上限
        if (System.currentTimeMillis() > deadline) {                 // ③ 预算熔断
            return new Answer("任务超时,已停止并返回已获得的部分结论。");
        }

        AiMessage ai = chatModel.generate(messages).content();
        if (!ai.hasToolExecutionRequests()) {
            return new Answer(ai.text());                            // 收敛:给出最终答复
        }

        messages.add(ai);
        for (ToolExecutionRequest req : ai.toolExecutionRequests()) {
            String result;
            try {
                result = toolExecutor.execute(req, UserContextHolder.tenantId());
                result = truncate(result, 2000);                     // 截断:防工具结果撑爆上下文
            } catch (Exception e) {
                // ② 异常不让它抛穿:转成文本回灌,模型有机会换一条路
                result = "TOOL_ERROR: " + e.getMessage() + ",请更换方式或告知用户稍后重试。";
            }
            messages.add(ToolExecutionResultMessage.from(req, result));
        }
        // 超过预算就压缩历史:保留最近 N 轮 + 早期摘要
        messages = contextCompactor.compact(messages, TOKEN_BUDGET);
    }
    return new Answer("步骤超限,已中断。请把问题拆得更小一些。");       // ④ 兜底
}
💡 技术亮点 :除了
MAX_STEPS,还要做工具调用去重 ------同一工具同参数连续调用直接短路,这是"反复调同一工具烧钱不收敛"的特效药;ToolResponse必须截断,一个 10 万行的 SQL 结果塞进上下文等于直接爆 token。
上下文压缩的常见实现:记录每轮 token 数,超限时把旧消息做摘要,保留最近几轮原话:
java
public List<Message> manageContext(List<Message> history) {
    int tokenCount = countTokens(history);
    if (tokenCount < MAX_TOKENS * 0.8) return history;

    // 取前一半旧消息生成摘要
    List<Message> oldMsgs = history.subList(0, history.size() / 2);
    String summary = llm.call("请用一句话总结以下对话:", oldMsgs);

    // 新上下文 = 摘要 + 最近几轮原话
    List<Message> newContext = new ArrayList<>();
    newContext.add(new SystemMessage("历史摘要:" + summary));
    newContext.addAll(history.subList(history.size() / 2, history.size()));
    return newContext;
}
9.4 框架层面:AiServices 极简装配
自己写循环是为了理解原理,实际项目直接用框架,ReAct 推理循环它帮你实现了:
java
@Configuration
public class AgentConfig {

    @Bean
    public CustomerServiceAgent customerServiceAgent(
            ChatLanguageModel chatModel,
            OrderQuerySkill orderSkill,
            LogisticsQuerySkill logisticsSkill) {

        return AiServices.builder(CustomerServiceAgent.class)
                .chatLanguageModel(chatModel)
                .tools(orderSkill, logisticsSkill)                       // 注入业务技能
                .chatMemory(MessageWindowChatMemory.withMaxMessages(20)) // 对话记忆
                .maxIterations(5)                                        // 最大决策步数,防死循环
                .timeout(Duration.ofSeconds(30))                         // 全局超时
                .build();
    }
    // 使用:agent.chat("我的订单 1001 什么时候到?")
}记忆分两层:短期记忆 用滑动窗口(MessageWindowChatMemory),长期记忆可以落向量库,按用户画像检索。
9.5 Agent vs Workflow:别为了用 Agent 而用 Agent
Workflow 是路径写死,Agent 是路径由模型决定。能确定性解决的流程就用 Workflow,稳定又便宜;只有任务路径真的无法预知时,才值得上 Agent------这是成本与稳定性的问题,不是技术问题。
评估一个 Agent 好不好,看这些指标:任务完成率、平均步数、工具调用准确率、端到端延迟、成本/token,再配合轨迹回放(Trace)排查失败原因。
概念全讲完了,它们到底怎么协同?来看一次完整的请求。
十、端到端串讲:一次客服请求的全链路
场景:电商智能客服,用户问------"我的订单 SO202610150001 为什么还没发货?"
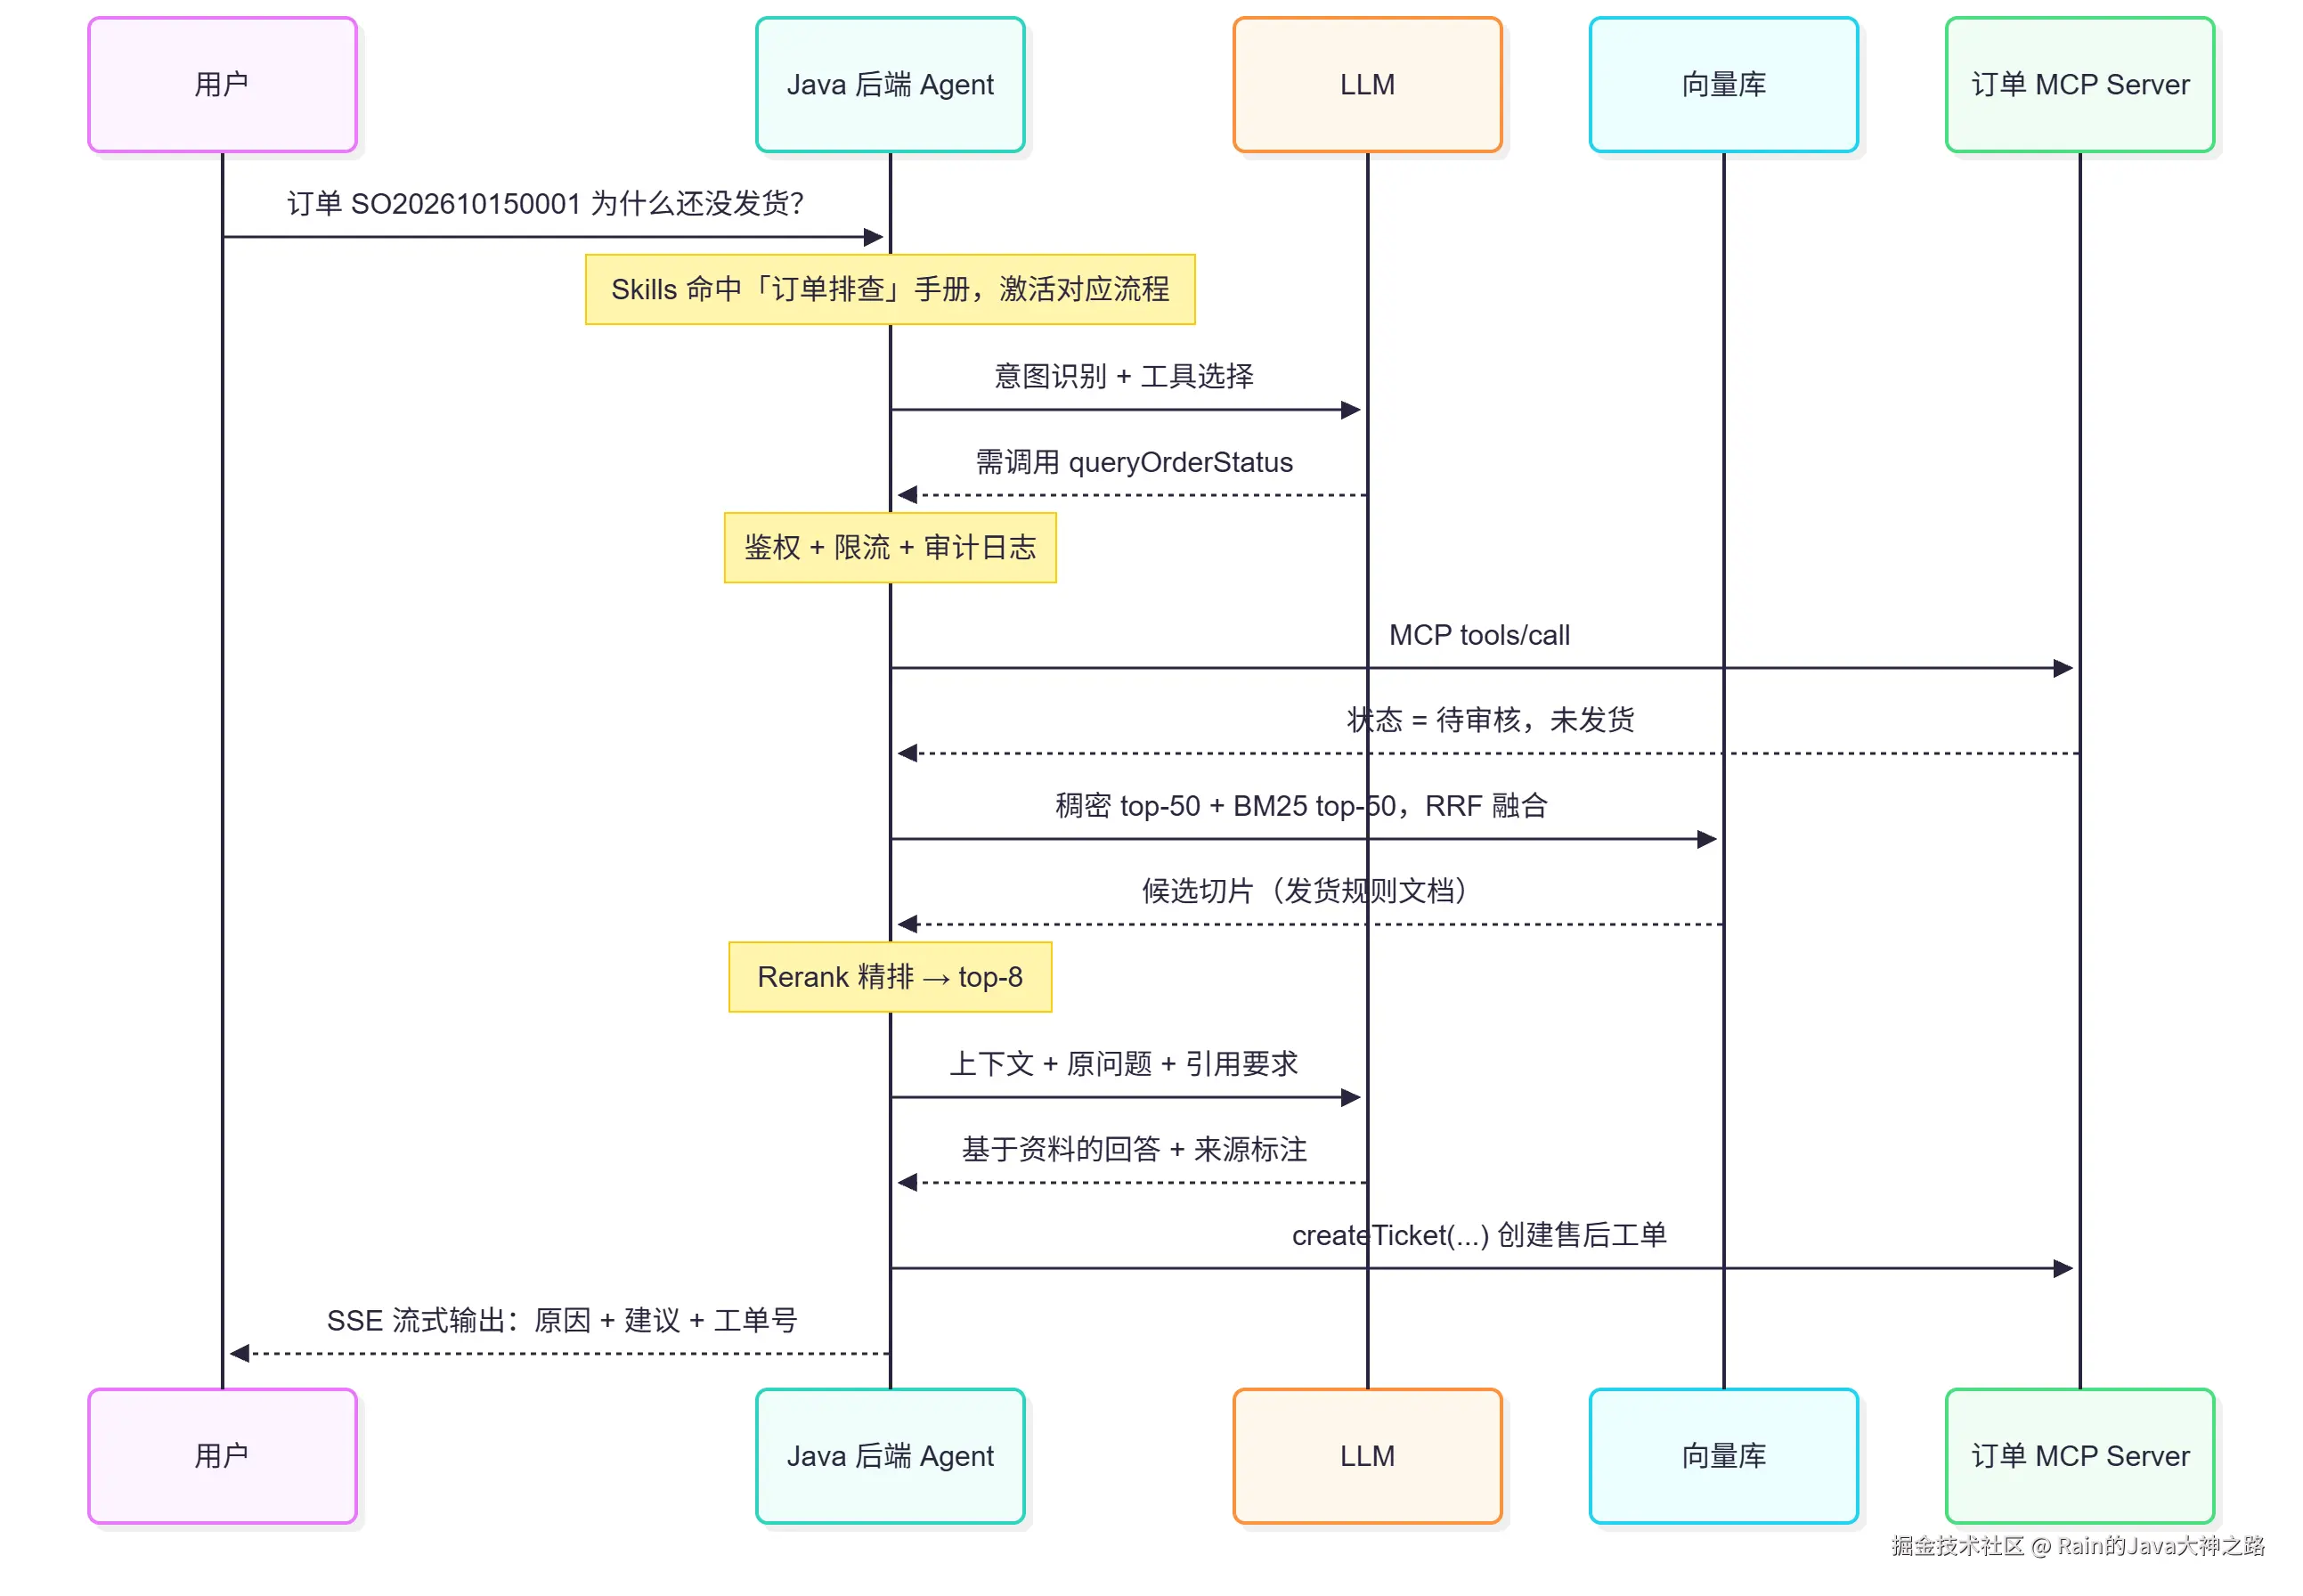
这条链路里,所有概念都出场了:Skills 决定流程 → LLM 做意图识别 → Tool 决定动作 → MCP 打通存量系统 → RAG 补业务知识 → 向量与余弦相似度负责召回 → 最后回到工程治理层保证稳定、安全、便宜。不是把全部知识塞给 LLM,而是 Agent 决定查什么、调什么、怎么答。
同样的骨架换个场景一样成立:
- 企业差旅助手 :"差旅报销标准是什么?我上个月有没有未报销单据?"------意图识别拆成两个子问题,RAG 查制度(回答带
[DOC-013]引用),MCP 查报销系统拿到 2 笔未报销单据,最后还能追问"要不要帮你提交"; - 智能运维助手 :"昨天服务器 CPU 告警多少次?"------RAG 检索操作手册无果,转调监控系统的
getAlerts(...)工具,拿到"35 次"后由 LLM 组织成自然语言回答。
知识问答 + 业务查询 + 可继续执行动作,三者齐活,这才是企业级 AI 应用。
十一、工程治理层:Java 的主场
面试官真正想听的下一句往往是:"如果 1000 个用户同时问,你的 Spring Boot 后端怎么设计?"三道防护,缺一不可:
java
/**
 * ① 流式输出(SSE + WebFlux):大模型很慢,绝不能同步阻塞,边生成边返回压 TTFT;
 * ② 多租户限流:按租户做 Redis 令牌桶,防止某个租户把配额吃光;
 * ③ 超时降级:模型超时不能挂页面,降级到"知识库直出"保住可用性。
 */
@GetMapping(value = "/chat/stream", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
public Flux<String> stream(@RequestParam String q,
                           @RequestHeader("X-Tenant-Id") String tenantId) {

    return redisRateLimiter.acquire(tenantId)                 // ② Redis + Lua 令牌桶
            .filter(RateLimitResult::allowed)
            .switchIfEmpty(Flux.error(new BizException("TOO_MANY_REQUESTS")))
            .flatMapMany(ok -> chatClient.prompt()
                    .user(q)
                    .stream()                                  // ① 流式
                    .content()
                    .timeout(Duration.ofSeconds(30))           // ③ 整体超时
                    .onErrorResume(e ->                        // ③ 降级兜底
                            Flux.just("模型服务繁忙,已为你返回知识库原文检索结果。")));
}这几个数字要能报出来,它们体现的是工程体感:
- 流式输出:首字延迟从 8s 降到 500ms 量级,"打字机效果"直接决定用户去留;
- 语义缓存 :重复问题命中缓存后跳过"检索 + 重排 + 生成"全链路,推理成本可降 40%~70%;
- 模型分层路由 :"意图识别、格式转换"给小模型,"复杂推理、关键决策"给旗舰模型,整体成本可降 40%~60%;
- 模型抽象 :因为做了统一
ChatModel抽象,换模型 = 改一条配置;没有抽象的项目,换模型 ≈ 重新开发。
其余几件老本行的事,一件都不能少:
- 多租户隔离 :元数据带
tenantId / acl / version,在检索阶段做 pre-filter,向量库按租户分区------不能只靠"检索后再过滤"; - 可观测:全链路 trace 打点 prompt / token / latency / 工具调用,Micrometer + OpenTelemetry,再用 W3C Trace Context 打通 MCP 全链路;
- 模型挂了三层兜底 :同模型多 Key/多地域重试 → 换备选模型(靠统一抽象层)→ 降级到知识库原文直出。可用性靠架构,不靠模型;
- 数据安全:网关层脱敏,敏感字段不进模型,必要时私有化部署。
十二、踩坑大全:技术难点与解决方案对照表
这张表融合了所有一线踩坑,建议直接收藏当检查清单用:
| # | 难点 | 典型表现 | 解决方案 | Java 侧抓手 |
|---|---|---|---|---|
| 1 | 幻觉 | 一本正经编造订单号/政策 | Prompt 硬约束 + 强制引用 + 低温度 + 阈值拒答 + 人工兜底;RAG 只能降低概率,不能彻底消除 | 系统提示 + Advisor + 引用回填 |
| 2 | 检索召回不准 | 向量相似 ≠ 语义相关;编号/术语/人名是稠密检索死穴 | 混合检索(Dense + BM25 → RRF)→ Cross-Encoder 重排 → top-5~8;Multi-Query 查询改写 | ES 一次查询吃 BM25 + 向量;similarityThreshold 调参 |
| 3 | 切片语义割裂 | 固定长度硬切,论证被腰斩 | 结构感知切片 + 10%~20% overlap + 父子块(子块检索、父块喂模型)+ 元数据增强 | 可插拔切片器,策略变更走离线评测 |
| 4 | 上下文爆炸 / 成本失控 | Agent 多步任务 Token 消耗是普通对话几十倍 | 滑动窗口 + 历史摘要 + 工具结果截断 + Skills 按需加载 + 语义缓存 + 模型分层路由 + 稳定前缀提 KV Cache 命中 | Redis 语义缓存 + 网关 Token 计量 + 成本看板 |
| 5 | Agent 死循环 / 失控 | 反复调同一工具、跑偏、无限烧钱 | 硬性步数上限 + 时间/Token 双预算熔断 + 调用去重 + 图状态机替代 while(true) |
maxIterations + Spring StateMachine |
| 6 | 工具误调用 / 参数错误 | 查订单却调了退款接口;参数格式乱填 | 优化 @Tool 描述 + Few-shot 示例 + JSON Schema 强校验 + 错误回灌重试闭环 + 运行时收敛工具集 |
ToolProvider 动态决策 + Bean Validation |
| 7 | 工具安全 / 越权 | Prompt 注入、越权查他人订单 | 权限过滤下推检索层 + 工具白名单 + 最小权限 + 审计日志 + 高危操作人在回路(HITL) | Spring Security 工具级权限 + 网关透传用户上下文 |
| 8 | MCP 生产化 | HTTP 端点默认无鉴权,裸暴露即裸奔 | OAuth2/OIDC 前置 + 网关限流 + 工具级权限 + 调用审计;优先 Streamable HTTP / STATELESS | Spring Security + MCP Server + W3C Trace Context |
| 9 | 高并发与延迟 | 同步阻塞打满线程池;用户等 8 秒才见字 | WebFlux + SSE 流式 + 虚拟线程 + 并行召回 + 多租户令牌桶 + 超时降级知识库直出 | Redis + Lua 令牌桶、timeout + onErrorResume |
| 10 | 多租户数据泄露 | 不同客户文档混在一个向量库 | 元数据 tenantId 检索阶段 pre-filter + 按租户 Partition/Collection 隔离 |
向量库 filter 表达式 + 请求级租户上下文 |
| 11 | 向量数据不一致 | 业务库更新了,检索还是旧答案 | Canal/CDC/Debezium 订阅 binlog 增量同步 + 版本号对比 + 定时全量对账 + 强制刷新 API | 事件驱动 + 事务更新 |
| 12 | 写操作幂等 | 重试导致重复退款 / 重复提单 | idempotencyKey + 业务 outbox + 唯一索引 + 二次确认 |
AOP 前置校验 + 幂等服务 |
| 13 | 效果无法度量 | "感觉还行",上线后无法回归 | 黄金问答集,量化 recall@k / 忠实度 / 幻觉率;Prompt 与切片变更过回归门禁 | RAGAS / TruLens 接入 CI |
| 14 | 技术栈易碎 | 模型、协议、框架月月迭代(MCP 一年内规范大改、SSE 转弃用) | 把变化关进适配层:模型统一 ChatModel 抽象、工具走 MCP 标准协议、Prompt 版本化 |
接口抽象 + 配置驱动 + 契约测试 |
| 15 | 多轮上下文丢失 | "它的标准是多少?"不知道"它"指谁 | 基于历史会话做问题改写,补全指代再检索 | Query Rewrite 组件 |
| 16 | 数据安全 | 敏感数据进入模型 | 网关脱敏 + 权限过滤 + 私有化部署 | 网关过滤器 + 数据分级 |
十三、快问快答:面试官的连环追问
| # | 追问 | 一句话回答 |
|---|---|---|
| 1 | 余弦相似度为什么不用欧氏距离? | 文本语义更关心方向而非长度,模长受文本长度影响会引入噪声;归一化后两者排序等价 |
| 2 | 归一化后为什么用内积? | 省掉查询期两次开方和一次除法,检索是热路径,收益直接体现在 P99 |
| 3 | 向量库和 ES 有什么区别? | 向量库专精 ANN 与高维检索;ES 强在"一套系统同时做文本与向量",混合检索最省事。选型看运维成本和规模 |
| 4 | 有了 1M 上下文还要 RAG? | 长上下文是预算 不是替代。资料越多噪音越多、成本延迟越高,RAG 解决"先过滤再喂" |
| 5 | RAG 和微调怎么选? | 知识频繁更新、要引用可追溯 → RAG;固定风格、专业格式、压缩 Prompt → 微调。生产常组合:小模型微调 + RAG 检索 + Agent 工具 |
| 6 | Agent 和 Workflow 的区别? | Workflow 路径写死,Agent 路径由模型决定。能确定性解决就用 Workflow,别为了用 Agent 而用 Agent |
| 7 | MCP 和 Function Calling 的关系? | FC 是模型侧"决定调哪个函数",MCP 是工程侧"函数如何标准化接入"。MCP 让工具一次实现、多处复用 |
| 8 | Skills 和 Prompt 的区别? | Prompt 是这一次 做什么,Skills 是这一类任务按什么流程做,靠渐进式披露做到"装很多但不占上下文" |
| 9 | 为什么需要 Rerank? | 向量召回是双塔独立编码,无法深度交互;Rerank 交叉编码准但慢,所以只对 Top-50 精排 |
| 10 | 向量维度多少合适? | 常见 768/1024/1536/3072,维度越高表达越细但成本线性增长,企业级常用 1024 + PQ 量化 |
| 11 | 模型挂了怎么办? | 三层兜底:多 Key/多地域重试 → 换备选模型 → 知识库原文直出。可用性靠架构,不靠模型 |
| 12 | 怎么证明 RAG 有效? | 黄金问答集,量化 recall@k / 忠实度 / 幻觉率,Prompt 与切片变更必须过回归门禁 |
| 13 | Java 做 AI 比 Python 强在哪? | 模型层 Python 生态更好,但工程层 Java 更强:虚拟线程扛高并发、强类型契合结构化输出、成熟的微服务/熔断/可观测体系,而且企业 90% 的业务系统本身就是 Java 写的------MCP Server 直接挂在现有服务上,不用重写 |
十四、收尾:一张速查表 + 三句忠告
概念速查表,存好:
| 概念 | 一句话本质 | 关键参数 / 关注点 | Java 落地 |
|---|---|---|---|
| LLM | 概率生成模型,不是知识库 | temperature、maxTokens、上下文预算 | ChatModel / ChatClient |
| Token | 计费与长度单位 | 中文约 1 字 ≈ 1~1.5 token | 网关侧计量与配额 |
| Embedding | 把语义变成高维坐标 | 维度、是否 L2 归一化、模型一致性 | EmbeddingModel.embed() |
| 余弦相似度 | 只看方向的相似度 | -1,1;归一化后 == 内积 | 手写兜底 + 交给向量库 |
| 向量库 | 高维向量的存储与 ANN 检索 | recall@K、HNSW efSearch、IVF nprobe |
Milvus / pgvector / ES 8.x |
| RAG | 外部知识管理 + 检索 + 生成 | topK、阈值、切片策略、Rerank | QuestionAnswerAdvisor |
| Tool Calling | 模型点名,程序执行 | 描述质量、参数 Schema、权限 | @Tool / ToolCallback |
| Agent | 自己决定下一步干什么 | 步数上限、预算熔断、终止条件 | AiServices + 状态机 |
| MCP | AI 工具的统一插座 | Tools/Resources/Prompts;Streamable HTTP | spring-ai-starter-mcp-server-* |
| Skills | 按需加载的行为手册 | 渐进式披露、SKILL.md < 500 行、引用只放一层 |
文件目录 + 按需注入 |
最后送三句忠告,都是真金白银换来的:
- 把 LLM 当成一个"不可靠的第三方服务"来治理------超时、重试、熔断、降级、可观测,老本行一套都不能少,只是这次处理的是概率性输出;
- 用 RAG 把答案锚定在事实上,用评测集把效果变成数字------这两件事做了,项目才算从 Demo 走向生产;
- Skills、MCP、Agent 本质都是面向对象思想在 AI 时代的复用:封装、抽象、标准化接口。想清楚这一点,新名词再多也不慌。
记住这句话就够了:AI 应用的本质,是把"不确定的模型能力",装进"确定的工程系统"里。而这件事,恰好是 Java 工程师最擅长的事。 造发动机的不多,造整车、修高速、建加油站的,才是大多数人的战场。
聊个具体的:你做 RAG 或 Agent 落地时,踩过最疼的坑是哪个?切片把语义切碎了、检索召不准、还是模型一本正经地编?评论区聊聊你的场景和参数,我看到会挨个回复交流。
如果这篇全景图帮你把概念串起来了,点个赞、点个在看、顺手关注一下------后续还会持续更新 Java AI 工程化的实战干货,比如混合检索调参实录和 Agent 状态机设计,别错过。