【轻量化复刻大模型 / KIMI K3】AttnRes 模块交互式演示
0x00 概述
本文是AttnRes (Attention Residuals) 的完整交互式演示,9 个 Tab 覆盖深度注意力混合的核心机制、Block vs Full 形式对比、内存有界性验证、RMSNorm 防垄断、梯度流通等。全部 CPU 实时运行,复用 attn_res.py 和 norm.py 真实源码算子。
如何启动:
python experiments\models\llm\kimi_k3\modules\attnres\gradio_attnres_demo.py浏览器打开 http://localhost:7860
注:
- 项目github.com/RossiLH/Mod... 和系列博客是我的一个尝试,也是我学习的过程。不确定是否满足读者的需求,我自己会反思改进,也希望大家提出宝贵意见。
- 涉及 KIMI K3,DeepSeek V4,PI0.5,PI0.7 等模型。后续可能会跟踪新模型。
- 全 CPU 复刻,不涉及 GPU,也不涉及大规模训练(这是另外一个庞杂深邃的领域)和硬件。
- 模型的组件尽量是原始大模型的缩小版,如果组件没有开源版本,则用近似组件替代。
- 会解释每个组件在解决一个什么问题、这个问题难在哪、为什么只能这么解、解法的原理是什么,以及组件之间如何咬合成一个整体。重点不是记名词,而是理解一条主线。
- 每个主要组件都有可直接运行的 Gradio demo------无需 GPU。另有若干可视化脚本(
plot_*.py),可生成静态图。 - 所有文件行号基于本地源码快照;源码后续变化时,行号可能移动,但函数名和调用关系仍可作为定位入口。
- 为了保证每个文章可以尽量独立成文,所以有些内容会在不同文章中都存在,可能在系列层面上存在冗余,还请大家理解。
0x01 核心数学
AttnRes 把 attention 从时间维迁移到深度维 --- 标准残差流把所有历史输出等权相加(深度维的无差别瓶颈),AttnRes 让第 l 层用一个可学习伪查询去软注意之前所有层的输出:
ini
q_l = w_l                     # 可学习伪查询(每层一个向量)
k_i = v_i = f_i(h_i),  k_0 = v_0 = h_1   # embedding 永远是源
phi(q, k) = exp(q^T RMSNorm(k))          # 打分核(RMSNorm 防幅值垄断)
alpha_{i->l} = phi(q_l, k_i) / sum_j phi  # softmax 归一化
h_l = sum_i alpha_{i->l} v_i             # 加权混合(Eq. 9)
关键洞察 : h_l 是混合本身,不是 "上一状态 + 新增"。均匀累加只是 alpha 的一个退化设置。
1.1 Block vs Full
- Full 形式 (Eqs. 8‑9):每层输出都保留为独立 source,算术 O (L²d)、内存 O (Ld)
- Block 形式 (Eq. 10):把 L 层切成 N 块,每块塌缩成单个求和表示 b_n,内存降到 O (Nd)
- 退化关系: block_units=1 时 Block 自动退化为 Full
1.2 状态机 API
ini
state = attnres.init_state(embedding)  # b_0 = h_1
for i, layer in enumerate(layers):
    h = attnres.mix(state, i)          # 深度注意力混合
    out = layer(h)                     # 子层变换
    state = attnres.add_output(state, out)  # 块归档
out = attnres.finalize(state)          # 最终聚合
0x02 Tab 1: Demo 四联图
2.1 目的
通过一个 copy 任务的训练过程,展示 AttnRes 的核心行为:训练前 alpha 均匀(等价标准残差),训练后 alpha 学会重点读 embedding;Block 形式内存有界 vs Full 形式线性增长;AttnRes vs 标准残差的训练收敛速度对比。
2.2 Copy 任务是什么
Copy 任务定义:给定随机输入 x, 模型输出必须逼近 x 本身(即 target = input)。损失函数为 MSE。
训练代码位于 gradio_attnres_demo.py 第 190‑203 行 (tab_demo_four 函数内),也复用于 demo_attn_res.py 第 131‑145 行:
ini
for step in range(steps):
    x = torch.randn(batch, 1, dim)        # 随机输入
    opt.zero_grad()
    out_a, _ = _forward_attnres(layers, attnres, x)
    la = torch.nn.functional.mse_loss(out_a, x)  # 目标 = 输入 x
    la.backward()
    opt.step()
为什么用 copy 任务 : 标准残差把 6 层输出等权加起来,输入信息被逐层稀释;AttnRes 则学会通过 softmax 注意力把权重集中在 embedding (source 1) 上,从而直接读回 x。这是最简单的验证 AttnRes "选择性读取" 能力的任务。
具体演示了 4 件事:
- w=0 初始化 == 均匀 == 标准残差 :训练前最后 unit 的
alpha = [0.3333, 0.3333, 0.3333](softmax(0) 均匀),与"等权相加"无差别 ------ 这就是"从 baseline 平滑出发"的实锤(论文零初始化要求)。 - 选择性读取 :训练后同一 unit 的
alpha = [0.0422, 0.0003, 0.9575]------模型学会把权重集中在 embedding 源上直接读回输入;而纯残差只能把 6 层输出等权相加(输入被稀释)。这也复现了论文的"embedding 作为深度维 attention sink"。 - 收敛优势 :相同层权重、唯一区别是路由方式,AttnRes 最终 MSE
7.57e-5vs 标准残差0.0572(约 750 倍差距),验证了"input-dependent 深度路由是关键增益"。 - Block 内存有界 :源数演进 Block
[1,2,2,2,3,3,3](n_units=6、block_units=3 时最多 3 个源)vs Full[1,2,3,4,5,6,7](线性增长)------ 印证O(Ld)→O(Nd)的内存降维。
2.3 UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| dim | 4‑64 | 16 | 隐藏维度。增大 → 模型容量更高,训练更慢但可能更准 |
| n_units | 2‑20 | 6 | 子层数量。增大 → 深度更深,alpha 分布更复杂 |
| block_units | 1‑10 | 3 | 块大小。增大 → Full 形式;增大 → 块数减少,内存更低但精度可能下降 |
| steps | 50‑500 | 260 | 训练步数。增大 → 训练更充分,alpha 分布更分化 |
| batch | 4‑64 | 16 | 批大小。增大 → 梯度更稳定,训练更平滑 |
| lr | 0.005‑0.1 | 0.02 | 学习率。增大 → 收敛更快但可能不稳定 |
2.4 输出图解读
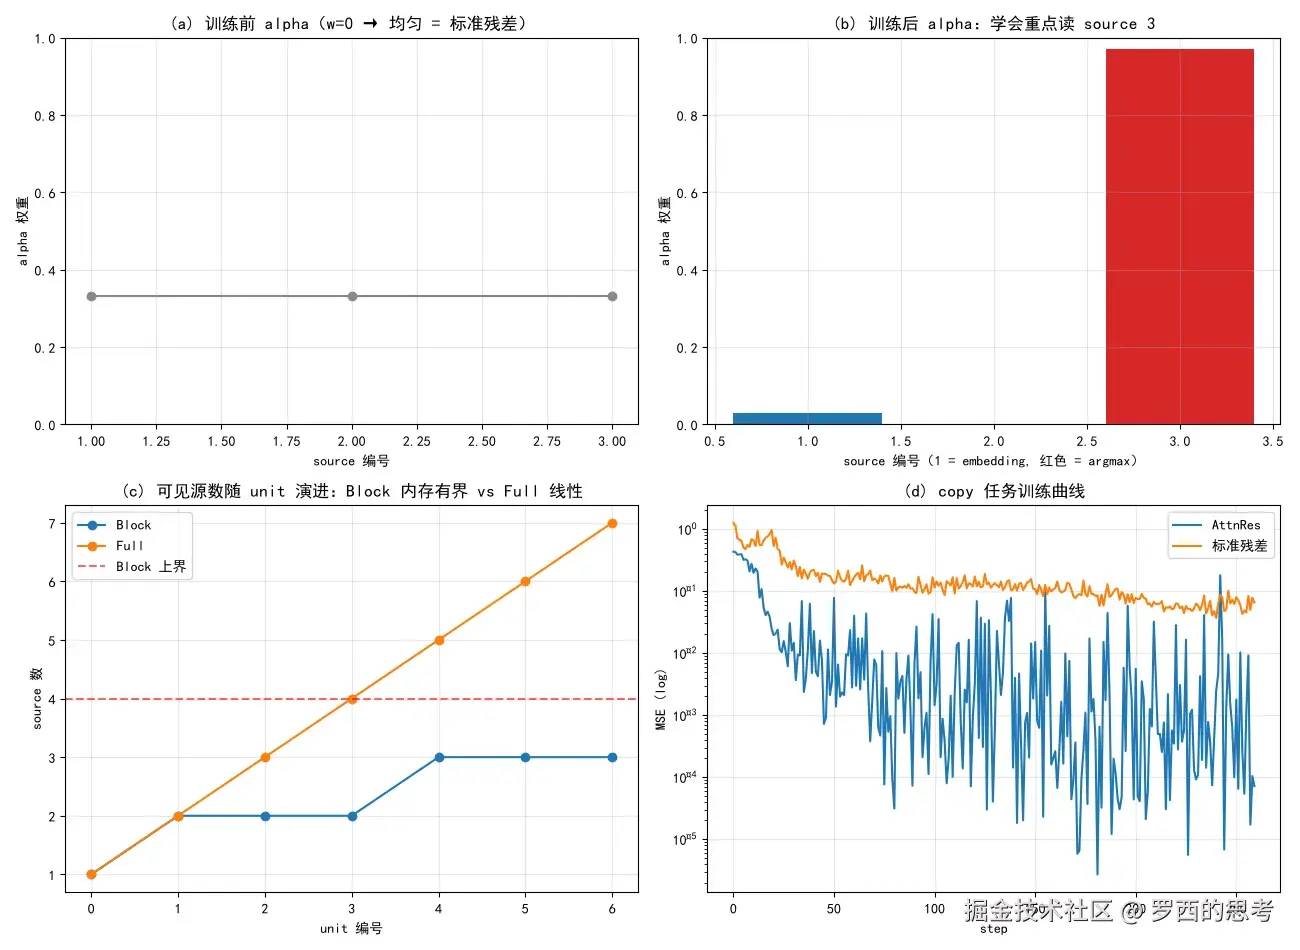
tab-1
2×2 四联图:
-
左上 (a): 训练前 alpha
- 灰色折线图,X 轴 = source 编号,Y 轴 = alpha 权重
- 初始时
queries权重接近 0 → softmax 输出近似均匀 → 所有 source 权重相等 - 这就是标准残差的行为:
h_l = h_{l‑1} + F_l(h_{l‑1})等价于 alpha 全等
-
右上 (b): 训练后 alpha
- 柱状图,红色柱 = argmax(学到的最重要源) ,蓝色柱 = 其他 source
- 训练后 argmax 是 source 3(最新块,alpha ≈ 0.49),不是 embedding(alpha ≈ 0.10)
- 物理意义:copy 任务的目标 = 输入本身,最后一层输出最接近输入,所以模型学到"读最新层比读 embedding 更直接"
- 原描述"embedding 显著增大"是错的 ------实际上 embedding 的 alpha 反而最小(0.10),因为它是"最远的源"
- 这恰好验证了 AttnRes 的核心价值:模型能学到内容相关的深度选择,而不是盲目累加
-
左下 (c): 可见源数演进
- 两条折线:Block (阶梯形,有上界) vs Full (线性增长)
- 红色虚线: Block 上界 (n_units //block_units + 2)
- Block 形式:每 block_units 个 unit 归档一次 → source 数阶梯式增长
- Full 形式:每个 unit 都保留 → source 数 = unit 编号 + 1,线性增长到 n_units
-
右下 (d): 训练曲线
- 两条 log‑scale 曲线:AttnRes (蓝) vs 标准残差 (橙)
- AttnRes 收敛更快: 深度注意力让每层能选择性读取有用的历史表示
- 最终 MSE 更低: copy 任务中 AttnRes 的 input‑dependent 混合优于标准残差的固定等权
-
验证了哪些观点:demo 第 2、3 点验证"固定伪查询可学出选择模式"与"softmax 让选择更锐利";第 1 点验证"零初始化 = 从标准残差平滑出发"。
2.5 调节建议
- 想看 alpha 更分化 → 增大 steps 到 400+
- 想看 Block vs Full 内存差异 → 增大 n_units 到 15+
- 想看 Full 形式 → 设 block_units=1
0x03 Tab 2: 范式对比
3.1 目的
对比深度维连接的三种范式:标准残差、mHC (流形约束超连接)、AttnRes。展示架构图 + 深度‑时间对偶性 + 量化指标。
3.2 前向范数实验
设置 32/64/128 层,隐藏维 512。比较:
- 标准 PreNorm 残差。
- 残差缩放或 DeepNorm 风格缩放。
- Full AttnRes。
- Block AttnRes, block size 2/4/8/16。
记录每层:||h_l||、新增 delta 的相对占比 ||delta|| / ||h_l||、softmax 最大权重、entropy。
预期:标准残差范数随深度增长;AttnRes 混合值范数更接近历史源最大范数;Block AttnRes 在块内仍有局部增长,在边界处更平稳。
3.3 输出图解读
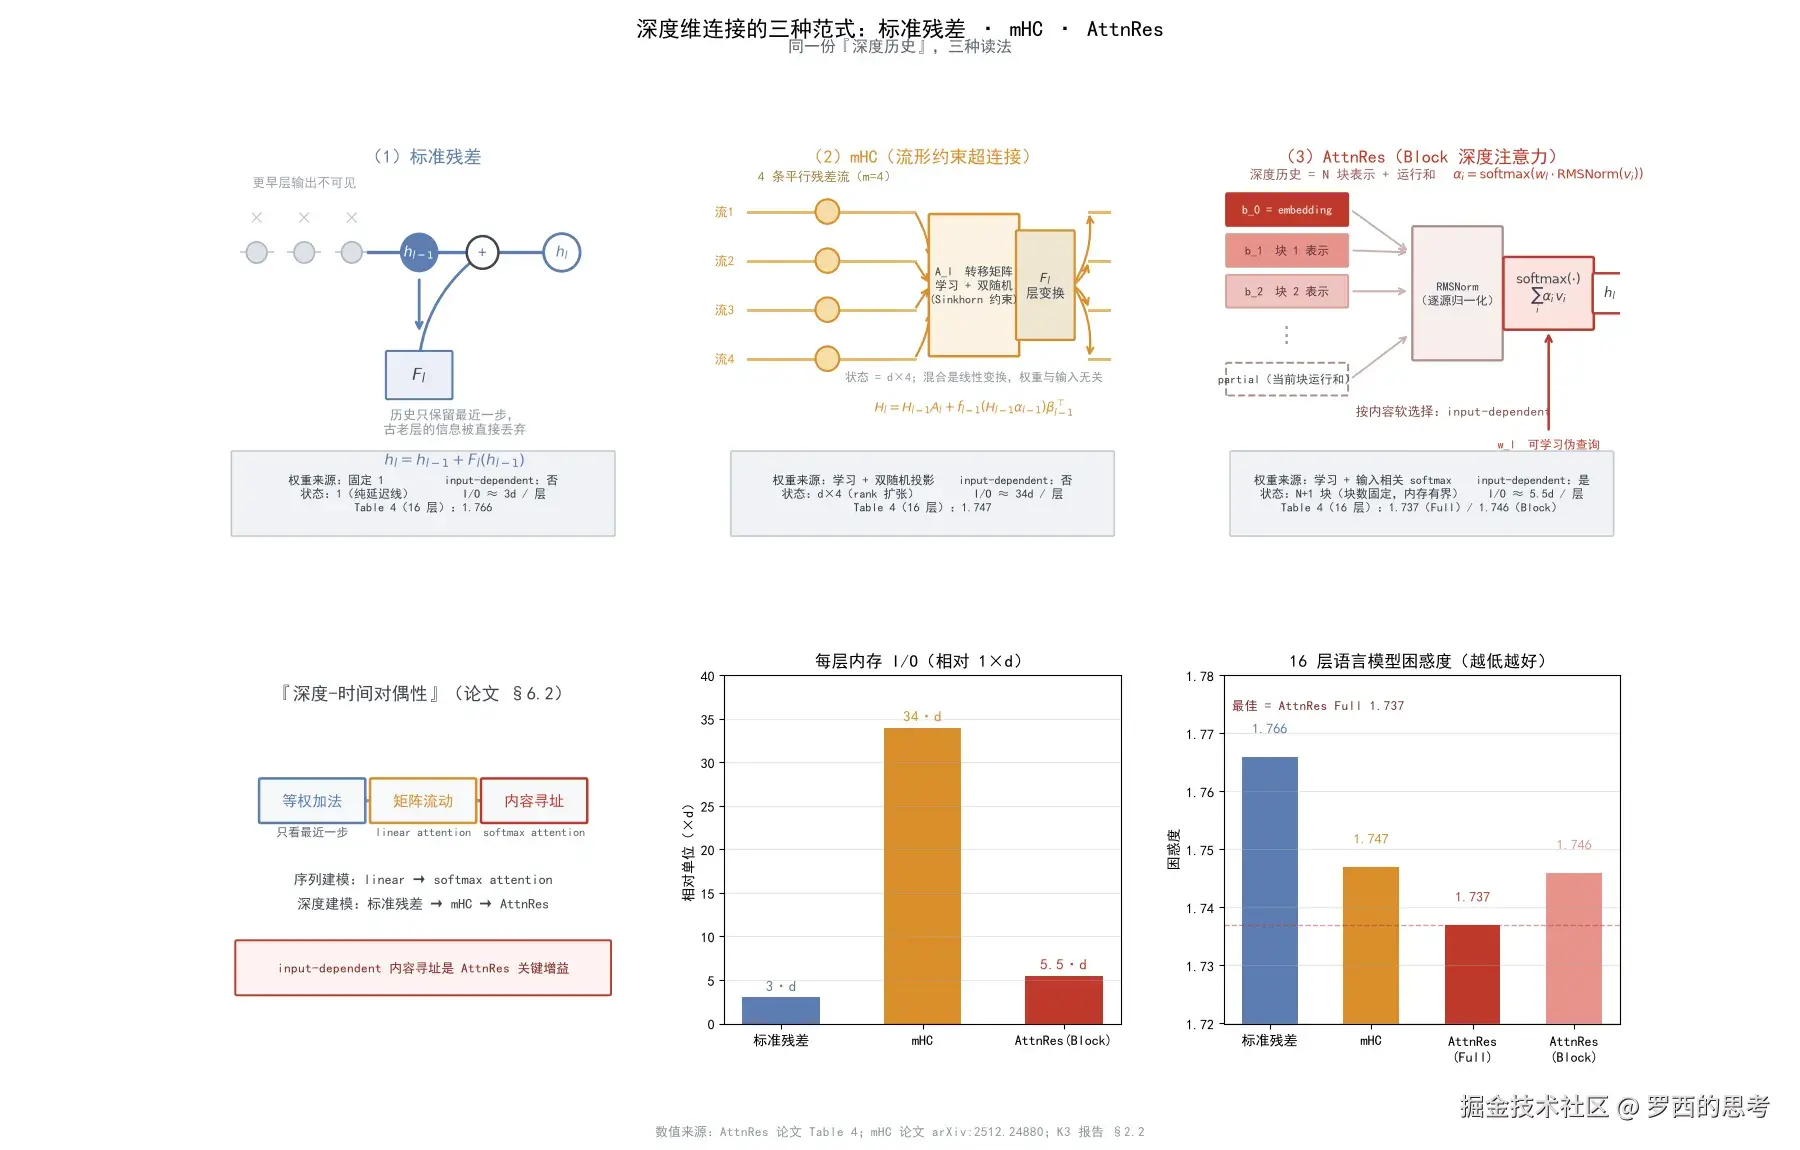
tab-2
2×3 布局:
上排三个架构图:
| 位置 | 范式 | 核心机制 | 权重来源 | input‑dependent |
|---|---|---|---|---|
| (1) 左 | 标准残差 | h_l = h_{l‑1} + F_l(h_{l‑1}) |
固定 1 | 否 |
| (2) 中 | mHC | m 条平行流 + 双随机转移矩阵 | 学习 + 双随机投影 | 否 |
| (3) 右 | AttnRes | 深度维 softmax 注意力 | 学习 + 输入相关 softmax | 是 |
每个架构图底部有量化条,显示:权重来源、input‑dependent、状态大小、每层 I/O、Table 4 困惑度。
下排三个分析图:
| 位置 | 内容 | 该看什么 |
|---|---|---|
| 左下 | 深度‑时间对偶性 | 三阶段演进:等权加法 → 矩阵流动 → 内容寻址 |
| 中下 | 每层内存 I/O | 标准残差 3d, mHC 34d, AttnRes (Block) 5.5d |
| 右下 | 16 层困惑度 | 标准残差 1.766, mHC 1.747, AttnRes (Full) 1.737, AttnRes (Block) 1.746 |
3.4 深度-时间对偶性
论文 §6.2 的核心洞察:
scss
序列建模:linear attention → softmax attention

深度建模:标准残差 → mHC → AttnRes

(等权加法) (矩阵流动) (内容寻址)- 标准残差 = 深度维的 linear attention (等权,无选择性)
- mHC = 深度维的 linear attention (学习转移矩阵,但权重与输入无关)
- AttnRes = 深度维的 softmax attention (input‑dependent 内容寻址)
AttnRes 的关键增益: input‑dependent--- 每层根据当前输入内容决定读哪些历史深度,而非固定模式。
0x04 Tab 3: Block vs Full
4.1 目的
验证 block_units=1 时 Block 形式自动退化为 Full 形式。这是 Block 实现正确性的基础锚点。测试套件因此不需要维护两套深层实现,Block 一处实现覆盖两种语义。
4.2 UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| dim | 4‑32 | 8 | 隐藏维度 |
| n_units | 2‑20 | 6 | 子层数量 |
| seed | 0‑10 | 0 | 随机种子 |
4.3 输出图解读
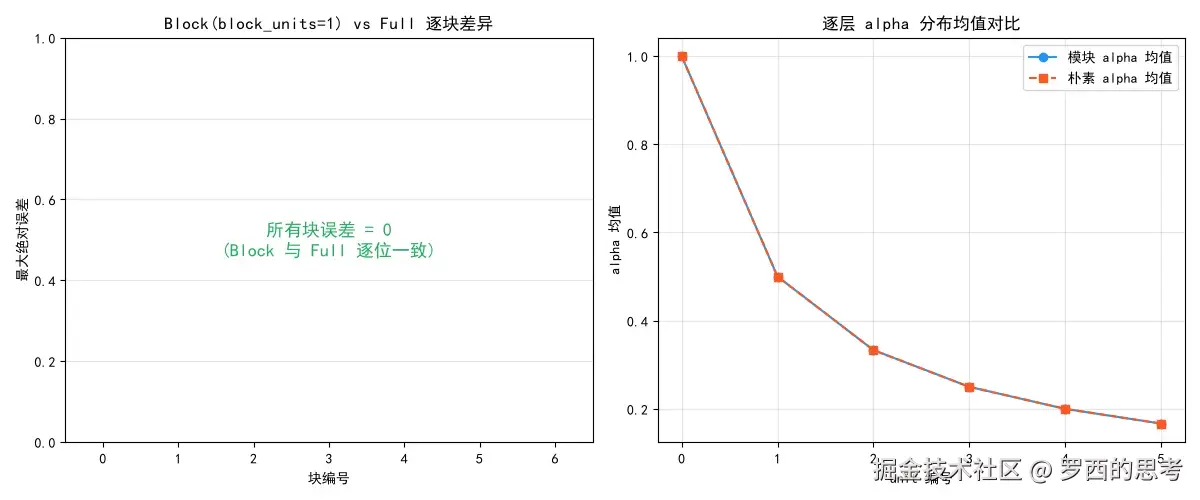
tab-3
1×2 布局:
-
左图:逐块最大绝对误差
- 当
block_units=1时,每个 unit 输出立即归档为一个"块",Block 应退化为 Full - 理想情况:所有块误差 = 0(Block 与 Full 逐位一致)
- 实际渲染问题 :所有 diff 确实为 0,但 log scale 下
bar(0)画不出来(log(0) = -inf),导致左图空白 - 修复:当所有误差 < 1e-12 时,改用文本标注"所有块误差 = 0(Block 与 Full 逐位一致)"
- 结论:Block(block_units=1) 与 Full 数学等价,Block 是 Full 的泛化------差异仅在内存策略,不在表达能力
- 当
-
右图:逐层 alpha 均值对比
- 蓝色圆点线 = 模块状态机算出的 alpha 均值
- 橙色方块虚线 = 朴素 Full 实现算出的 alpha 均值
- 理想情况: 两条线完全重合
4.4 为什么重要
Block 是 Full 的泛化(block_units=1 是退化)。如果退化失败,说明 Block 的归档逻辑(何时把 partial 并入 blocks、何时清空)有 bug。
0x05 Tab 4: Embedding 源
5.1 目的
验证 embedding 永远是 sources()[0] (b_0 = h_1 约定)。任何深度的层都能读到最初的输入表示。
5.2 UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| dim | 4‑32 | 8 | 隐藏维度 |
| n_units | 2‑24 | 12 | 子层数量。增大 → 验证更深处的 embedding 保持性 |
| block_units | 1‑12 | 4 | 块大小。增大 → 块归档更少,验证更极端的压缩下 embedding 仍保持 |
| seed | 0‑10 | 0 | 随机种子 |
5.3 输出图解读
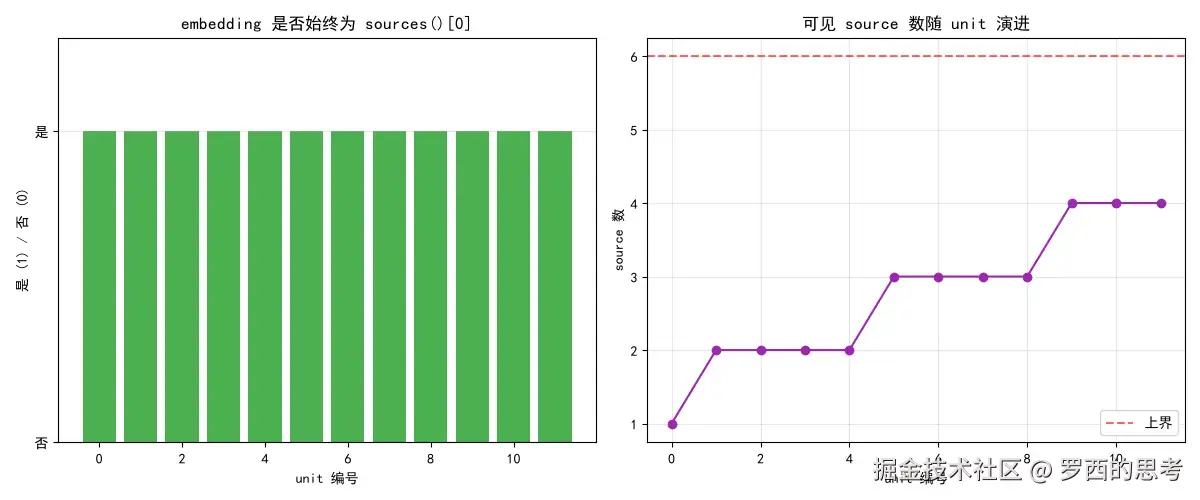
tab-4
1×2 布局:
-
左图:embedding 保持检查
- 绿色柱状图,每根柱 = 1.0 (embedding == sources ()0)
- 如果出现 0.0 柱 → 严重 bug: embedding 在某步被覆盖或丢失
-
右图:可见 source 数演进
- 紫色折线,阶梯形增长 (每 block_units 个 unit 归档一次,source 数 +1)
- 红色虚线 = 上界 (block_units + 2)
- 默认配置 (n_units=12, block_units=4) 下,source 数演进为
[1, 2, 2, 2, 2, 3, 3, 3, 3, 4, 4, 4] - 规律:每 block_units 步 source 数 +1,在两次归档之间保持不变
5.4 为什么重要
论文规定 k_0 = v_0 = h_1 (embedding 永远是第一个源)。如果实现把它丢了(例如 block 轮转时误覆盖 blocks 0),深层网络会失去对输入的直连路径--- 所有层只能读到中间层输出,无法直接访问原始输入。这对 copy 任务、信息检索任务等是灾难性的。
0x06 Tab 5: 内存有界
6.1 目的
验证 Block 形式的核心优势:source 数 ≤ 块数 + 常数,远小于 Full 形式的 O (L)。
6.2 "source 数 ≤ 块数 + 常数" 三个数的含义
| 符号 | 含义 | Block 形式 | Full 形式 |
|---|---|---|---|
| source 数 | 当前深度注意力可见的历史表示数量 (len(state.sources())) |
阶梯增长,峰值 = 块数 + 2 | 每步 +1,最终 = n_units + 1 |
| 块数 | 已完成的块归档数 (len(state.blocks) - 1, 减去 embedding) |
n_units // block_units | n_units (每 unit 一个块) |
| 常数 | 固定开销:1 个 embedding + 1 个当前 partial | 2 | 1 (只有 embedding,无 partial) |
具体数值示例(默认配置 n_units=40, block_units=8):
| 指标 | Block 形式 | Full 形式 |
|---|---|---|
| 块数 | 40 // 8 = 5 | 40 (每 unit 一个块) |
| 常数 | 2 (embedding + partial) | 1 (只有 embedding) |
| source 数上界 | 5 + 2 = 7 | 40 + 1 = 41 |
| 实际峰值 source 数 | 7 | 41 |
| 内存压缩比 | 41/7 ≈ 5.9x | 1x |
6.3 "峰值 = 块数 + 2" 的推导
"2" 就是 1 个 embedding + 1 个当前 partial。这是 AttnRes Block 形式的算法设计规定的,不是任意常数。
具体推导:
scss
`state.sources()` 的构成 = blocks 列表 + [partial] (如果 partial 存在)其中 blocks 列表的内容是:
ini
blocks = [embedding, 已归档的块1, 已归档的块2, ..., 已归档的块N]
          ↑永远在          ↑每满 block_units 个 unit 归档一次
所以峰值 source 数:
scss
峰值 = len(blocks) + 1(partial)
     = (1 + 已归档块数) + 1
     = 已归档块数 + 2
         ↑      ↑
     embedding(1) + partial(1)
最多 = n_units // block_units为什么这两个必须存在:
| +1 | 为什么必须有 | 算法依据 | |
|---|---|---|---|
| embedding | 论文规定 k_0 = v_0 = h_1,任何深度的层都必须能读到原始输入 | Eq. 9 的 source 列表定义 | |
| partial | 当前块内正在累计的运行和,当前 unit 做深度注意力时必须能看到它 | Eq. 10 的 Block 形式定义 |
partial 必须可见是因为:当前 unit 的深度注意力需要 attend over 可读源 --- 已归档的块表示 + 当前块还没归档的部分。如果 partial 不可见,当前 unit 就看不到同块内前面 unit 的输出,信息就断了。
这就是 Block 形式内存 O (Nd) 的核心:用 N 个块表示 + 1 个 partial + 1 个 embedding = N+2 个 source,替代 Full 形式的 L+1 个 source。
6.4 UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| n_units | 10‑100 | 40 | 子层数量。增大 → Full 形式线性增长更明显,Block 优势更大 |
| block_units | 2‑20 | 8 | 块大小。增大 → 块数更少,内存更低 |
| dim | 4‑32 | 8 | 隐藏维度 |
| seed | 0‑10 | 1 | 随机种子 |
6.5 输出图解读
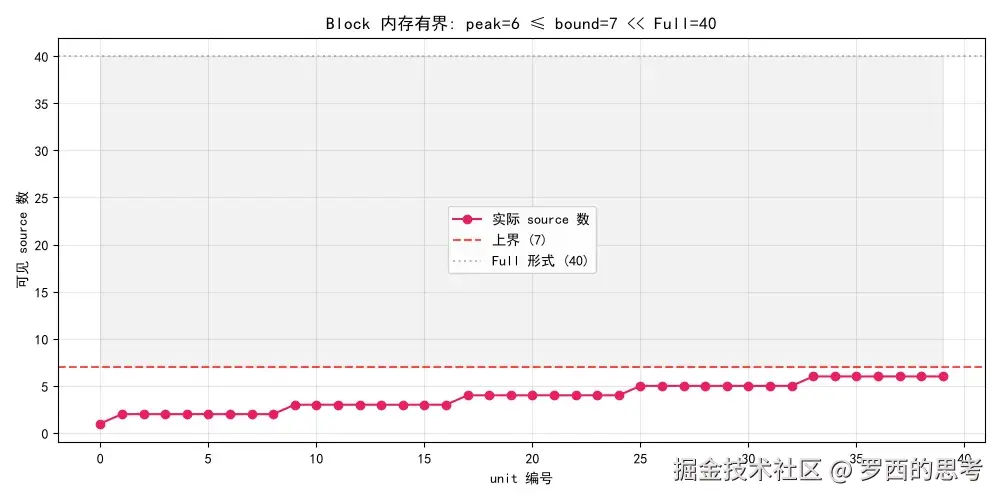
tab-5
单图:
- 粉色折线: 实际 source 数随 unit 演进(阶梯形)
- 红色虚线: 理论上界 = n_units //block_units + 2
- 灰色点线: Full 形式需要的 source 数 = n_units
- 灰色阴影区: Block 节省的内存空间
6.6 为什么重要
Block 形式的全部动机是内存 O (Nd) 而非 O (Ld)。在 2.8T 配置中(L=93, N=8),内存压缩比约 93/9 ≈ 10x。如果实现退化(比如 partial 没有及时归档,或块内每个 unit 都被保留),峰值会悄悄涨到 O (L) 而在此暴露。
0x07 Tab 6: 权重分布
7.1 目的
验证深度注意力权重 alpha 在每个位置构成概率分布(沿 source 维求和 == 1,且全部 ≥ 0)。
7.2 alpha 的概念
alpha 是 AttnRes 中深度维 softmax 注意力的权重,即第 l 层在混合历史表示时分配给第 i 个 source 的权重:
less
alpha_{i->l} = exp(q_l^T RMSNorm(k_i)) / Σ_j exp(q_l^T RMSNorm(k_j))
h_l = Σ_i alpha_{i->l} v_i- alpha 的每个分量表示 "第 l 层有多关注第 i 个深度源"
- softmax 归一化保证
Σ_i alpha_i = 1且alpha_i ≥ 0 - 这使得
h_l是各 source 表示的凸组合 (convex combination) ,不会引入尺度偏移
7.3 为什么在这里展示
alpha 是理解 AttnRes 行为的核心窗口--- 它回答 "每层到底读了哪些深度"。通过可视化 alpha 分布,可以验证:
- 概率分布性质: alpha 求和 == 1 (数值正确性)
- 选择性读取 : 不同 unit 的 alpha 分布不同(伪查询
w_l学到了不同策略) - 训练前后变化: 训练前 alpha 均匀(等权),训练后 alpha 分化(选择性)
7.4 UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| dim | 4‑32 | 8 | 隐藏维度 |
| n_units | 2‑20 | 9 | 子层数量 |
| block_units | 1‑10 | 3 | 块大小 |
| seed | 0‑10 | 0 | 随机种子 |
7.5 输出图解读
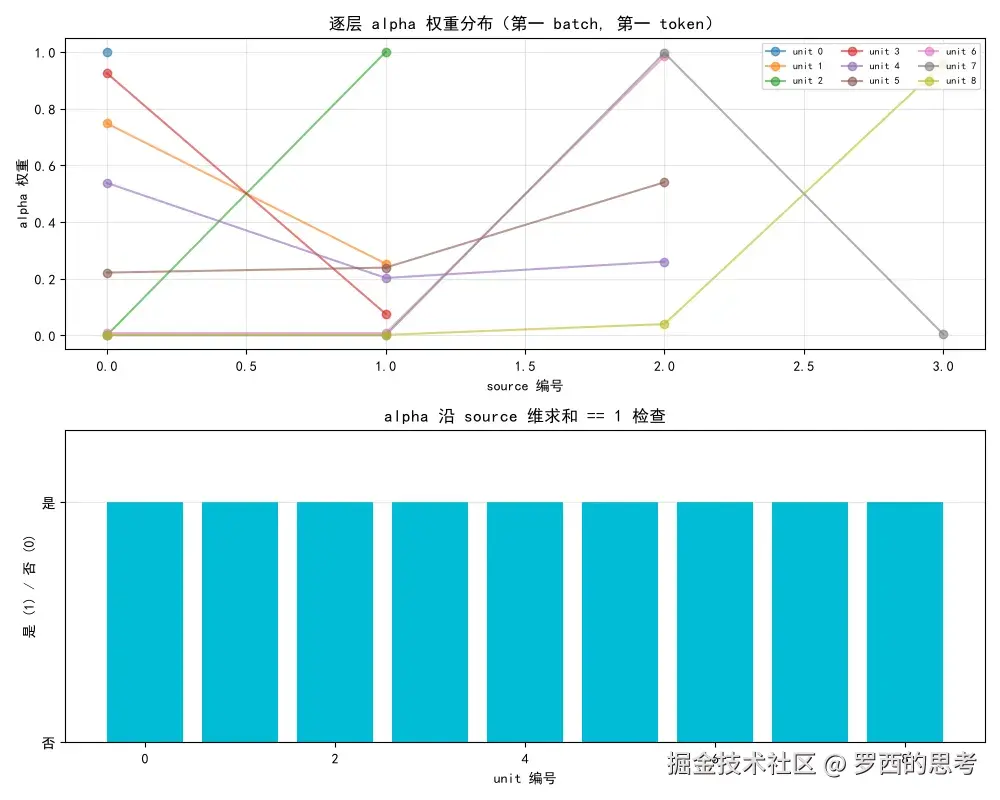
tab-6
2×1 布局:
-
上图:逐层 alpha 权重分布
-
多条折线,每条 = 一个 unit 的 alpha 分布
-
X 轴 = source 编号,Y 轴 = alpha 权重
-
你该看什么:
- 不同 unit 的 alpha 分布不同 → 伪查询
w_l学到了不同的 "读取策略"
- 不同 unit 的 alpha 分布不同 → 伪查询
-
-
alpha 全部 ≥ 0 且求和 ≈ 1 → 构成有效概率分布
-
下图:求和检查
- 青色柱状图,每根柱 = 1.0 (求和 == 1 通过)
- 如果出现 0.0 柱 → 严重 bug: alpha 不构成概率分布
7.6 为什么重要
深度混合 h_l = Σ alpha_i v_i 的系数必须是概率分布,否则加权和会引入不可控的尺度偏移。softmax 归一化天然保证这一点,但如果实现有数值精度问题(如 fp16 下 softmax 溢出),求和可能偏离 1。
0x08 Tab 7: RMSNorm 防垄断
8.1 目的
验证打分核里的 RMSNorm 确实防止 "大幅值层垄断注意力权重"。
8.2 UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| dim | 4‑32 | 8 | 隐藏维度 |
| n_units | 2‑12 | 6 | 子层数量 (v5 默认从 4 改为 6,增加 source 数) |
| seed | 0‑10 | 0 | 随机种子 |
8.3 输出图解读
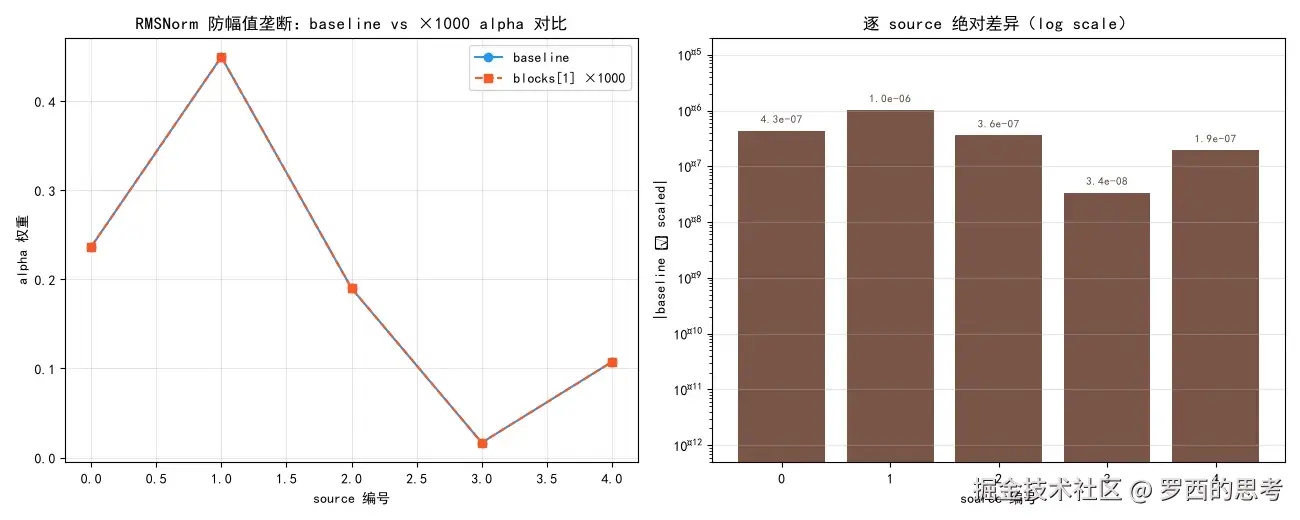
tab-7
1×2 布局:
-
左图:baseline vs ×1000 的 alpha 对比
- 蓝色圆点线 = baseline (正常 alpha)
- 橙色方块虚线 = blocks 1 放大 1000 倍后的 alpha
- 两条线几乎完全重合 → RMSNorm 把幅值归一化后,放大不影响打分
-
右图:逐 source 绝对差异 (log scale)
- 棕色柱状图,每根柱 = baseline i − scaled i 的绝对值
- Y 轴为 log scale, 让 e‑08 级别的差异可见
- 每根柱上方标注科学计数法数值(如
8.9e‑08) - 所有柱在 1e‑09 到 1e‑07 之间 ,远小于通过标准
1e‑4→ RMSNorm 成功防止幅值垄断 - 0 值的柱在 log scale 下显示为 1e‑12 (占位),标注为
0.0e+00
右图读图方法:
- 看 Y 轴刻度:如果所有柱在 −8 到 −10 之间(即 1e‑08 到 1e‑10),说明差异极小
- 看柱上方标注:具体数值如
8.9e‑08远小于通过标准1e‑4 - 如果 RMSNorm 失效,差异会涨到 0.1‑1.0 量级,柱会跳到 Y 轴顶部
8.4 为什么重要
深度注意的最实际风险是 "某层输出幅值巨大 → 它的点积分垄断 softmax 权重 → 其他深度被忽略"。RMSNorm 在打分前把每个 source 重缩放到单位 RMS,从根源消除幅值效应。
对比 : 如果打分核漏了 RMSNorm(直接用 q^T @ k 而非 q^T @ RMSNorm(k)),把 blocks 1 放大 1000 倍后,它的 alpha 会从~0 暴涨到~1.0,其他 source 的 alpha 趋近 0--- 这就是 "垄断"。
0x9 Tab 8: 梯度流
9.1 目的
验证梯度能流到每一层(每个深度源都被注意 / 读到),不存在被遗忘的深度。
9.2 UI 组件与参数影响
| 参数 | 范围 | 默认 | 调节效果 |
|---|---|---|---|
| dim | 4‑32 | 8 | 隐藏维度 |
| n_units | 2‑20 | 9 | 子层数量 |
| block_units | 1‑10 | 3 | 块大小 |
| seed | 0‑10 | 0 | 随机种子 |
9.3 输出图解读
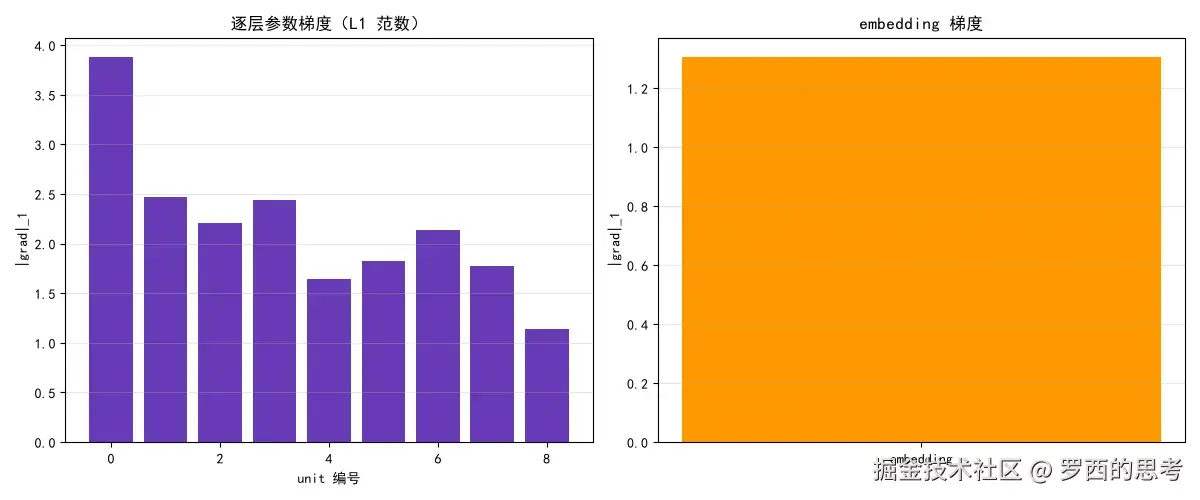
tab-8
1×2 布局:
-
左图:逐层参数梯度 (L1 范数)
- 紫色柱状图,每根柱 = 该层 weight.grad 的 L1 范数
- 所有柱 > 0 → 每层都收到了梯度,没有被 "遗忘"
-
右图:embedding 梯度
- 橙色单柱 = embedding.grad 的 L1 范数
- > 0 → embedding 也收到了梯度
9.4 为什么重要
深度混合如果不均匀(某些源被 softmax 权重压成 0 或实现切断了某条路径),对应层的参数梯度会消失 --- 那些深度就 "白学了"。AttnRes 的 softmax 注意力天然保证所有 source 的 alpha > 0 (softmax 不输出精确 0),因此梯度总能流到每一层。
对比标准残差 : 标准残差也有梯度流(残差直连),但 AttnRes 的优势在于信息流是选择性的--- 每层根据内容决定读哪些深度,而非无差别累加。
0x10 Tab 9: 2.8T 配置
10.1 目的
验证论文 2.8T 配置(93 层 / 8 块 / 每块 12 层)的划分数字与代码配置自洽。
10.2 输出图解读
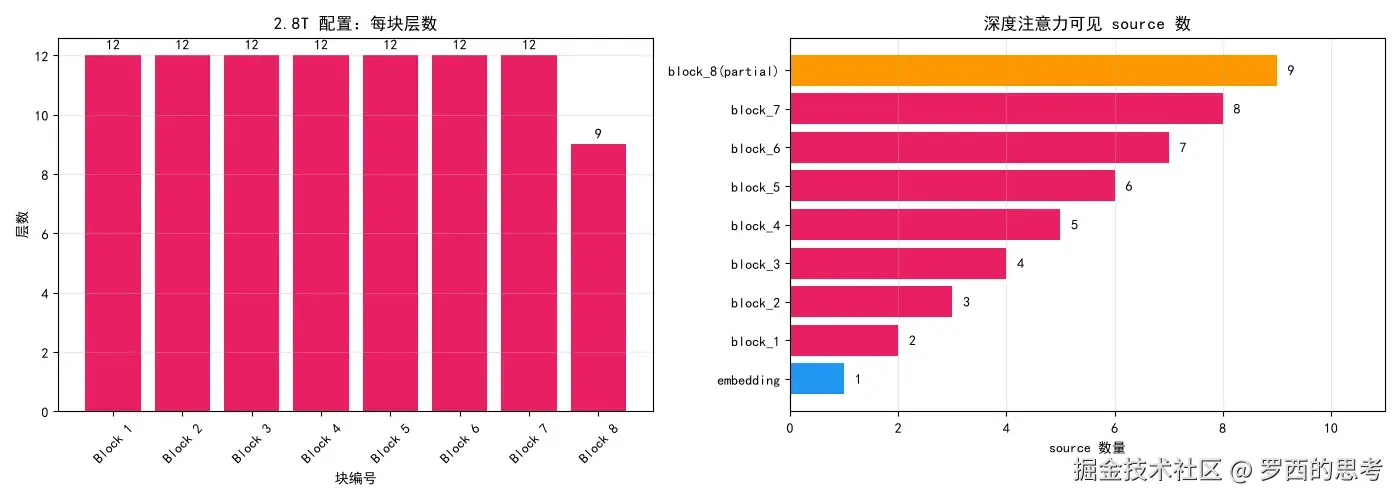
tab-9
1×2 布局:
-
左图:每块层数
- 粉色柱状图,8 根柱
- Block 1‑7 各 12 层,Block 8 只有 9 层 (
93 = 7×12 + 9) - 每根柱上方标注层数
-
右图:深度注意力可见 source 数
- 水平柱状图,9 个 source
- 蓝色 = embedding (1 个)
- 粉色 = block_1 到 block_7 (7 个完成块)
- 橙色 = block_8 (partial) (1 个未满块)
- 总计 9 个 source = 论文描述
10.3 关键数值
| 指标 | 值 | 来源 |
|---|---|---|
| n_layers | 93 | Kimi3Config |
| block_size | 12 | AttnResConfig |
| n_blocks | ceil(93/12) = 8 | 代码计算 |
| 深度 source 总数 | 8 + 1 = 9 | 块数 + embedding |
| n_units (子层粒度) | 93 × 2 = 186 | 每层含 2 个子层 |
| block_units (子层粒度) | 12 × 2 = 24 | 子层块大小 |
10.4 为什么重要
把测试与生产配置挂钩 --- 论文里 "8 块、9 源、每块 12 层" 的描述必须能被代码里的划分数字精确复现。若配置字段改名或除法约定变化,该测试会立即报警,防止文档与实现漂移。
10.5 代码复用策略
| 组件 | 复用方式 | 说明 |
|---|---|---|
demo_attn_res.py |
提取 fig_demo_attn_res() → Gradio 直接调用 |
训练四联图,避免维护两份代码 |
plot_attnres_comparison.py |
提取 fig_attnres_comparison() → Gradio 直接调用 |
范式对比架构图 |
test_attn_res.py |
复用 build_test() + run_module() + naive oracle |
每个 Tab 是对应测试函数的可视化版本 |
attn_res.py |
直接 import AttentionResiduals |
真实源码算子,非重实现 |
norm.py |
直接 import rms_norm |
RMSNorm 核心计算 |
保持向后兼容 : 原有
main()函数保留,__main__仍可独立运行。"
10.5 验证策略总览
每个 Tab 都是对应测试函数的可视化版本:
| Tab | 测试函数 | 验证点 | 通过标准 | |
|---|---|---|---|---|
| 3 | Block vs Full | test_block_size_one_recovers_the_full_form |
block_units=1 退化 | 逐块误差 < 1e‑6 |
| 4 | Embedding 源 | test_embedding_is_always_a_source |
embedding 永远在 sources ()0 | torch.equal 每步 |
| 5 | 内存有界 | test_memory_is_bounded_by_block_count |
source 数 ≤ 块数 + 2 | peak ≤ n_units//block_units+2 |
| 6 | 权重分布 | test_attention_weights_form_a_distribution |
alpha 求和 == 1 | allclose(atol=1e‑6) |
| 7 | RMSNorm 防垄断 | test_key_rmsnorm_prevents_magnitude_domination |
×1000 不影响权重 | allclose(atol=1e‑4) |
| 8 | 梯度流 | test_gradients_reach_every_depth |
每层梯度非零 | grad.abs().sum() > 0 |
| 9 | 2.8T 配置 | test_paper_partition_for_the_2p8t_config |
8 块 /9 源 /24 单位 | assert n_blocks==8, module.block_units==24 |
TransFormer-封面
0xFF 参考
本文使用 markdown.com.cn 排版