第 4 篇给它装了状态机,第 5 篇给它接了题库和检索------现在它终于"知道问什么"了。但我拿这套完整跑了一场,发现一个致命问题:它不会"接话"。
我答对了 volatile 的可见性,它回我"好的,下一题";我答错了把 AOF 说成"全量写盘",它也说"好的,下一题";我前面说自己"用过三年 Kubernetes",后面又说"没用过",它毫无反应,继续问我 JVM 调优。
这不是考官,这是点唱机------投币出题、答题、换碟,全程没有"听进去"。真实考官最值钱的能力恰恰是追问:答得好,往深一层挖,看你是真懂还是背答案;答得错,当场点破,不让你带着错误认知过关;前后矛盾,一秒回戳,简历水分当场现形。
我当年面试被人问"你这个项目上线后 QPS 多少",答了个大概,对方立刻追问"那这台机器几核、连接池多大、慢查询怎么定位的",我当场卡住------那一下卡住,比前面十道八股题都更能暴露真实水平。追问引擎要复现的,就是这种"卡住才见真章"的压力。
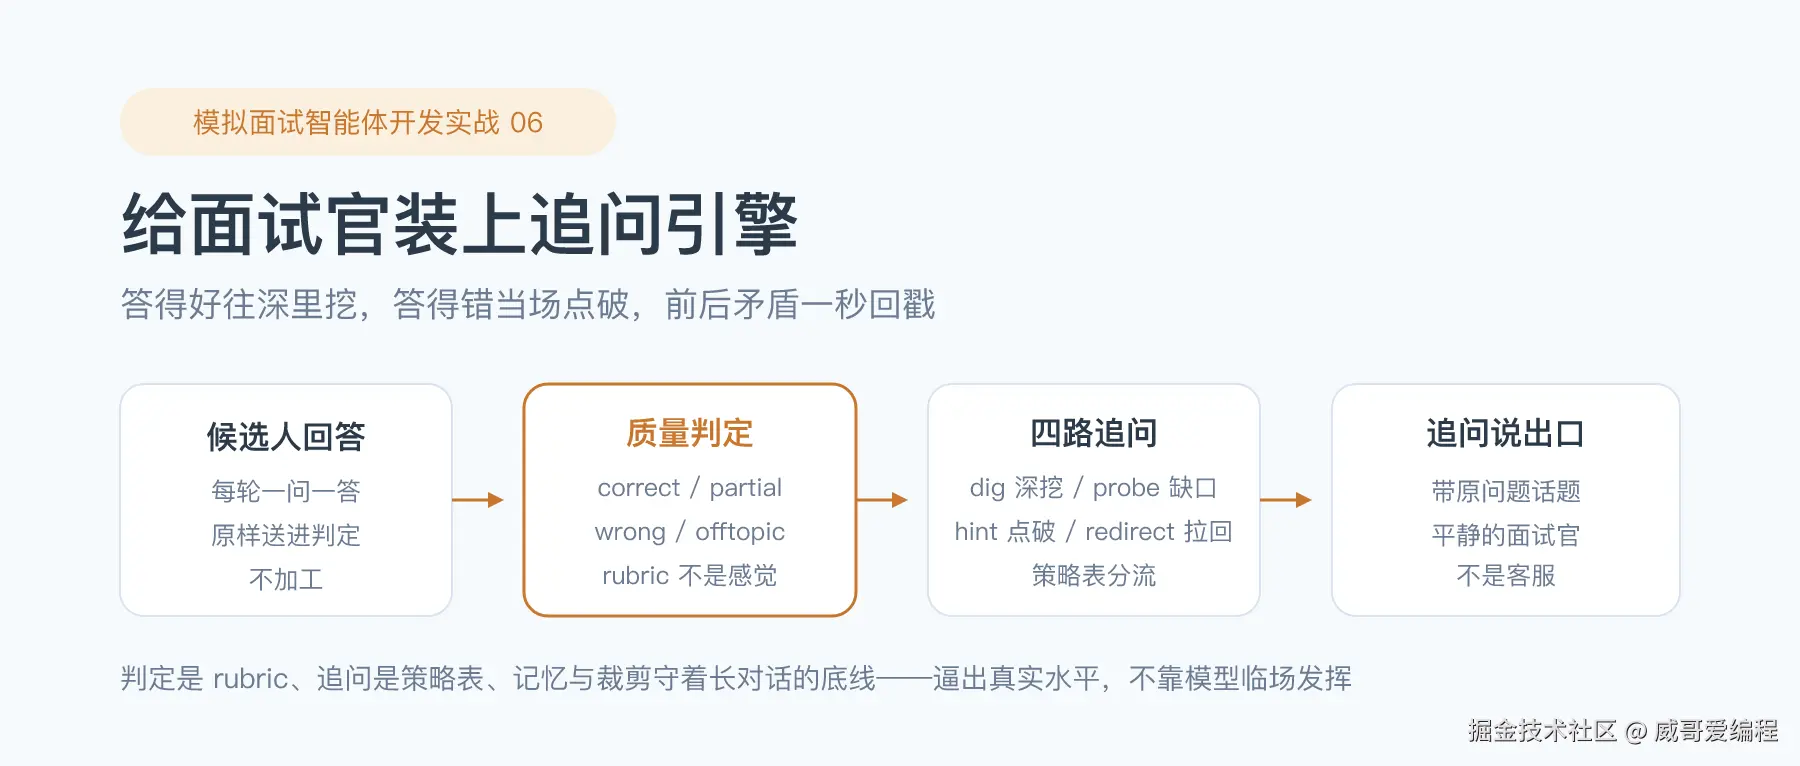
这一篇就给它装上这套"会听、会接、会揪"的追问引擎。四块拼起来:判定 rubric、四路追问策略、面试记忆、上下文裁剪。
前四篇解决了"问什么、怎么问、按什么顺序问",这一篇解决"听没听进去"------没有它,前面所有的工程都只是让一个更流畅的点唱机跑得更快,看起来更专业,实际一样测不出真实水平。
一、先扫盲:为什么追问不能让模型"自由发挥"
我最早的设计就是一句"根据候选人的回答决定怎么追问"。跑起来灾难:模型今天心情好就多夸两句,明天就直接给答案,有时还自问自答。问题不在模型,在我把"判断"和"决策"两件事都交给了模型的临场发挥。这一篇做的全是"把临场发挥拿走":
1. 判定是 rubric,不是感觉
"你答得不错"这种评价是废话,因为"不错"没有标准。我把判定写成一份写死的规则(rubric):覆盖全部要点且无事实错误=correct,覆盖部分=partial,有相悖错误=wrong,答非所问=offtopic。模型只做归类,不做价值判断。口径统一了,下游策略才挂得稳。
2. 追问是策略表,不是自由裁量
判定结果到动作必须一一对应,写死成表:correct→dig、partial→probe、wrong→hint、offtopic→redirect。不允许"模型觉得该追问就追问"------那等于又把方向盘还回去了。表是唯一的分流依据。
3. 记忆和裁剪是长对话的两条底线
聊到十几轮,发给模型的上下文必须裁剪,否则又慢又贵;但"候选人自称用过 K8s"这种关键事实不能跟着一起被裁掉,否则第 18 轮他说没用过,面试官毫无察觉。所以记忆管"这场面试永远记得什么",裁剪管"发给模型多少历史",各守一边。
4. 判定与追问都依赖注入,整套链路才能离线测
judge 和 followup 都不直接 new 一个具体模型,而是接收外部传进来的 llm。离线测试时传 OfflineChatModel(脚本预置回复),生产传 ChatOpenAI。这意味着"追问对不对"能被测试逐字断言 ------比如断言"参考答案要点真的进了发给模型的提示词"、"模板的 {question} 一个没漏"、"四档判定各自命中"。如果判定和追问都硬编码了某个具体 SDK,这些断言根本写不出来。可测试,是这一篇能交付的底气,也是前面五篇一以贯之的工程纪律。
二、工程结构:判定、策略、记忆、裁剪四块分离
bash
06-追问引擎/
├── src/
│   ├── settings.py    # 配置集中读取(硅基流动 + DeepSeek-V3)
│   ├── llm.py         # 模型工厂:真 Key / 离线脚本模型 / 没 Key 报错
│   ├── judge.py       # 判定 rubric:Verdict + grade_answer(结构化输出)
│   ├── followup.py    # 四路追问策略表:模板模式 + 模型模式
│   ├── memory.py      # 面试记忆:Claim + 矛盾检测(回戳)
│   └── trimmer.py     # 上下文裁剪:滑窗 + token 预算 + 问答对不拆
├── tests/             # 62 个用例,全程离线
└── demo.py核心思想一句话:判定有 rubric、追问有策略表、记忆与裁剪有铁律------把"逼出真实水平"这件最需要稳定性的事,从模型的临场发挥里彻底夺回来。
三、判定 rubric:用结构化输出把"判据"焊死
judge.py 里最关键的是一个 Verdict 结构(pydantic)和一份写死的系统提示词 GRADE_SYSTEM_PROMPT:
python
class Verdict(BaseModel):
    quality: Quality = Field(description="回答质量:correct/partial/wrong/offtopic")
    missing_points: list[str] = Field(default_factory=list, ...)
    reason: str = Field(description="一句话判定依据,要引用参考答案的要点原文")

GRADE_SYSTEM_PROMPT = """你是模拟面试系统的回答质量判定器。只做判定......
四档质量(quality):
- correct:覆盖参考答案全部核心要点,且无事实性错误
- partial:覆盖部分要点。把没覆盖的要点逐条原样抄进 missing_points
- wrong:回答里存在与参考答案相悖的事实性错误
- offtopic:答非所问,missing_points 留空
纪律:missing_points 只能从参考答案要点里抄,一个字都不要自己编......"""
调用时用 with_structured_output(Verdict)------格式约束在管线里,不在提示词里 。提示词里没有"请输出 JSON"这种话,LangChain 把 Verdict 转成工具定义发给模型,模型以 tool_calls 形式返回,再解析成 Verdict 实例。这样 quality 和 missing_points 是程序直接可读的字段,不是一段要再解析的文本。
python
def grade_answer(question, reference_answer, answer, llm):
    structured = llm.with_structured_output(Verdict)
return structured.invoke([("system", GRADE_SYSTEM_PROMPT), ("human", prompt)])这一篇的离线难点在这里:with_structured_output 走的是工具调用管线,通用的 FakeListChatModel 只会吐纯文本,喂不进去。所以我写了 OfflineChatModel------脚本条目是 str 就当普通文本返回,是 pydantic 实例就包成一条 tool_calls 消息返回。判定和追问跑测试、跑演示时,真实模型和离线模型走的是同一条解析管线,不是绕过去造假。
rubric 里还有一条铁律我特意写进提示词:"拿不准 correct 还是 partial 时,判 partial------宁可多追问一句,不可漏判。" 为什么?因为漏判的代价是"以为答对了放过去",多问一句的代价只是多聊一轮。面试是"尽可能逼出真实水平"的场景,bias 必须朝"多问"方向偏,不能朝"少问"方向偏。这条 bias 写进 rubric,判定器才不会被"差不多就行"的默认倾向带偏------否则它为了省事会把一堆半懂不懂的回答默默放过去。
四、四路追问策略:判定结果一一对应到动作
followup.py 把"质量 → 动作"写成两张表,逻辑全在表上:
python
STRATEGIES = {
    "correct":  ("dig",      "候选人答对了。不要夸奖。往深一层追问......"),
    "partial":  ("probe",    "针对 missing_points 追问,一次只问一个缺口......"),
    "wrong":    ("hint",     "先用一句话指出错误点,给方向性提示,不直接给答案......"),
    "offtopic": ("redirect", "用一句话把候选人拉回原问题,不解释不展开......"),
}
四种动作各自的打法,是这一篇"像真考官"的核心:
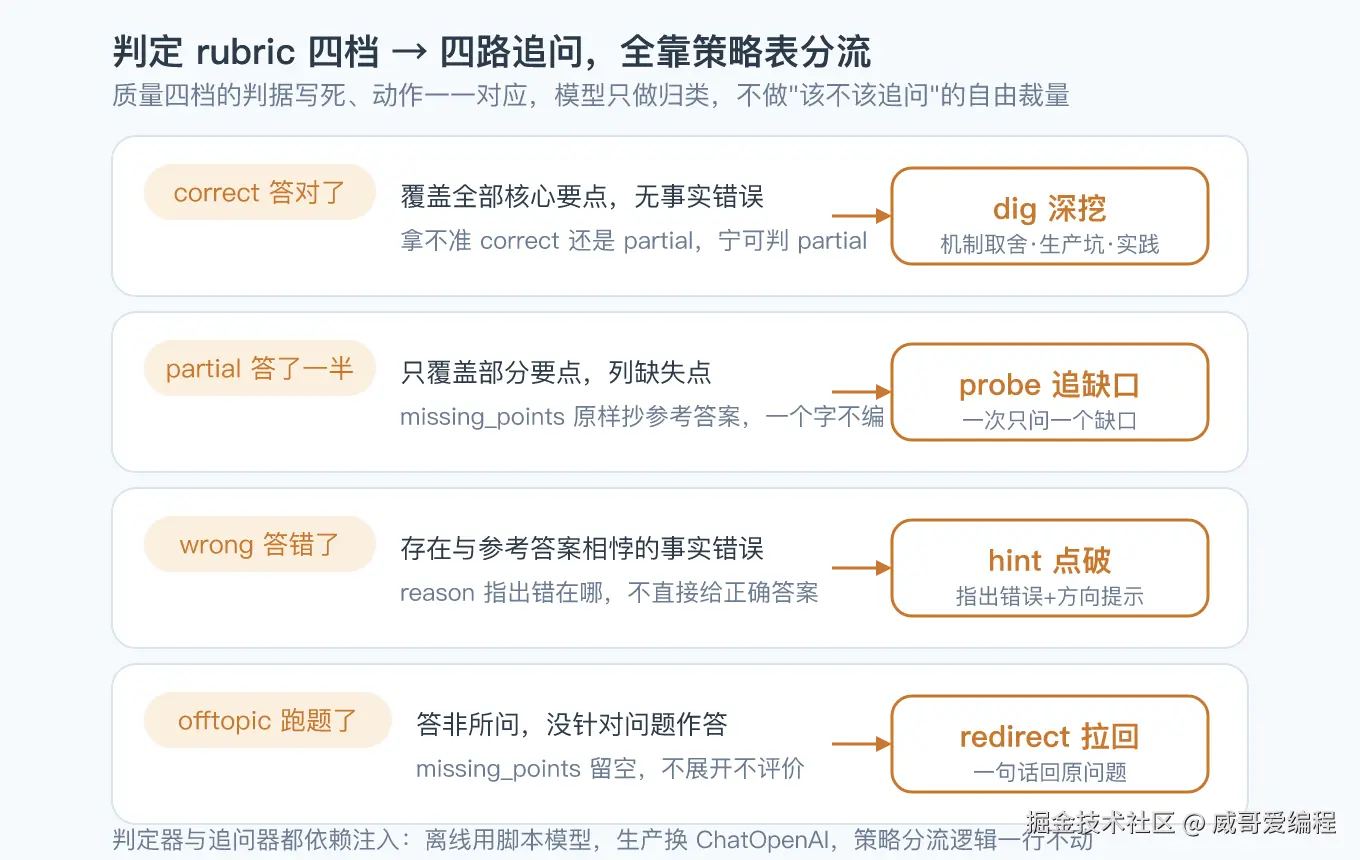
- dig(答对) :不夸。答对了反而最危险------你不知道他是真懂还是背答案。往深一层挖机制背后的取舍、生产环境的坑、他自己的实践。真懂的人能接住,背答案的人到这里就露馅。
- probe(半对) :对着
missing_points追缺口,一次只问一个。一次甩三个问题,候选人挑会的答,你还是不知道他不会什么。 - hint(答错) :先点破错误点(引用判定理由),再给方向性提示,请他换方向重答。不直接给正确答案------给答案就失去了"被考"的意义。
- redirect(跑题):一句话拉回原问题,不解释、不展开、不评价。跑题的人最擅长把话题带偏来逃避,你越展开他越带得走。
两种生成模式都支持:短句(redirect/hint)用模板直接拼,零成本、确定性;要贴合题目内容的(dig/probe)可以传 llm 用模型生成。下游只认 FollowUp(action, prompt) 这个结构,不关心是哪种模式生成的。
python
def next_move(verdict, question, *, llm=None):
    action, strategy = STRATEGIES[verdict.quality]
    prompt = _template_prompt(action, question, verdict) if llm is None \
        else followup_prompt(llm, action, strategy, question, verdict)
    return FollowUp(action=action, prompt=prompt)
模板里 {question} 必须出现------追问不带原问题,候选人根本不知道你在问哪题。这是从真实面试里总结的:人考官回戳时一定会说"刚才那道 K8s 的题......",不会凭空蹦一句。
为什么 dig 反而最难、也最值钱 ?因为答对了之后,模型最容易犯两个错:一是顺着夸("答得真好!"),二是抛出一个和本题无关的新问题(又变回点唱机)。dig 的约束是"同一个问题往深一层"------必须贴着原考点,不能夸、不能跳题。这条约束写在策略说明里,模型生成时被框住;离线的 redirect/hint 用模板就够,但 dig/probe 这种需要理解题目内容的,留了模型模式入口(见踩坑第 7 条)。答对了不轻易放过、往生产实践里逼,才是真考官和客气客服的分水岭。demo 第 ① 个场景里那句" AOF 重写期间磁盘 IO 打满会发生什么",就是把一个背得出来的知识点,逼到候选人没准备过的现场处境里------能接住的人,才是真懂。
五、面试记忆:专抓前后矛盾
memory.py 解决一个模型天然不擅长的问题:跨轮记住候选人的关键说法。裁剪会把早期对话裁掉,但"自称用过 Kubernetes"这种事实不能跟着没------否则前后矛盾抓不到。
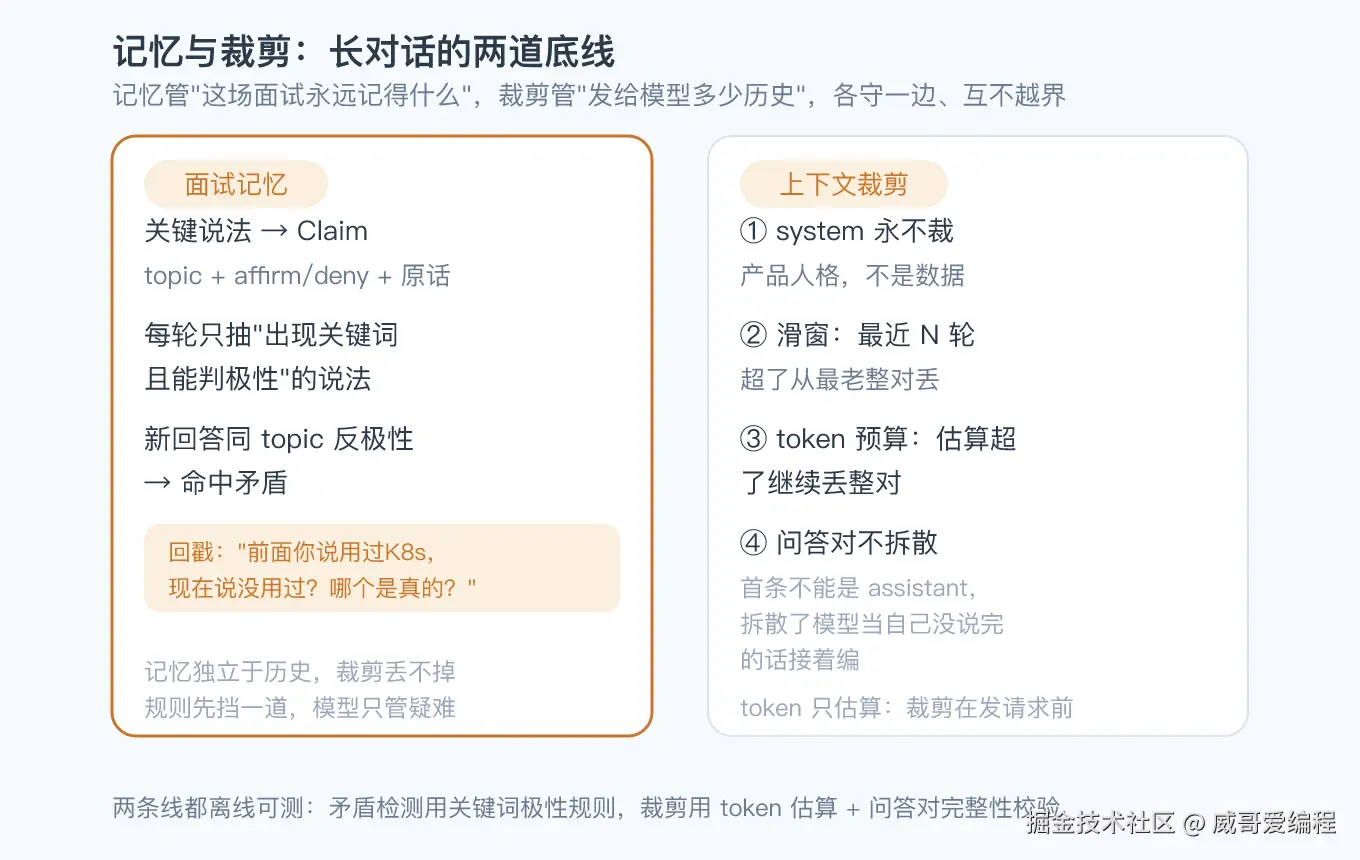
做法很便宜(每轮必跑,零成本):把每条关键说法记成一个 Claim(topic, polarity, statement)。polarity 是"用过"还是"没用过",靠关键词窗口判定:
python
DENY_TOKENS = ("没用过", "没做过", "不熟", "不了解", ...)
AFFIRM_TOKENS = ("用过", "做过", "熟悉", "掌握", ...)

def detect_polarity(text, keyword):
    idx = text.find(keyword)
    window = text[max(0, idx-12): idx+len(keyword)+12]   # deny 先查,否则"没用过"误判
    if any(t in window for t in DENY_TOKENS): return "deny"
    if any(t in window for t in AFFIRM_TOKENS): return "affirm"
    return None
新回答里再出现同一个 topic 且极性相反,find_contradiction 命中,直接生成"回戳"追问------返回的是 prompt 而不是布尔值,上层拿到就能说,不用再拼一次:
python
return (f"等一下。前面你的原话是「{claim.statement}」,也就是{was}{claim.topic};"
        f"刚才这句里的说法跟它对不上。哪个才是你的真实情况?直接说清楚。")
为什么不全交给模型?每轮让模型扫一遍全部历史,又慢又贵还会漏。规则先挡一道,模型只处理规则报上来的疑难,才是划算的分工。
第二层(模型精判)留给第 7 篇的逐题点评和收尾总评------那时候选人的全部回答都在,模型才有足够上下文判断"我管过十人团队"和"我没做过管理"这种换了说法的矛盾。规则层先挡住九成的显性矛盾(同一个词正反说),模型层只处理那一成的隐性矛盾,成本和时间都花在刀刃上。这也是"便宜的先跑、贵的留给疑难"这条工程原则在面试系统里的具体落地。
六、上下文裁剪:聊得再久也守得住预算
trimmer.py 守着长对话的另一条边。面试特殊在一轮=一问一答必须成对保留------把候选人的回答裁在窗口里、把问题裁掉,模型看到的最后一条是段没头没尾的回答,会当成"自己上一句没说完的话"接着编。所以裁剪有三条铁律:
- system 永不裁:人设是产品人格,不是数据。
- 滑窗:只留最近 N 轮,超了从最老的整对丢。
- token 预算:估算值超预算就继续从最老的整对丢;且裁剪后第一条若是 assistant 回答,就再丢一条(问答对不拆散)。
token 只做估算不做精确计数------裁剪发生在请求发出之前,精确数字要等服务端返回 usage,那时钱已经花了。量级正确就够用:汉字约 1.6 字/token,英文约 4 字符/token,每条消息另有约 4 token 角色开销。
七、跑起来看真实效果
python demo.py 全程离线(脚本模型预置回复,不需要 Key),四个场景正好对应四块能力:
ini
① 答对 → 判定 correct → 深挖一层(dig)
判定:quality=correct  理由:覆盖了 RDB、AOF、混合持久化三个要点,无事实性错误
动作:dig
追问:你提到 AOF 文件大恢复慢。那在生产环境里,AOF 重写期间如果磁盘 IO 打满,
      你的 Redis 会发生什么?当时你是怎么处理的?

② 半对 → 判定 partial → 追问缺失要点(probe)
判定:quality=partial  理由:流程说对了,但状态变化和三次的原因没有覆盖
缺失要点:每一步的状态变化(SYN_SENT / SYN_RCVD / ESTABLISHED);为什么是三次而不是两次
动作:probe
追问:「TCP 三次握手......」这题你答了一半,还有关键点没说到:每一步的状态变化......挑一个展开讲讲。

③ 前后矛盾 → 面试记忆命中 → 回戳
已记录的关键说法:1 条  - Kubernetes: affirm|我们的服务都跑在 Kubernetes 上......
新回答:Kubernetes 这块我没用过,我们当时都是物理机直接部署的......
矛盾检测:命中
回戳:等一下。前面你的原话是「......生产环境用了三年了。」,也就是用过Kubernetes;
      刚才这句里的说法跟它对不上。哪个才是你的真实情况?直接说清楚。

④ 聊到 12 轮 → 滑窗裁剪生效(保留最近 6 轮 + 预算 600 token)
裁剪前:25 条消息,估算 888 token
裁剪后:13 条消息,估算 456 token
第一条仍是 system:True  最后一条历史角色:AIMessage
注意第 ② 个场景:missing_points 是判定器从参考答案里原样抄出来的,不是模型编的;第 ④ 个场景裁剪后"第一条仍是 system"且"问答对完整"------这两条都是我在测试里钉死的底线,不是演示运气。
这四个场景不是四个孤立功能,而是同一套"听进去"能力的四个切面:① 是追问的深度 ,答对了不轻易放过,往生产实践里逼;② 是追问的精度 ,针对漏掉的具体要点而不是泛泛追问;③ 是跨轮的一致性 ,前后说法对不上当场揭穿;④ 是长程的成本与完整性,聊到二十轮既不烧钱也不丢人格。一个只会逐题念题的点唱机,这四个切面全是空白。
把 demo 里的脚本回复换成真实模型,这四件事一件都不会变------因为它们都写死在 rubric、策略表、记忆和裁剪的铁律里,模型只是被编排的执行者,不是决策者。这也正是"把临场发挥拿走"这句话落到实处后的结果:换任何底座模型,追问质量都不漂移。
八、测试覆盖:62 个用例把"以为判了实际没判"钉死
bash
tests/test_judge.py      判定 rubric 四档、结构化输出管线、参考答案真的进提示词
tests/test_followup.py   四路策略分流、模板变量齐全、模型模式拼接
tests/test_memory.py     极性判定、矛盾检测、回戳 prompt
tests/test_trimmer.py    滑窗、token 预算、问答对不拆、system 永不裁
tests/test_llm.py        三通路、OfflineChatModel 工具调用管线
tests/test_demo.py       四个演示场景端到端跑通
─────────────────────────
62 passed in 30.68s覆盖到什么程度:四档判定各自命中、with_structured_output 真走工具调用管线(不是绕过)、参考答案要点真的塞进了发给模型的提示词 (测试逐字断言 calls 里的原文)、模板的 {question} 一个不漏、矛盾检测 deny 先于 affirm、裁剪后问答对不拆散、三通路 build_llm 各分支。全部离线,不需要 Key、不联网。
值得强调一句:62 个用例里没有一个是"调一次真模型看它心情"。全部用 OfflineChatModel 脚本化,判定和追问的每一步行为都被断言钉死------这正是依赖注入换来的可测试性,也是这个系列能一篇篇交付、而不是每篇靠运气的原因。
九、踩坑清单
-
with_structured_output喂不进假模型 :通用FakeListChatModel只吐纯文本,判定管线直接报错。自己写OfflineChatModel,脚本条目是 pydantic 实例就包成tool_calls返回,和真实模型同管线------这是本篇最大的一个坑。 -
判定口径随模型心情漂移:一开始只说"请评估一下",模型今天看语气明天看长度。写死 rubric 四档、让模型只归类,口径才稳定。
-
矛盾检测 affirm/deny 顺序写反:"没用过"里也含"用过",如果先查 affirm 会把否定句误判成肯定。deny 必须先查。
-
裁剪把问答对拆散:只按条数裁,最后一条剩半句回答,模型当成自己没说完的话接着编。加了一道"首条不能是 assistant"的修正。
-
记忆越攒越脏:早期在每个回答里无脑记 Claim,没提到的技术也记。改成"只在回答里真出现关键词且能判极性时才记",记忆才干净。
-
回戳返回布尔值导致文案走样 :早期
check_contradiction返回True/False,上层拿到还得再拼一次字符串,三处调用拼出了三种说法。改成直接返回"回戳"原文,上层无脑说出去,文案唯一、不会变味。 -
dig/probe 硬塞模板丢掉了贴合度 :模板模式对
redirect/hint这种短句够用,但dig(往深一层挖)和probe(针对具体漏点)需要贴合题目内容,纯模板拼出来很生硬。所以这两路留了模型模式入口------短句确定性优先,长句贴合度优先,两条路输出同一个FollowUp结构,下游无感。
十、本篇收尾
现在这个面试官终于"听进去了":你答得对,它往深里挖;你答得错,它当场点破;你前后矛盾,它一秒回戳;聊到二十轮,它既记得你三年前用过 K8s,又不会把整段历史都喂给模型烧钱。它从一个点唱机,变成了会接话、会揪错的考官。
下一篇我们让它"会打分":第 7 篇写逐题点评------每答完一题,用结构化输出给出这道题的得分、亮点、短板和下一步建议,把所有回答汇成一份练后复盘。
最后一句:面试官值钱的不在"问了什么",而在"听没听进去"------判定、策略、记忆、裁剪四块拼起来,才把一个会点唱的壳,变成会深挖、会纠错、会揪水的真考官。