给 Agent 配上外部工具(Tool Calling / Function Calling)之后,质量团队常把精力放在「模型能不能选对工具、参数填得对不对」上。但在生产环境下,真正导致业务故障的,往往是网络抖动引发的副效应失控。
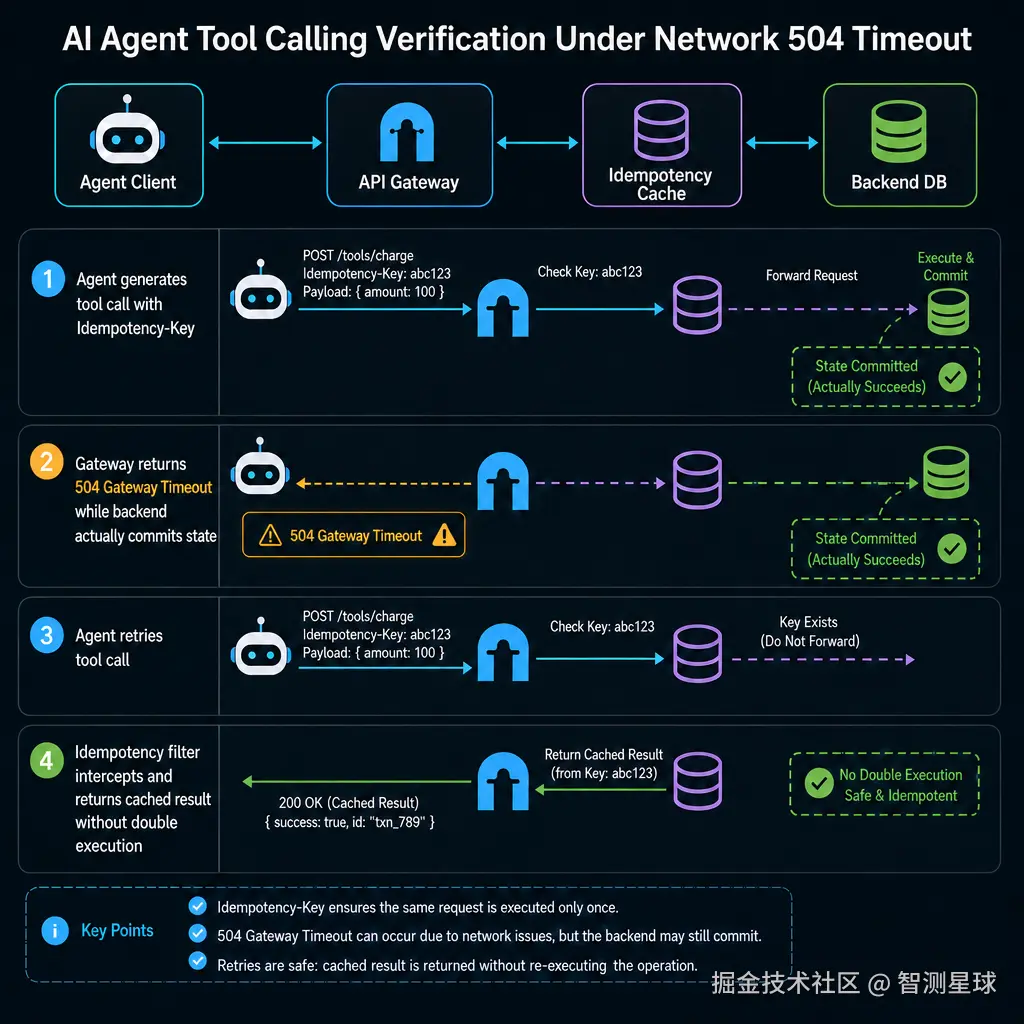
最典型的现象是:Agent 发起一次带写操作的工具调用(例如扣减库存、创建工单、执行转账),请求已经打到后端并完成持久化,但网关由于偶发超时或链路抖动,向 Agent 返回了 504 Gateway Timeout。大模型接收到底层工具抛出的超时异常后,自愈机制通常会立即生成下一轮动作------重新调用该工具或调整入参再试一次。如果底层工具没有严格的幂等控制,重复扣款、重复建单、脏数据堆积就会随之产生。
本文给出一套针对 Agent 工具调用在超时、抖动场景下的幂等与补偿测试验证方案。
一、工具调用的三态模型与测试断言盲区
在传统接口测试中,HTTP 请求基本遵循两态逻辑:要么 200 成功,要么 4xx/5xx 明确失败。但在 Agent 驱动的分布式工具调用链路上,必须显式引入「三态模型」:
- 确定成功(Success):后端已执行并返回成功报文,Agent 收到确认。
- 确定失败(Fail):参数校验拦截或前置拒绝(如 400 Bad Request、403 Forbidden),业务未发生任何状态变更。
- 状态未决(In-Doubt / Timeout):客户端与网关超时断开(如 504、502、ETIMEDOUT),后端可能完全没执行,也可能已经执行完毕甚至异步入库。
当 Agent 遇到第 3 种状态时,模型的推理逻辑具有不确定性。测试如果只断言「最终是否拿到预期返回值」,就会漏掉重试过程中的多重写入风险。
二、测试架构:透明代理与故障注入
为了系统化验证 Agent 在遇到工具超时后的行为,测试环境需要搭建一个具备故障注入能力的透明 Mock 代理层(如利用 WireMock、Mitmproxy 或轻量 Envoy 网关),截获 Agent 到真实微服务之间的工具请求。
核心拦截逻辑包括以下四个阶段:
less
[Agent 核心 Runtime]
       │
       ▼ (Tool Request: POST /api/v1/orders)
[故障注入代理 Proxy] ──── (记录请求签名、注入延迟 / 504)
       │
       ├─ Case A: 丢弃请求并直接返回 504(模拟请求未到达)
       ├─ Case B: 转发请求到微服务,微服务处理成功后,代理拦截响应并丢弃,向 Agent 返回 504(模拟响应超时)
       └─ Case C: 正常转发并返回 200
       │
       ▼
[业务微服务集群 / 数据库]
通过代理精确控制「服务端是否已经落库」与「Agent 到底收到什么 HTTP 状态码」之间的差异,才能测出边缘边界。
三、核心测试场景与用例设计
针对上述三态模型,测试方案应覆盖以下四组核心用例:
用例 1:服务端处理成功但响应超时(假死重试)
- 故障模拟 :Agent 发起
create_payment,代理将请求放行至支付服务,支付服务扣款成功(生成订单流水号TX_1001);代理在等待 3000ms 后主动断开连接,向 Agent 返回504 Gateway Timeout。 - Agent 预期反应 :Agent 接收到超时后,应先触发状态查询工具(如
get_payment_status),或携带相同的idempotency_key重新发起请求。 - 验证断言 :
- 数据库中该业务唯一键记录数始终等于 1。
- 后端幂等组件拦截第二次调用,直接返回第一次的处理结果或缓存摘要。
- 最终上下文里的账单与扣款凭证一致,禁止生成第二笔流水号。
用例 2:客户端超时取消但服务端异步仍完成(静默并发)
- 故障模拟:Agent 配置了本地工具调用超时间隔(如 5 秒)。代理刻意引入 6 秒延迟;在第 5 秒时 Agent 客户端触发 AbortSignal 断开连接;服务端在第 5.8 秒处理完成并写入数据库。
- Agent 预期反应:Agent 抛出 Client Timeout 之后,下一轮对话中应当对刚才中断的动作进行结果核验,而不是直接断定任务失败并提示用户重来。
- 验证断言:检查服务端是否支持客户端中断的主动回滚(如检测到连接关闭触发上下文取消);若不支持取消,Agent 必须通过后续查询工具核对最新状态。
用例 3:入参动态微调导致的幂等 Key 失效
- 故障模拟 :Agent 第一次调用
book_meeting_room失败,模型由于"自作聪明",在第二次重试时微调了备注字段(例如从预订研发评审变成了自动重试:预订研发评审)。如果业务系统的幂等 Key 是通过入参哈希生成的,该哈希值已发生改变。 - Agent 预期反应 :框架层必须统一管理
idempotency_key(如基于任务上下文 ID 或步骤序号固定注入 Header),禁止将生成幂等键的职责交给大模型自由组织。 - 验证断言 :无论正文文本如何微调,底层由 SDK 注入的
X-Idempotency-Key保持不变,防止绕过防重机制。
用例 4:连续失败下的退避与级联熔断
- 故障模拟:底层服务真实宕机,连续返回 500/504。
- Agent 预期反应:Agent 应当在达到最大重试次数(如 3 次)后主动停止,进入熔断状态,向用户汇报具体错误,而不是陷入无限死循环将上下文消耗殆尽。
- 验证断言:重试间隔应呈指数退避(Backoff),单任务总工具调用次数不超过上限阈值。
四、幂等与容错验收检查表
测试执行过程中,建议使用如下检查表逐项核验:
| 检查维度 | 具体验证项 | 判定标准 | 证据留存要求 |
|---|---|---|---|
| 请求凭证 | 外部写入工具是否强制注入全局唯一幂等 Key | 无 Key 请求必须被网关直接 400 拒绝 | 抓包工具记录 Request Header |
| 状态一致 | 504 响应后重试同一工具 | 服务端实体写入计数必须严格为 1 | DB 数据快照(前/后比对) |
| 自愈路径 | 超时后模型动作决策 | 优先执行查询核对或原样防重提交,不盲目新增变体 | Agent 运行日志中的 Tool Trace |
| 错误透传 | 三次连续超时后的终态 | 明确告知用户业务状态未决并输出单号,不编造成功 | 用户可见终端输出及会话日志 |
| 开销受控 | 重试过程中的 Token 与延迟 | 工具调用轮数未超过限制,无死循环发泡 | 上下文 Token 统计与耗时分析 |
五、适用边界与失效场景
在实际评测中,还需要注意这套验证方案的边界:
- 最终一致性读写分离延迟:如果业务架构采用异步事件驱动(如 Kafka)处理写入,超时后 Agent 立即调用查询工具可能出现读穿透或读到旧数据(主从延迟)。此时测试需要额外校验 Agent 对「处理中(Pending)」状态的识别能力,不能只测成功与失败。
- 纯只读工具的过度保护 :对于
search_docs或query_metrics等纯幂等查询工具,无需强制加入重试幂等锁,否则高频并发时反倒会导致锁冲突或性能劣化。
把「网络不可靠」作为默认前提去设计 Agent 工具调用的测试矩阵,才能确保智能体在复杂生产环境里不仅能干活,而且在出错时不会把系统搞乱。