H3-World 写了 CPU offload,为什么还不能保证塞进 48GB?
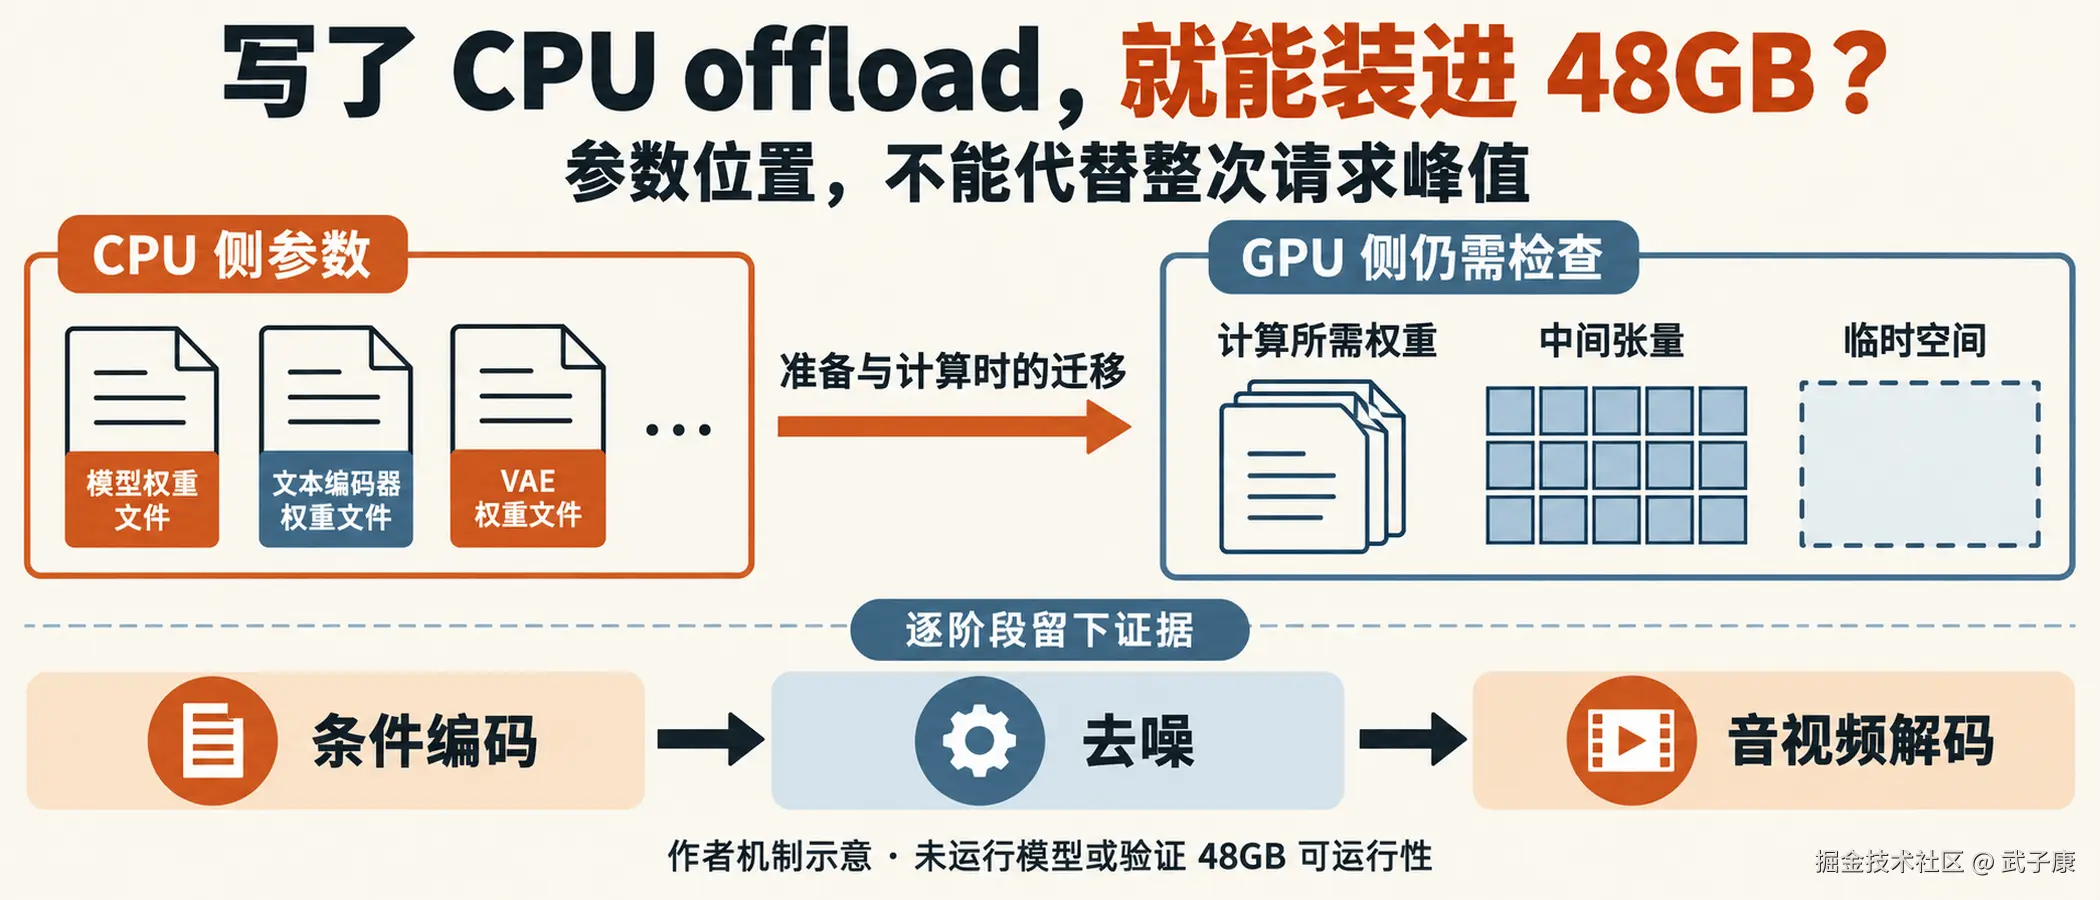
作者机制示意或待执行记录;未运行A6000,不代表实测结果。
准备在单张 A6000 上试 H3-World,先看官方推理脚本,会发现四个组件都配置了 offload_device="cpu"。这似乎已经回答了最难的问题:权重放不下,就让它们待在 CPU,需要时搬过来。
但同一份脚本还有一个更值得追问的细节:它没有向 pipeline 传入显存预算 vram_limit,而指定基础实现的默认值是 None。 再顺着调用走下去,None 对应的分支并不是"自动识别 48GB 并为整次请求留足空间"。即使补上预算,那个检查也不等于 GPU 内存的硬配额。
因此,读懂 CPU offload 配置,可以帮助我们决定下一次该测哪里;单凭它还不能写"A6000 已可运行"。下面只解释这条配置到执行的链路,不给出本机性能成绩。代码核对日为 2026 年 10 月 17 日,H3-World 固定在 f0c7be2acbbde8256b2473f6e7b088f58272acae,DiffSynth 使用仓库指定的 300e3e4da76e881d5e6bd97d897810c18f6e4893。本次没有导入模型依赖、下载权重或运行 GPU。
CPU 是卸载位置,计算前还有一次状态变化
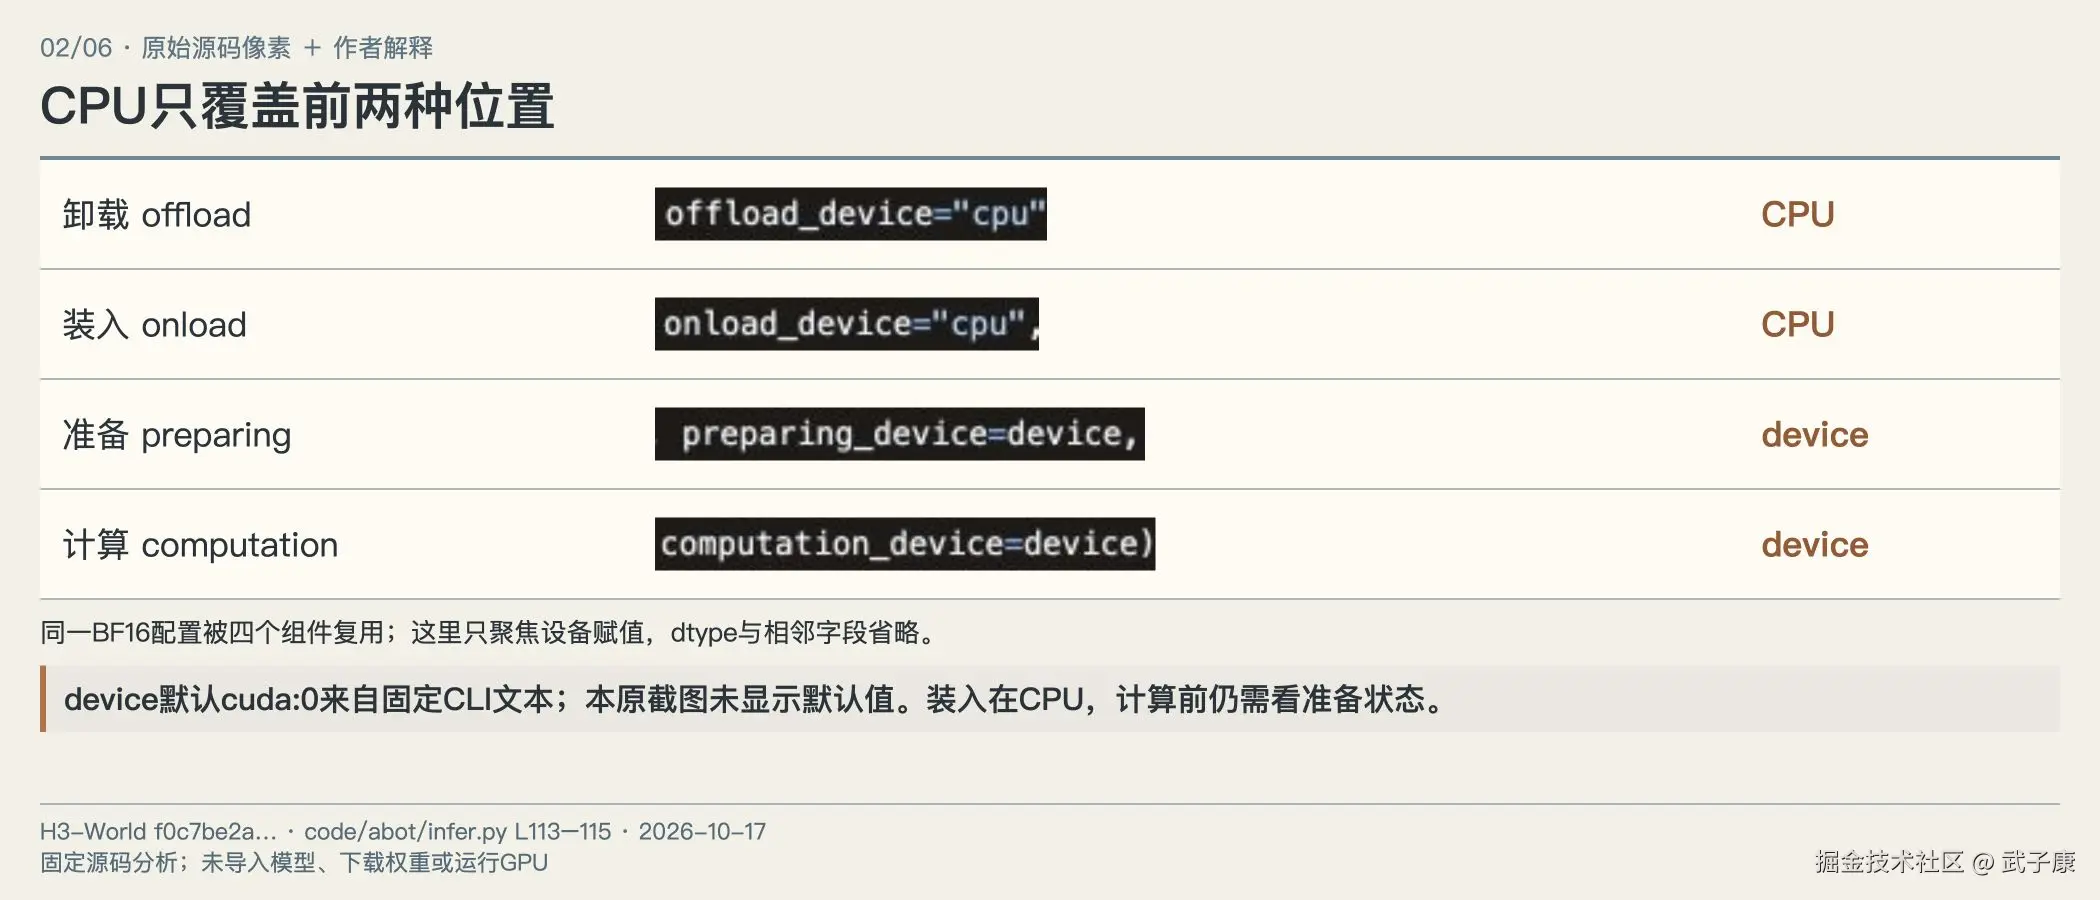
固定官方源码原页面聚焦证据;仅证明图中配置或分支,不是运行结果。
官方 load_pipeline为文本编码器、Transformer、视频 VAE 与音频 VAE 复用同一组设置。下面是其中的实际配置,省略组件路径与其他调用参数:
python
dtype = torch.bfloat16
vram_config = dict(
    offload_dtype=dtype, offload_device="cpu",
    onload_dtype=dtype, onload_device="cpu",
    preparing_dtype=dtype, preparing_device=device,
    computation_dtype=dtype, computation_device=device,
)
四组名字分别描述卸载、装入、准备与计算所用的位置和精度。默认推理设备是 cuda:0,所以前两组在 CPU,后两组指向 GPU。这里的"装入"仍然可以发生在 CPU;真正计算之前,还要看相应包装层如何进入准备状态。不能把其中任意一行扩写成"整个组件永远只在 CPU"。
这些设置也不是注释。ModelConfig.vram_config() 把它们交给 BasePipeline.download_and_load_models(),后者连同 vram_limit 传入 ModelPool。模型池识别权重对应的模型类,并根据显存管理映射选择包装层,再由核心 loader 安装这些包装层。这条路径说明配置由谁消费,避免只从变量名猜行为。配置与装载入口
对原始 H3 Transformer,固定映射把 torch.nn.Linear 对应到 AutoWrappedLinear,把 torch.nn.RMSNorm 对应到 AutoWrappedModule。编码器和两个 VAE 各有自己的映射,包含嵌入、卷积、归一化或模型专用模块。由此不能把全部组件想成一整块,也不能假定每个模块都采用完全相同的包装方式。H3 组件映射
接下来只跟踪映射明确覆盖的线性层。它的 onload() 会把状态置为 1;按上述设置,这一步对应 CPU。第一次进入 forward() 时,满足条件就调用 preparing(),将权重按准备位置转移,并把状态置为 2。之后若准备位置与计算位置、精度相同,computation() 可以直接使用现有权重。
这能降低哪些阶段的 GPU 权重常驻,要结合阶段卸载一起判断。已经准备好的某层,不会仅因为一次线性运算返回就自动变回 CPU 状态;该包装层的 offload() 才负责转回卸载位置并恢复状态 0。这里描述的是代码中的状态转换,不是断言目标机器上所有层都已驻留、必然超容或每一步都重复搬运。
读这一组状态时,可以把两个问题写在同一条记录里:调用者希望参数准备到哪里,实际包装对象此刻又在哪里。前者能从配置确定,后者需要在运行中读取真实对象。即使配置都使用同一个字典,组件映射到的包装类也不同,不能只检查一个线性层就替文本编码器、Transformer和两个VAE共同签字。本文沿线性层解释,是因为它的映射与分支能够固定核对;没有把这一局部对象扩展成所有模块的统一执行轨迹。
状态编号同样只是包装实现的标记,不是显存占用率。状态1说明这个对象已经进入装入状态,不说明CPU或GPU总共还有多少空间;状态2说明它进入准备状态,不说明激活和后续解码所需空间已经预留。将对象状态与资源读数分别记下来,才可能在失败后回答"参数准备是否发生"和"哪个阶段还有其他存活对象",而不是拿一个状态码替代容量记录。
vram_limit=None 到底跳过了什么
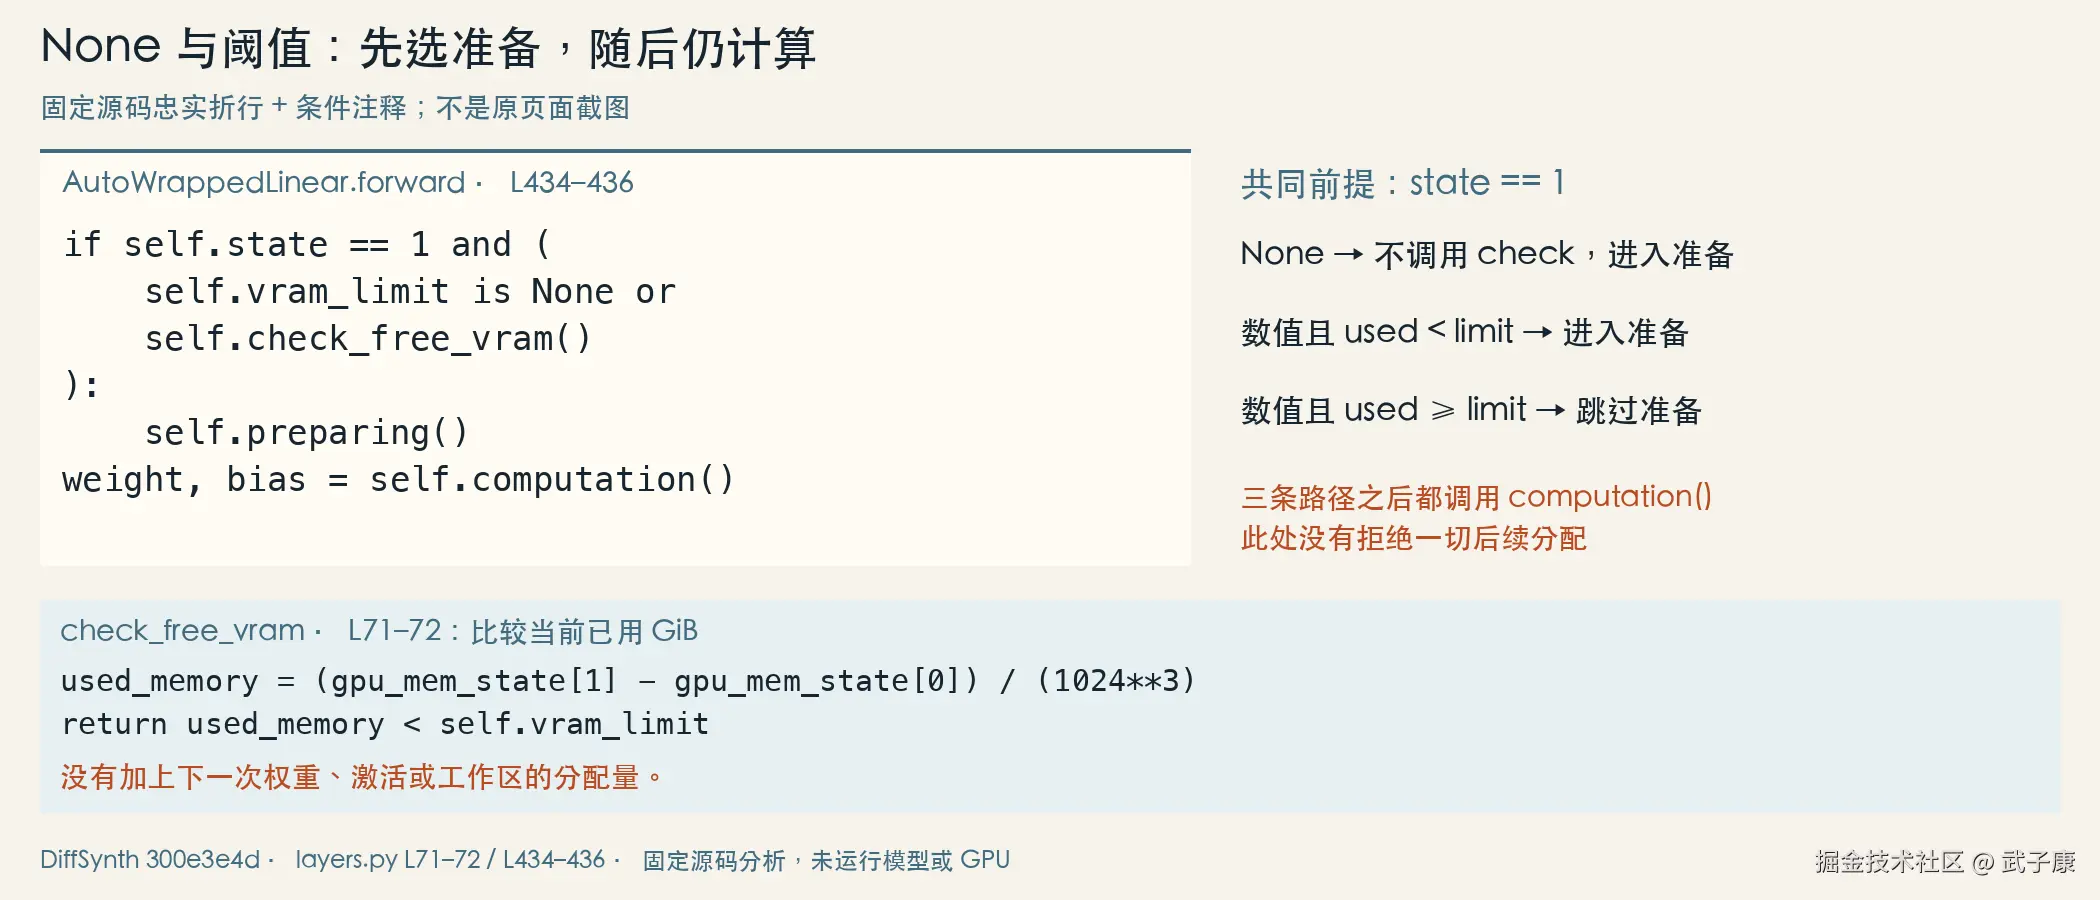
固定源码完整条件与公式的忠实摘录,按语义折行;旁列为作者条件注释,非原页面截图,未运行模型或GPU。
官方推理的 from_pretrained(...) 调用没有给出 vram_limit。指定 pipeline 的默认参数是 None,继续沿上述装载链传给包装层。对 AutoWrappedLinear,关键分支如下,省略了与当前问题无关的计算尾部:
python
if self.state == 1 and (
    self.vram_limit is None or self.check_free_vram()
):
    self.preparing()
weight, bias = self.computation()
这段代码的顺序很重要。当层处于状态 1 且预算为 None 时,条件中的第一项已经成立,不需要先执行 check_free_vram(),便会进入准备状态。None 在这里表示没有启用这项阈值比较,不能解读成"框架已替 A6000 自动算好安全余量"。AutoWrappedModule 也有同形的准备条件,但执行模块和线性权重的实现不同,分析时仍需区分对象。固定包装层实现
这并不等于框架完全没有显存管理。卸载配置、组件切换和包装层都在工作;我们只确认:这次参考调用没有显式提供这一项预算,线性层在对应状态下没有通过它做容量比较。设备自身容量、分配失败以及其他路径的行为,不能被这个局部分支概括成"没有任何限制"。
一种自然的修正是给 vram_limit 填上数字。但要先读清这个数字会决定什么。固定实现的 check_free_vram() 取设备内存信息,计算当前已用量,以 GiB 为单位,然后判断:
python
used_memory = (gpu_mem_state[1] - gpu_mem_state[0]) / (1024**3)
return used_memory < self.vram_limit
这个条件没有把"下一层准备增加多少权重、紧随其后的激活与工作区需要多少"加进比较。即使当前值低于阈值,下一次分配也可能越过它。这里引用的是包装层选择准备路径的逻辑,不是对一次真实运行的内存预测。
更容易漏掉的是比较失败之后。forward() 只是跳过 preparing(),仍继续调用 computation()。对还处于 CPU 装入状态的线性层,若其位置或精度不匹配计算要求,后者会调用 cast_to(),在计算设备上创建权重副本并复制数据。也就是说,阈值可以影响参数是否进入准备驻留状态,但当前运算仍然需要自己的计算用权重和临时空间。 它没有在这个分支中宣布"预算不足,拒绝一切新分配"。
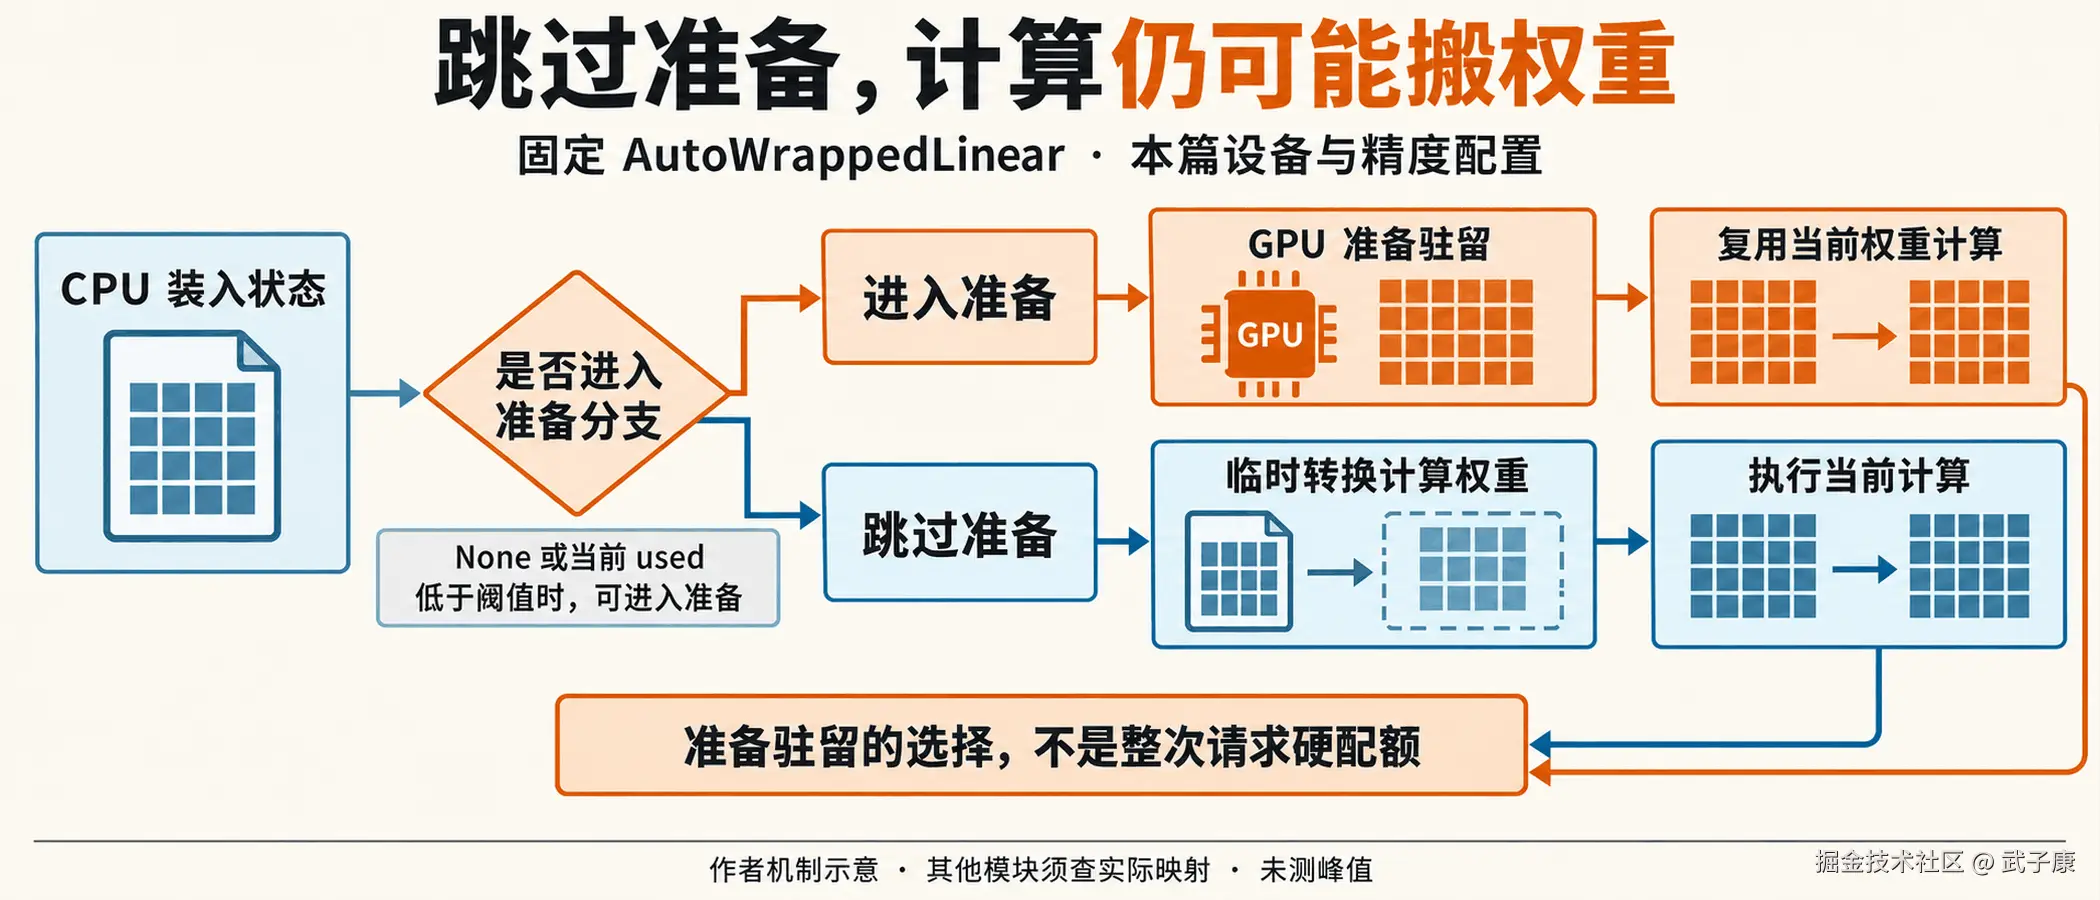
作者机制示意或待执行记录;未运行A6000,不代表实测结果。
这就解释了为什么不能把 vram_limit 当作整次请求的硬额度,更不能直接把商品页的 48GB 填进去便宣布验收完成。这里没有给出应该填多少的经验值;实际设备可见容量、其他进程、分配器、输入大小与执行路径都需要进入测量记录。
还可以把这段条件分成一次选择和一次计算来看。选择发生在当前状态与当前内存读数上;计算发生在随后的具体输入上。比较条件返回真,只是让这次调用进入准备路径,并没有在该处承诺后续所有分配都能满足。返回假,也没有在该处结束线性运算。因此,记录预算实值时必须把它与实际分支一起保存;仅记"已启用预算"仍无法知道本次究竟沿哪条路径执行。
据此排查时,先不要用"阈值失效"概括任何分配失败。至少要区分:观察到的是准备驻留增加、临时计算权重增加,还是计算之外的中间对象仍存活。这些项目可能在一次请求中交叠,源码分析只能给出要查的对象,不能替实际测量分摊比例。本文没有提出新的显存预测公式,也没有为48GB设备给出一个未经试验的安全预算。
组件会切换,留下的中间结果还要单独算
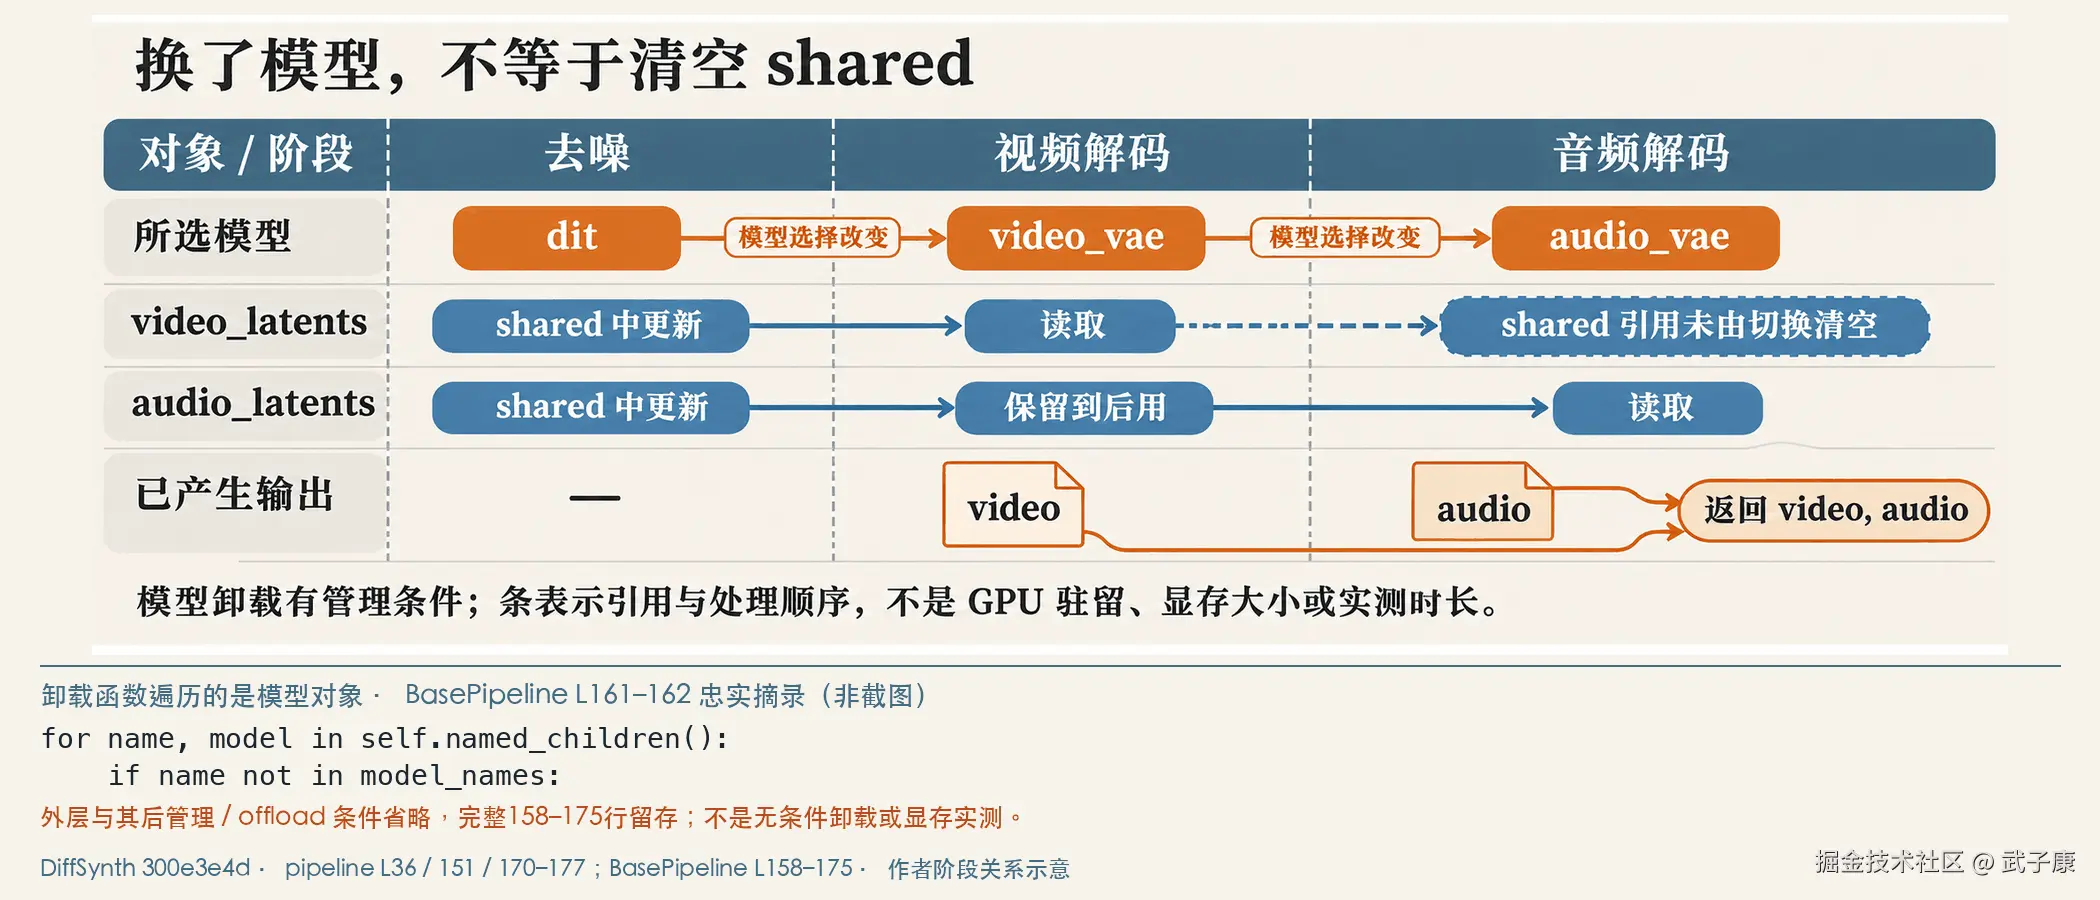
固定源码两行忠实摘录与作者阶段/引用关系示意,非原页面截图;管理前提及后续条件已省略并注明,完整函数留存,未运行模型或GPU。
只看包装层仍会少一半信息。固定 pipeline 在去噪前调用 load_models_to_device(self.in_iteration_models),该列表是 ("dit",);解码阶段再先后请求 video_vae 和 audio_vae。基础调度函数会对未被选中的、启用了显存管理的组件调用卸载,对选中组件调用装入。H3-World 补丁增加动作输入,并没有把这些阶段切换改成另一套显存调度。pipeline 阶段调用
所以,不能把四个权重文件的体积简单相加,当作每个时刻都同时驻留在 GPU 的数量。反过来,组件被卸载,也没有证明 GPU 已经只剩下下一组件的权重。
例如,去噪循环在共享输入中更新视频与音频 latent;视频解码使用其中的视频 latent,音频解码随后使用音频 latent。权重调度与这些中间张量的生命周期是两条相关但不同的线。load_models_to_device() 遍历的是模型组件,没有把共享输入字典里的全部张量一并清空。注意力计算的中间结果、输出帧以及运行时缓存,也不能由一个权重卸载位置代为计量。
因此,有意义的容量问题应具体到某个阶段:进入去噪时编码器是否已经卸载、哪些输入仍保留;进入视频解码时 Transformer 处于什么状态;切到音频解码后还保留哪些结果。这些都是待观察的问题,不是本文宣称已经发生的峰值位置。CPU 侧也要同步记录:把权重从 GPU 移走,主机内存与数据传输并没有消失。
PyTorch 的活跃张量内存与缓存分配器保留内存也应分开看。官方说明中,memory_allocated() 和 memory_reserved() 对应不同口径;释放未使用缓存不会释放仍被张量占用的内存。单张系统监控截图不能反推某个权重包装层是否按预期转换状态。PyTorch 2.10 CUDA 内存说明
阶段名称也不能自动代表一个绝对清空点。组件切换函数的职责是处理被管理的模型,解码参数的职责是把所需latent交给下游;两条调用链在同一流程中出现,但管理对象并不相同。若在阶段入口看到显存没有明显下降,既不能据此确认卸载失败,也不能仅凭函数名确认卸载完成。需要回到实际组件状态和仍存活的输入输出,核对观测时刻与代码位置是否对应。
这个区分还影响如何保存失败现场。文件写出前已经出现了中间输出,并不等于完整音画已交付;后续阶段失败也不应抹掉此前已经完成的阶段。记录中保留到达位置、当前输入配置和未完成项,才能在修改单一条件后比较差异。该表的目的不是提前判定哪一步必然最占内存,而是让下一次真正运行留下足以支持那个判断的证据。
下一次运行,先留下怎样一条记录
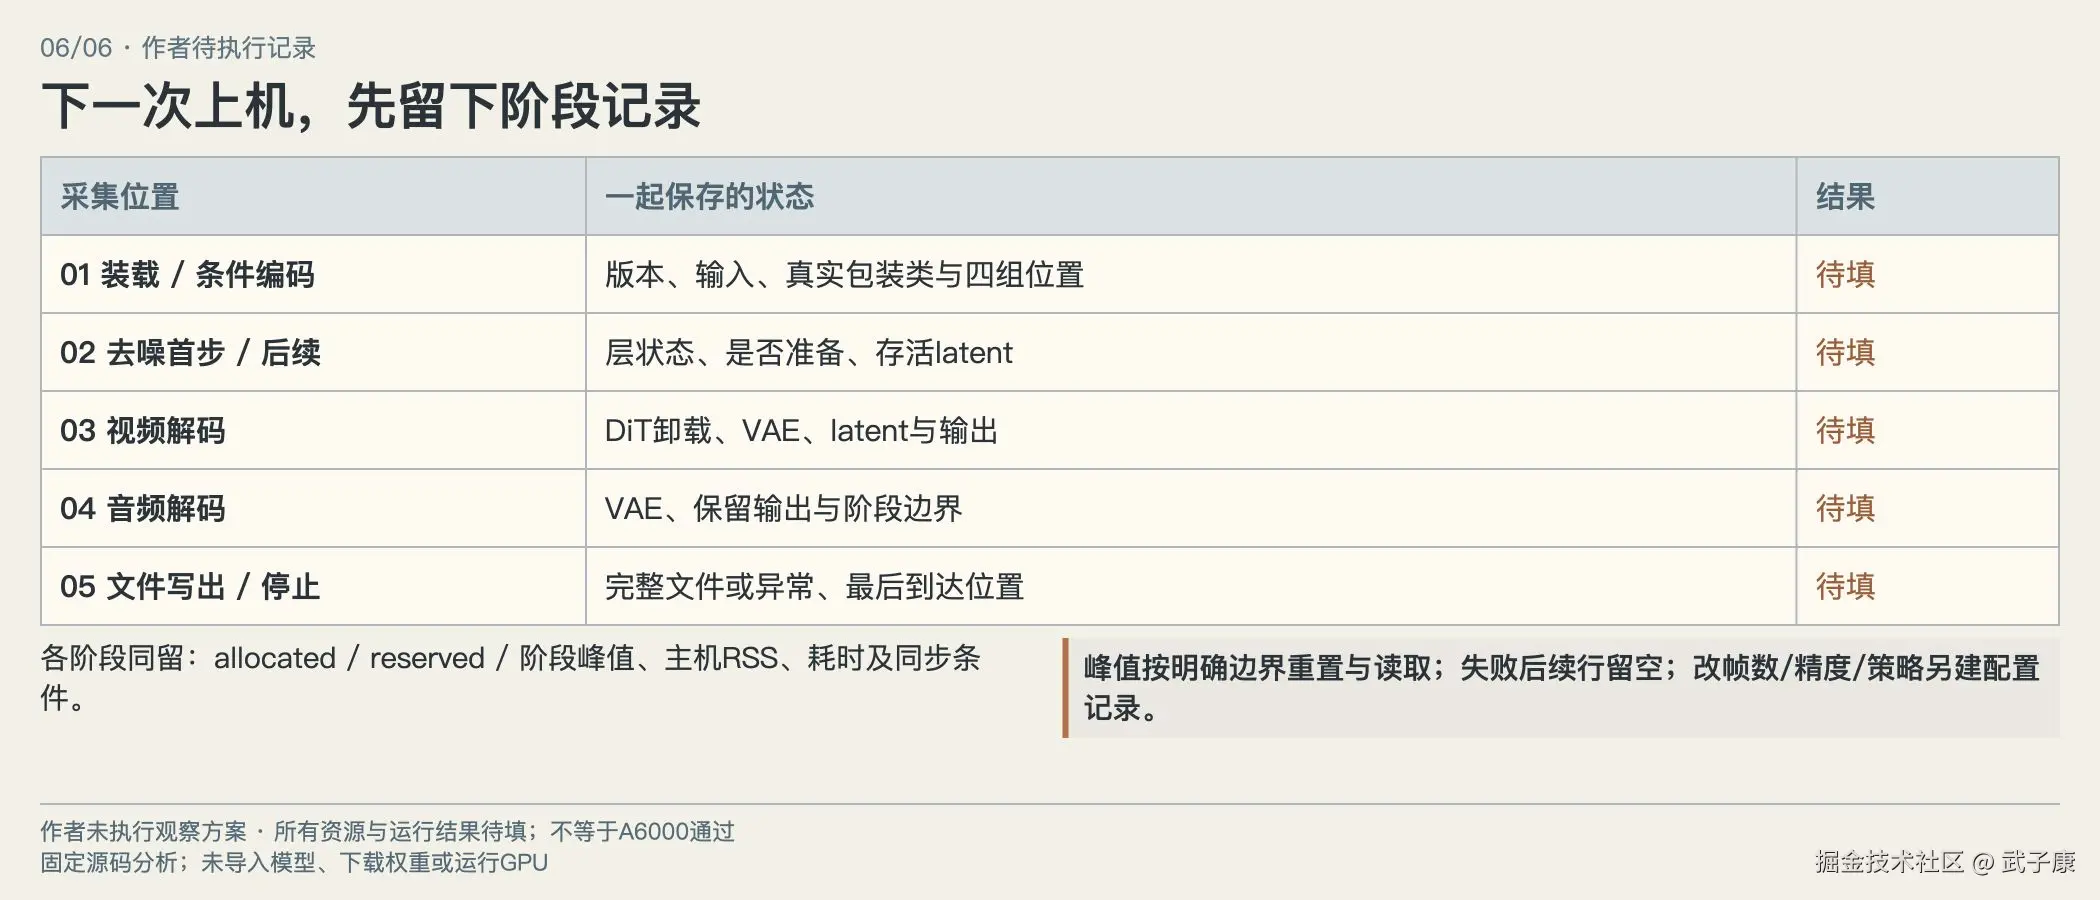
作者机制示意或待执行记录;未运行A6000,不代表实测结果。
由这条源码链自然得到的行动,是记录"准备驻留怎么选、阶段切换留下什么、峰值在哪里",而非先组合量化、裁剪与少步加速。下面是作者设计的待执行采集表,所有资源值和运行结果都留空;它不是新的模型 API,也不是 A6000 的测试报告。
| 采集位置 | 要和资源值一起保存的状态 | 本次实际结果 |
|---|---|---|
| 装载完成、条件编码前 | 权重版本、真实组件类与包装层,四组设备/精度,vram_limit 实值 | 待填 |
| 条件编码结束、去噪开始 | 编码器卸载情况,DiT 装入状态,保留的 embedding 与 latent 形状 | 待填 |
| 去噪首步及后续步骤 | 选定线性层的状态与设备,准备路径是否进入,当前输入配置 | 待填 |
| 视频解码入口与结束 | DiT 卸载情况,视频 VAE 状态,保留的音视频 latent 与输出对象 | 待填 |
| 音频解码与文件写出 | 音频 VAE 状态,保留的输出,文件是否完整及停止位置 | 待填 |
每行同时采集活跃分配、保留量、阶段峰值、设备或进程监控口径、主机 RSS 与时间。单位和测量工具保持一致,阶段峰值要在清楚的边界重置与读取,避免拿整次历史最大值冒充当前阶段峰值。计时时标明是否同步,以及冷启动还是后续运行;插入同步本身可能改变调度,观测配置也属于实验条件。峰值统计说明与重置说明
只采阶段入口的瞬时值仍会漏掉内部峰值,因此记录应同时保留该阶段的峰值与原始日志。若任务在某次分配失败,就保留最后到达的阶段、异常和当时状态,后续行继续空着。若为了完成任务改了帧数、分辨率、精度或卸载策略,建立另一条配置记录;新配置完成不替原配置填写通过。
先按固定参考路径建立这样一条记录,才有依据判断下一步该改什么。若峰值主要来自准备驻留,讨论相应预算和卸载选择;若发生在解码,就继续看该阶段的权重与输出;若切换组件后内存没有按预期变化,核对实际对象与存活张量。以上是诊断分流,不是尚未测试便提供的一键修复承诺。
量化与 BF16 LoRA 分支也要等这条基线明确后再比较。一个更小的权重文件不能替当前 loader 的实际 dtype、临时副本与控制结果作证;基础 H3 的历史成片耗时,也不能借给加入动作路径的 H3-World。本文因此不沿用原笔记中的速度估计或"保证不超过 48GB"的推演。
最终可以确定的判断是:CPU offload 描述参数如何在执行状态间转移;48GB 可运行性需要整次请求的实测峰值与完整输出。 固定源码已经足以拆清二者之间缺少哪段证据,却还不足以代填那段证据。下一次上机,应先把这条记录留完整,再决定是否有必要更换量化、缓存或注意力实现。
来源与核验范围
- H3-World 固定推理入口与固定补丁:四组件配置、默认设备与动作接入范围。
- DiffSynth 固定模型池、核心装载器、组件映射与包装层:核配置传递、原始 H3 模型类和准备/计算分支。这里分析固定版本,不当作所有运行时的统一实现。
- PyTorch 2.10 文档:仅解释内存与峰值统计口径,未执行这些观测。
原 ZIP 07_A6000_DEPLOYMENT.md 仅作选题种子。本文没有本机资源曲线、音画成片或动作回归;未将基础 H3、h3.c、社区量化文件或其他硬件的成绩移植为 H3-World 结果。