用 AI 这么久了,我突然意识到一个问题。
那就是 AI 厂商太多了,不管是大厂小厂都在发新模型,而且大多数模型发布都很集中,往往 DeepSeek 发完了,GLM 发,GLM 发了还没测,Qwen、Kimi 又杀出来了,几乎每个月都有新版本发布,每家都说自己代码能力又上了一个台阶。
但具体哪个模型干活好、哪个模型价格低,靠自己一个个去测的话根本测不过来。
最理想的状态当然是:简单的活交给便宜模型,难的活交给强模型,每个任务都用刚好够用的那个。但这个刚好够用如何判断、每个档位该配哪个模型,一般来说很难自己搞清楚。
我发现了一个 GitHub 项目,就专门干这事儿的。
这个 GitHub 的思路就是:不用你自己挑模型,他们每月把主流模型测一遍,把当月最合适的配置直接下发到你的客户端。
先简单说一下 OpenSquilla 是什么。它是基元律动开源的 Agent 框架,日常用起来和常见的 Agent 平台差不多:给它一个任务,它帮你拆解、调用工具、把活干完。
区别在背后的智能路由。一般的 Agent 平台固定用一个模型,而 OpenSquilla 会按任务难度自动换模型。
目前 OpenSquilla 做的是微内核的架构,在核心引擎层只做了编排调度和状态管理,其他能力都以插件的形式展开,这不就很像是 DSH 的 Cordits 微内核模式么。
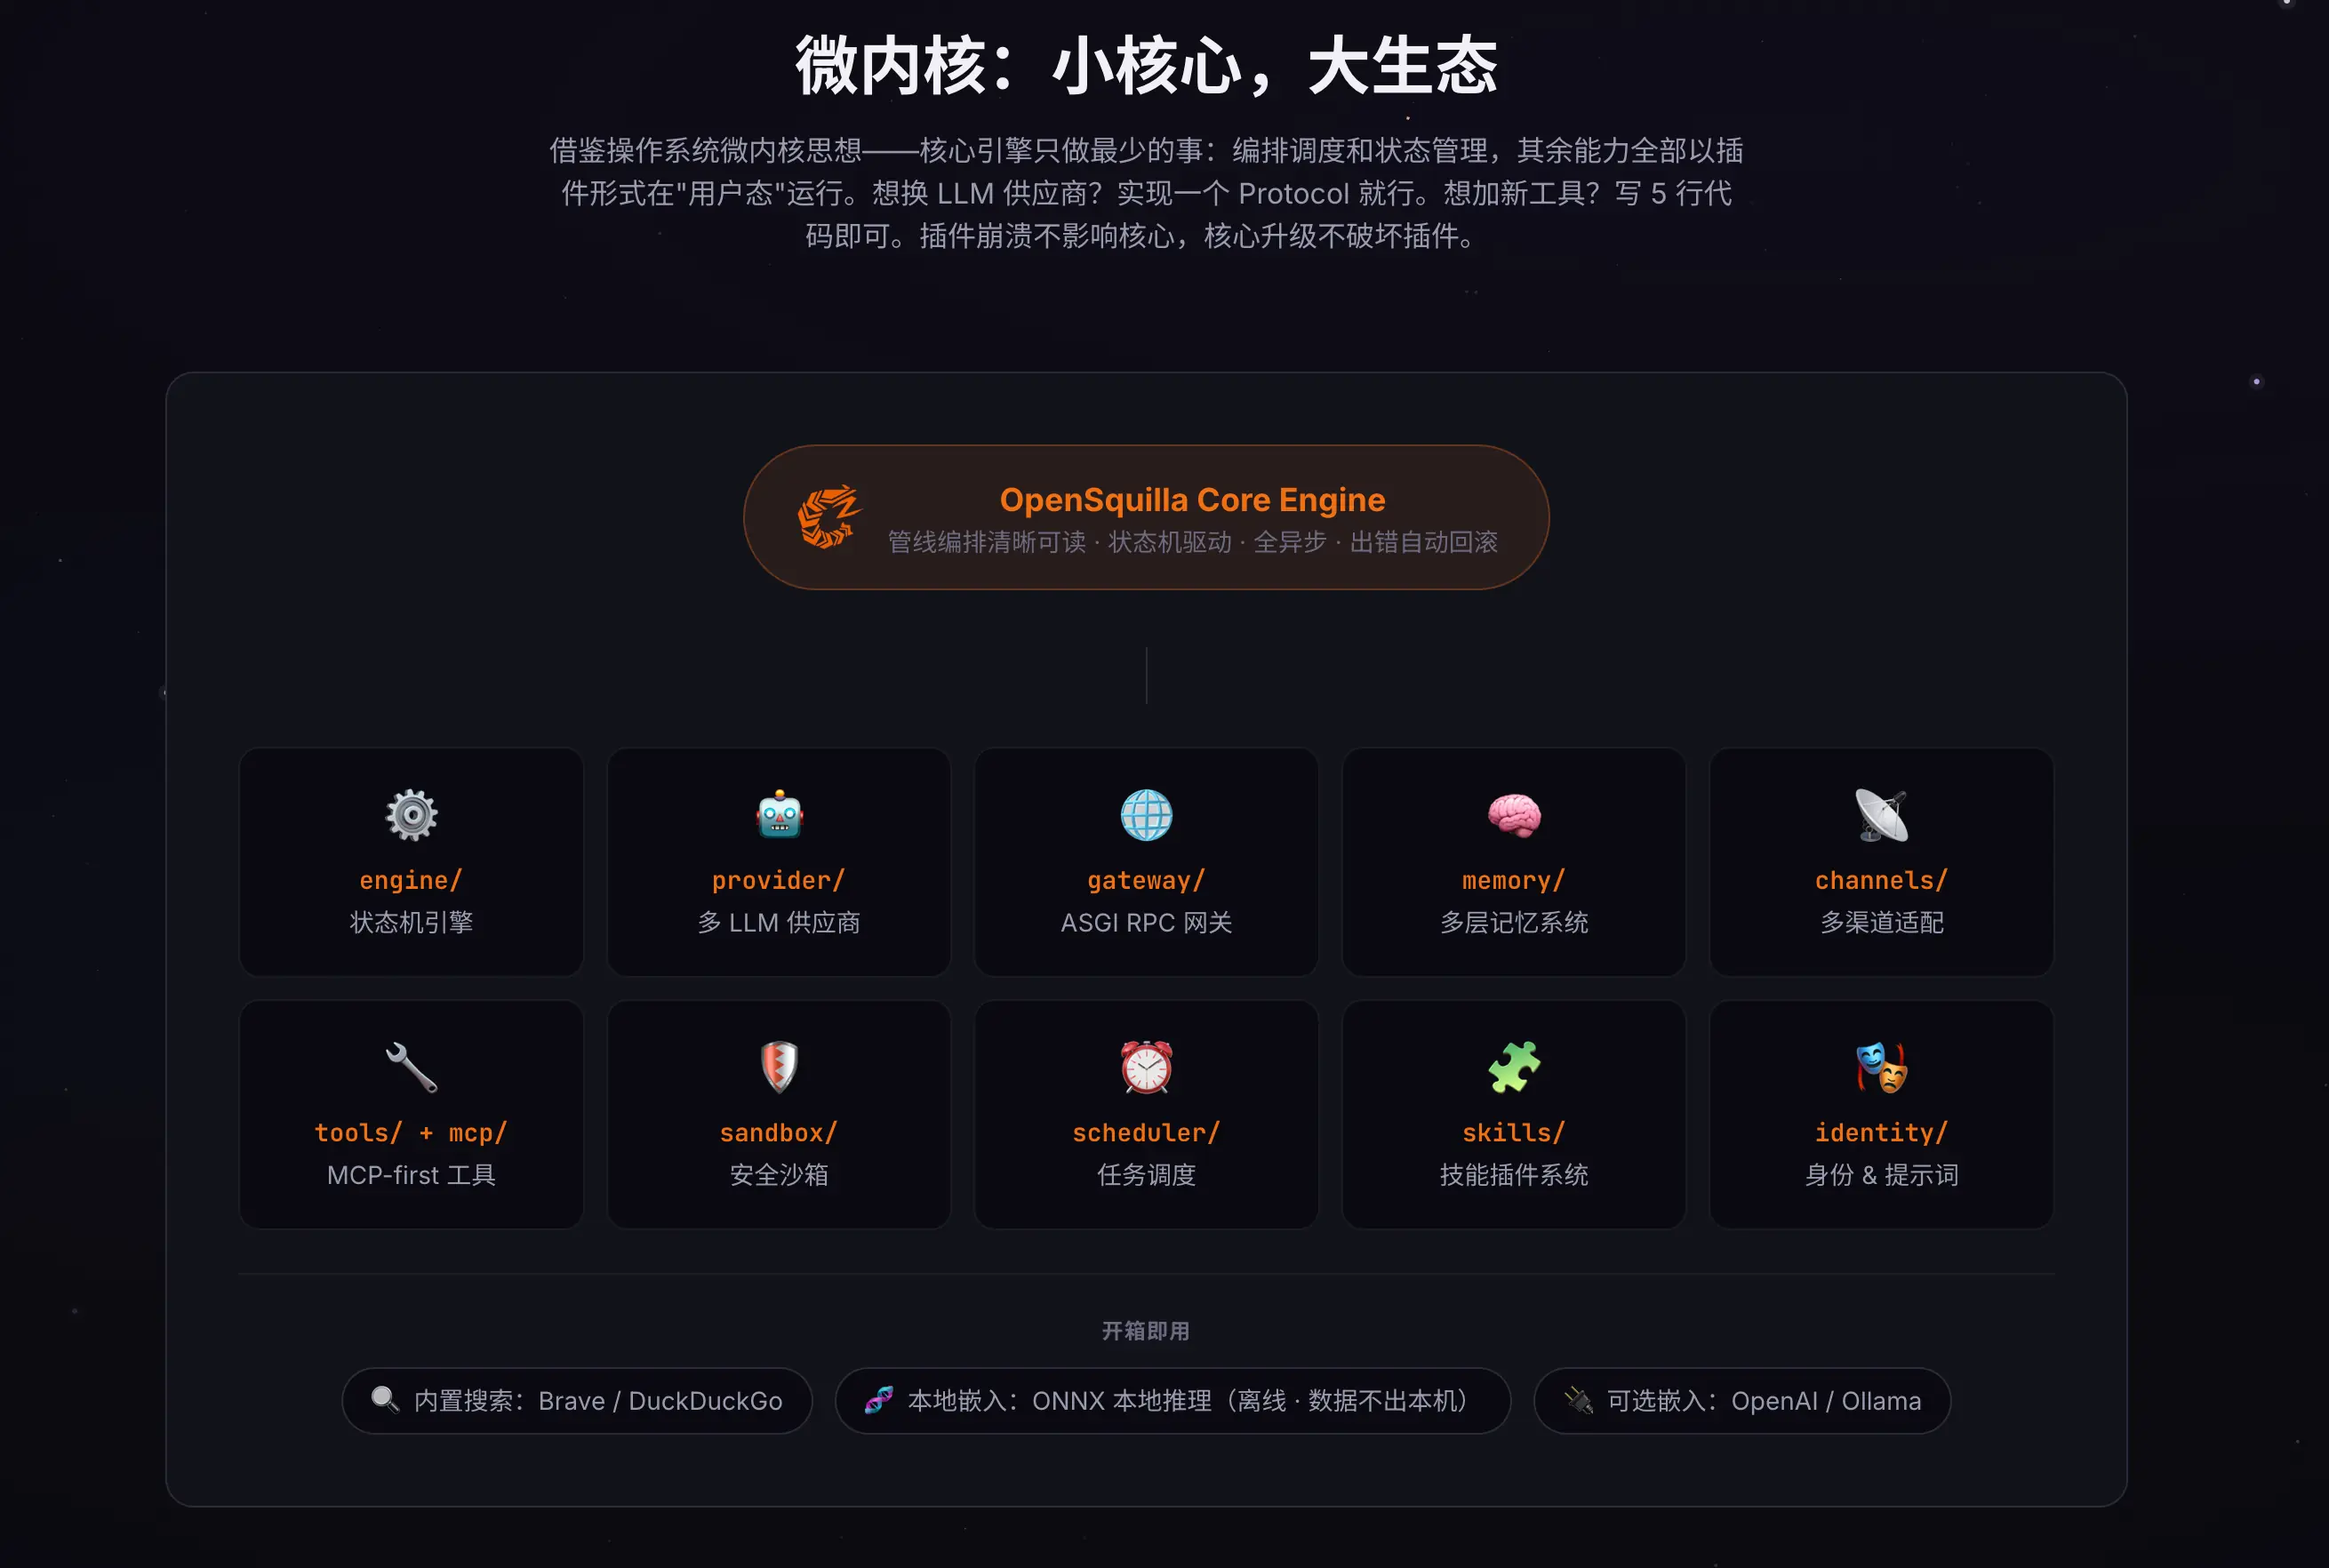
模型路由这块,主要分为三层。
1. C0 至 C3 四个档位,本地路由器判断任务该用哪一档。
OpenSquilla 会把任务按难度分成 C0、C1、C2、C3 四档,C0 是最简单的任务,C3 是最复杂的。每次你发起任务,本地的路由器先判断这个任务属于哪一档,再交给对应档位的模型去做。
2. 一次请求只调用一个模型。
有些智能路由的模型为了选得准,会让多个模型同时跑一遍,再从结果里挑最好的。这样效果可能不错,但 Token 费用直接涨了好几倍。
OpenSquilla 没这么干,它一次请求只调用被选中的那一个模型,这也是它用得省的关键。
3. 继续同一个任务沿用原档位,需要重做时才升档
同一个任务继续执行的时候,会沿用原来的档位,不会每轮都重新判断。
只有当对当前结果不满意、需要重做时,才会往上升档,换更强的模型来处理。
十一月模型推荐榜
那每个档位具体用哪个模型?这就是 OpenSquilla 每月推荐榜要解决的问题。
推荐榜是基元律动内部实验测出来的最优配置。每个月,他们会把新模型的各种组合放在多个公开的 Agent 基准上做综合测试,比如:
- Claw-SWE-Bench:代码修复任务;
- AppWorld:跨应用的事务办理任务。
测试时同时看效果和花费,比较本期配置、往期配置、只用单一模型 三种做法,最后选出处于帕累托前沿 的那一组,说人话就是:同样的花费下效果最好,同样的效果下花费最低。
11 月这个月是第一期,四个档位的模型如下:
档位
模型
C0
Qwen3.8-Flash
C1
DeepSeek-V4.1-Flash
C2
GLM-5.3
C3
Kimi K3
基准结果
十一月配置与往期配置相比:
基准
得分变化
平均单题生成费用变化
Claw-SWE-Bench(代码修复)
+32.41%
-22.10%
AppWorld(跨应用任务)
+9.39%
+2.96%
在代码修复这一项得分高了 32%,费用反而低了 22%,等于又快又省。
AppWorld 这项需要说清楚:得分提升了 9% 左右,但平均单题费用也上涨了约 3%。这是一个取舍,跨应用任务链路长、步骤多,为了把成功率拉上来,需要多花一点费用。
更新不用等客户端发版
还有一点我挺喜欢:推荐配置和客户端是分开更新的。
TokenRhythm 和 OpenRouter 两套推荐配置,OpenSquilla 在启动时检查一次,之后每 24 小时检查一次。有新配置时,会先让你看新旧配置的差异,你确认后才会应用。
也就是说,新模型一出来、榜单一更新,你不用等客户端发新版本就能用上,同时也不会在你不知情的情况下偷偷换模型。
实测
光看数据不够,我下载下来实际跑了一下,看看实际怎么样。
下载安装
OpenSquilla 目前支持 Windows、Mac、Linux 三端,安装方式有好几种,按自己的习惯选就行。
方式一:桌面客户端(推荐普通用户)
这个最省事,不需要装 Git、Python 这些环境。目前桌面安装包提供了 Mac 和 Windows 两个版本。
下载后按提示一路安装即可,Mac 拖进应用程序文件夹就行。需要注意的是,登录 TokenRhythm 账户这个功能目前只有桌面端才有。
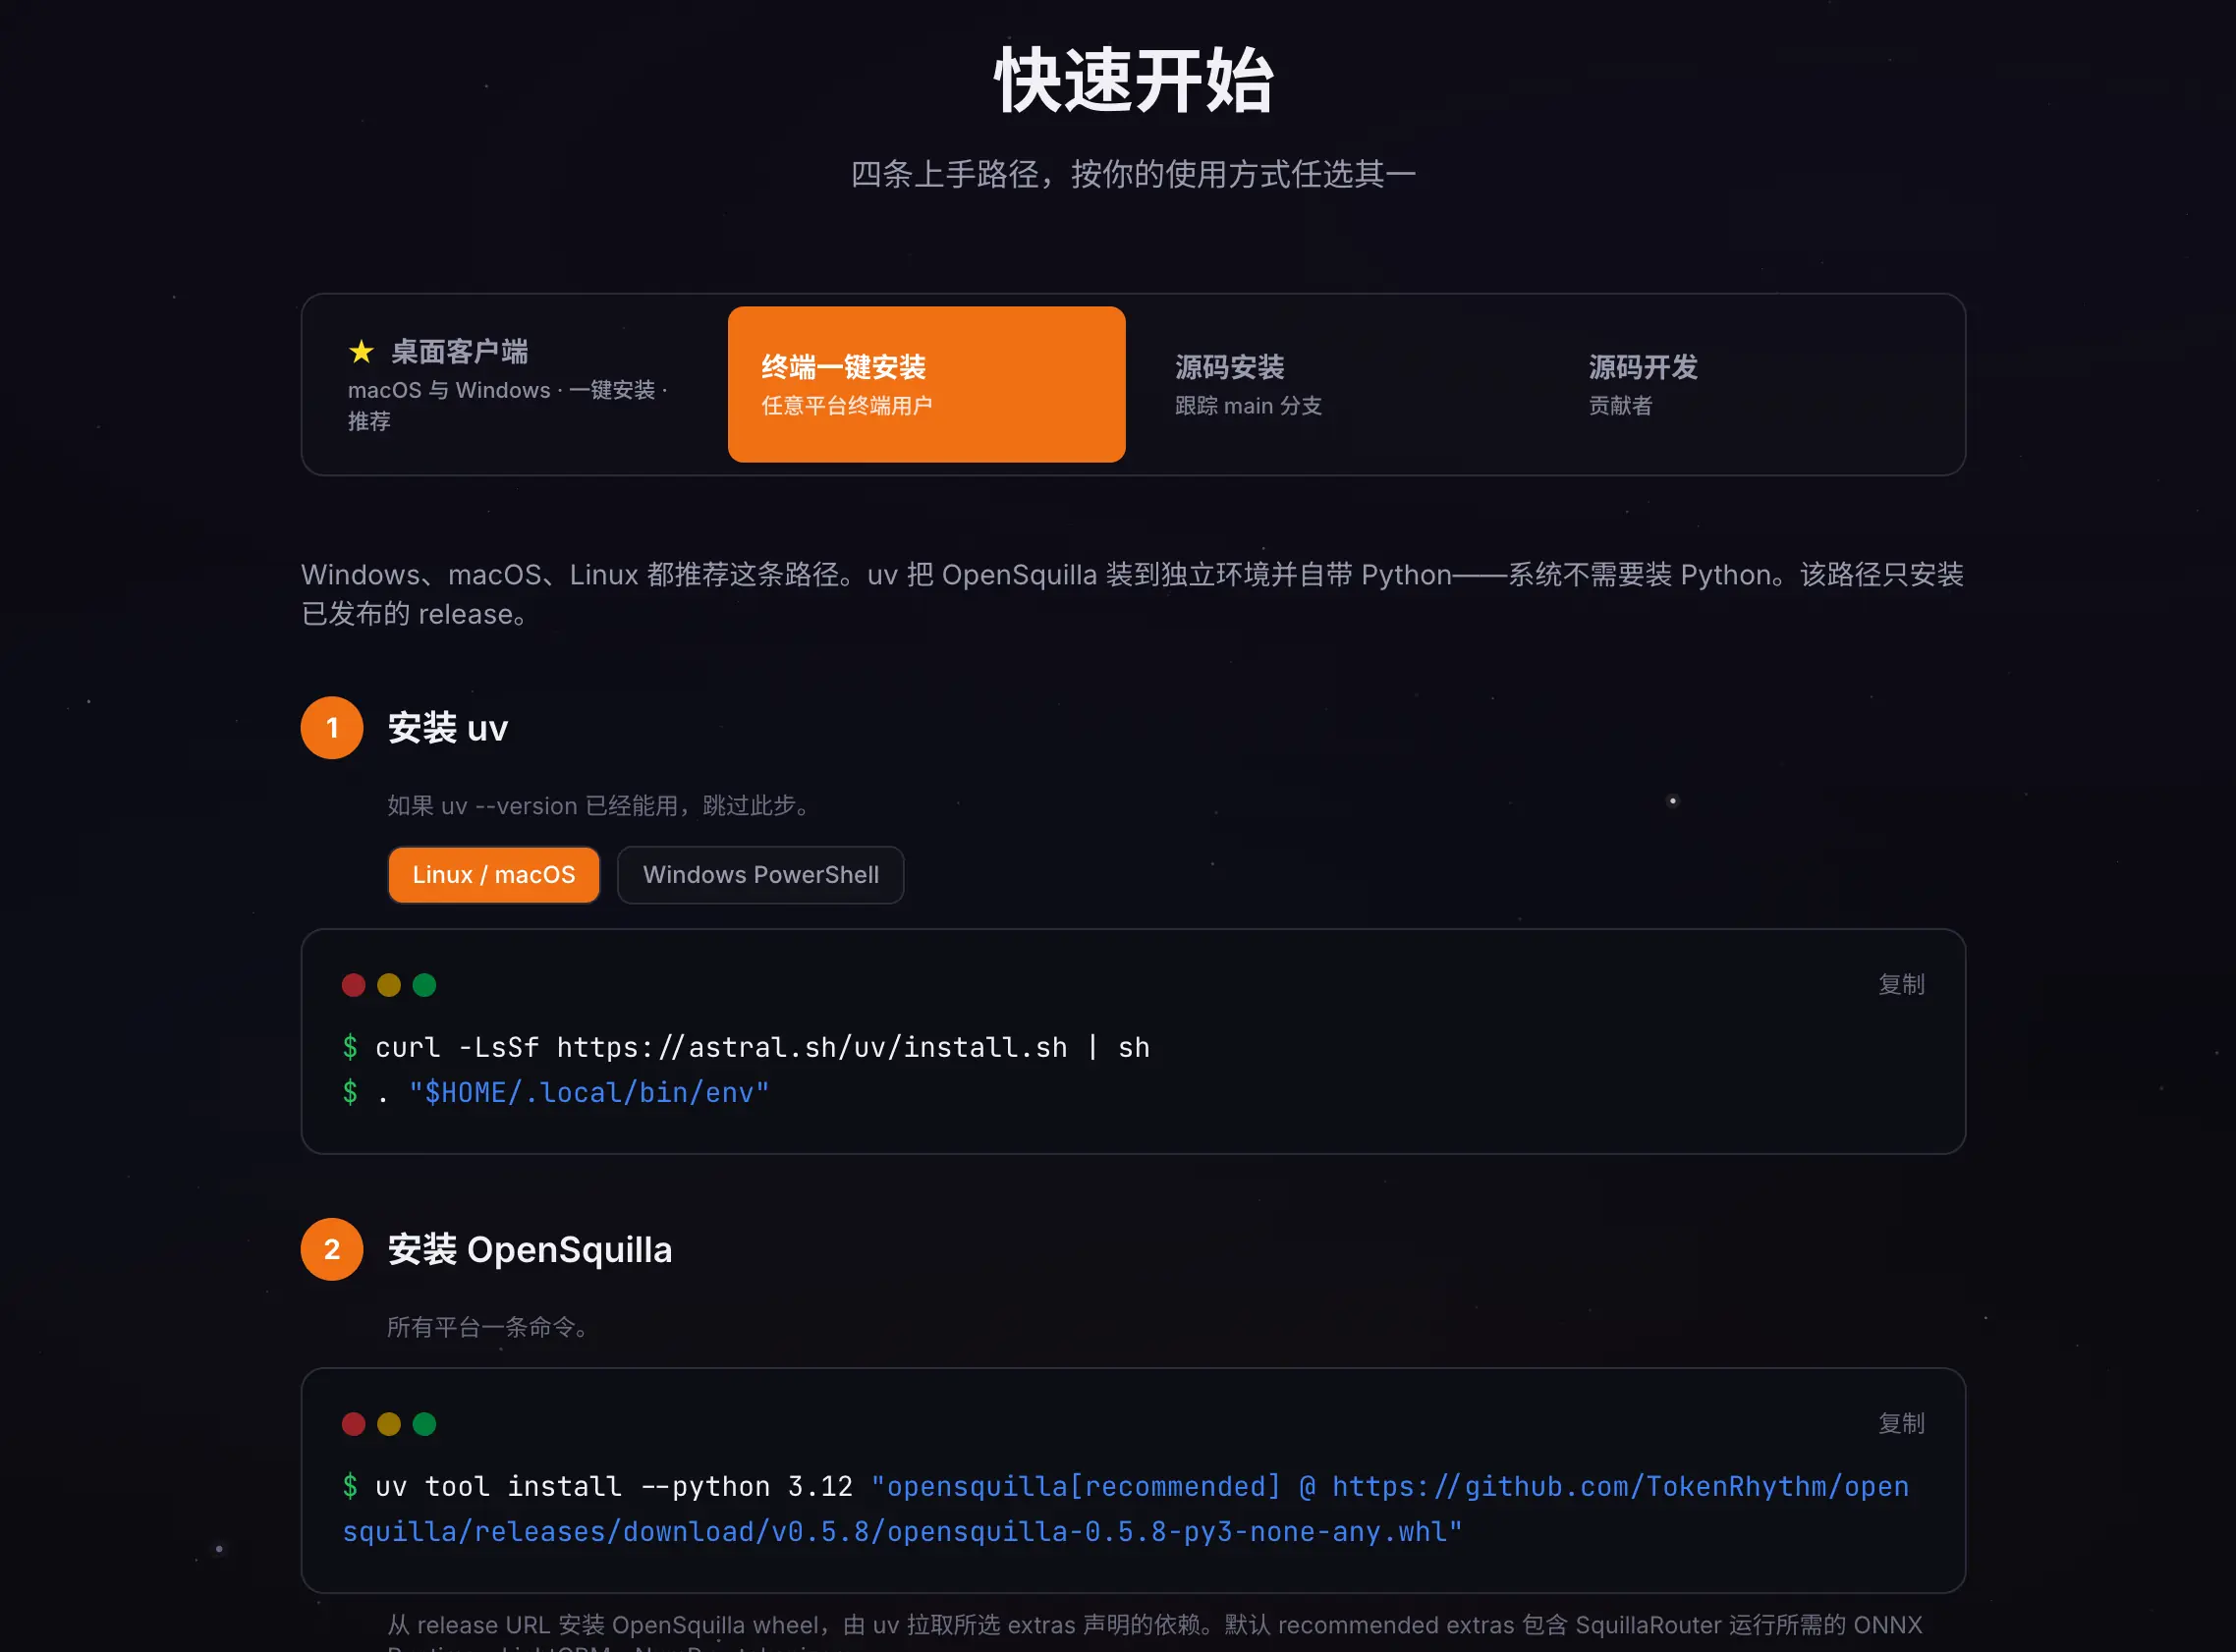
方式二:终端安装(推荐 Linux 和命令行用户)
Linux 用户,或者习惯在终端里用、想部署到服务器上的,可以用 uv 直接装发布好的版本,不需要提前装 Python,uv 会自己处理。
先装 uv(已经装过的跳过):
bash
# macOS / Linux
curl -LsSf https://astral.sh/uv/install.sh | sh

# Windows PowerShell
powershell -c "irm https://astral.sh/uv/install.ps1 | iex"
然后安装 OpenSquilla,三个平台命令都一样:
css
uv tool install --python 3.12 "opensquilla[recommended] @ https://github.com/TokenRhythm/opensquilla/releases/download/v0.5.8/opensquilla-0.5.8-py3-none-any.whl"这里的 recommended 会把本地路由器 SquillaRouter 一起装上,智能路由就靠它。
装完之后跑一下初始化向导,配置模型来源和 API Key,再启动 Gateway:
bash
opensquilla onboard       # 首次配置向导
opensquilla gateway run   # 启动服务,默认 127.0.0.1:18791
opensquilla chat          # 或者直接在终端里对话
遇到问题可以跑一下 opensquilla doctor,它会检查环境有没有就绪。
另外官方也提供了 Docker 镜像(ghcr.io/tokenrhythm/opensquilla:v0.5.8),支持 amd64 和 arm64,服务器部署也可以用这个。
方式三:源码安装(想跟进最新 main 分支的)
源码安装需要提前装好 Git、Git LFS、Node.js 22.12+ 和 uv。路由器用到的模型文件是放在 Git LFS 里的,所以 clone 完要记得拉一下 LFS:
bash
git lfs install
git clone https://github.com/TokenRhythm/opensquilla.git
cd opensquilla
git lfs pull --include="src/opensquilla/squilla_router/models/**"
然后运行安装脚本:
bash
# macOS / Linux
bash scripts/install_source.sh

# Windows PowerShell
powershell -ExecutionPolicy Bypass -File ./scripts/install_source.ps1
脚本会顺手把 Vue 写的 Web 控制台也构建好,装完同样用 opensquilla onboard 初始化。
我这里图省事,直接用的桌面客户端。
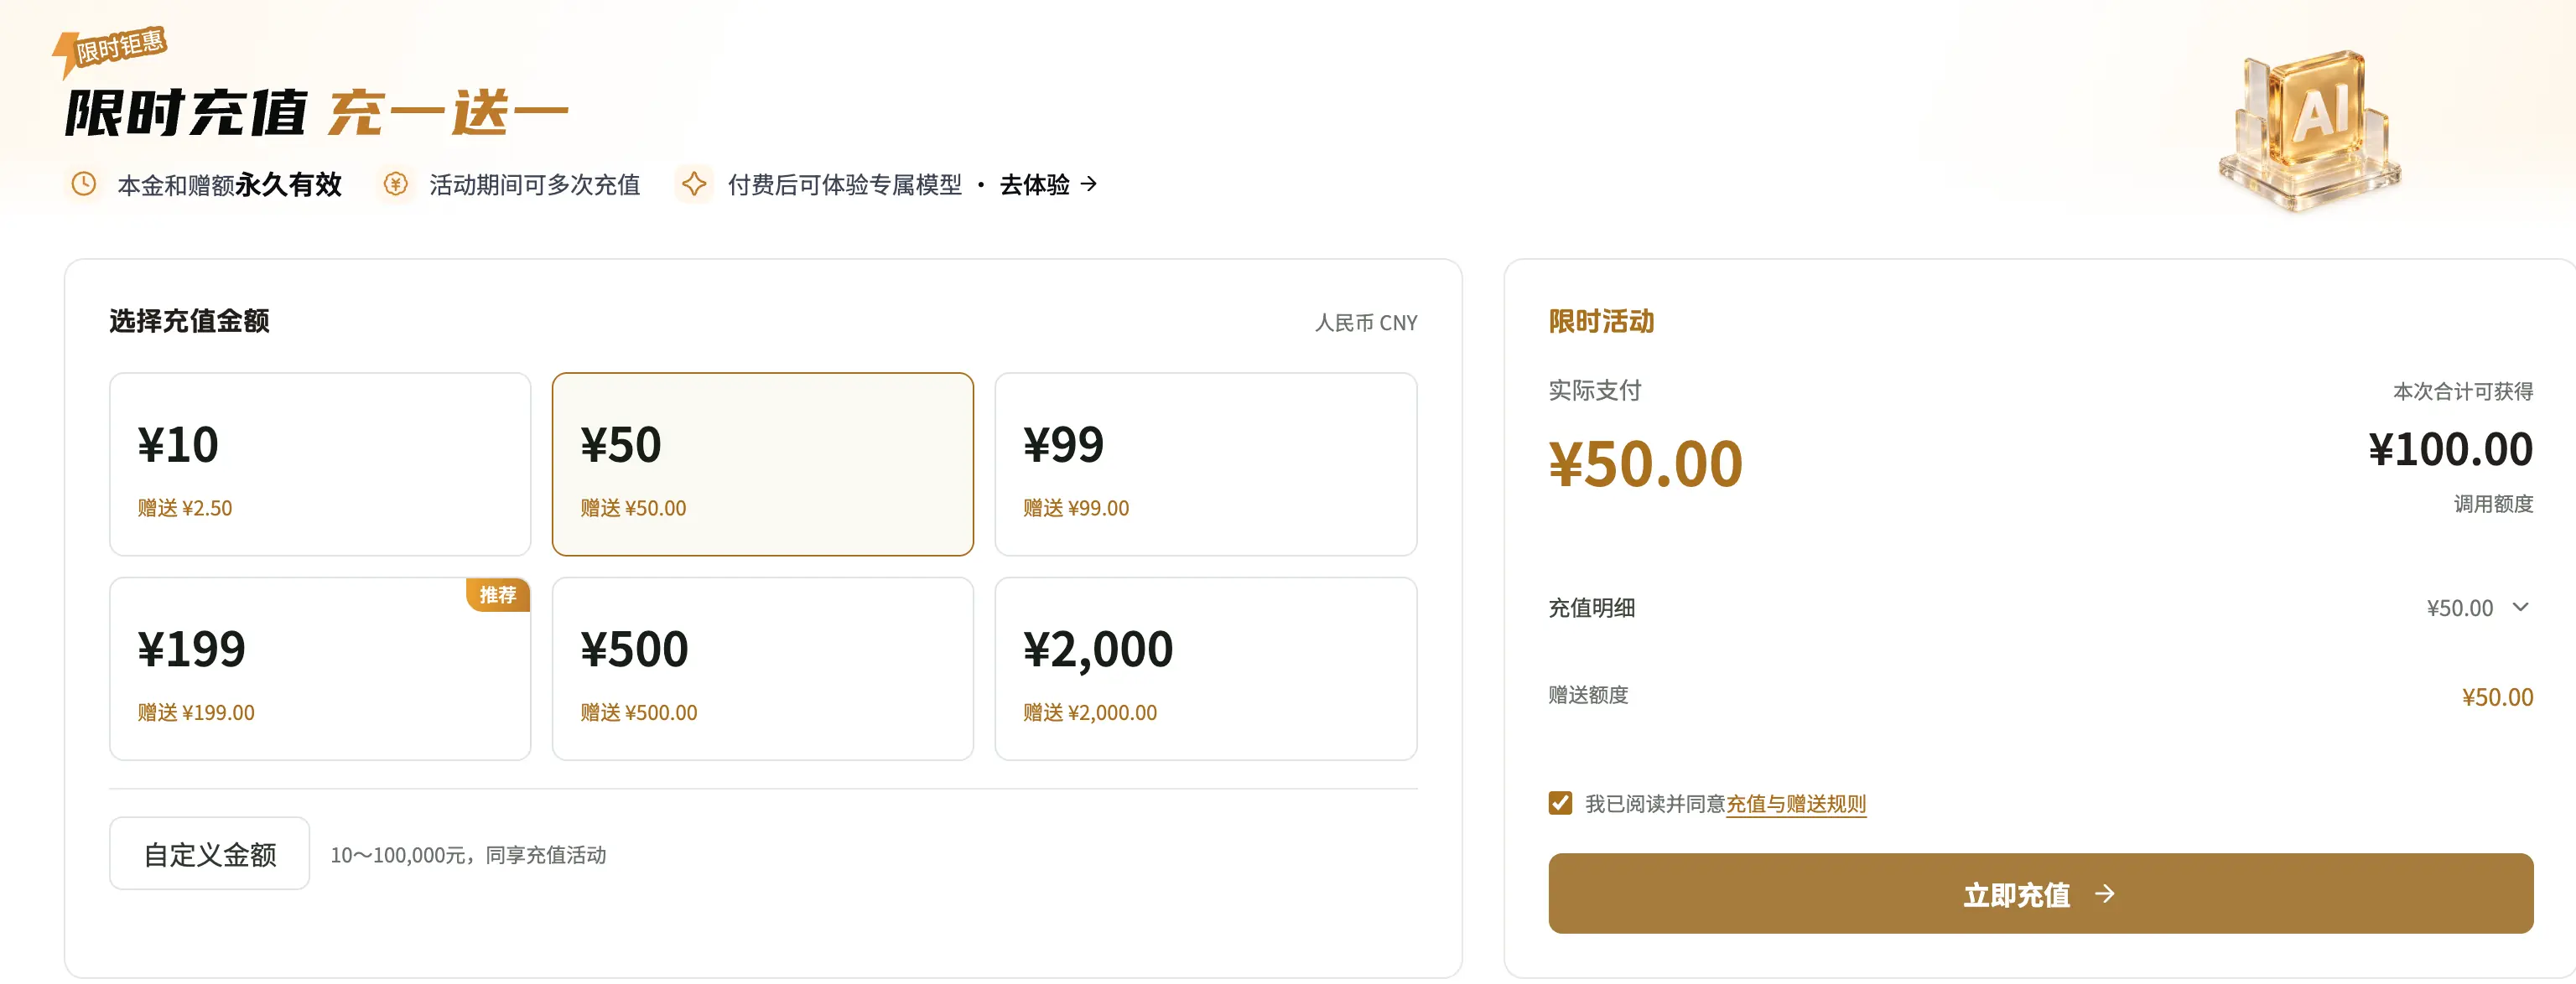
OpenSquilla 用的模型由基元律动的多模型 API 平台 TokenRhythm 提供,所以需要先注册一个 TokenRhythm 账户。实名认证之后,会给 18 元的体验额度,先跑几个任务完全够用,目前我看着也是有限时充一送一的活动。
OK,下载完成后我们开始实测。
打开主页还是需要先登录一下 TokenRhythm 账户。
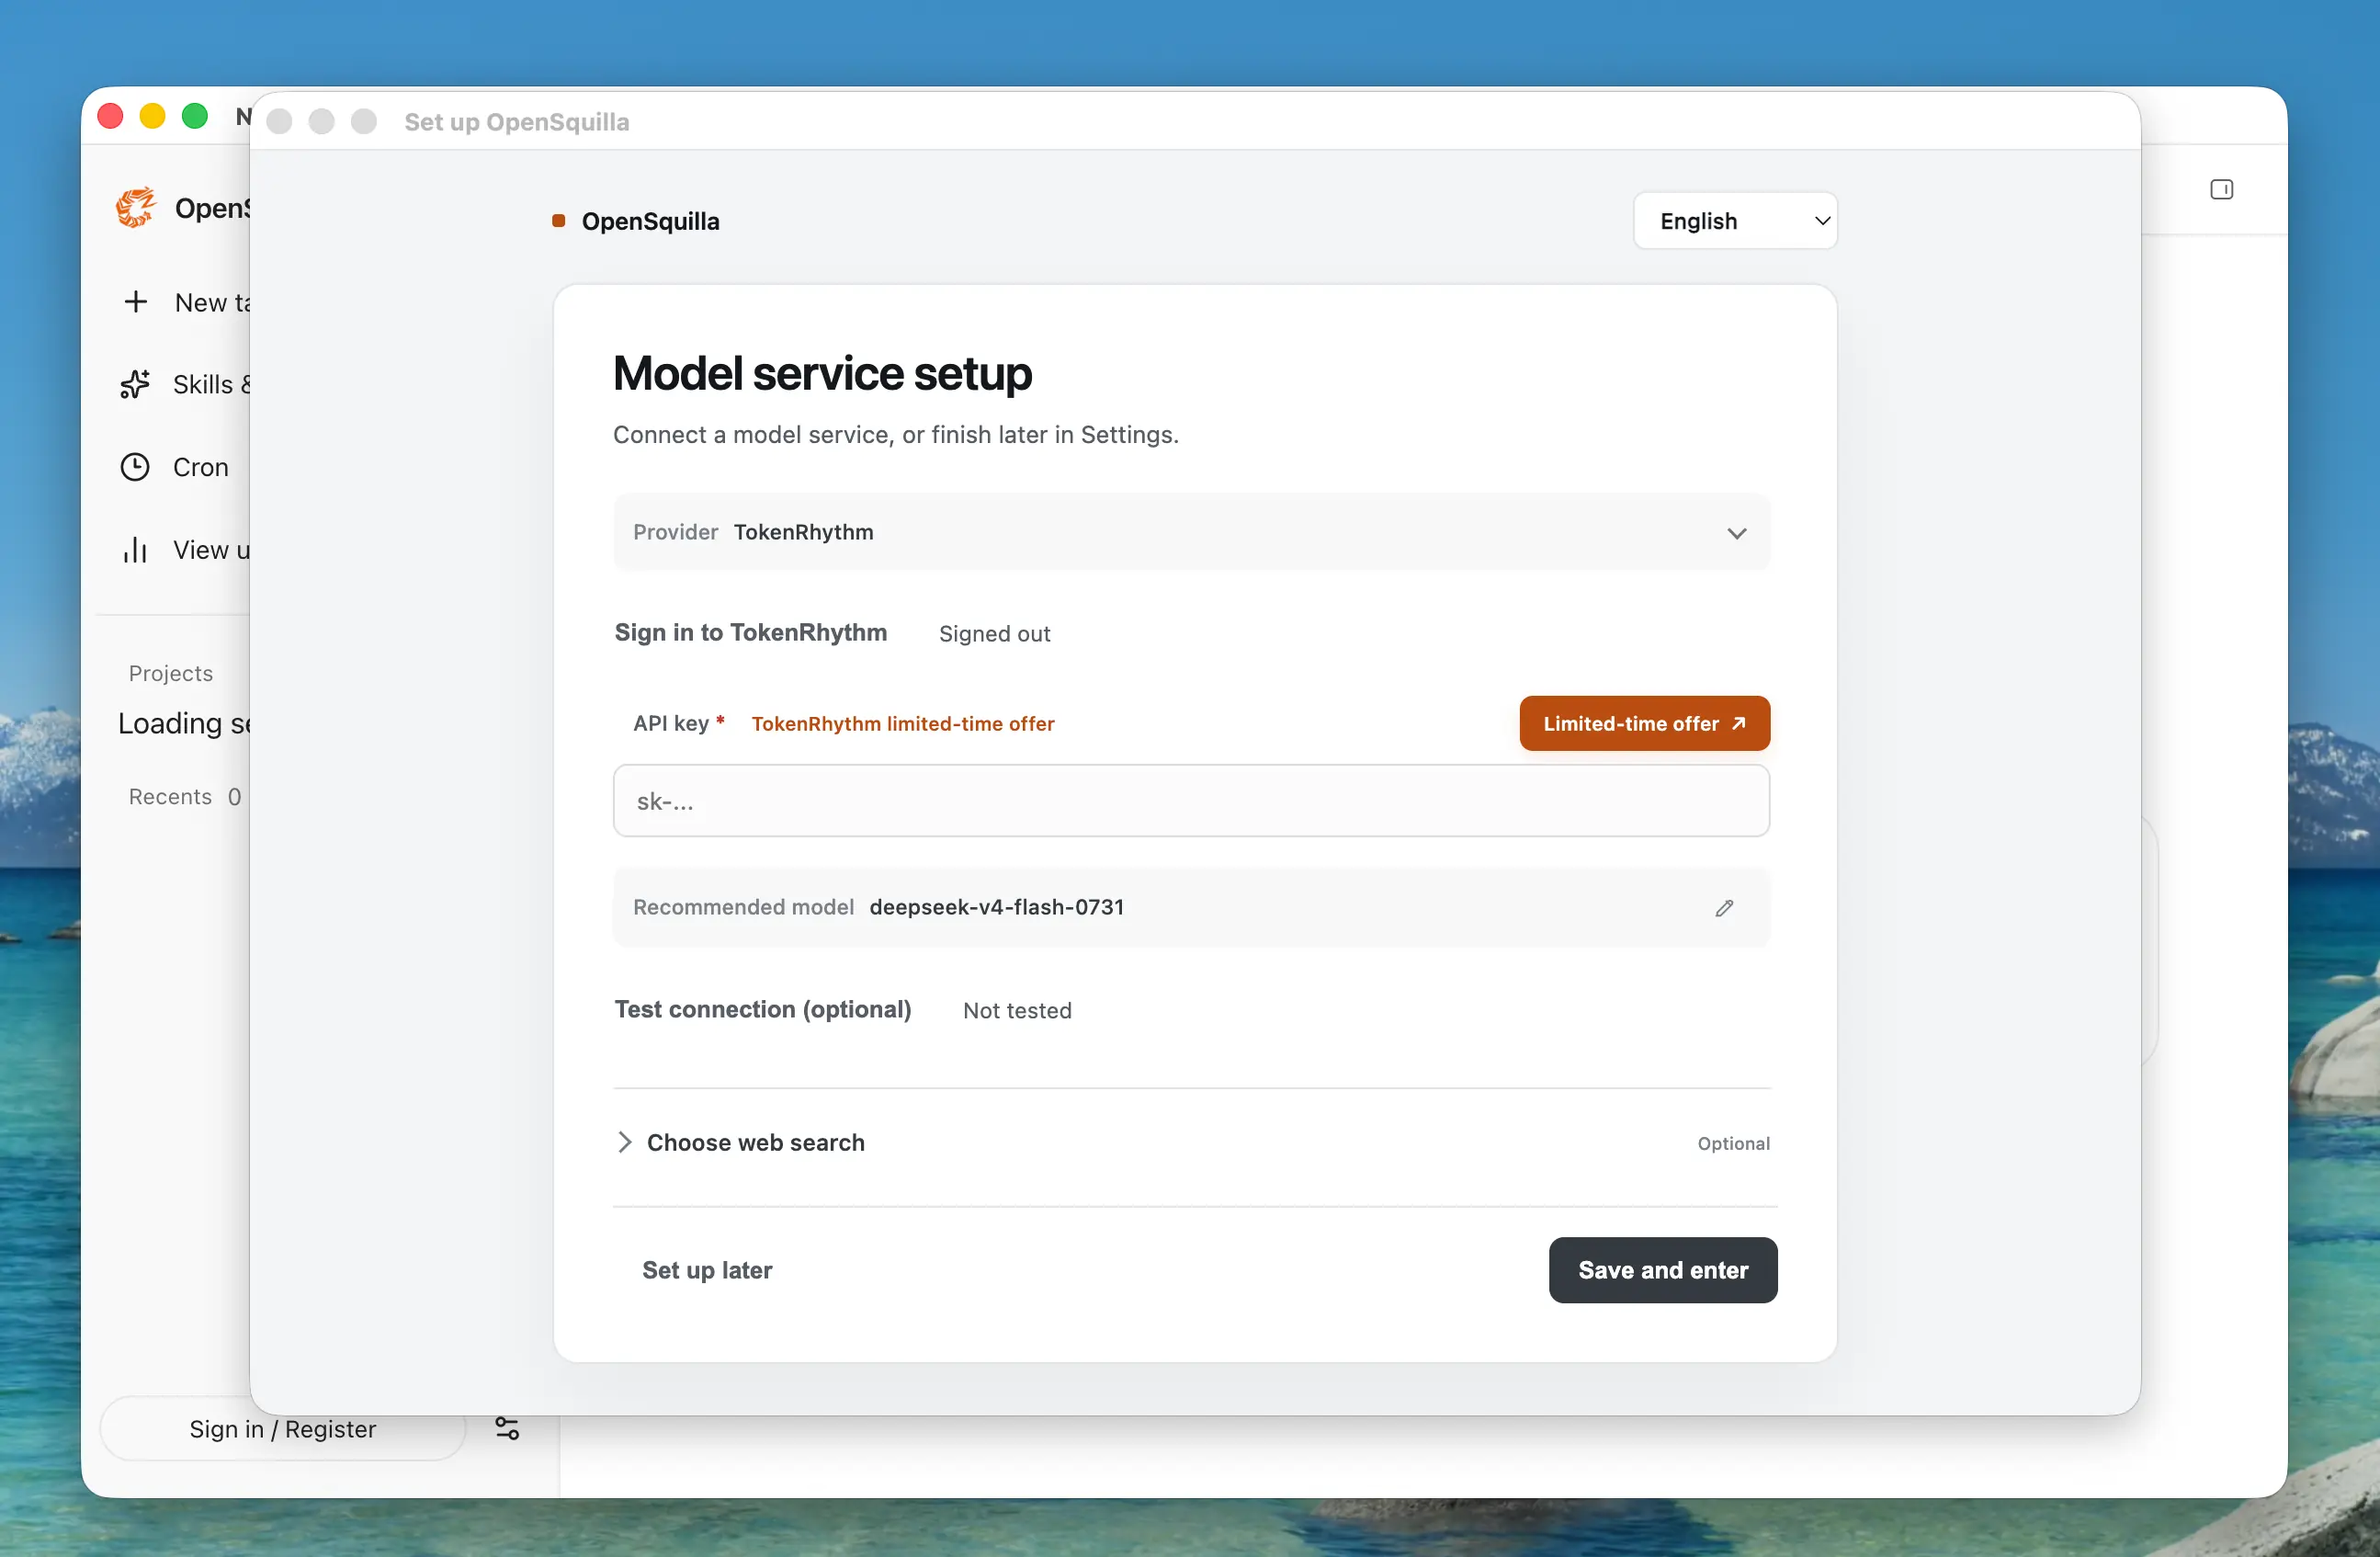
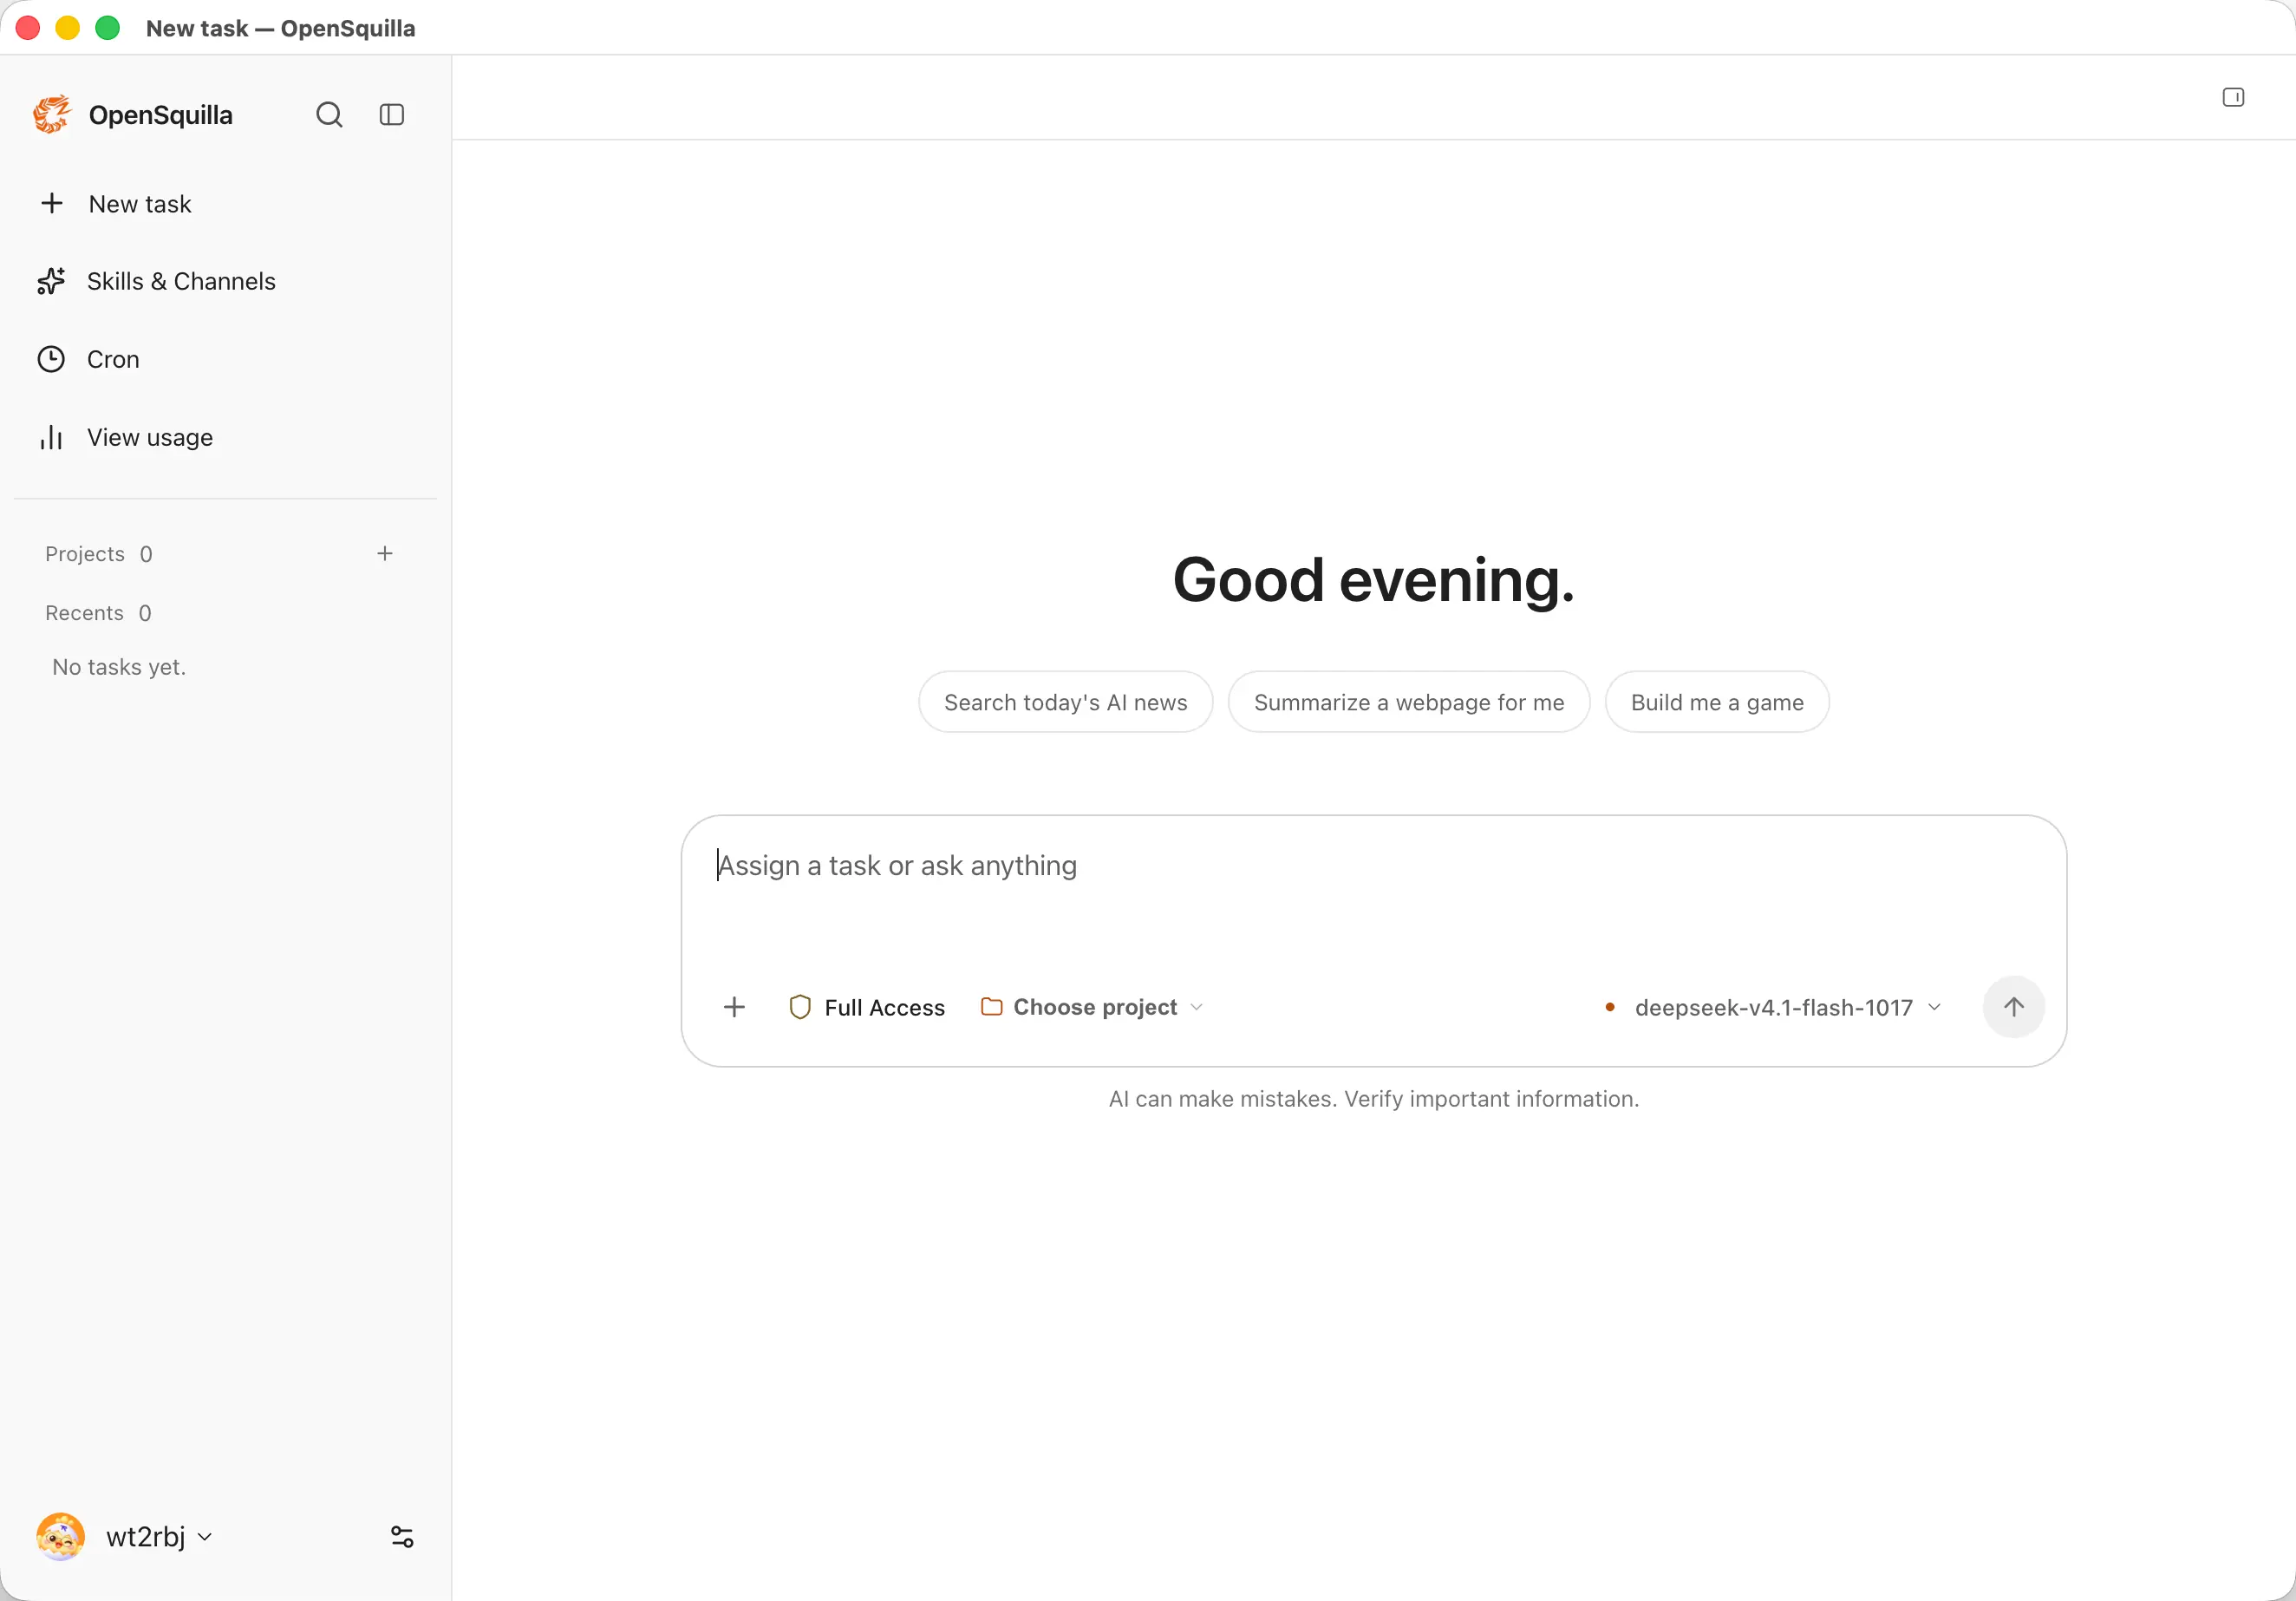
登录完成后的界面是这样的,左侧是 Task、Skills & Channels、定时任务和用量信息。
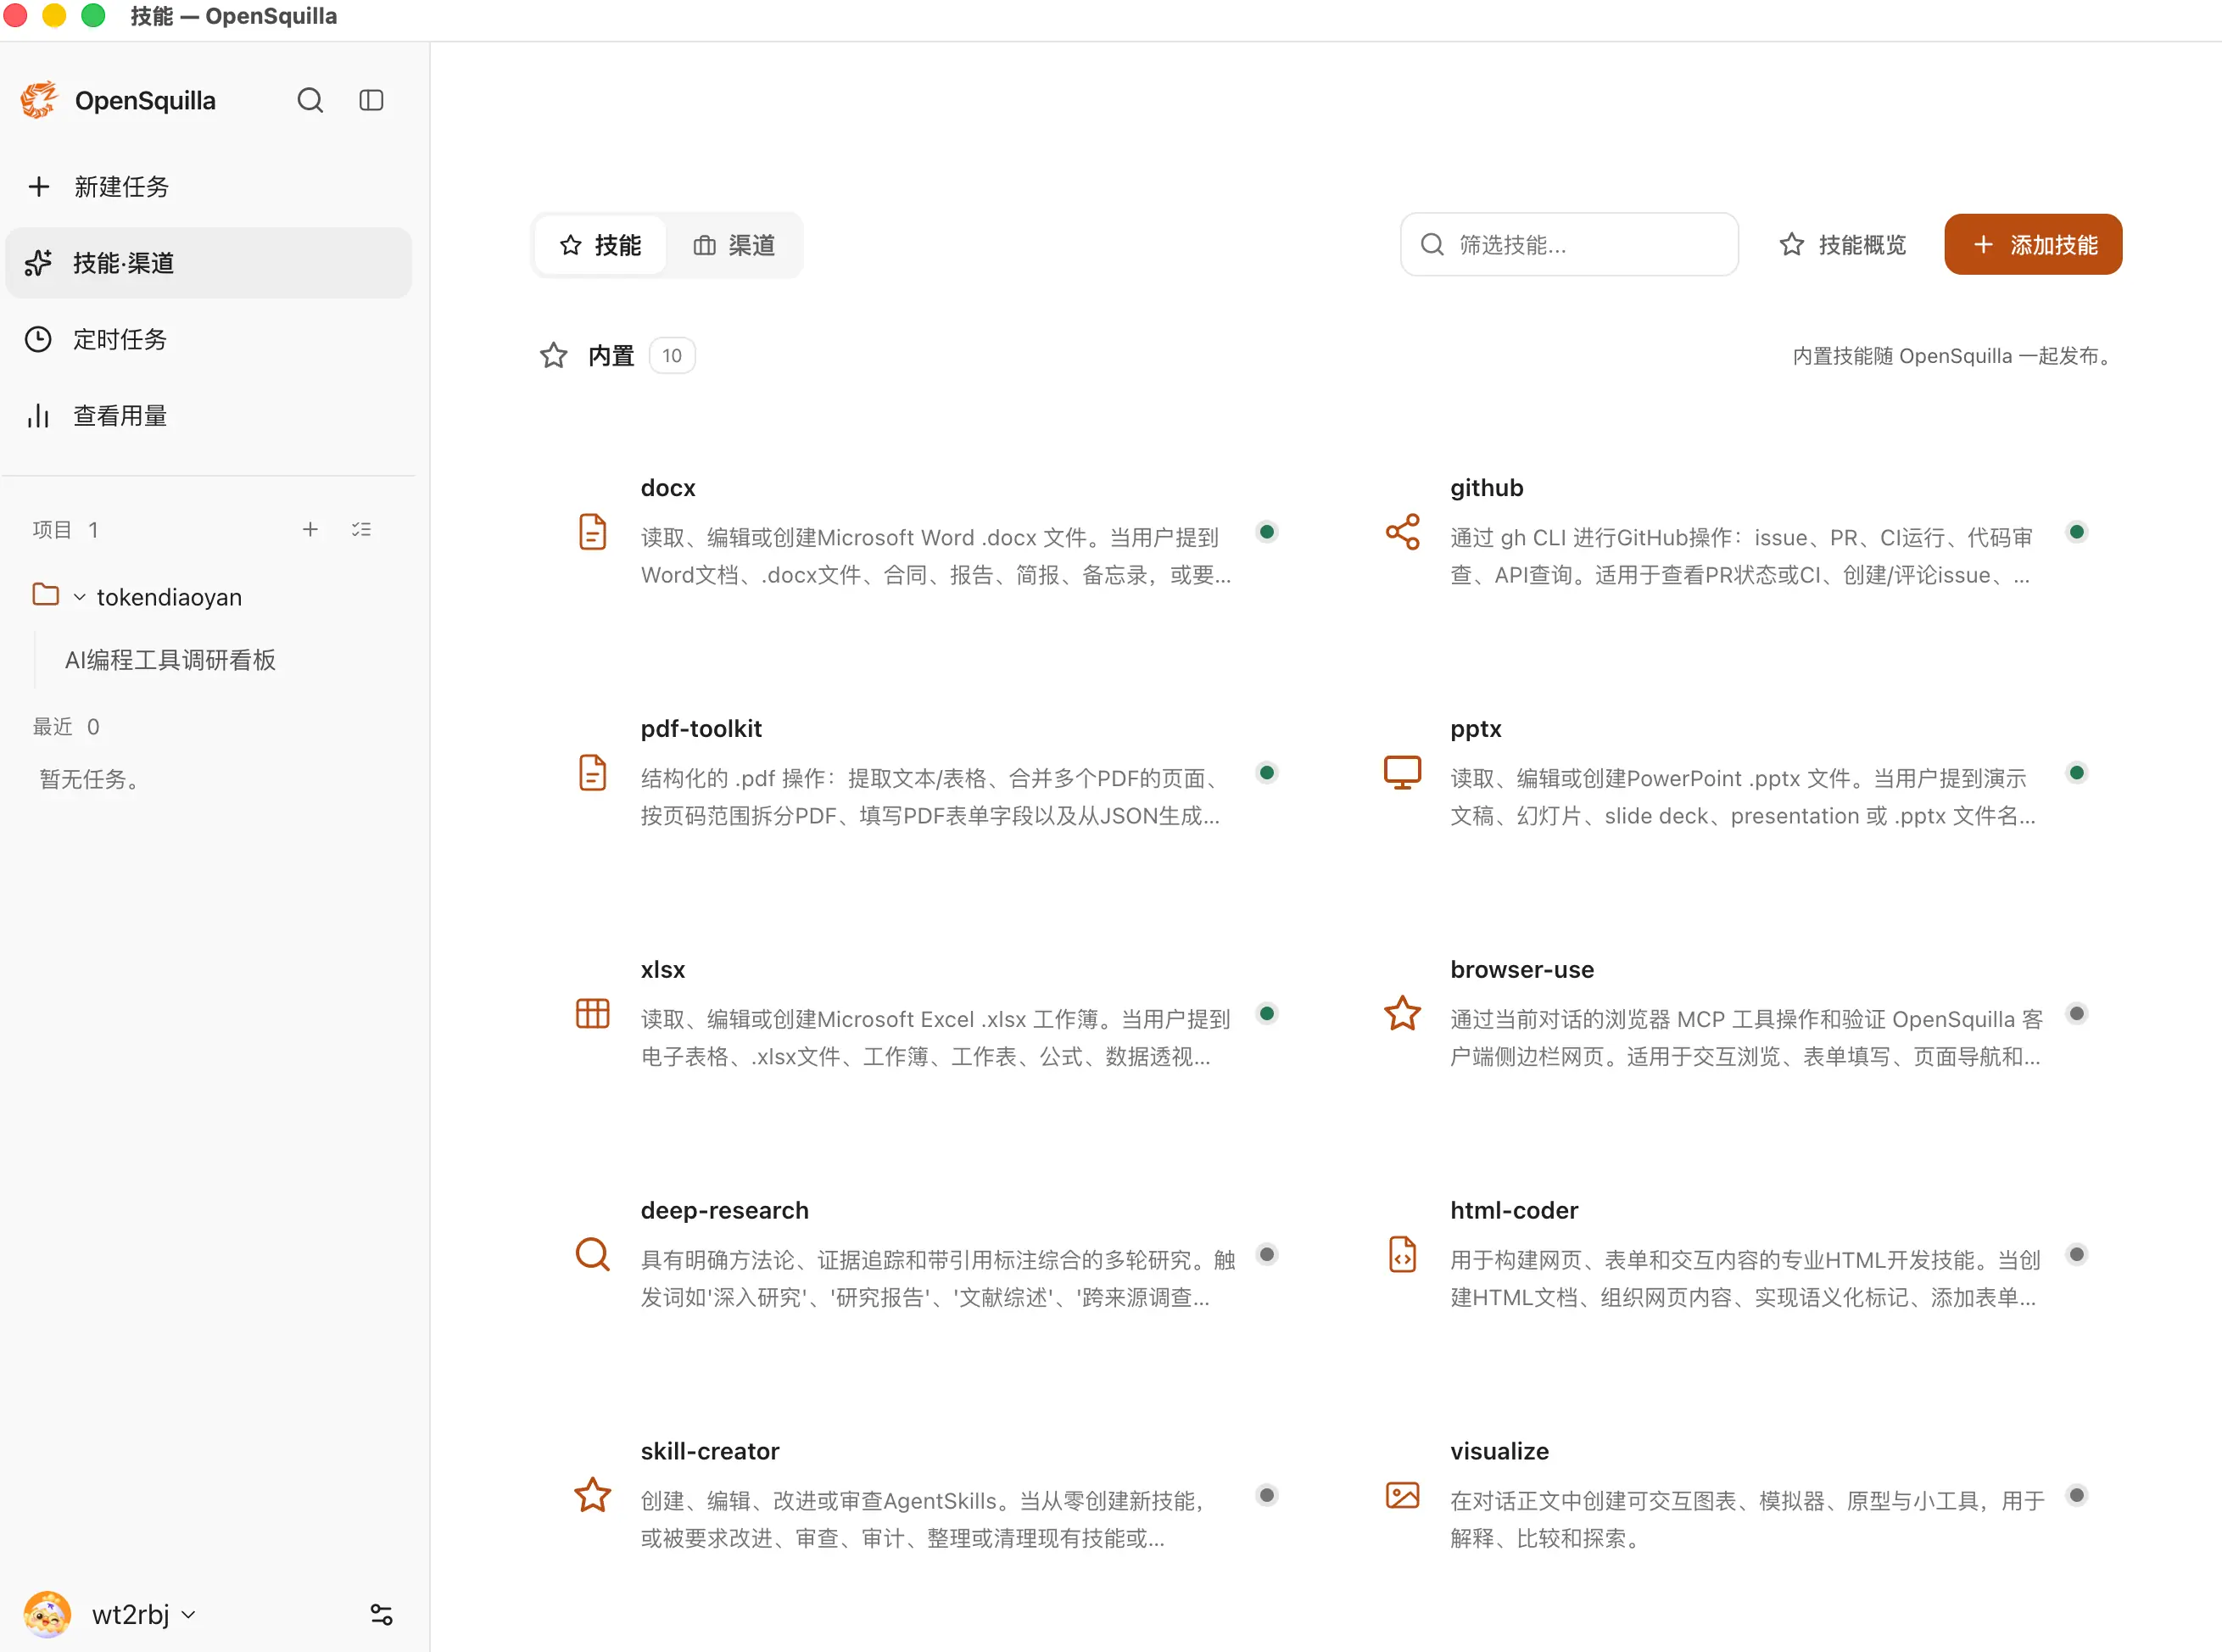
在左侧的 Skill & Channel 支持内置和自定义,也可以从市场上安装。
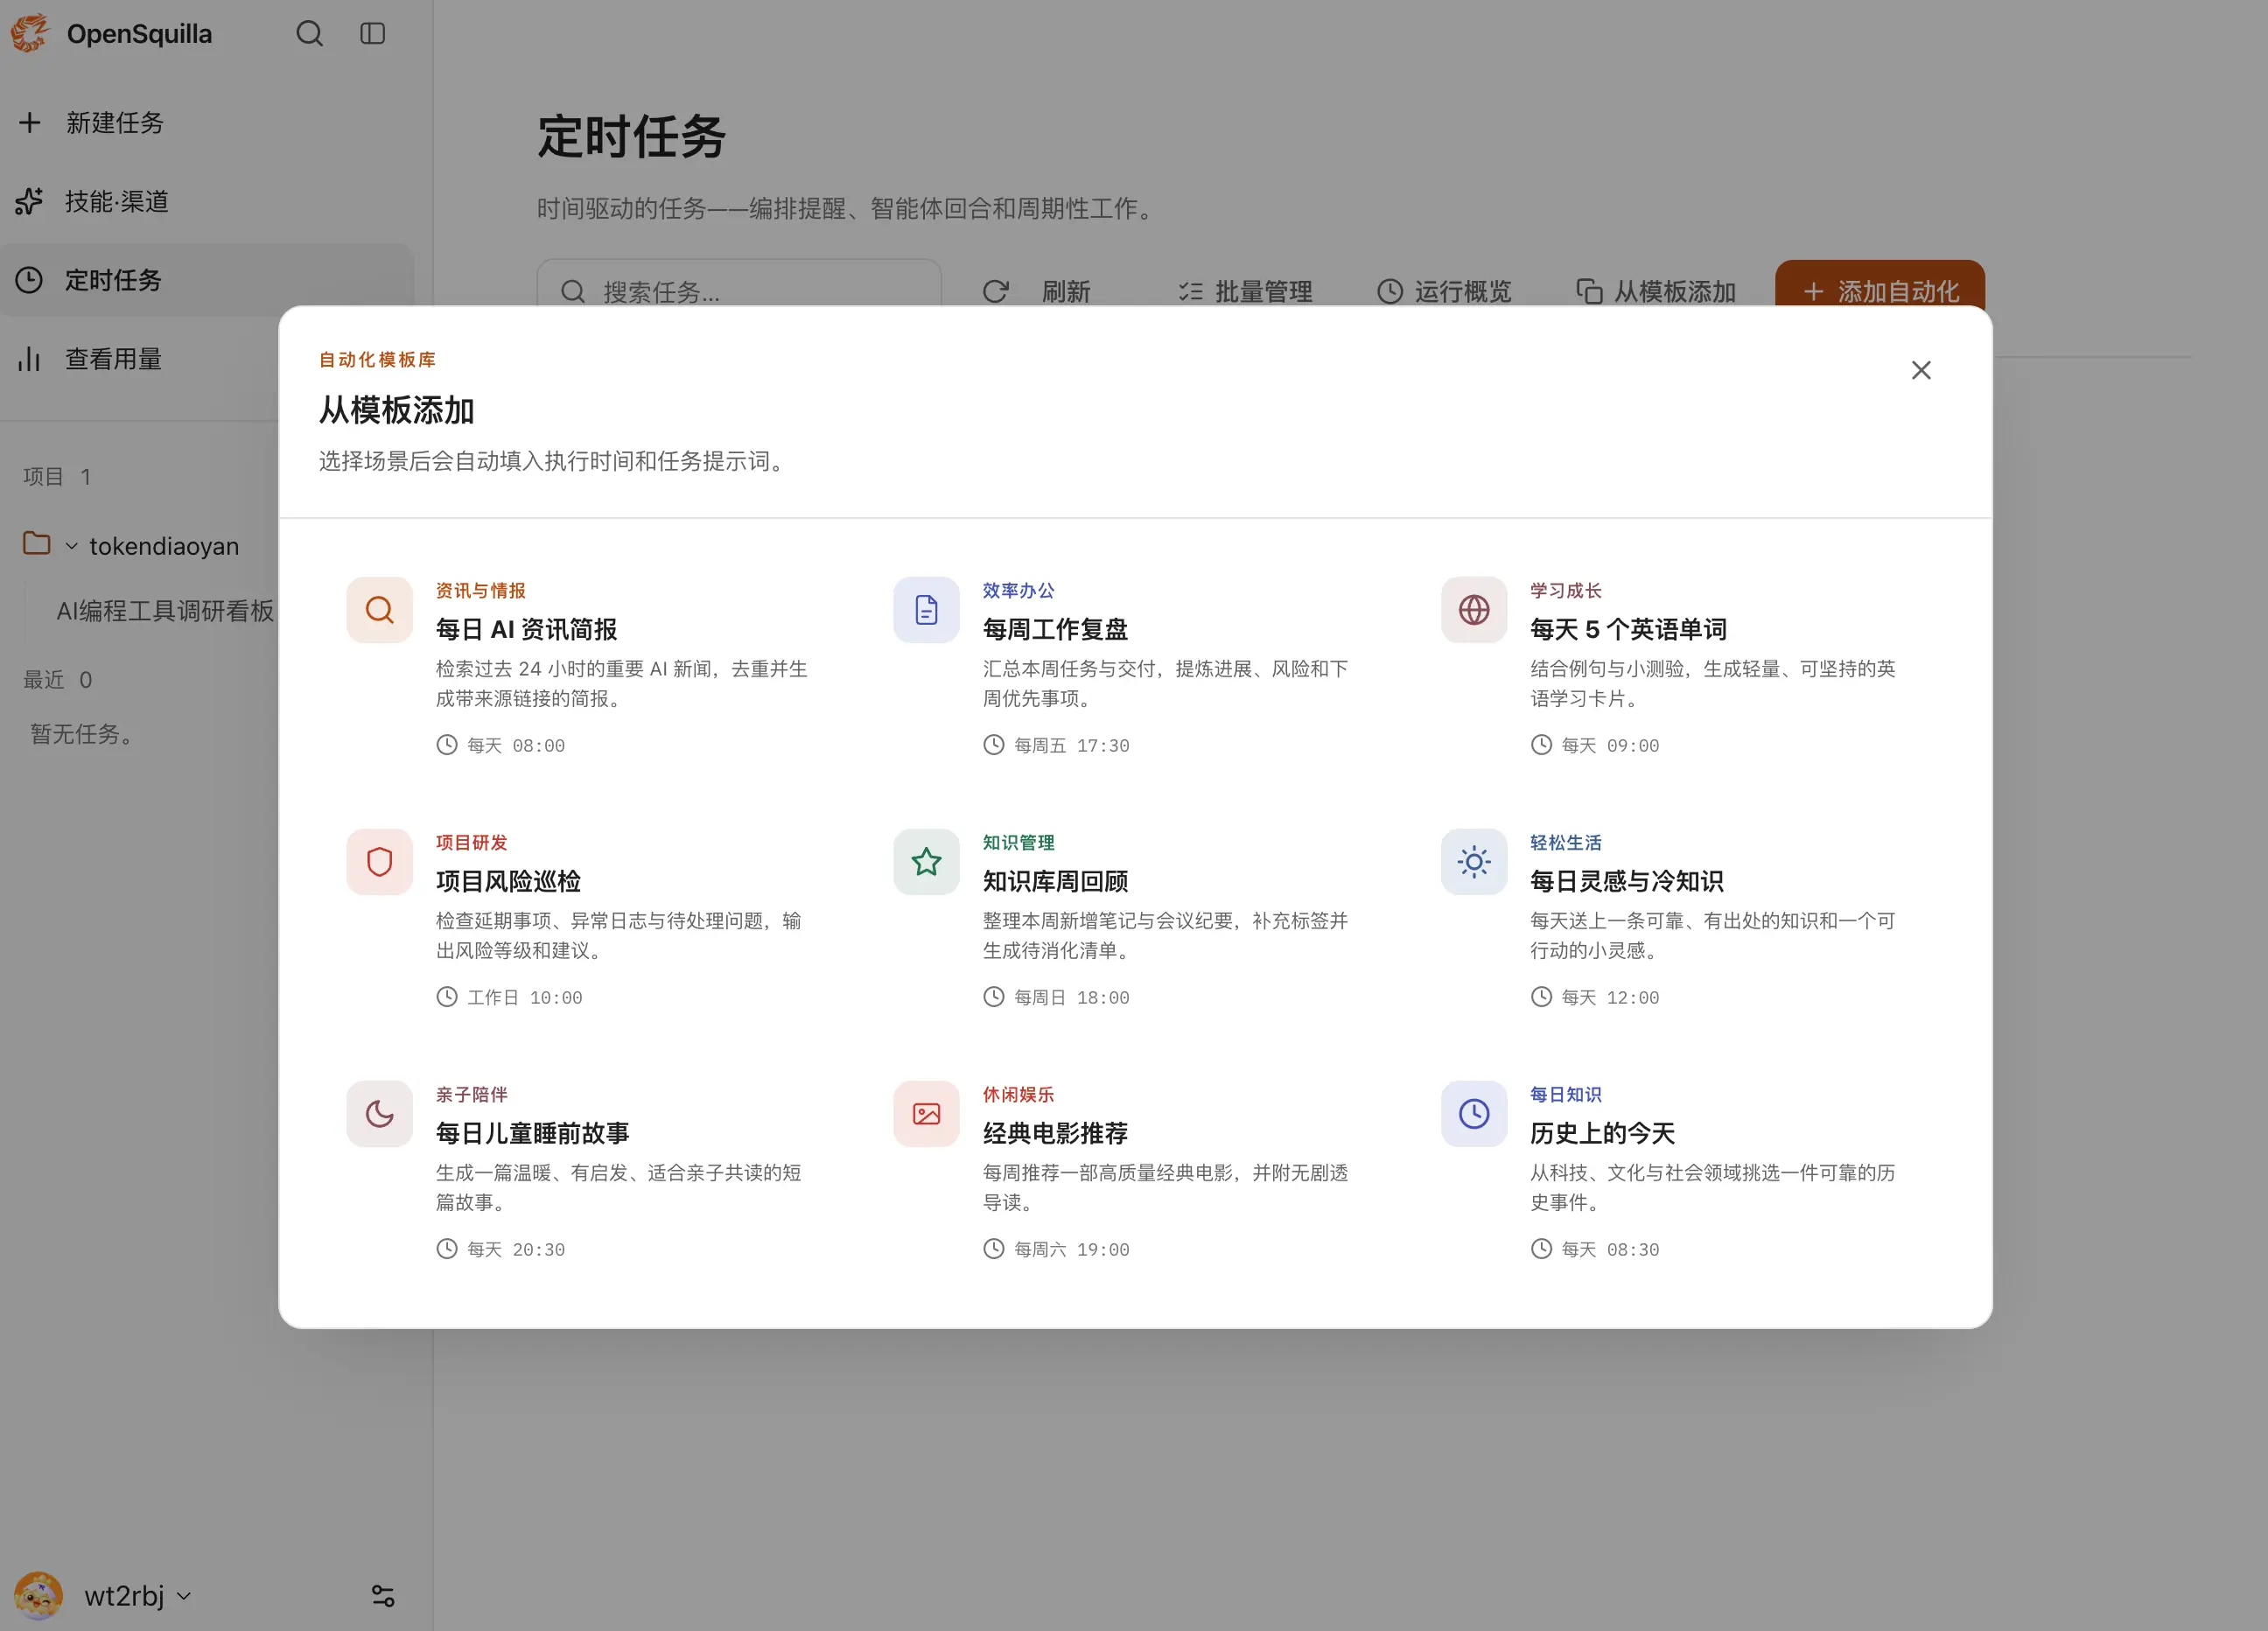
这里的定时任务部分,提供了几个可以直接运行的模板,还是不错的。
这里的模型选择地方需要注意下。
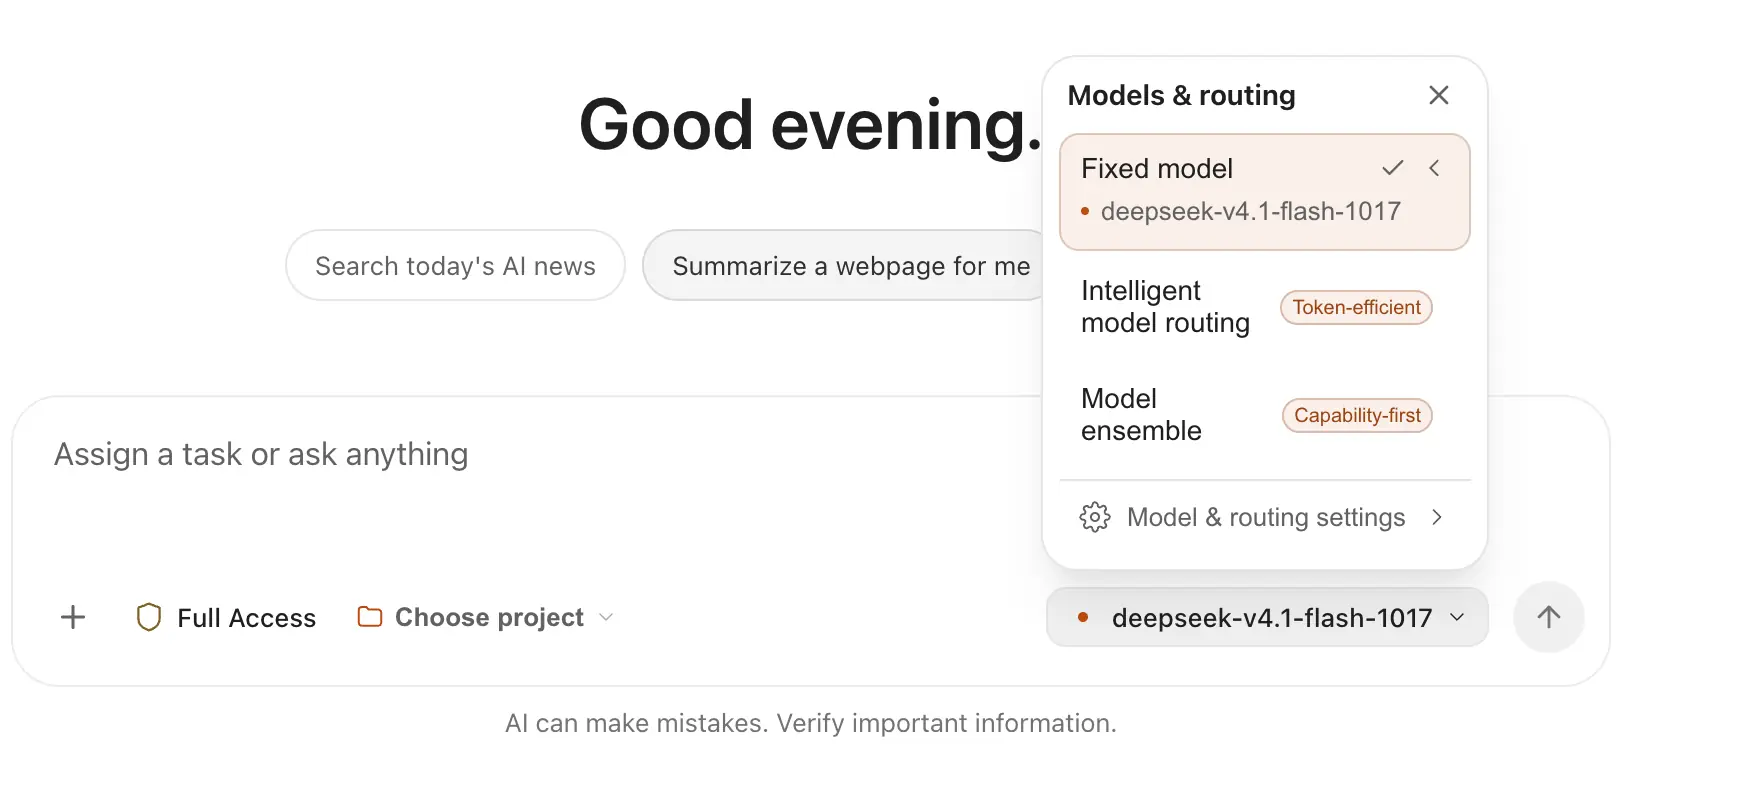
目前有三种模型选择方式,一种是固定模型,这个就是你随意切换。
第二种是智能模型路由,这个是根据实际需求路由到性价比高的模型,达到恰好把活干完的程度。
第三种是多模型融合,这个是多个候选模型并行工作,然后由一个模型做汇总,这种方式会保证干活最优,但是会消耗更多 Token 。
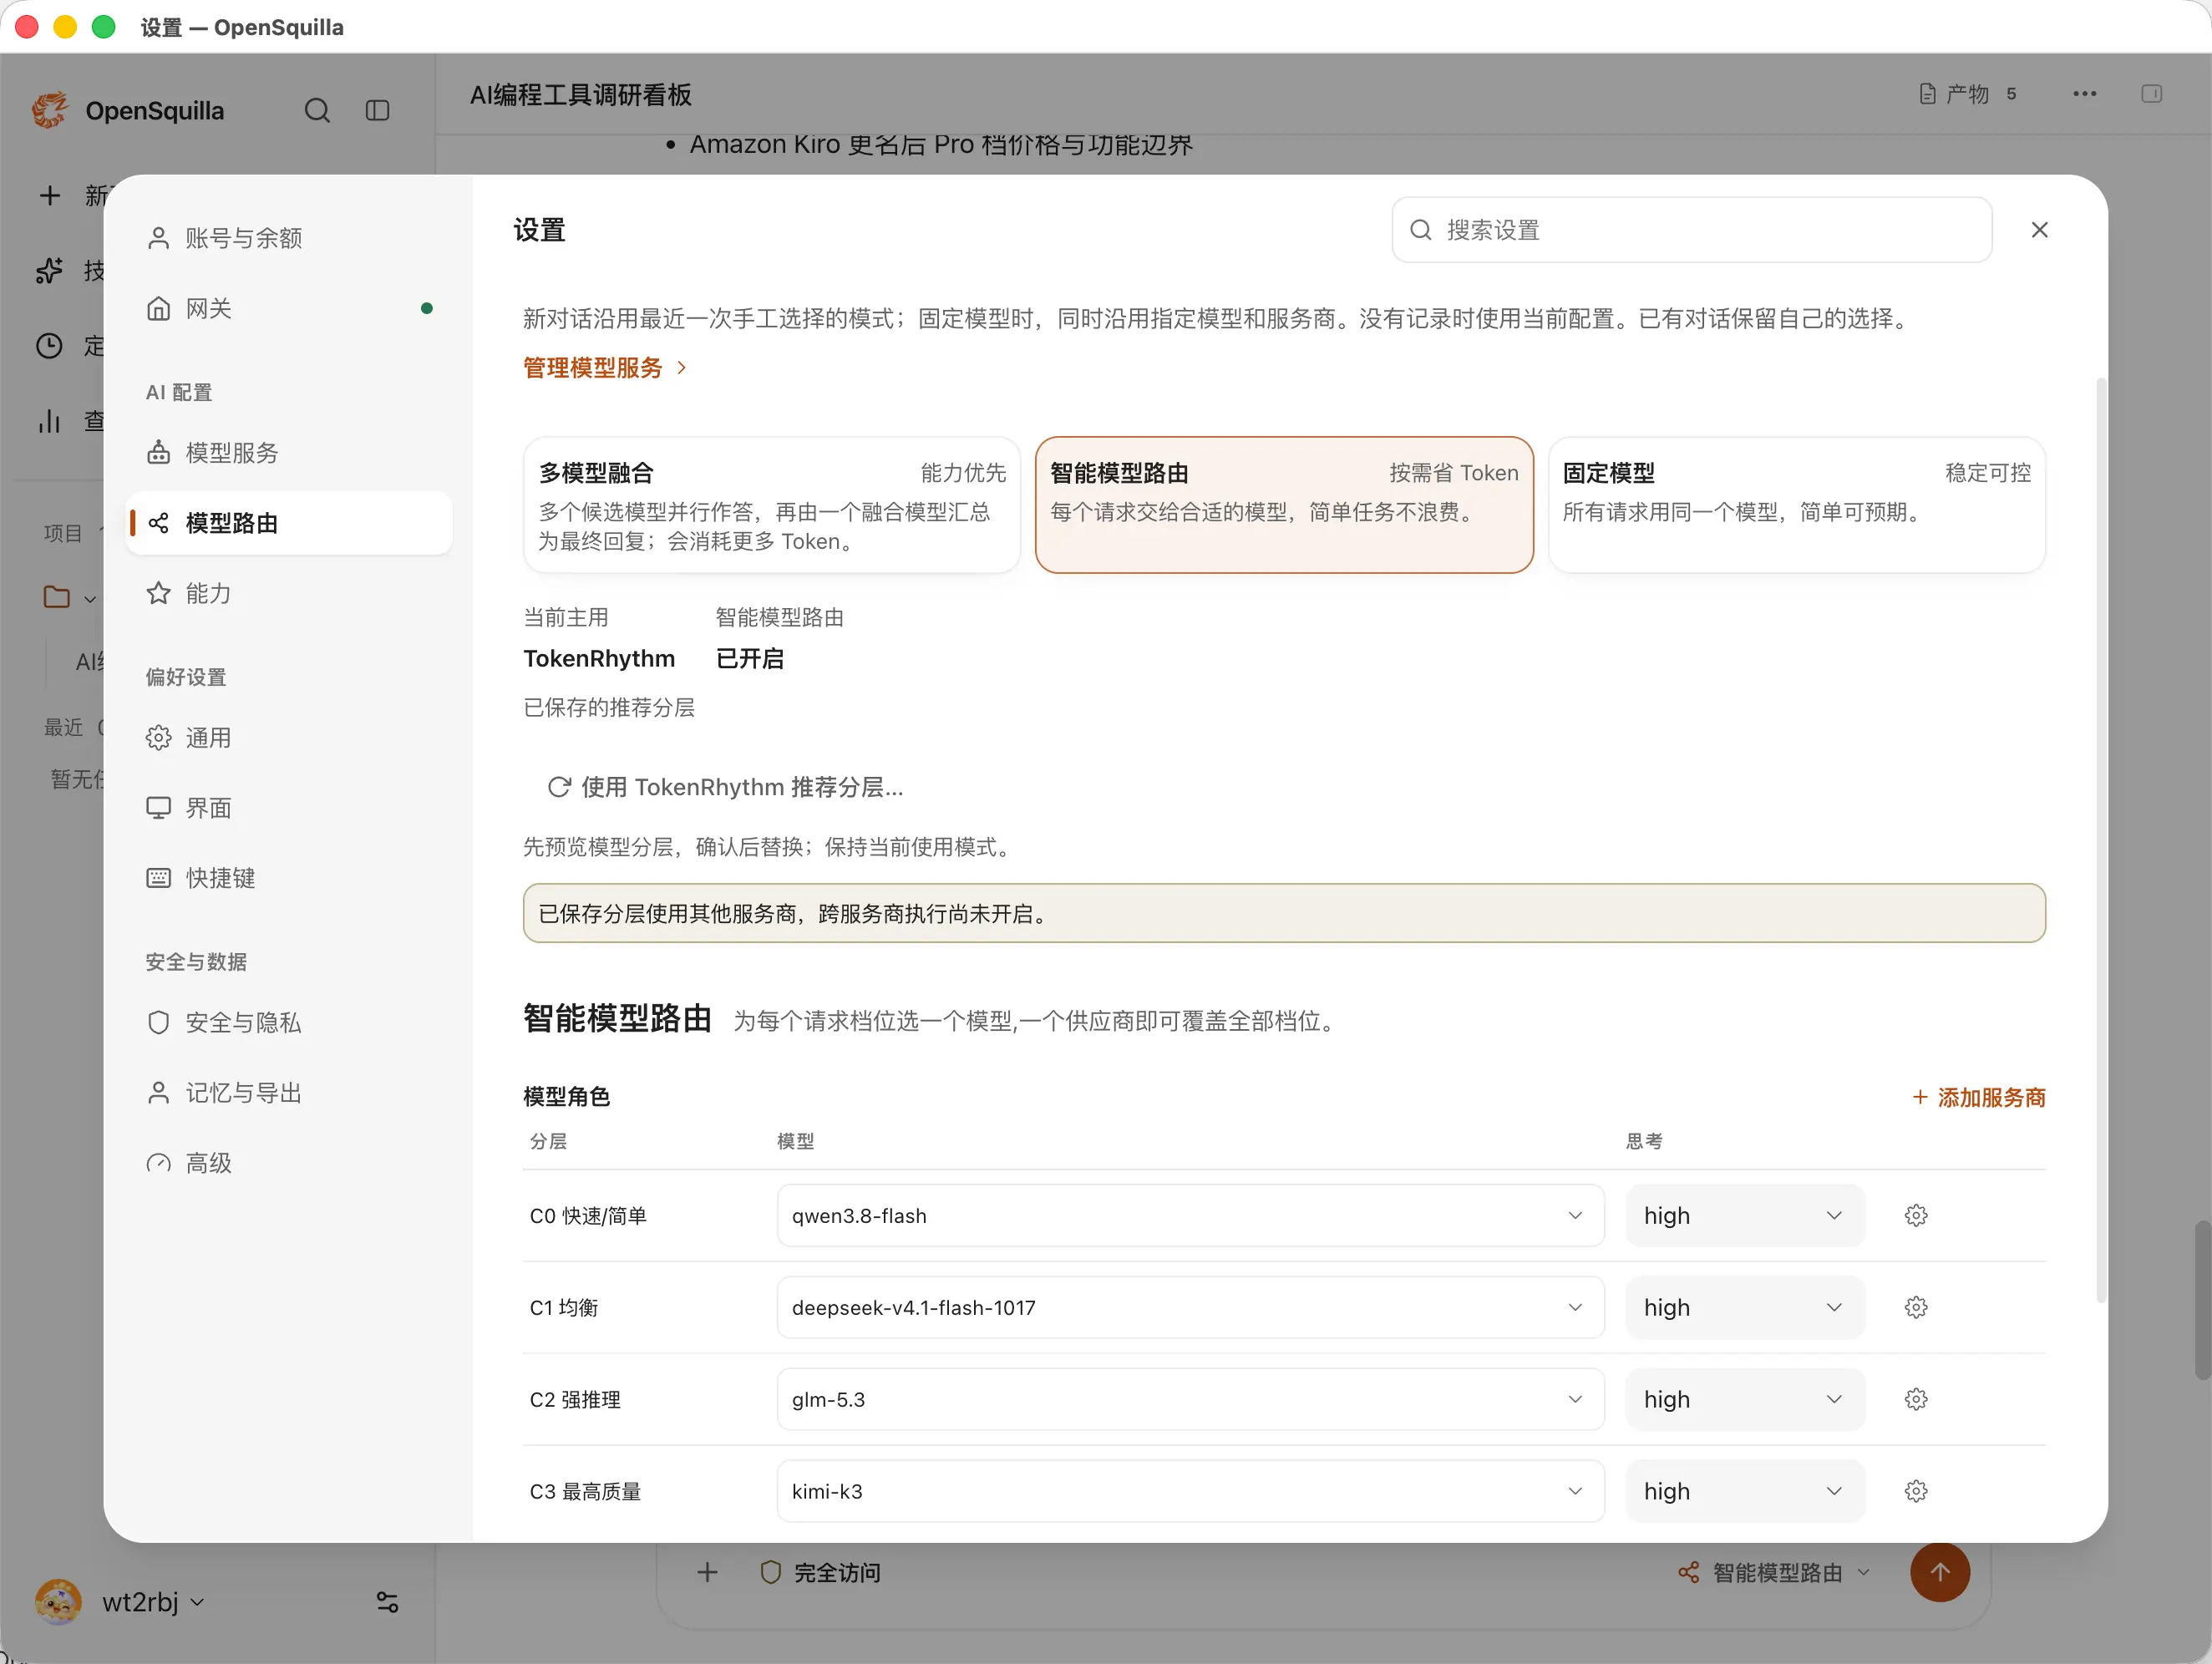
我选了下智能模型路由,来看下实际效果和花费情况。
我布置了一个编程工具费用调研的任务,"全面调研当前国内外所有主流 AI 编程工具,并制作一个中文交互看板,帮助我了解市场、比较产品和安排试用。"
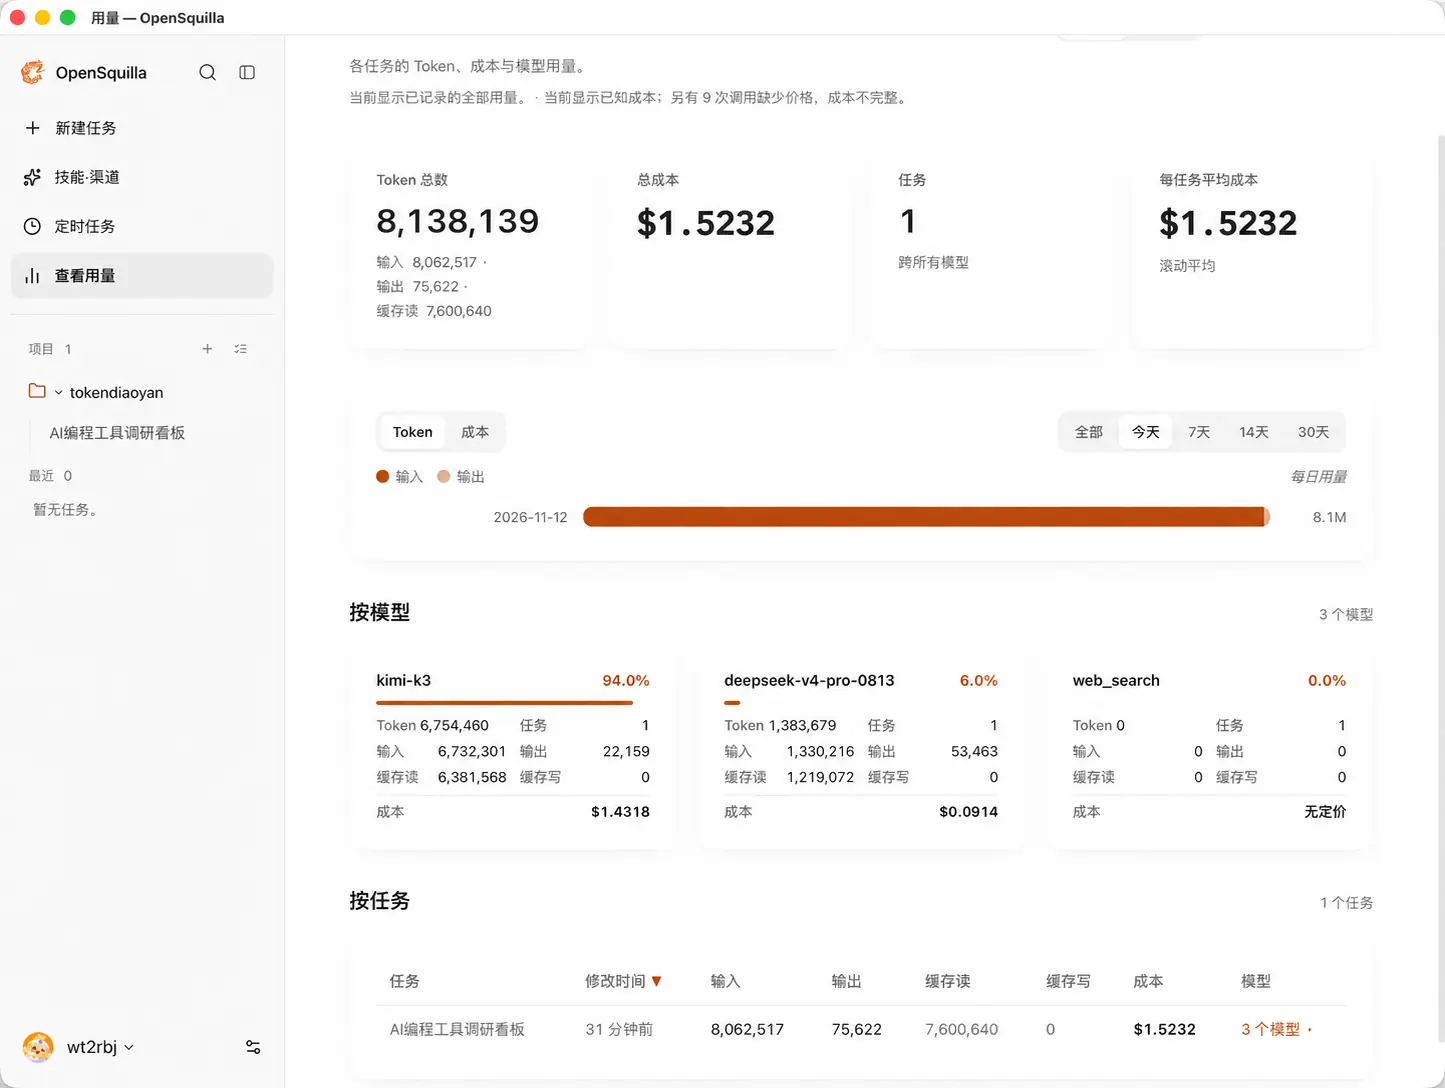
然后智能模型路由给我路由到 Kimi K3 了。
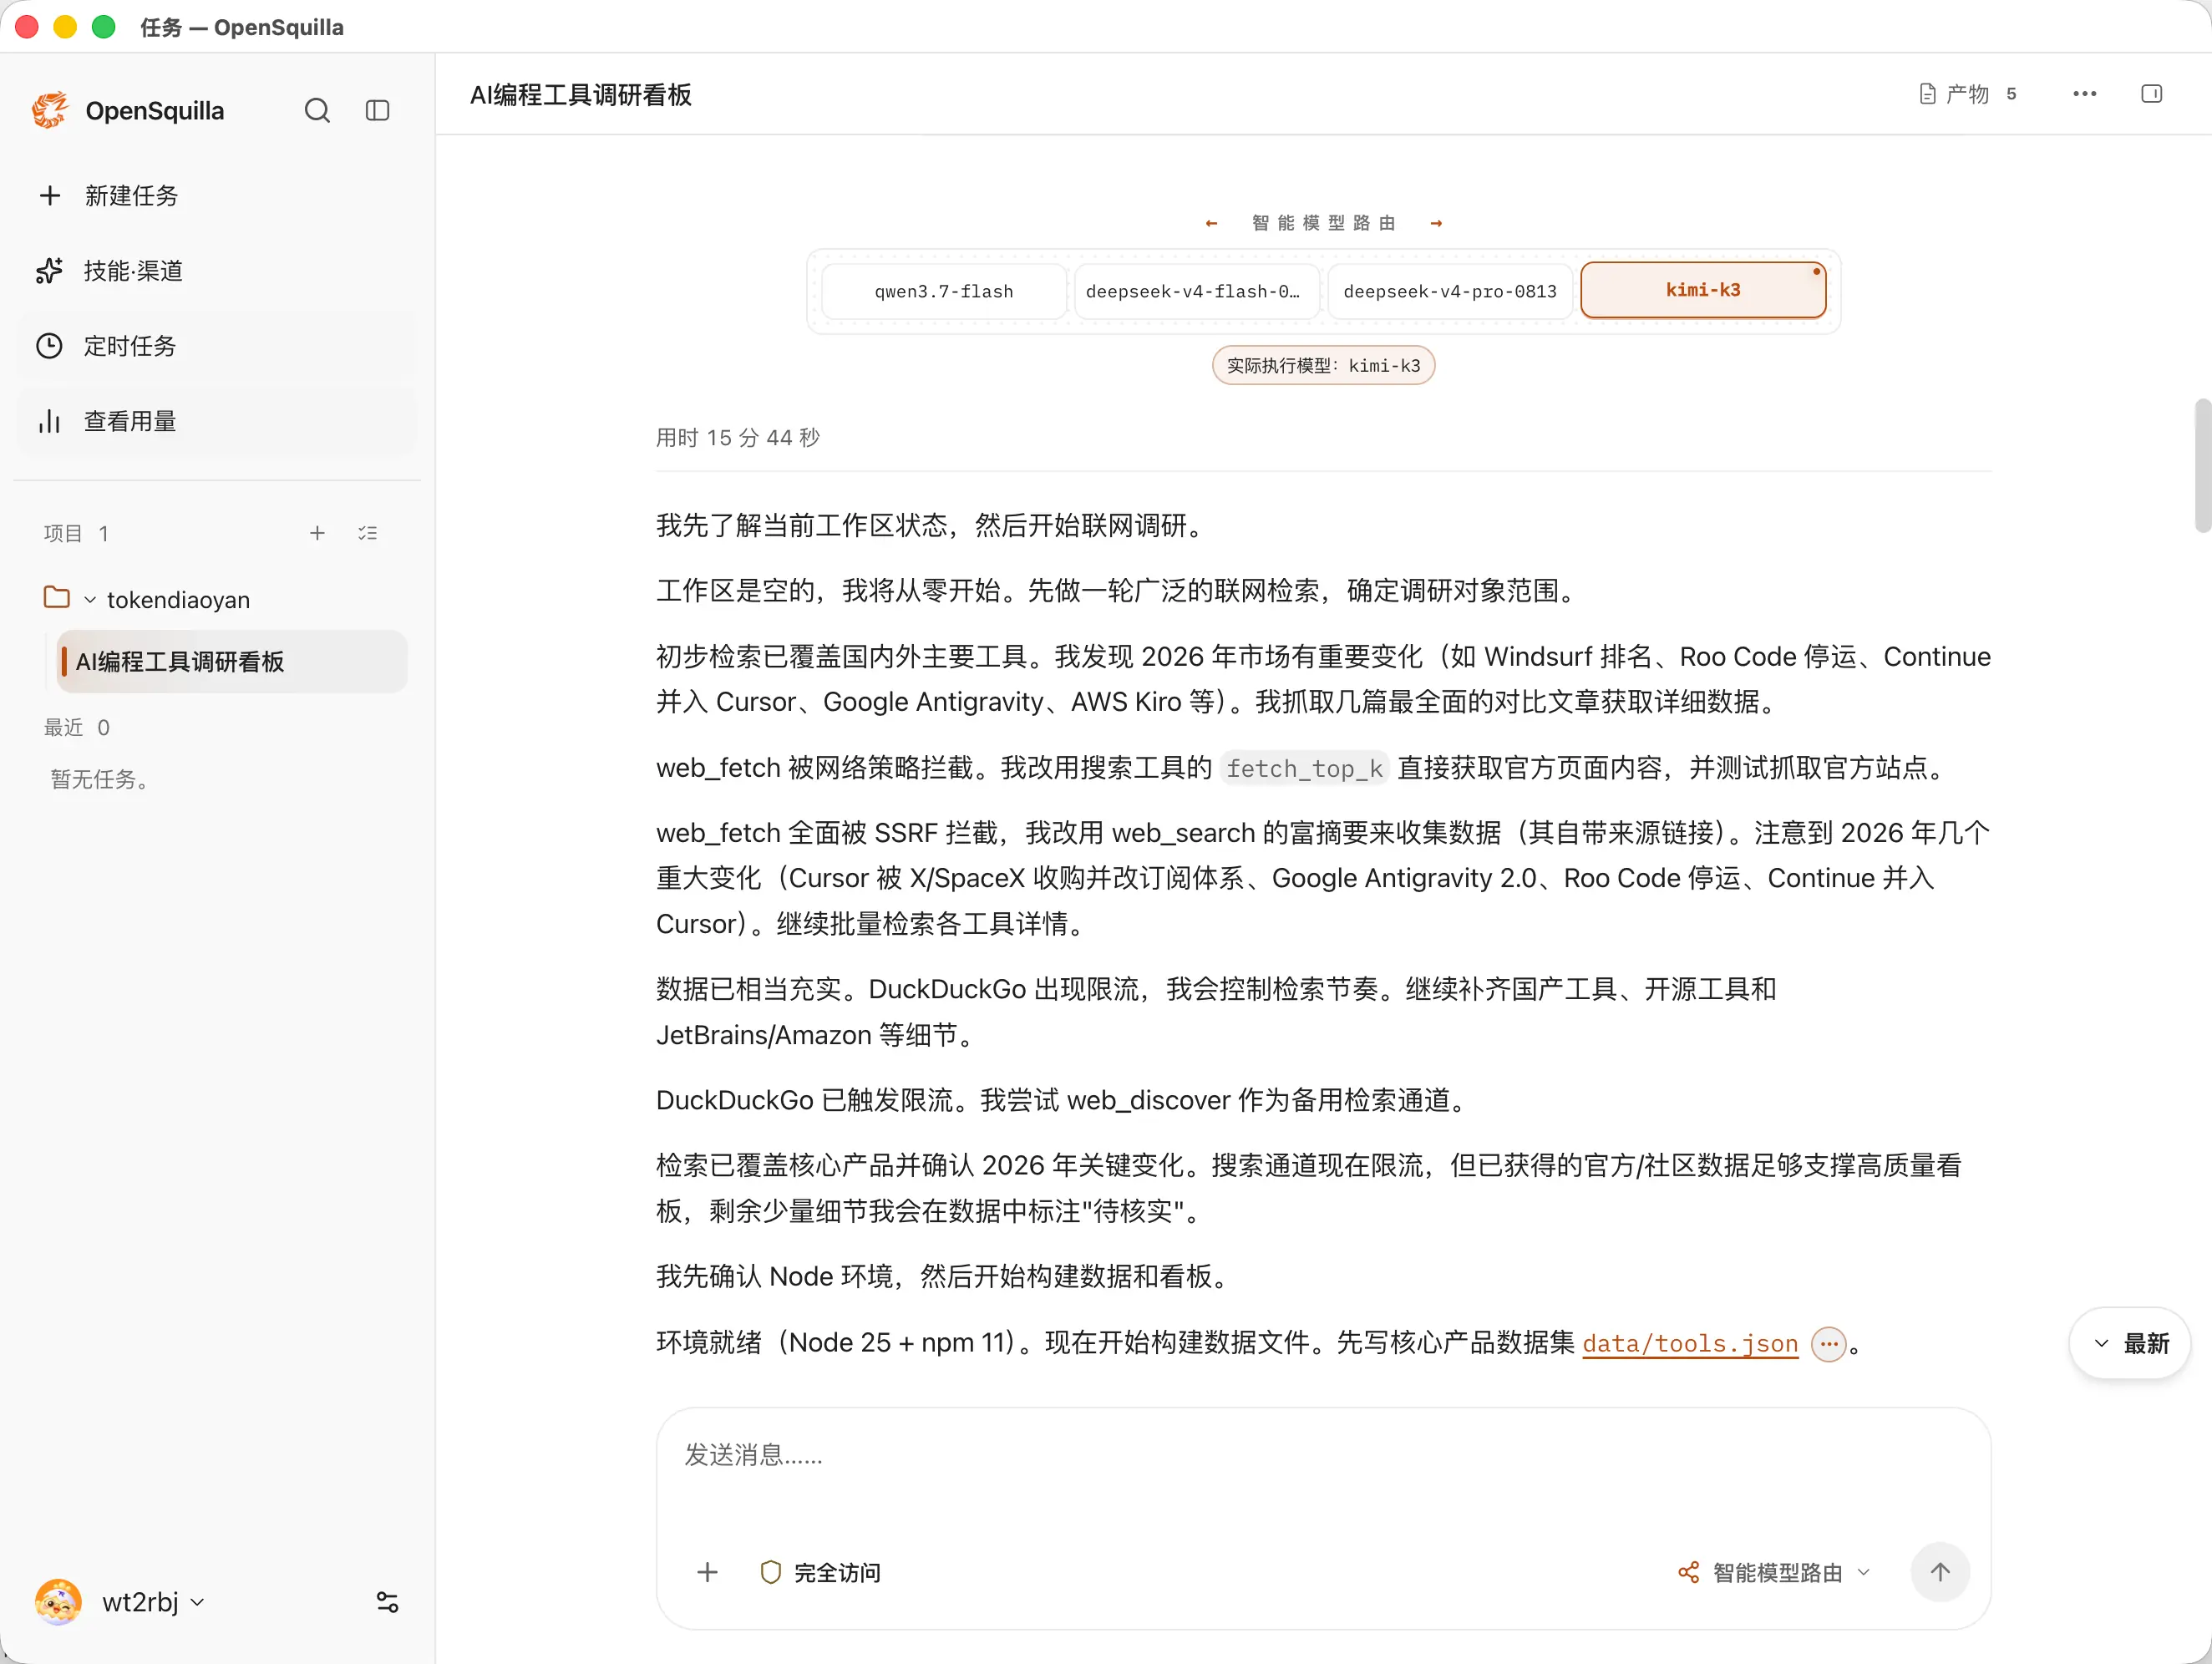
做完之后看一下效果。
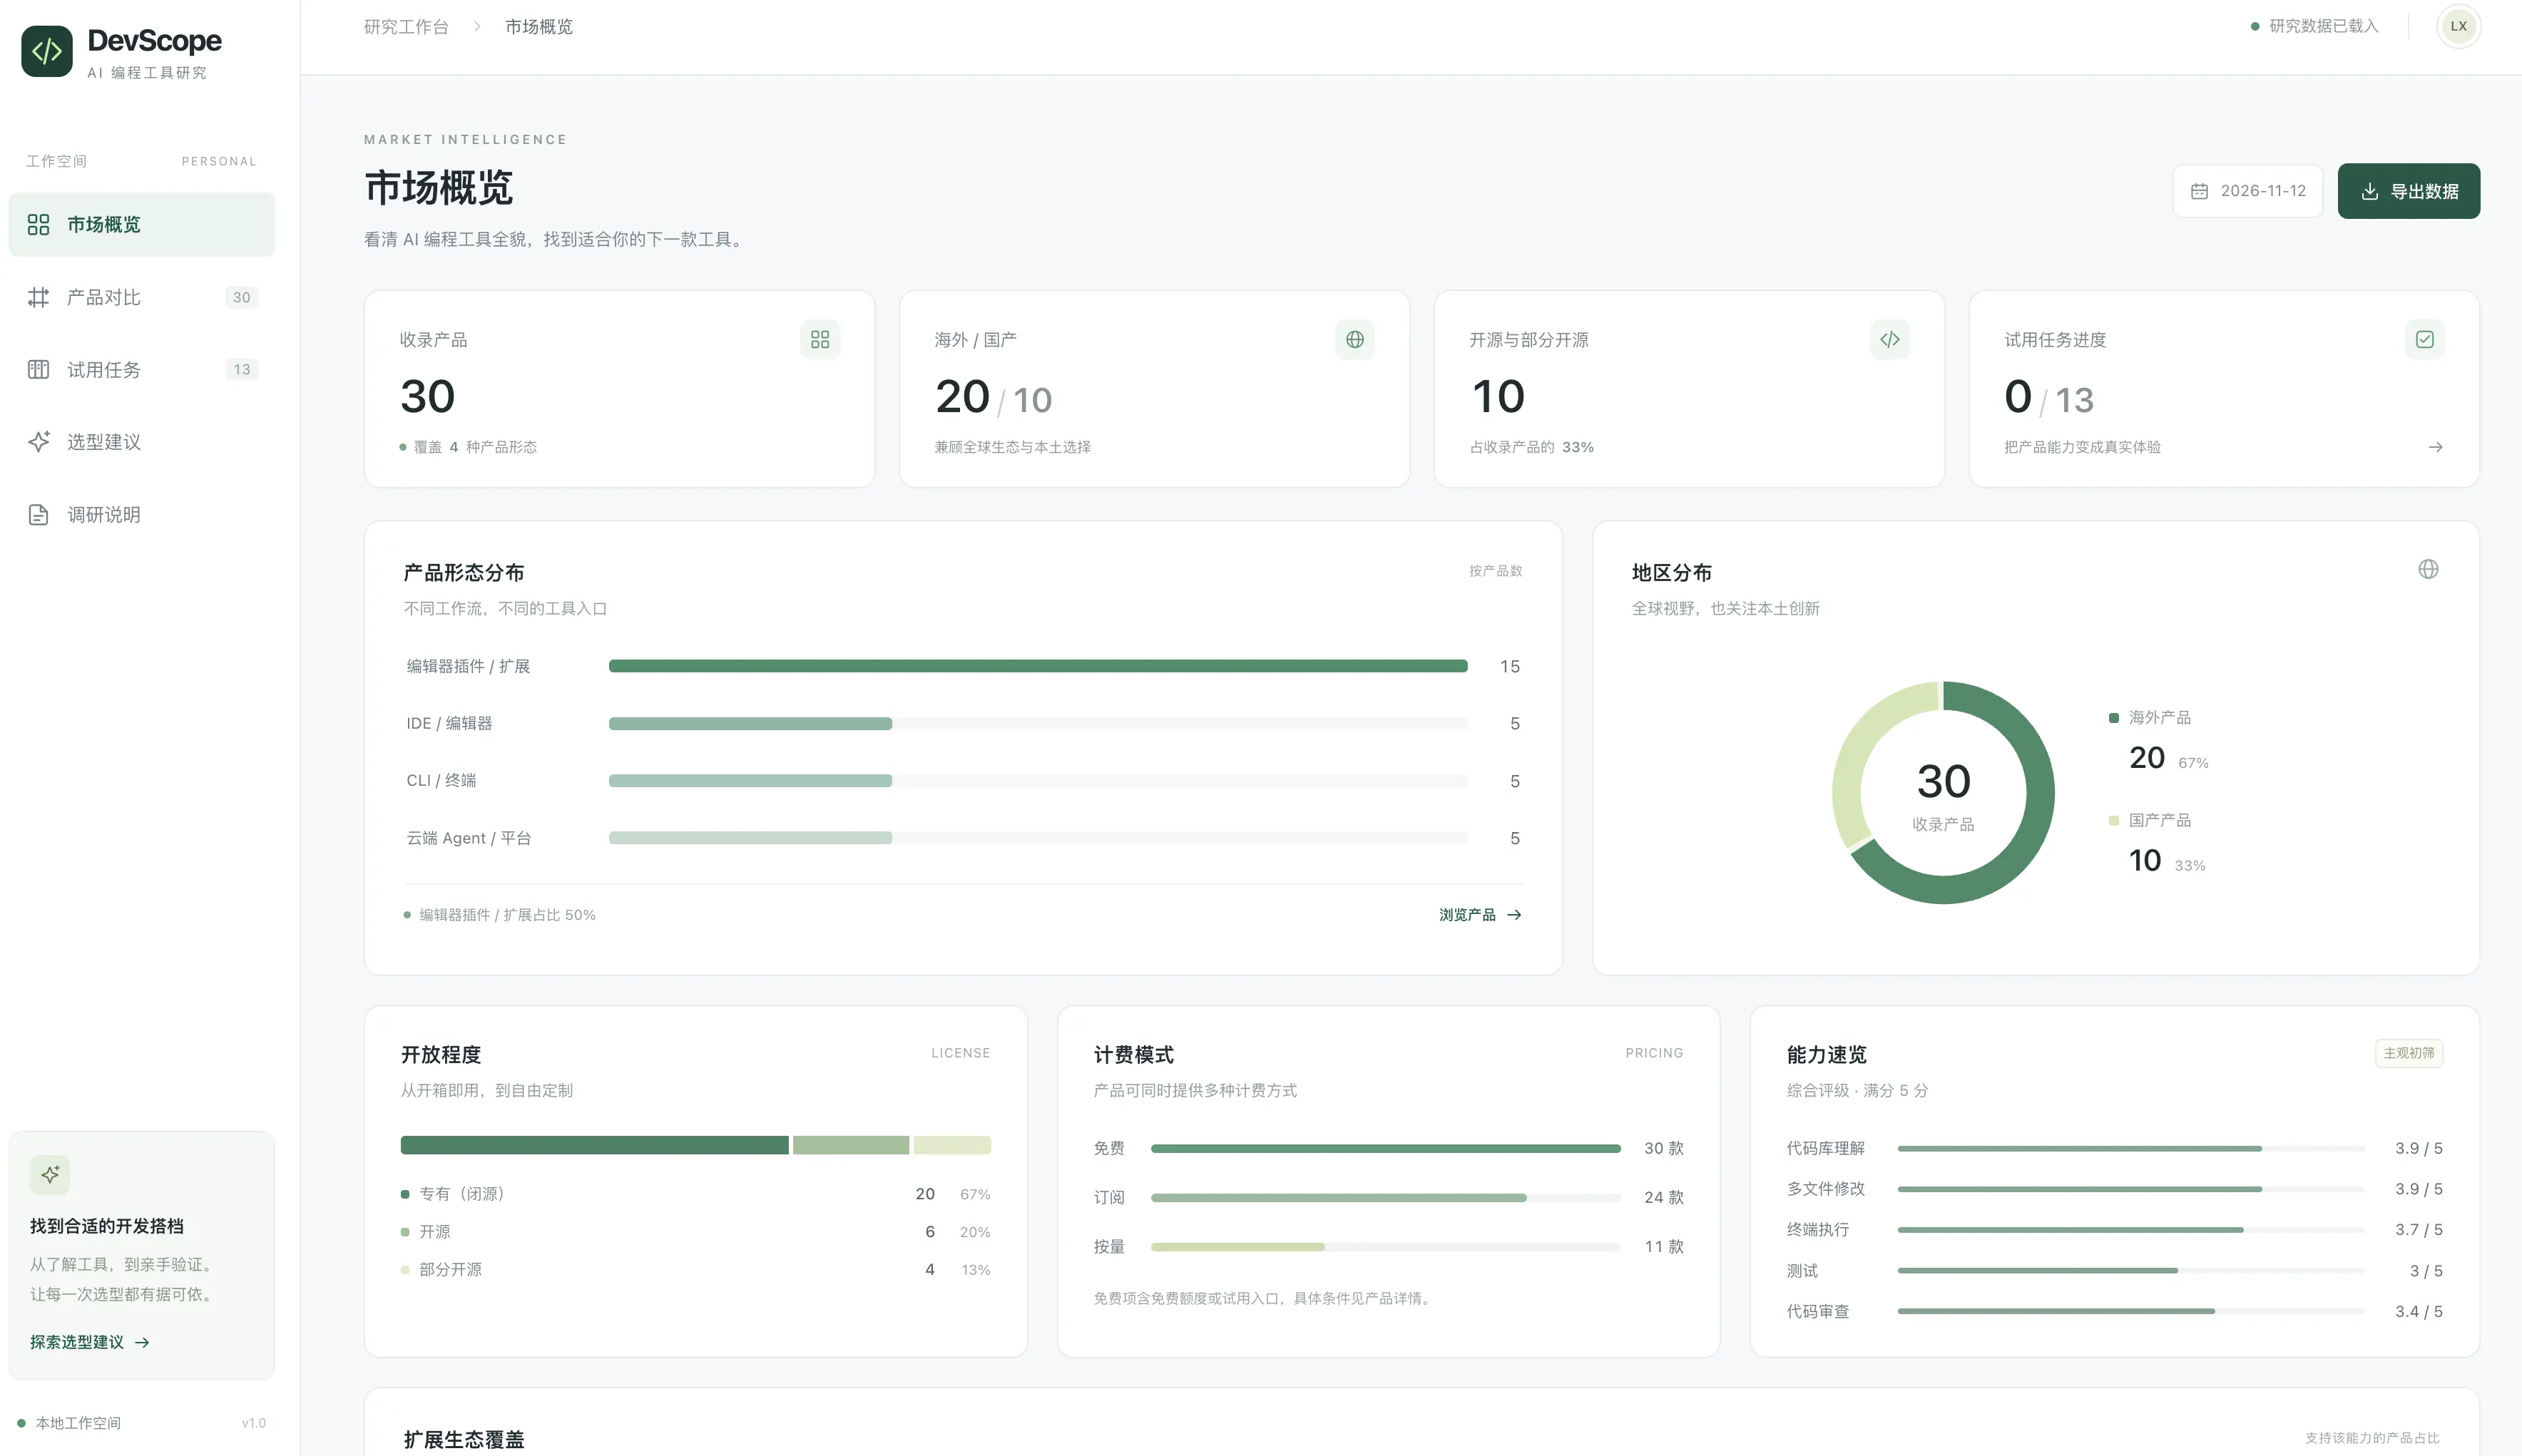
这个任务基本上是把市面上所有主流 AI 编程工具都统计了。
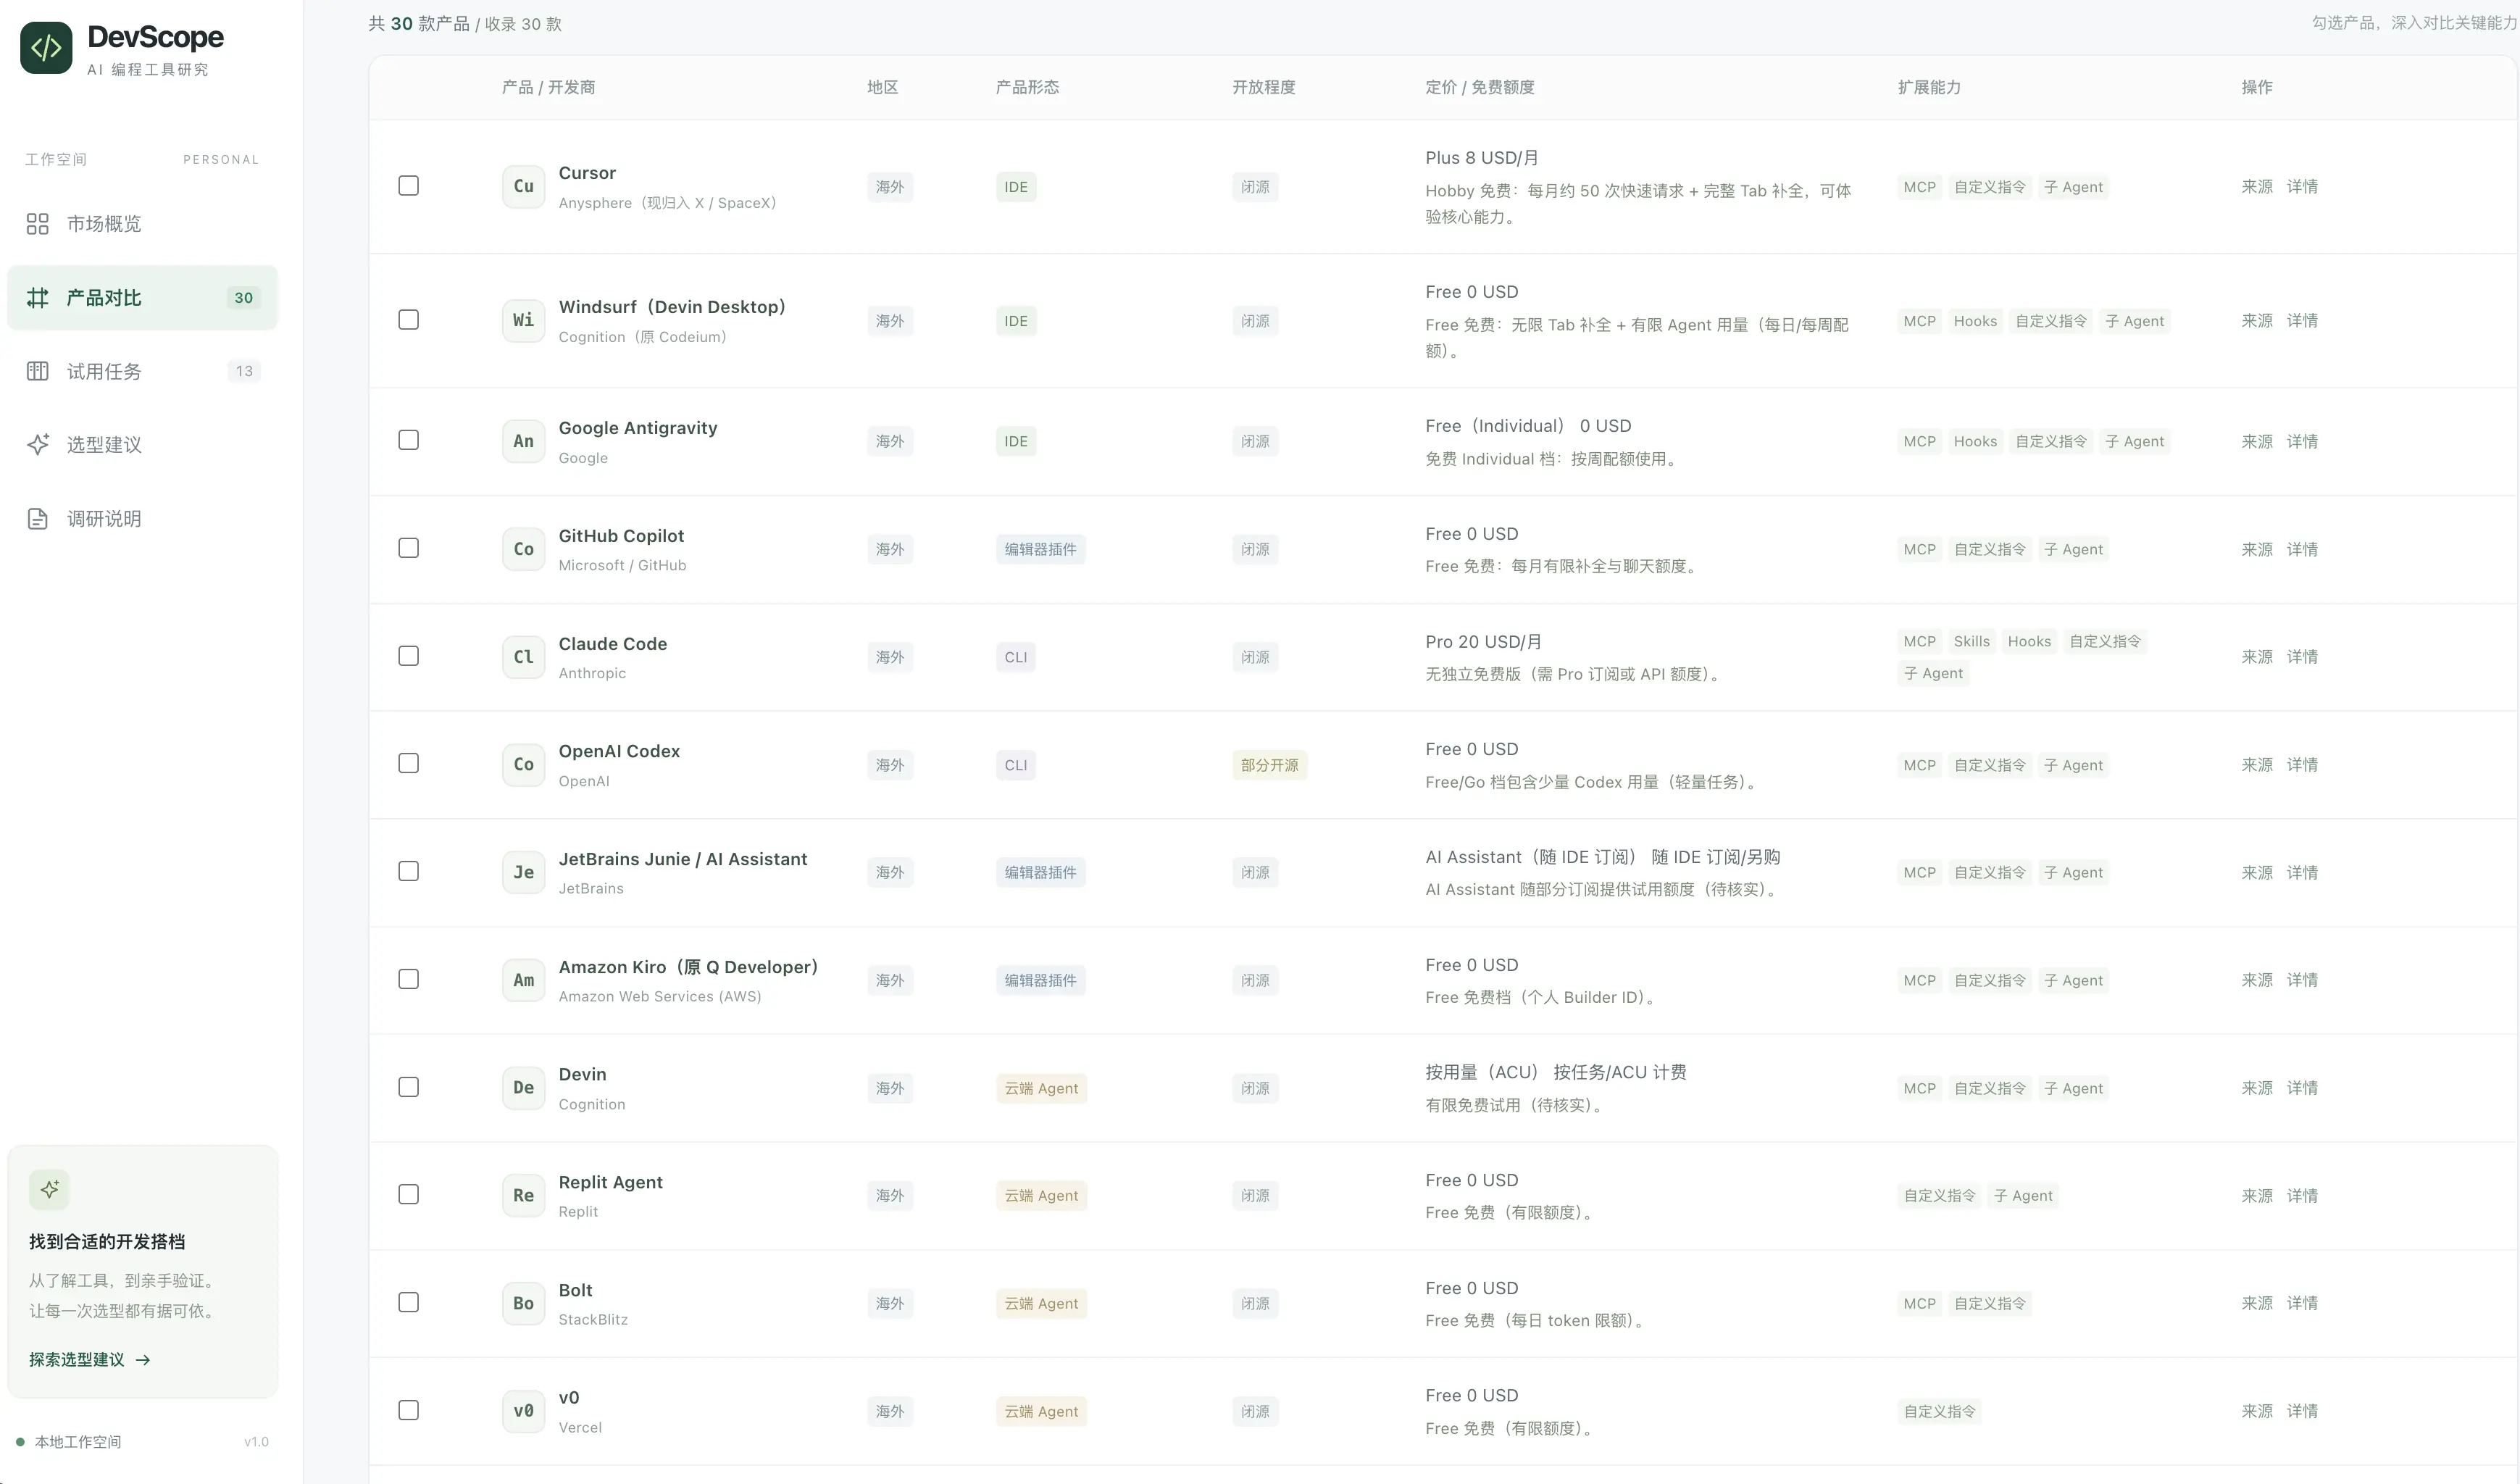
实际花费和 Token 消耗如下。
最后说说我的感受。
模型迭代这么快,与其每个月自己花时间去测、去纠结用哪个,不如把这件事交给专门做评测的人。
OpenSquilla 的思路就是:每个任务交给刚好够用的模型,配置每月按评测更新一次。模型每月评测出来新的组合,会把你本地的模型列表也同步更新。
如果你不想追模型的变化,可以选择 OpenSquilla 的智能路由方案,省心省 Token 。
感兴趣的小伙伴可以试试,看样子今天是双 11 期间最后一天了。