编者按: 在技术选型日益碎片化的今天,RAG、SKILL、MCP、RLM ------ 这些看似相似的技术名词缩写背后,究竟藏着怎样截然不同的设计哲学与适用边界?
我们今天为大家带来的文章,作者的核心观点是:RAG 与 RLM 本质上是"上下文窗口扩展"技术,而 SKILL 与 MCP 则聚焦于"外部工具调用"能力,四者并非互斥替代,而是针对不同场景的能力增强范式。
本文系统梳理并深度对比了当前主流的四大 LLM 能力扩展路线:从通过向量检索动态注入知识的 RAG,到依赖模型自主路由加载确定性代码的 SKILL;从标准化大模型与外部软件交互的 MCP 协议,到彻底打破上下文窗口物理限制的递归语言模型 RLM。作者不仅逐一拆解了各技术的实现流程、核心优缺点与生态现状,更结合一线工程实战,给出了极具操作性的"何时推荐用、何时坚决不用"的边界指南,帮助开发者有效规避上下文爆炸、系统臃肿与延迟失控等常见架构陷阱。
技术演进从无银弹,唯有"场景驱动"与"架构克制"方能真正释放 AI 的工程价值。希望这篇深度解析能为您的 AI 系统设计与技术决策提供清晰的路标,也期待各位开发者在实战中不断验证、迭代出更优雅的 AI 架构方案。
作者 | Alex Ewerlöf
编译 | 岳扬
LLMs 是通才型选手。无论是基础模型、指令模型还是推理模型,它们在专业任务上的表现总存在能力边界。
我们该如何突破这一限制,将通才型 LLM** 打造成特定任务场景下可靠的专才?
RAG 与 RLM 实质上扩展了模型的上下文窗口,而 SKILL 和 MCP 则实现了对外部工具的调用能力。
本文将逐一解析这些技术,涵盖其底层实现与使用机制、优缺点分析,并提供何时该用、何时不该用的实战建议。
声明:在本文的前期调研和初稿撰写阶段,我借助了一些 AI 工具,但我已经对全文进行了多次审阅与大幅精修,以确保内容完全表达的是我个人的思考与实战经验。
01 RAG - 检索增强生成(Retrieval-Augmented Generation)
从本质上看,RAG 就像是 AI 领域的"即时依赖注入"(JIT Dependency Injection)。大模型的权重在训练完成后就固定了,如果我们想让它掌握私有数据或最新信息,该怎么办?
RAG 引入了一套外部检索机制,在用户提示词送入模型之前先行执行。其核心目标是将高度相关、垂直领域的知识动态注入到模型的执行上下文中。
1.1 RAG 的实现
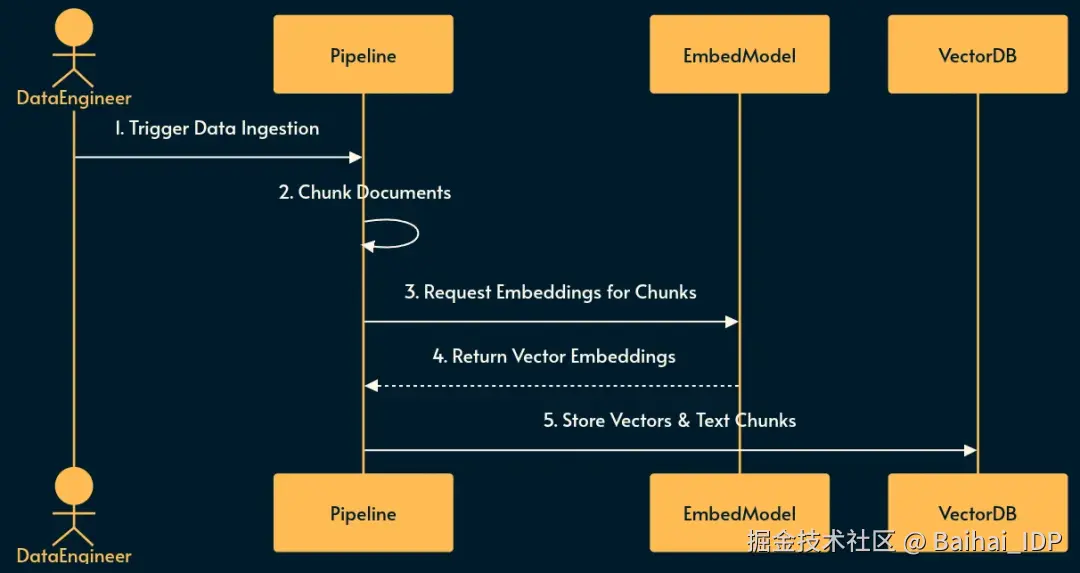
在使用 RAG 之前,需要先将知识库进行预处理,并索引为可检索的格式。
1)数据摄入(Ingestion) :收集并解析原始领域数据(如文档、维基、日志等)。
2)文本分块(Chunking) :将长文本切分为更小、语义完整的片段,以适配嵌入模型**和上下文窗口的长度限制。
3)向量化(Embedding) :通过嵌入模型将文本片段转换为高维向量表征(本质上是一个数值数组)。
4)存储(Storage) :将向量及其对应的文本片段存入向量数据库,以便快速执行相似度检索,可选方案包括 SQLite-Vector1、PostgreSQL pgvector2、Pinecone3,或直接加载 JSON 中的简单数组。
1.2 RAG 的使用
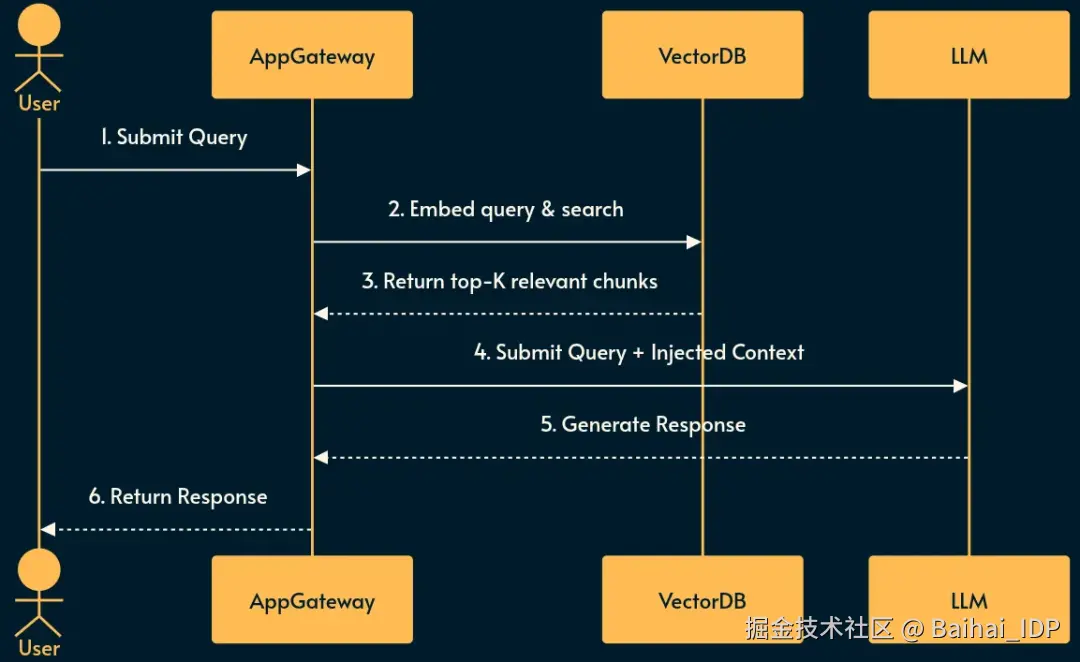
当用户与 RAG 系统交互时,系统会查询预先构建的向量数据库,动态注入相关上下文。
1)检索(Retrieval) :拦截用户查询,并用相同的嵌入模型将其转换为向量。
2)搜索(Search) :在向量数据库中执行相似度搜索(如余弦相似度计算4),找出最相关的文本片段。
3)注入(Injection) :将检索到的文本作为上下文,拼接到用户提示词的前部或后部。
4)生成(Generation) :大模型基于增强后的提示词,生成言之有据的回复。
1.3 RAG 的优缺点
- 优点:概念直观易懂;与模型底层实现解耦;能将大模型的输出严格限定在提供的事实范围内(有效降低幻觉);生态成熟、工具链丰富;无需对模型进行任何微调;RAG 所用的数据和向量数据库可独立更新,不必扰动大模型本身。
- 缺点:效果高度依赖嵌入模型的质量和分块策略的合理性;词汇或语义层面的不匹配可能导致"静默检索失败";引入向量数据库会带来额外的基础设施开销和状态管理复杂度。
1.4 RAG 的适用场景
- 什么时候推荐使用:当你需要查询静态的或低频更新的知识库(如企业维基、产品文档、历史日志),且数据量已超过大模型上下文窗口、但很适合使用检索范式处理时。
- 什么时候不推荐使用:涉及实时交易数据、需要基于全量数据进行复杂多步推理的任务,或当专业逻辑偏向行为规则而非信息查询时。
注:如果数据集本身很小,可以跳过向量化和向量数据库环节,直接将内容拼入系统提示词。这种方法被称为 CAG(Cache-Augmented Generation),但因实现简单、适用场景有限,本文未将其单独列出。
1.5 延伸阅读
- PageIndex5:一种替代 RAG 的思路,完全跳过向量化机制,改为提供上下文目录供智能体导航。
- GraphRAG**6:微软研究院提出的方案,通过知识图谱映射不同信息片段之间的关联(区别于我们讨论的基础版 RAG)。
02 SKILL - 动态能力加载(Dynamic Capability Loading)7
如果说 RAG 像是"即时依赖注入(Just-In-Time dependency injection)",那么 SKILL 就更接近"动态链接库"(DLL)的工作方式。
SKILL 颠倒了 RAG 的流程:不再是依靠固定的向量检索去盲目注入数据,而是让大模型根据对话上下文,自主判断需要加载哪些能力。
这种方式也省去了嵌入模型和向量数据库的依赖,使得使用门槛大幅降低。
2.1 SKILL 的实现
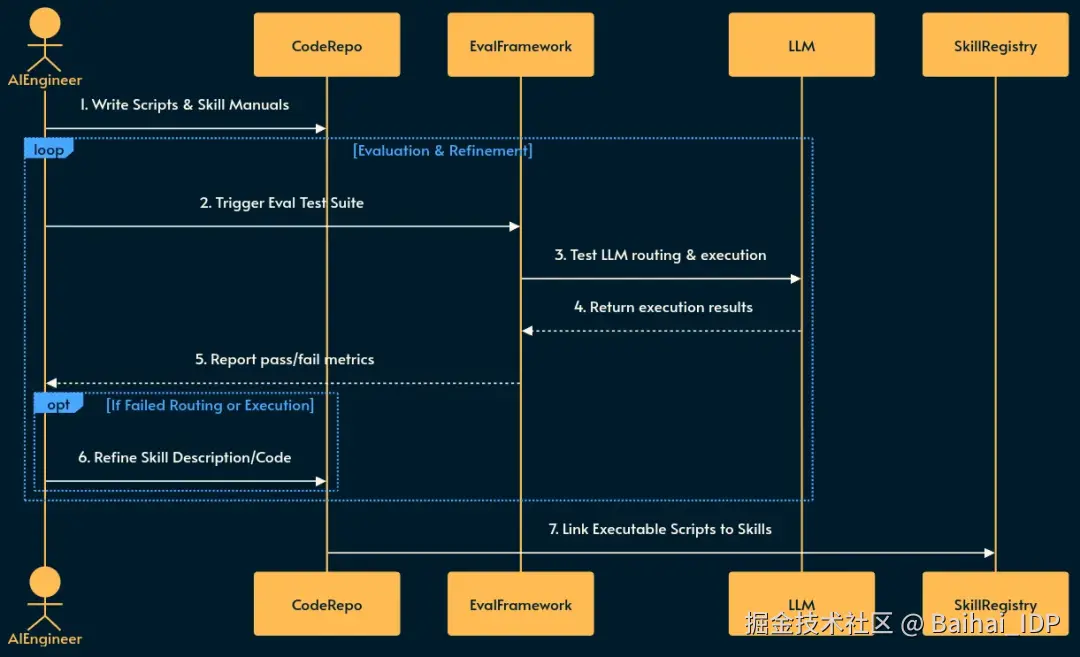
在部署之前,领域专家(SME)需要先定义各项技能(skills)、编写确定性代码,并对 LLM 的路由行为进行迭代评估。
1)定义技能(Definition) :工程师撰写清晰、简洁的能力描述(例如"金融计算器"、"用户认证管理器")。
2)脚本编写(Scripting) :用确定性代码(如 Node.js 或 Python 函数)实现大模型不擅长的任务,比如数学运算或精确的字符串格式化。
3)评估(Eval Loop) :使用"golden dataset"对技能进行验证。评估框架会检查大模型是否能正确路由到新技能,以及工具是否返回预期结果。若失败,则需优化技能描述或底层脚本。
4)注册(Registration) :一旦技能通过了评估阈值,其能力描述、使用手册和可执行脚本将被注册到中央技能注册表(central Skill Registry)(如 Anthropic**8 的 Skill Registry),供 AI 应用调用。
2.2 SKILL 的使用
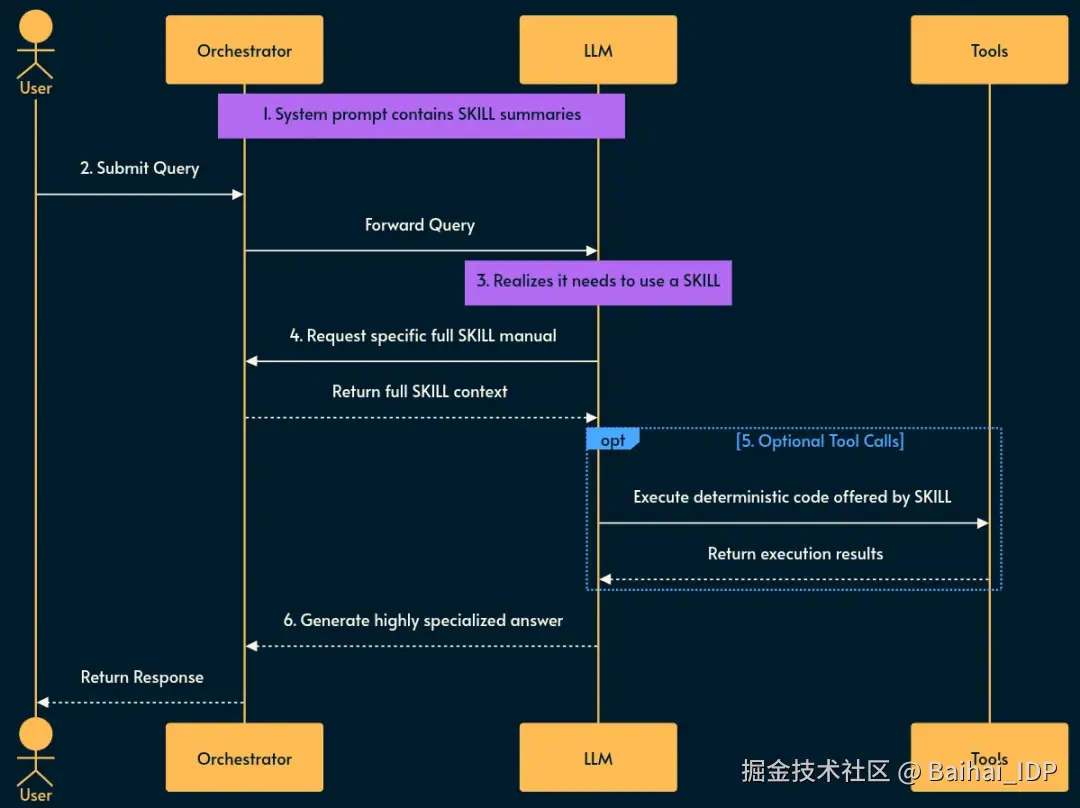
每个 SKILL9 都包含一个名称(name)字段和描述(description)字段。
1)能力广播(Capability Broadcasting) :系统提示词中注入一份轻量级的可用技能摘要列表(仅含名称与描述)。
2)评估(Evaluation) :大模型根据用户提示词,结合自身已知能力进行判断。
3)检索(Retrieval) :如有需要,大模型会主动请求加载解决当前问题所需的完整技能手册或脚本。
4)能力增强与工具调用(Augmentation & Tooling) :系统加载所请求的技能。此外,LLM 可以根据该技能提供的确定性脚本发起工具调用(由编排器执行)。
5)执行(Execution) :大模型结合工具执行结果与新加载的上下文,构建出一个高度专业化的答案。
2.3 SKILL 的优缺点
- 优点:仅加载所需能力,大幅降低 token 消耗;利用大模型自身的推理能力进行路由决策,而非依赖"简单"的嵌入模型与向量相似度;支持将随机性推理与确定性脚本执行相结合(特别适用于数学或严格逻辑场景)。
- 缺点:用户获取回复前会引入多轮交互延迟;需要足够强大的推理模型,才能准确判断该加载哪个技能。
2.4 SKILL 的适用场景
- 推荐使用的场景:当 LLM 面对数百个潜在工具可供调用、而一次性加载全部工具定义会撑爆上下文窗口或令模型困惑时(模型在工具数超过约 50 个后,便难以准确加载相关技能),请选用 SKILL。它尤其适合将数学运算或确定性路由任务分流给简单脚本处理。
- 不推荐使用的场景:简单的问答机器人、对延迟敏感的同步 API 场景,或当使用推理能力较弱的小模型、难以支撑多步渐进式能力增强时。
2.5 延伸阅读
- npx skills10:一个命令行工具,可与 skills.sh11 配合,直接从互联网查找并下载技能到本地机器。
- Skill specification8:来自 Anthropic 的技能规范文档。他们还维护了一个名为"Awesome Skills"12的技能市场。此外还有这份清单13、这份清单14,或者这个15、这个16。正如你所见,这类技能目录可谓遍地开花。😄
03 MCP - 模型上下文协议(Model Context Protocol)17
MCP 就像是 AI 领域的 POSIX 标准或 API 网关。 它最初是为了标准化大模型与外部软件(浏览器、IDE、数据库、SaaS 等)的交互方式,定义了一套严格的客户端 - 服务器架构,并对外暴露三个核心原语:
- Prompts:可复用的提示词模板✳️
- Tools:可执行的函数✳️
- Resources:上下文数据与文件✳️
你可能已经注意到,MCP 与 SKILL 都包含 prompt 和 tools 的概念。虽然 MCP 最初被定位为一种纯粹的"协议翻译层",但现实中许多 MCP 实现其实是自包含的 ------ 直接将 prompt 模板与 tool 函数打包成一个独立单元。对于这类场景,更推荐使用 SKILL18。
3.1 MCP 的实现
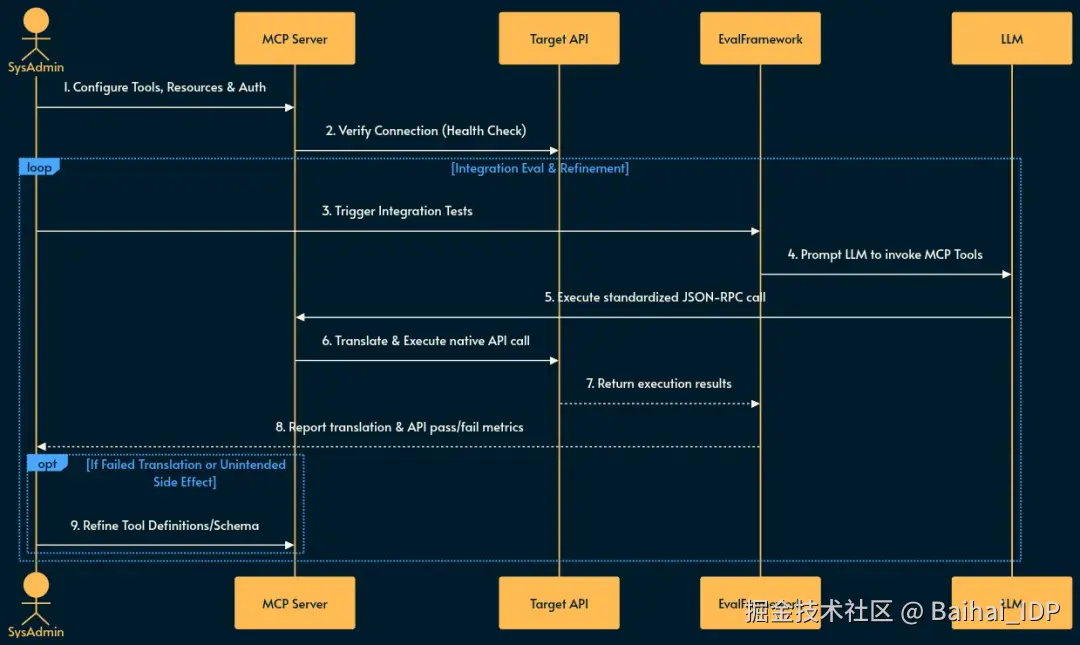
MCP 服务器扮演集成层的角色,必须配置好与外部系统的通信,并经过严格测试以确保翻译的准确性。
1)服务器部署(Server Setup) :在网络或本地环境中启动一个 MCP 服务器实例。它可以简单到只是一个 docker 容器,甚至一条 npx19 命令。
2)配置(Configuration) :工程师需要定义服务器将要暴露的 Resources(如文件路径、数据库 Schema)与 Tools(如 API POST 请求)。
3)认证与路由(Authentication & Routing) :为服务器配置必要的凭证20和网络路由,使其能够安全地与目标外部系统通信。MCP 服务器充当 OAuth 2.1** 资源服务器21,MCP 客户端则充当 OAuth 2.1 客户端21。
4)集成评估(Eval Loop) :自动化测试套件会驱动 LLM 与新配置的 MCP 服务器交互。评估框架负责验证 LLM 是否能正确发现工具、能否生成合法的 JSON-RPC 请求,以及目标 API 是否能准确响应且不产生预期之外的状态变更。
3.2 MCP 的使用
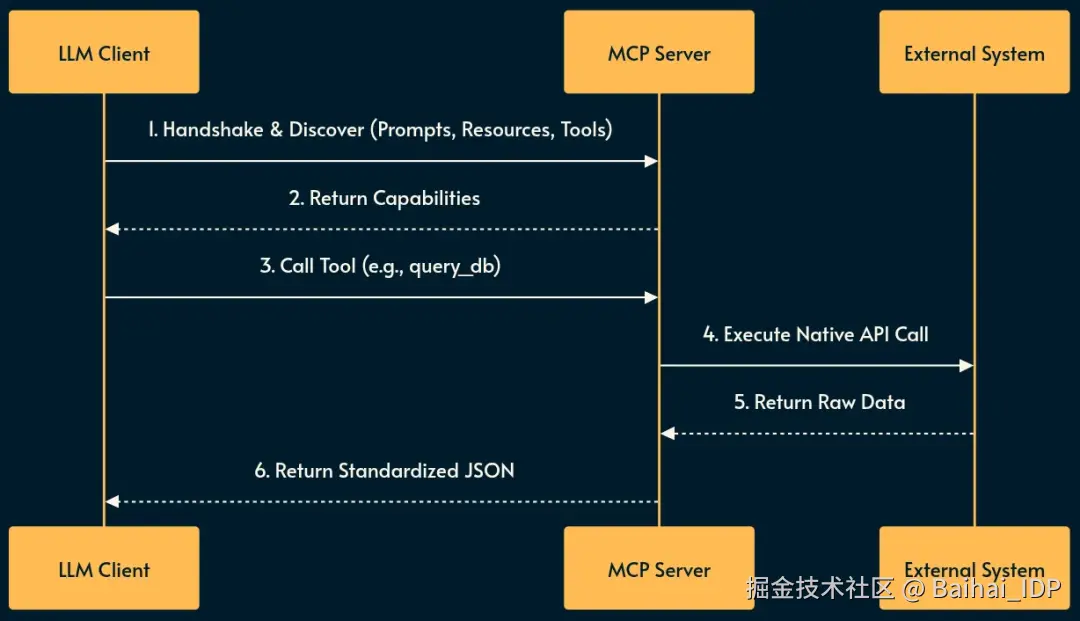
LLM 客户端通过建立标准化的连接来与环境交互。
1)发现(Discovery) :LLM 客户端(注意,不是底层的原始 LLM)连接到 MCP 服务器,并通过标准化的 JSON-RPC 查询22其可用的 Prompts、Resources 和 Tools。
2)集成(Integration) :大模型读取某个 Resource(如拉取一条 GitHub issue)或调用某个 Tool(如触发构建流水线)。实际调用由 LLM 客户端执行。
3)翻译(Translation) :MCP 服务器将标准化的 LLM JSON-RPC 请求,翻译为目标软件所需的专有 API 调用。
4)回调(Callback) :外部软件执行相应动作,并将结果经 MCP 服务器返回给 LLM 客户端,最终交由大模型处理。
3.3 MCP 的优缺点
- 优点:将大模型与目标 API 解耦。支持一次编写、随处使用的工具创建模式(一个 MCP 服务器可同时服务于 Claude、本地工具或各类自定义界面)。
- 缺点:系统架构可能偏重且缺乏弹性。如前文所述,自包含的 MCP 往往在初始阶段就注入过多上下文,效率不如 SKILL 的动态加载机制。LLM Client 与 Server(位于大模型与 API 之间)增加了系统复杂度,而复杂性越高,通常意味着出错的风险越大,可靠性越低。
3.4 MCP 的适用场景
- 推荐使用的场景:当需要将 LLM 连接到复杂的有状态外部系统(如数据库、SaaS 平台、本地文件系统),且标准化、安全性以及在不同 AI 客户端之间的复用性是硬性要求时,请使用 MCP。
- 不推荐使用的场景:内部紧耦合的微智能体交互,或自包含型任务,不要使用 MCP ------ 这类场景中,SKILL 的动态、轻量特性在性能与成本上更具优势。
3.5 延伸阅读
- WebMCP23 提出了两项新的 API,使浏览器智能体能够代表用户执行操作:
-
- Declarative API:执行可以直接在 HTML 表单中定义的标准动作。
- Imperative API:执行需要运行 JavaScript 的复杂的、更具动态性的交互。
- Chrome DevTools MCP23:我个人非常喜欢的一个 MCP 实现,因为它赋予了智能体"眼睛",让其能看到代码运行的结果并调试前端代码。
- 和 SKILL 一样,MCP 的市场和目录也毫不匮乏,比如这个24、那个25,或者是另外一个26。
- 使用 CLI 替代标准 JSON27:我在本文发布当天才注意到这一动向(足见该领域演进之快),其核心思路是向 LLM 开放 CLI 访问权限,而非遵循 MCP 标准。
- Skills vs Dynamic MCP Loadouts:一篇分析透彻、论证清晰的好文章,解释了为何自包含的 MCP 是一种反模式(译者注:软件工程术语,指一种看似合理、实则会导致架构臃肿、维护困难或性能下降的错误设计实践),以及为何我们应优先选用 SKILL。
04 RLM - 递归语言模型(Recursive Language Models)28
如果说 SKILL 的运作方式像 DLL,那么 RLM 就好比 FFI(外部函数接口)。
RLM 是其中最新演进的一种架构,其工作方式类似于 MapReduce 与递归式 REPL(Read-Eval-Print Loop29,读取-求值-输出循环)的结合体 ------ Python30 或 Node.js31 中就内嵌有这种 REPL。
它的核心目标是彻底突破大模型上下文窗口的物理限制。 RLM 不再试图将海量提示词硬塞进模型,而是将长文本/大数据直接作为外部环境变量挂载。
4.1 RLM 的实现
由于 RLM 需要针对海量数据集递归执行代码,因此必须准备一个安全的执行环境。
1)Environment Provisioning(环境准备) :搭建一个沙箱化的 REPL 环境(例如 Docker 容器或 Firecracker 微虚拟机32),并配置好必要的运行时(Python、Node.js 等)。
2)Data Staging(数据预置) :将海量数据集(如整个代码仓库或数 GB 的法律文件)预置到高速本地文件系统中。
3)Variable Mounting(变量挂载) :将该数据集作为可访问的全局变量或目录结构,挂载至 REPL 环境内。
4.2 RLM 的使用
大模型将被授权访问该安全环境,以递归方式探索数据。
1)Scaffolding(脚手架搭建) :系统提示词中包含明确指令,向模型说明 REPL 环境的功能、能力边界以及总体任务目标。
2)Programmatic Peeking(程序化窥探) :LLM 编写代码,对环境内挂载的海量变量进行探查、搜索或切片。
3)Recursive Invocation(递归调用) :大模型生成程序,递归地派生出自身的新实例,并行处理被切片后的提示词/数据片段。
4)Aggregation(聚合) :递归调用沿调用栈逐层返回,汇总发现结果,最终将完整状态或变量结果交还给用户。
4.3 RLM 的优缺点
- 优点:彻底解锁近乎无限的上下文处理能力;在处理海量数据集时,其准确率远超简单的"分块+检索"式 RAG;允许 LLM 动态决定自身的数据遍历策略。
- 缺点:非确定性的执行路径可能引发无限递归或 API 费用失控;观测与调试极为复杂;由于涉及多次串行与并行的大模型调用,延迟极高。
4.4 RLM 的适用场景
- 推荐使用 RLM 处理需要全局上下文理解的海量复杂推理任务 ------ 例如重构整个单体代码库、分析上万页的法律取证材料、爱泼斯坦案卷宗,或在标准 RAG 向量检索难以捕捉结构细节的大型数据集中挖掘深层逻辑漏洞。
- 不推荐使用 RLM 处理任何面向用户的、同步的聊天应用场景,也不适用于简单的文本摘要任务,或者那些有严格成本控制与低延迟要求的环境。
05 Further reading
- Skills vs Dynamic MCP Loadouts, Armin Ronacher33, 2025-12-13
- RLM: The Ultimate Evolution of AI? Recursive Language Models34, Gao Dalie, 2026-01-13
END
本期互动内容 🍻
❓在你的业务场景里,是更怕「检索不准」,还是更怕「加载太慢」?为什么?
文中链接
4en.wikipedia.org/wiki/Cosine...
6microsoft.github.io/graphrag/
9support.claude.com/en/articles...
12awesomeclaude.ai/awesome-cla...
18lucumr.pocoo.org/2025/12/13/...
19docs.npmjs.com/cli/v8/comm...
20modelcontextprotocol.io/specificati...
22en.wikipedia.org/wiki/JSON-R...
23developer.chrome.com/blog/chrome...
26mcp.so/
29en.wikipedia.org/wiki/Read%E...
30realpython.com/python-repl...
32firecracker-microvm.github.io/
33lucumr.pocoo.org/2025/12/13/...
本文经原作者授权,由 Baihai IDP 编译。如需转载译文,请联系获取授权。
原文链接: