第 7 篇做完,系统终于能"有交代"了:答完一题给个带分数的点评,整场结束聚合成一份总评。我兴冲冲把总评往群里一贴,准备当交付物用,结果被人一句话问住了------"这报告你敢直接发给候选人吗?"
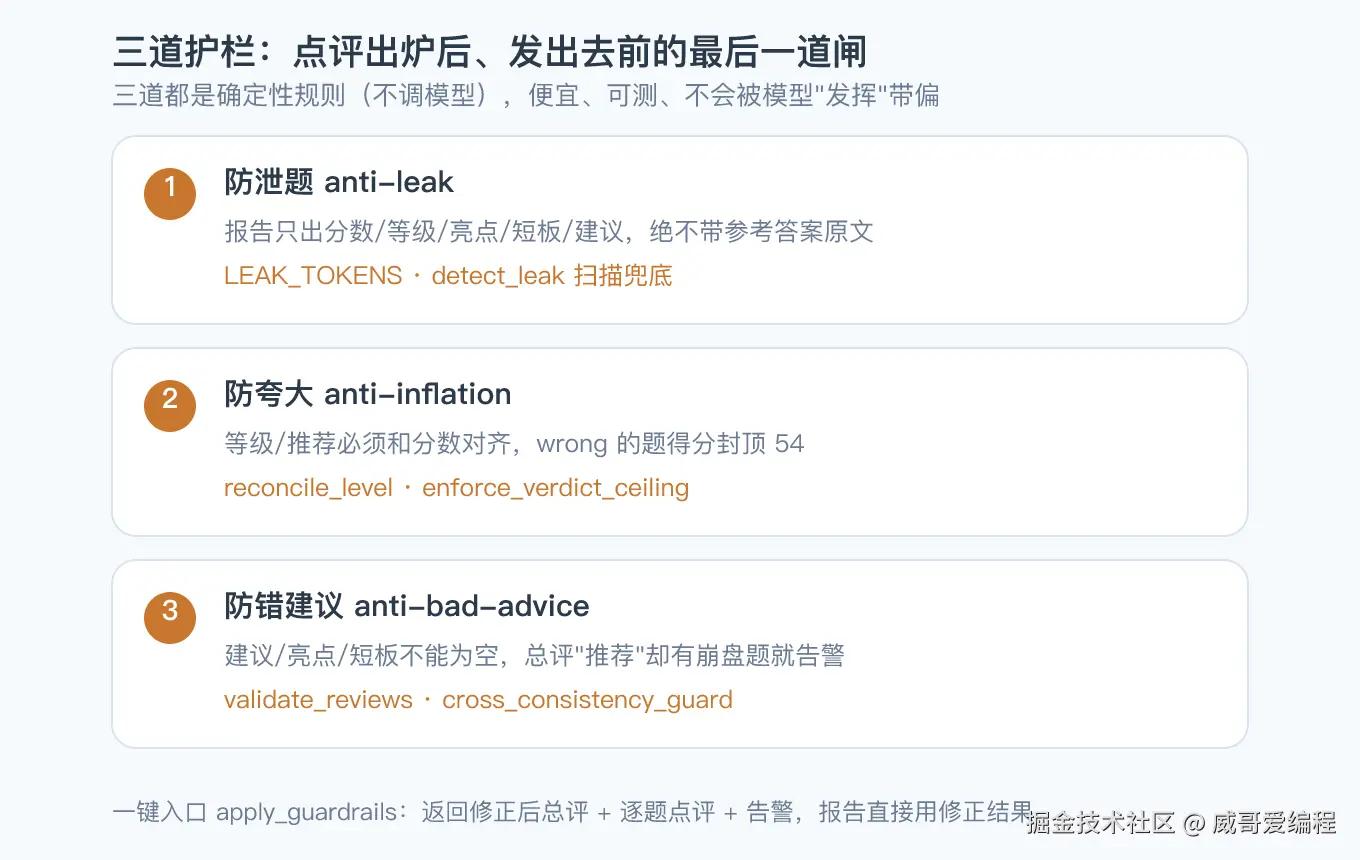
我停下来一想,还真不敢。三个问题摆在眼前:第一,报告可能泄题 。模型点评时是"对着参考答案判"的,万一它把参考答案原文顺手抄进点评里,候选人下次直接背答案,题库就废了;第二,分数可能被夸大 。模型有时嘴上说"优秀",分数却只有 50 分,等级和分数对不上,报告自己打自己脸;第三,建议可能是空的或自相矛盾。总评写着"强烈推荐",里面却有一题崩到不及格,候选人看完一头雾水。
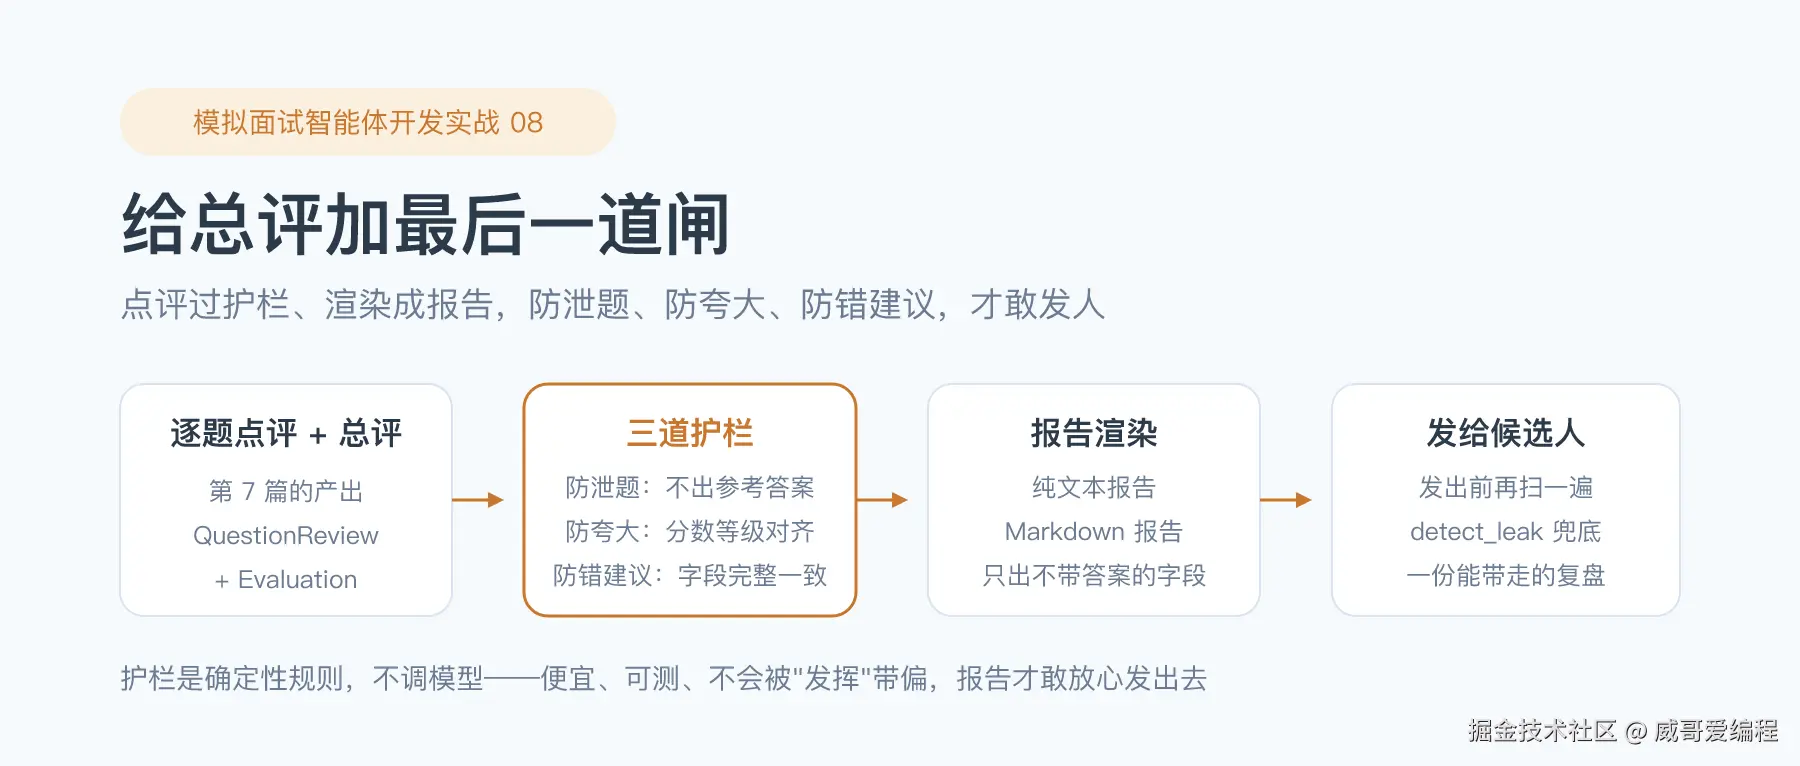
这一篇就给这套系统加最后一道闸 :把总评渲染成一份能发人的报告,并且在发出去之前过三道护栏------防泄题、防夸大、防错建议。核心还是那句老话:这三道闸全是确定性规则,不调模型,便宜、可测、不会被模型"发挥"带偏。
一、先扫盲:为什么报告一定要有护栏
1. 报告是给候选人看的,参考答案绝不能漏
前面几篇反复强调"模型只对着参考答案判,不引入自己的标准"。这带来一个副作用:参考答案原文会出现在模型眼前的提示词里,模型随手一抄,就可能把答案带进点评。举个例子:候选人被问"Redis 的 AOF 重写是怎么触发的",模型点评时很可能写出"本题正确答案是先触发 auto-aof-rewrite-percentage 阈值......"------这一句把参考答案的关键词全带出来了。对内部复盘没事,可一旦报告发给候选人,"这道题的标准答案是什么"就被泄露了------下次面试直接背,测评就失真了。所以防泄题是第一优先级:报告里只允许出现分数、等级、亮点、短板、建议、总结这些"公开字段",参考答案原文一个字都不能有。
2. 模型的等级、推荐会跟分数打架
模型不是算术机。你让它同时输出"分数"和"等级",它可能给分数 50、等级却写"优秀";给它总分 72,推荐结论却写"强烈推荐"。这些不一致在真实调用里高频出现,因为它本质上是在"猜"一个它记不准的阈值。解决办法只有一个:等级和推荐永远由代码查表,模型只负责给数字。分数 50 → 查表得"待提升",模型写什么等级都不算数。
3. 建议为空、总评矛盾,复盘就失效了
一份复盘的价值在"下一步练什么"。如果某道题的 advice 是空的,或者总评"推荐"却有一题崩到 40 分,候选人根本不知道该信哪句。这些是数据完整性问题,靠"人肉看一遍"迟早漏,必须用规则自动体检,把矛盾拦在发出之前。
三道闸合起来,就是把"模型产出"和"能发人的报告"之间,架上一道不依赖模型的、可离线测试的过滤层。
4. 为什么三道闸都不用模型
有人会问:既然模型能判定、能点评,让它顺便"自检一下报告合不合规"不就行了?不行,原因有三:第一,这些检查本质是规则,不是语义 。等级和分数对不对得上、建议是不是空、有没有泄题词,是确定的字符串比对和查表,用模型反而慢、贵、还不稳;第二,护栏必须可测 。护栏是全系统最后一道防线,必须能在离线、零成本、无 Key 的情况下跑全绿,模型调用做不到这一点;第三,让模型自查自己,等于让考生自己批卷。它写出"优秀"又让它判断"优秀"合不合理,天然没有独立性。所以护栏清一色是纯函数------这也和前几篇"便宜确定的交给算术,语言加工交给模型"是同一句格言。
二、工程结构:报告渲染 + 护栏,两层分离
bash
08-总评报告与护栏/
├── src/
│   ├── settings.py     # 配置集中读取(沿用前几篇,硅基流动 + DeepSeek-V3)
│   ├── llm.py          # 模型工厂(沿用前几篇:真 Key / 离线脚本模型 / 报错)
│   ├── rubric.py       # 点评与总评的 pydantic 模型 + 阈值(沿用第 7 篇)
│   ├── guardrails.py   # 三道护栏:防泄题 / 防夸大 / 防错建议(本篇新增)
│   └── report.py       # 报告渲染:文本 / Markdown / 可选开场白(本篇新增)
├── tests/              # 26 个用例,全程离线
└── demo.py
rubric.py 里是第 7 篇已经定好的 QuestionReview、Evaluation 和阈值函数 level_of、recommendation_of,这篇直接复用------护栏要"对齐分数和等级",靠的就是这同一套阈值。新增的两个模块分工清晰:guardrails.py 管"发出去之前对不对",report.py 管"发出去长什么样"。
三、三道护栏:把规则焊死在代码里
guardrails.py 是本篇的心脏。三道闸都是纯函数,输入点评/总评,输出修正结果或告警清单。
1. 防泄题:detect_leak 扫描 forbidden 词
python
# 报告里绝对不能出现的词(题库 / 参考答案相关)
LEAK_TOKENS = ("参考答案要点", "参考答案", "正确答案", "标准答案", "题库原文")

def detect_leak(text: str, extra_tokens=()) -> list[str]:
    """扫描文本里是否出现泄题词,返回命中的词列表(空=安全)。"""
    tokens = LEAK_TOKENS + tuple(extra_tokens)
return [t for t in tokens if t in text]这是兜底扫描,真正的第一道墙在渲染层 (下一节讲):报告渲染函数压根就不输出参考答案字段,答案进不来。detect_leak 是"发出前最后再扫一遍",万一哪个环节手滑把答案拼进报告,这里直接命中、拦住。
2. 防夸大:等级、推荐必须跟分数对齐
python
def reconcile_level(score: int, level: str) -> str:
    correct = level_of(score)
    return correct if level != correct else level

def enforce_verdict_ceiling(review, verdict_quality) -> QuestionReview:
    """wrong / offtopic 的题,得分不允许超过待提升线(54)。"""
    if verdict_quality in ("wrong", "offtopic") and review.score > 54:
        return review.model_copy(update={"score": 54, "level": level_of(54)})
    return review
reconcile_level 让"分数 50 却写优秀"这种漂移现形:以分数为准查表,等级被压回"待提升"。更狠的是 enforce_verdict_ceiling------它直接接住第 6 篇的判定结果:如果某道题第 6 篇已经判了 wrong(有事实错误)或 offtopic(答非所问),那这道题的得分不允许超过 54 分(待提升线)。这样"判错了却给高分"的矛盾在源头就断了。
这里有个容易忽略的连锁反应:一旦有题被压分,总分就必须重算 。护栏不是压完单题就完事,还要把压分后的所有得分重新取平均、重新查等级和推荐------否则就会出现"第 3 题从 55 压到 54,但总分还按旧的 72 显示"这种数字对不上的情况。这也解释了为什么 apply_guardrails 要返回修正后的逐题点评,而不是只返回总评。
3. 防错建议:字段完整 + 总评一致
python
def validate_reviews(reviews) -> list[str]:
    problems = []
    for idx, r in enumerate(reviews, start=1):
        if not (r.advice or "").strip():
            problems.append(f"第{idx}题建议为空")
        if not r.strengths:
            problems.append(f"第{idx}题亮点为空")
        if not r.weaknesses:
            problems.append(f"第{idx}题短板为空")
    return problems

def cross_consistency_guard(evaluation, reviews) -> list[str]:
    warnings = []
    for idx, r in enumerate(reviews, start=1):
        if evaluation.recommendation in ("推荐", "强烈推荐") and r.score < 50:
            warnings.append(f"第{idx}题得分{r.score}偏低,与总评'{evaluation.recommendation}'矛盾")
return warnings两个函数各管一边:validate_reviews 查"每一题字段是否完整",cross_consistency_guard 查"总评结论和逐题得分是否矛盾"。总评"推荐"却有一题崩到 50 以下,直接告警,让矛盾暴露在发出之前。
4. 一键入口:apply_guardrails 返回三件套
三道闸不该让调用方一个个去拼,我把它包成一个入口:
python
def apply_guardrails(evaluation, reviews, verdicts=None):
    """返回(修正后的总评, 修正后的逐题点评, 告警清单)。"""
    fixed_reviews = []
    for r, v in zip(reviews, verdicts or [None] * len(reviews)):
        quality = v if isinstance(v, str) else getattr(v, "quality", None)
        r = enforce_verdict_ceiling(r, quality)
        r = r.model_copy(update={"level": reconcile_level(r.score, r.level)})
        fixed_reviews.append(r)

    overall = round(sum(r.score for r in fixed_reviews) / len(fixed_reviews))
    fixed_eval = evaluation.model_copy(update={
        "overall_score": overall,
        "level": reconcile_level(overall, evaluation.level),
        "recommendation": reconcile_recommendation(overall, evaluation.recommendation),
    })
    ...
return fixed_eval, fixed_reviews, warnings注意它返回的不是两个值,是三个 :修正后的总评、修正后的逐题点评、告警清单。为什么要同时返回修正后的逐题点评?因为如果有题被压分(比如 55 → 54),总分会重算,但报告里那道题的得分也必须跟着变------否则报告写着"第 3 题 55 分",抬头却是"总分 71",自己就打自己脸了 。这个坑我一开始没注意,第一版只返回了总评,渲染报告还拿原始的 reviews,结果演示输出里出现了总分和单题对不上的尴尬,改回三件套才闭环。
四、报告渲染:能发人的报告长什么样
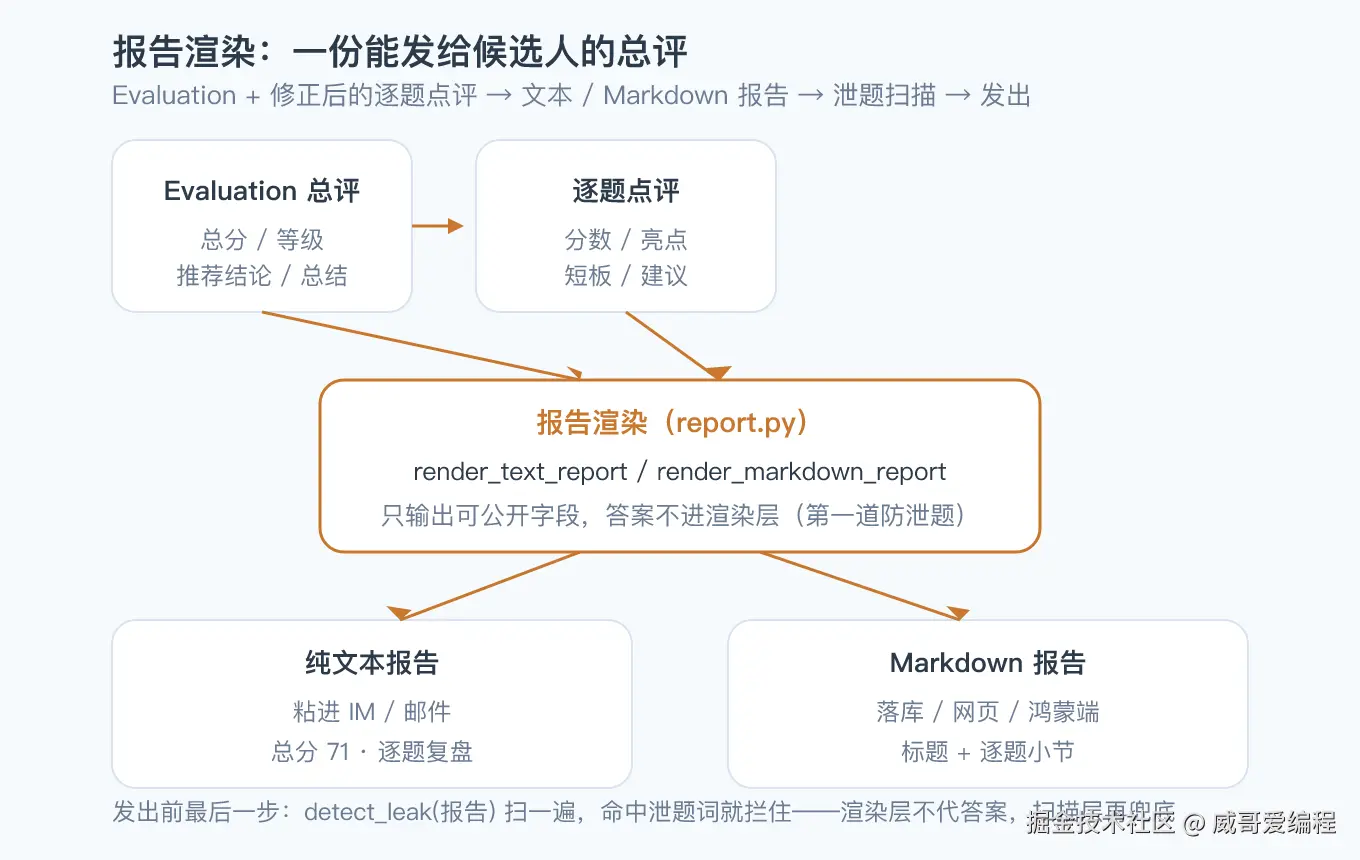
report.py 把 Evaluation + 逐题点评变成两份报告。核心纪律只有一条:渲染层只输出公开字段,参考答案一个都不带------这是防泄题的第一道墙,比扫描更彻底,因为答案压根没进来。
python
def render_text_report(evaluation, reviews) -> str:
    """纯文本报告,适合直接粘进 IM / 邮件发给候选人。"""
    lines = ["=" * 30, "         模拟面试 · 总评报告", "=" * 30]
    lines.append(f"总分:{evaluation.overall_score}({evaluation.level})")
    lines.append(f"推荐结论:{evaluation.recommendation}")
    lines.append("【综合亮点】")
    for s in evaluation.strengths:
        lines.append(f"  + {s}")
    ...
    for idx, r in enumerate(reviews, start=1):
        lines.append(f"  第{idx}题  得分 {r.score}({r.level})")
        if r.strengths:
            lines.append(f"    亮点:{';'.join(r.strengths)}")
        if r.weaknesses:
            lines.append(f"    短板:{';'.join(r.weaknesses)}")
        lines.append(f"    建议:{r.advice}")
    ...
    return "\n".join(lines)
render_markdown_report 结构相同,只是用 Markdown 标题和列表,方便落库、渲染成网页、或者后面鸿蒙端做富文本展示。两份报告都只有"分数 / 等级 / 推荐 / 亮点 / 短板 / 建议 / 总结",reference_answer 字段从头到尾没被引用------想泄露都没得泄露。
还有一个可选的开场白 polish_intro:让模型给报告写一句鼓励且诚实的话(不超过 40 字、不出现参考答案)。它是"语言加工交给模型"的延续------数字都是算术算好的,只有"人话"交给模型补。当然,就算模型在开场白里"发挥",detect_leak 在发出前还会再扫一遍兜底。
五、跑起来看真实效果
python demo.py 全程离线,演示"三道护栏 + 报告渲染 + 泄题扫描"完整链路:
markdown
① 护栏修正后:总分 71(良好)/推荐
   无告警,可直接发出

② 纯文本报告:
==============================
         模拟面试 · 总评报告
==============================
总分:71(良好)
推荐结论:推荐

【综合亮点】
  + 基础扎实
  + 讲清取舍
  + 概念清楚

【综合短板】
  - 生产经验少
  - 深度不够

【逐题复盘】
  第1题  得分 88(优秀)
    亮点:覆盖 RDB/AOF 两种;讲清文件大小与恢复速度的取舍
    短板:没提 fsync 三档
    建议:把 AOF 的 fsync 三档区别讲清楚
  第2题  得分 72(良好)
    亮点:概念清楚
    短板:深度不够
    建议:补充持久化与主从同步的关系
  第3题  得分 54(待提升)
    亮点:答了要点
    短板:有事实错误;表述乱
    建议:先纠正 RDB 触发时机的说法

【总结】
  整体良好,建议进一步补生产深度。
==============================

④ 发出前泄题扫描:
   文本报告:安全(无泄题词)
   Markdown:安全(无泄题词)
注意几个细节:第 3 题原本 55 分,因为第 6 篇判定它是 wrong,被护栏压到了 54 分,等级也从"合格"改成"待提升";总分跟着从 72 重算成 71((88+72+54)/3)。这份报告内部完全自洽------总分、等级、推荐、逐题得分,全都对得上,且从头到尾没有一个字是参考答案。这就是"敢发人"的报告该有的样子。
上面是离线演示。真接到硅基流动的 DeepSeek-V3 后,点评和总评的内容由模型现场生成,但护栏和渲染这两层一个字都不用改 ------apply_guardrails 和 render_*_report 吃的是同一份 Evaluation / QuestionReview 结构,模型只是把里面的文字写得更像人话。配置还是走 .env(LLM_API_KEY=sk-你的密钥、LLM_BASE_URL=https://api.siliconflow.cn/v1、LLM_MODEL=deepseek-ai/DeepSeek-V3),密钥绝不进代码仓库。也就是说,你在本机离线验证过的"压分、重算、去重、泄题扫描",上线即生效,不因换真模型而有任何行为差异。
六、测试覆盖:26 个用例把三道闸钉死
bash
tests/test_report.py        报告结构、字段完整、绝不出现参考答案、开场白
tests/test_guardrails.py    三道闸:等级/推荐对齐、压分、泄题扫描、空字段、一致性
tests/test_demo.py          端到端:护栏 → 渲染 → 泄题扫描,报告内部自洽
─────────────────────────
26 passed in 1.84s
覆盖到什么程度:报告文本和 Markdown 都含总分/等级/推荐、逐题列出每题得分与建议;两份报告都不出现"参考答案"等 forbidden 词 (这是防泄题的核心断言);reconcile_level 四档边界、reconcile_recommendation 四档边界;enforce_verdict_ceiling 对 wrong/offtopic 压到 54、对 correct/partial/None 不动、对本来就低的不再往下压;detect_leak 命中/不命中/自定义词;validate_reviews 空建议、空亮点;cross_consistency_guard 崩盘题告警;apply_guardrails 压分后总分重算、返回的逐题点评被同步修正、推荐结论被纠正。全部离线,不需要 Key、不联网。
这里最值得拿出来说的是那条**"报告绝不出现参考答案"的断言**。别的测试是"验证功能对不对",这一条是"验证安全底线守没守住"------它直接断言 render_text_report 和 render_markdown_report 的输出里没有 参考答案、正确答案、标准答案、题库原文 任何一词。哪怕哪天有人改了渲染函数、不小心把答案字段加进去,测试立刻红。护栏的价值,一半在拦住坏数据,另一半就在"让人不敢随便拆掉这道闸"。
七、踩坑清单
- 第一版只返回总评,没返回修正后的逐题点评 :有题被压分后总分变了,但报告还渲染原始的
reviews,结果"总分 71"却写着"第 3 题 55 分"。改回"总评 + 逐题点评 + 告警"三件套,报告才自洽。 - 把防泄题只寄托在"提示词里让模型别写答案":提示词约束是软的,模型偶尔还是会把参考答案抄进点评。改成"渲染层不带 + 发出前扫描"双保险,答案物理上就进不了报告。
- 等级/推荐让模型自己定:模型给的等级和分数对不上。等级、推荐一律查阈值函数,模型只给数字,口径唯一。
- 压分阈值想当然写 60:一开始想把 wrong 的题压到 60 以下,但 60 还是"合格"档,视觉上像"还行"。改成 54(待提升线下),让"答错了"和"待提升"严格对应。
- 报告和护栏混在一个函数里 :最早边渲染边检查,逻辑纠缠、难测。拆成
guardrails.py(管对不对)和report.py(管长什么样),各自独立可测。 detect_leak只扫报告不扫开场白 :一开始泄题扫描只跑在报告正文上,漏了polish_intro模型润色的开场白。后来把开场白也纳入"发出前扫描"的范围------凡是模型自由发挥过的文本,都要过一道detect_leak,不能有例外。
八、本篇收尾
现在整套系统的后端闭环彻底合上了:从第 5 篇接题库、第 6 篇做追问判定、第 7 篇出结构化点评、到这一篇过护栏、渲染成一份能发人的总评报告。一份报告里,分数是算术算的、等级推荐是查表的、亮点短板是去重提炼的、泄题是被拦住的------每一步都可复核、可测试,不是模型一口"发挥"出来的。
到这儿,8 篇后端全部完成。接下来就该让它"上手机"了:第 9 篇我们开始写鸿蒙端(ArkTS),先把聊天界面搭起来,让面试官的问题流式滚到屏幕上,候选人直接在手机里和它对话。 后端这些 JSON 字段,就是鸿蒙端界面要直接绑定的数据源。
最后一句:一份报告能不能发人,不看它写得有多漂亮,而看它敢不敢被追问------分数可复核、答案不泄露、结论不自相矛盾,这份复盘才真正拿得出手。