原文:mp.weixin.qq.com/s/Mc-6RlqGn...(2026年10月11日)
做 AI 应用的人常有这种直觉:监督微调(SFT)出来的模型,遇到见过的题型特别稳,一遇到新花样就开始"死记硬背"地套旧答案。
这不是错觉。有一组像"教学演示"一样的实验,把这种差别清清楚楚地量了出来。
一个"24 点"游戏,照出了"背"和"懂"
这个游戏叫 GeneralPoints,规则和大家玩过的"24 点"很像:给你四张牌,用加减乘除凑出 24,每张牌用一次。
它的精妙之处在于------训练和测试的规则故意不一样:
训练时,扑克牌里的 J、Q、K 一律当成 10 来算;可到了测试时,把它们分别当成 11、12、13 来算。这样一来,测试里必然出现训练时从没见过的数字组合,正好考察它是"真懂"还是"死记"。
结果很鲜明:
•
遇到规则变化 :RL 的准确率涨了 3.5% ,而 SFT 不升反降了 8.1%。
•
研究者还做了个"换花色"的小实验:训练用黑色牌(♠♣),测试改用红色牌(♥♦)。结果 RL 涨了 17.6% ,SFT 跌了 9.9%。
为什么会这样?一个很合理的解释是:有限的 SFT 数据,让模型死死记住了"看到 J/Q/K 就按 10 算"这条死规矩 。测试时 J 变成 11,它还是按 10 算;而 RL 更像是在反复练习中悟出了"不管规则怎么变,我都要算到得出正确答案为止"这个活办法。
更有意思的是,追踪发现:RL 甚至顺带提升了模型"看牌"的底层能力;而 SFT 因为死抠"解题步骤的文字套路",反而荒废了对牌面的识别。
当然,这只是实验中的一个普遍倾向,不是说 SFT 就只会背、RL 就一定能举一反三。
RL 到底是怎么"学"的?用一份考卷看懂
要理解 RL 为什么能举一反三,先看它一轮"训练"里到底发生了什么。今天最主流的算法之一叫 GRPO,可以用一个场景讲清。
假设给它一个任务:某段程序有个毛病(bug),请修好它,而且不许改测试。
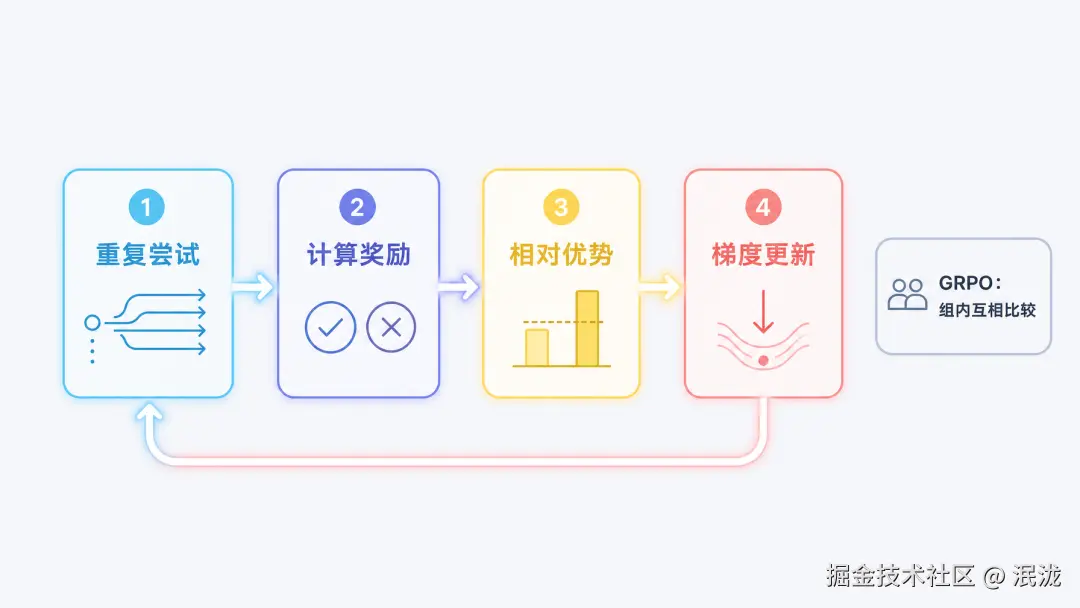
第一步:同一道题,交 16 份答卷。 系统把同样的题目和环境,复制成 16 份互不干扰的副本,让模型各自独立地做一遍。"读代码→改代码→跑测试→交卷"这完整的一遍,专业上叫一次 rollout(可以理解成"一次完整作答")。因为模型每次都有点随机性,16 份答卷的走势可能完全不同。
第二步:给每份答卷打分。 每份做完后,用一个"判卷器"(验证器)来打分。比如 16 份里有 4 份通过了全部测试、也没偷改测试文件,这 4 份得 1 分,其余 12 份得 0 分。在编程这类任务里,打分并不神秘------就是跑测试,对了给分、错了不给。(如果是没有标准答案的开放题,才需要请人来评,或者用"AI 评委"打分。)
第三步:算"相对优势"------也就是谁比谁强。 光知道每份成功还是失败还不够,还要知道它在一组里排第几 。这一组的平均分是 4/16,那 4 份通过的因为高于平均,得到"正分";12 份失败的低于平均,得到"负分"。GRPO 的精髓,就是这个"组内互相比较"。
第四步:按排名调整习惯。 把名次翻译成"该鼓励还是该打压",然后调整模型参数:让它以后多做 那些拿到"正分"的选择,少做那些拿到"负分"的选择。
关键在于:它不是在背某个具体的成功答案,而是在大量练习中,慢慢养成"遇到类似问题,先复现、再检查边界、改完要跑测试 "这样的习惯倾向。这,才是"举一反三"的真正来源。
那 PPO、GRPO、DPO 又是什么?
它们都是 RL 的具体"算法",区别主要在于------"拿谁跟谁比":
•
GRPO (G roup R elative P olicy O ptimization,组相对策略优化):让同一道题的多份答卷互相比较(就是上面的例子),简单高效。
•
PPO (P roximal P olicy Optimization,近端策略优化):额外训练一个"陪练/教练",帮它判断"这一步走得好不好",适合步骤多、需要逐步评估的长任务。名字里的"近端",指每次更新都限制在旧策略附近、不让模型一步迈得太大。
•
DPO (D irect P reference O ptimization,直接偏好优化):不自己现场做题,而是直接看现成的"好答案 vs 差答案"对比来学,最简单,但也少了探索的乐趣。
一句话:算法决定"怎么比较、怎么调整",奖励决定"什么算成功",环境和数据决定"能练到哪些题"。
一个隐蔽的坑:它可能"悄悄跑偏"
这里有个技术细节,虽然有点硬核,但它直接决定你的训练会不会突然崩掉。
理想情况下,RL 应该是"用自己当前的水平现场练习 "(专业上叫 On-policy,在轨 )。但现实中,大模型训练常常是"一台机器出卷、另一台机器判卷"。两边即便用的是同一份模型,因为计算的先后顺序、精度等细微差别,同一个字算出来的"概率"也会有一丁点不同。
这一丁点不同,会被越长越放大:一段几千字的回答里,每个字都偏一点点,累积起来就可能让整个"概率比"偏出好几倍,进而让训练剧烈震荡、甚至崩溃。
所以工程上要做的,是把它当成一件正经事来盯 :监控两边算出的概率差了多少、偏差有没有在扩大。"出卷机"和"判卷机"的一致性,要和"得分曲线"一样认真地看。
一句话总结
RL 之所以更会"举一反三",不是因为它更聪明,而是因为它优化的目标是"结果对不对",而不是"答案像不像"------这逼着它去重新推理,甚至顺带提升了底层能力。
但也别神化它:RL 又贵又容易不稳定,还有一堆"数值上的暗坑"。很多时候,它需要 SFT 先搭好台,才能唱好戏。理解了这一点,你也就不会再纠结"到底该用 SFT 还是 RL"------它们本就是一套组合拳,不是非此即彼。
本篇名词速查
•
RL(强化学习):让模型自己多试,按结果好坏调整行为,相当于"刷题复盘"。
•
rollout:模型完整作答一次的过程,可以理解成"交一份卷子"。
•
奖励(Reward):给一份答卷打的分。
•
GRPO / PPO / DPO:三种常见的 RL 算法,区别在于"拿谁来比较"。
◦
GRPO = Group Relative Policy Optimization,组相对策略优化
◦
PPO = Proximal Policy Optimization,近端策略优化
◦
DPO = Direct Preference Optimization,直接偏好优化
•
On-policy(在轨):用模型当前的水平"现场练习",而不是照着旧数据练。