原文:mp.weixin.qq.com/s/ZbTtEx_p1...(2026年10月10日)
 先问一个问题。
你花大价钱,请人标注了几万条高质量"标准答案",微调之后,模型确实"听话"了------格式规整、语气专业、流程规范。可你换个问法,它又开始胡说八道。
问题出在哪?因为你从头到尾教它的,都是"怎么说",而不是"知道什么"。
SFT 到底在教什么?答案是"规矩"
前面说过,SFT 在数学上和预训练是同一件事,只是换了数据、只对着答案算账。那它究竟把什么"刻"进了模型?
一句话:SFT 的核心价值,不在于给模型"灌知识",而在于给模型"立规矩"------把输出的格式、风格、流程固化下来,让模型以后不用你啰嗦一大堆提示,就能直接产出你想要的样式。
可以把它想成新员工岗前培训:你不需要重新教他所有专业知识,只需要教会他"我们公司的报告怎么写、话怎么说、流程怎么走"。
但这套培训有个代价:它高度依赖你给的样例。 在需要随机应变、或者实际情况和样例差很多的任务里,模型容易照搬样例里的套路,一遇到新情况就不灵了。
所以记住:任务越明确、格式越清楚、评判标准越稳,SFT 就越划算。 想让它"博学",别指望 SFT。
那,这些"标准答案"从哪来?
这是动手前绕不开的问题。业内的答案基本就三条路,实际项目中往往是组合着用:
人工写一批种子------量少但质量高,用来定标准;
让一个更强的 AI 模型批量生成------像请了一位"AI 老师"来出题、写答案,快速把量放大;
用规则或程序来筛选------像质检员,把不合格的挑掉。
不论走哪条路,流程都差不多:先想清楚任务长什么样、答案该长什么样,再批量生成,然后过滤、去重、保证多样。
有一句特别值得记住的话:数据不必贪多,几千到几万条高质量样例,通常就够立规矩了。 与其堆十万条脏数据,不如精修一万条干净数据------因为数据里的每一处毛病,都会被 SFT 原样刻进模型。就好比老师示范时写错一个字,学生很可能照着错的一直写下去。
从"真实案例"到"练习题"
直接拿线上的真实日志来训练,往往不行------里面全是客户隐私,又乱又多。更好的做法是:从真实案例里提炼出"任务的结构",再生成一批虚构但等价的练习题。
提炼的是这些东西:用户想干嘛、一开始什么状态、能用哪些工具、有什么业务规则、常见怎么失败、什么算成功。去掉身份信息后,换成虚构的人物、订单和文件,放进一个"可以随便折腾、坏了能重置"的隔离环境里。
一条靠谱的流水线是这样:
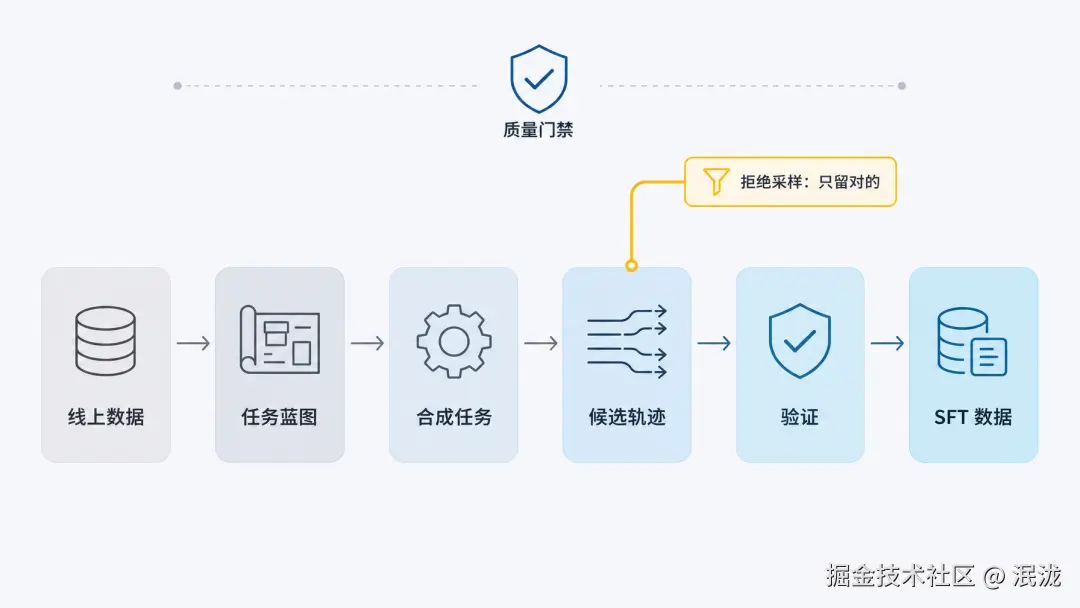 线上真实数据 → 提炼任务蓝图 → 合成练习题 → 生成多份候选解答 → 检验 → 变成 SFT 数据。
检验分两道:题目本身能不能做、难度合不合适 (叫"任务验证");给出的解答最终状态对不对、工具调用规范不规范(叫"轨迹验证")。
这里有个很关键的小动作:同一道题,让模型多答几遍,只把"验过是对的"那几遍留下来 ------这叫拒绝采样微调(RFT)。道理就像"做十遍,只把做对的那几遍抄进错题本",不用额外训奖励模型,就能显著提升数据质量,性价比很高。
蒸馏:把"学霸的解题思路"压缩进小模型
SFT 有个很强大的变体,叫蒸馏。它解决的是"能不能用更小、更便宜的模型,干出大模型差不多的活"。
有两个常见套路,方向正好相反。
套路一,Prompt 蒸馏:把啰嗦的提示"折叠"掉。 本来要让模型完成复杂任务,得写一大段几千字的提示词(既慢又贵)。这招的做法是:让大模型在完整提示下答出好答案,但训练小模型时只保留"用户的问题 + 最终结论",把冗长的提示和中间思考统统丢掉。小模型学会"直接给结论",又快又省。
套路二,CoT(思维链)蒸馏:把完整思考过程"抄"给小模型。 反过来,把强模型的完整解题思路也一起教给学生。实测下来,用这种方式,小模型能恢复大模型 70%--80% 的能力。DeepSeek-R1 发布时开源的那批小模型,走的正是这条路。
但两种套路都要小心:蒸馏会连老师的毛病一起继承。 老师如果在某类问题上系统性出错,学生也会把错误学过去;老师靠工具才答得对,学生只学"结论"就会丢掉这份稳当。
一个有意思的实验:让模型用中文"思考"
有个实验特别能说明 SFT 的边界。
大多数"会思考"的模型,其实只会用英语在脑子里盘算------不管你用中文还是别的语言提问,它内部的推理过程都是英文的,因为训练时高质量的思考样例基本都是英文。
研究者做了个实验:训练时在指令里加一句"请用德语思考",再用英、西、法等语言的思考样例来训。注意------训练数据里完全没有中文。 可训完之后,只要把指令改成"请用中文思考",模型居然就能用中文完整推理。
这个"跨语言举一反三"确实惊艳。但真相是:这不是 SFT 自己的本事。 模型在更早的多语言训练里,早就建好了各种语言之间的"公共通道",SFT 只是把这些已经有的能力"唤"了出来。
一句话:SFT 更像"把已经会的东西调出来用",而不是"教会它全新的东西"。
一句话总结
SFT 是"规章教练",不是"知识老师"。它能让模型把话说利索、把格式摆端正,但别指望它替模型补知识------那是预训练和外挂资料库的活。
而且,动手之前最该下功夫的不是算法,而是数据。因为数据里的每一处毛病,SFT 都会原封不动地刻进模型。 与其堆十万条脏数据,不如精修一万条干净数据。
本篇名词速查
•
SFT(监督微调):用"问题→标准答案"样例教模型"怎么答",重在立规矩,不在灌知识。
•
蒸馏:把大模型(或强模型)的能力,迁移进一个更小、更便宜的模型。
•
思维链(CoT):模型答题前先一步步推理的过程。
•
拒绝采样微调(RFT):一道题多答几遍,只留下验过是对的那些,当训练数据。