给 H3-World 叠加 Turbo,动作 LoRA 为什么还要重新验收?
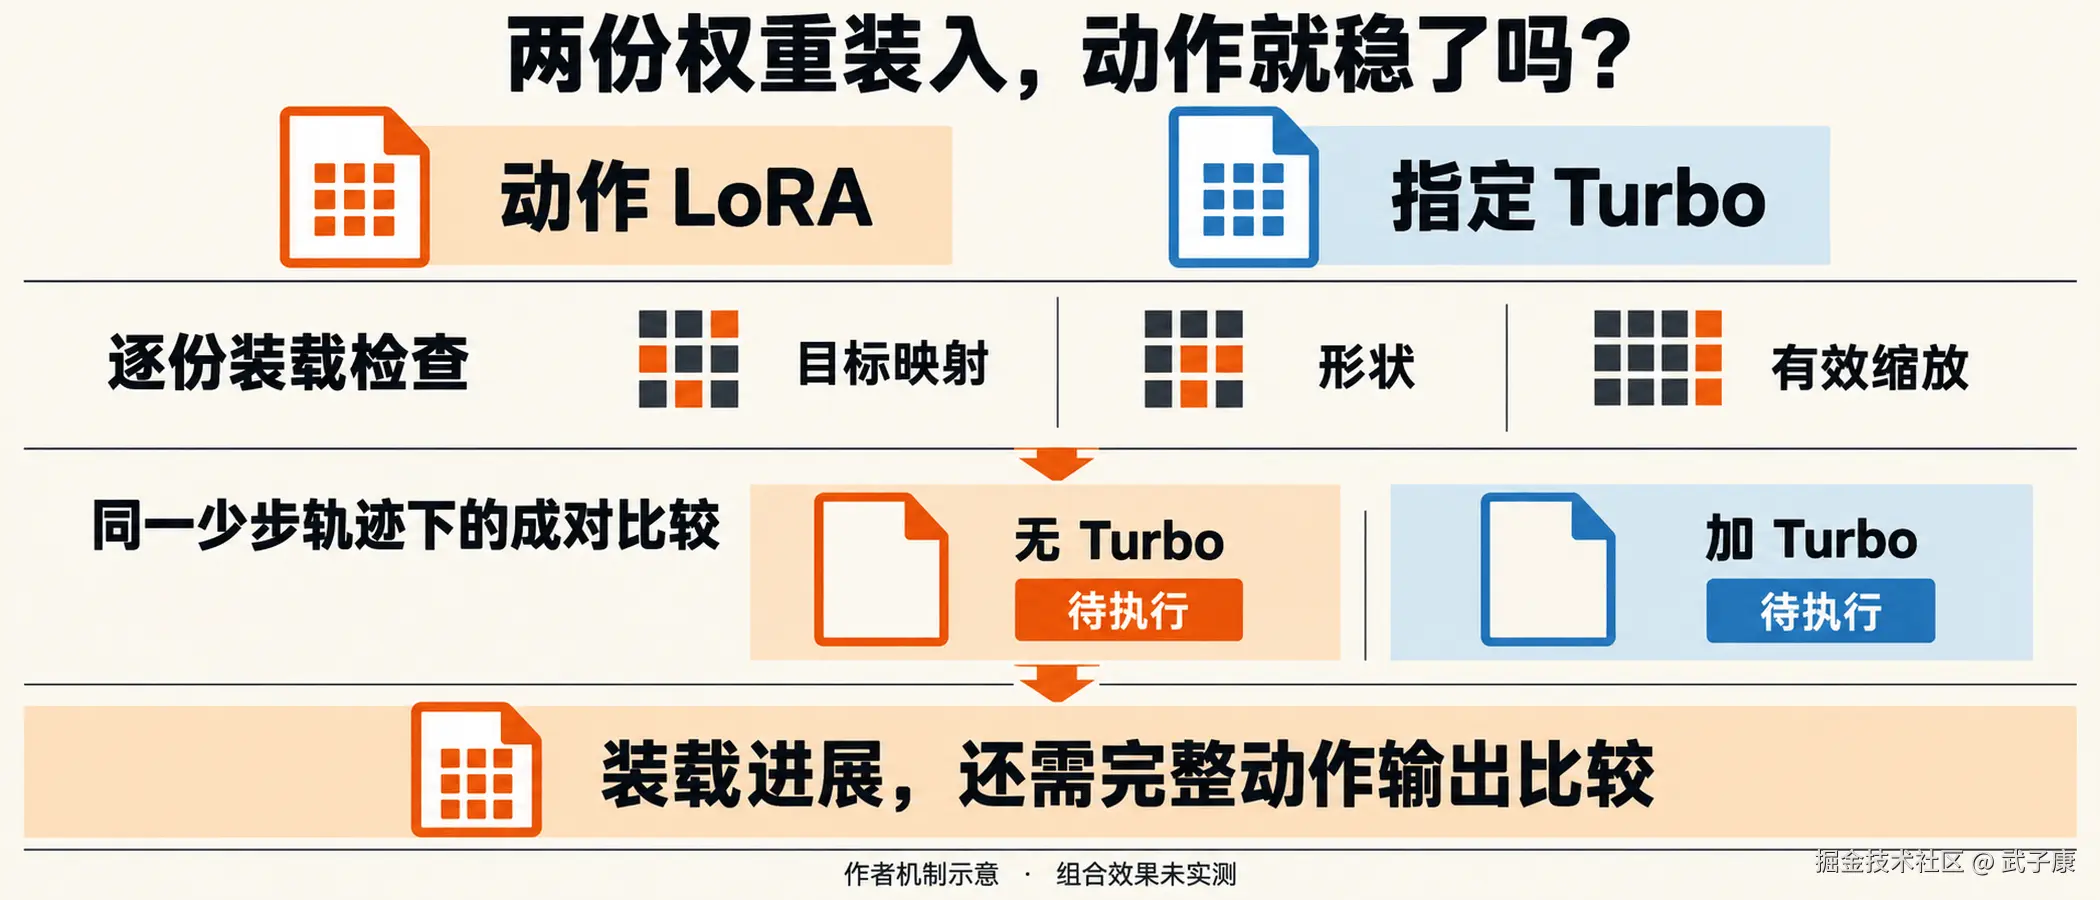
作者机制示意或待执行比较安排;没有组合效果或GPU实测。
你已经按 H3-World 的参考脚本接好首帧和动作 LoRA,接下来想缩短等待时间。最直接的念头是:把默认 50 步改成 4 步,再加一份同样基于 MiniMax-H3 的 Turbo LoRA。两份文件都是低秩增量,似乎只差再调用一次加载函数。
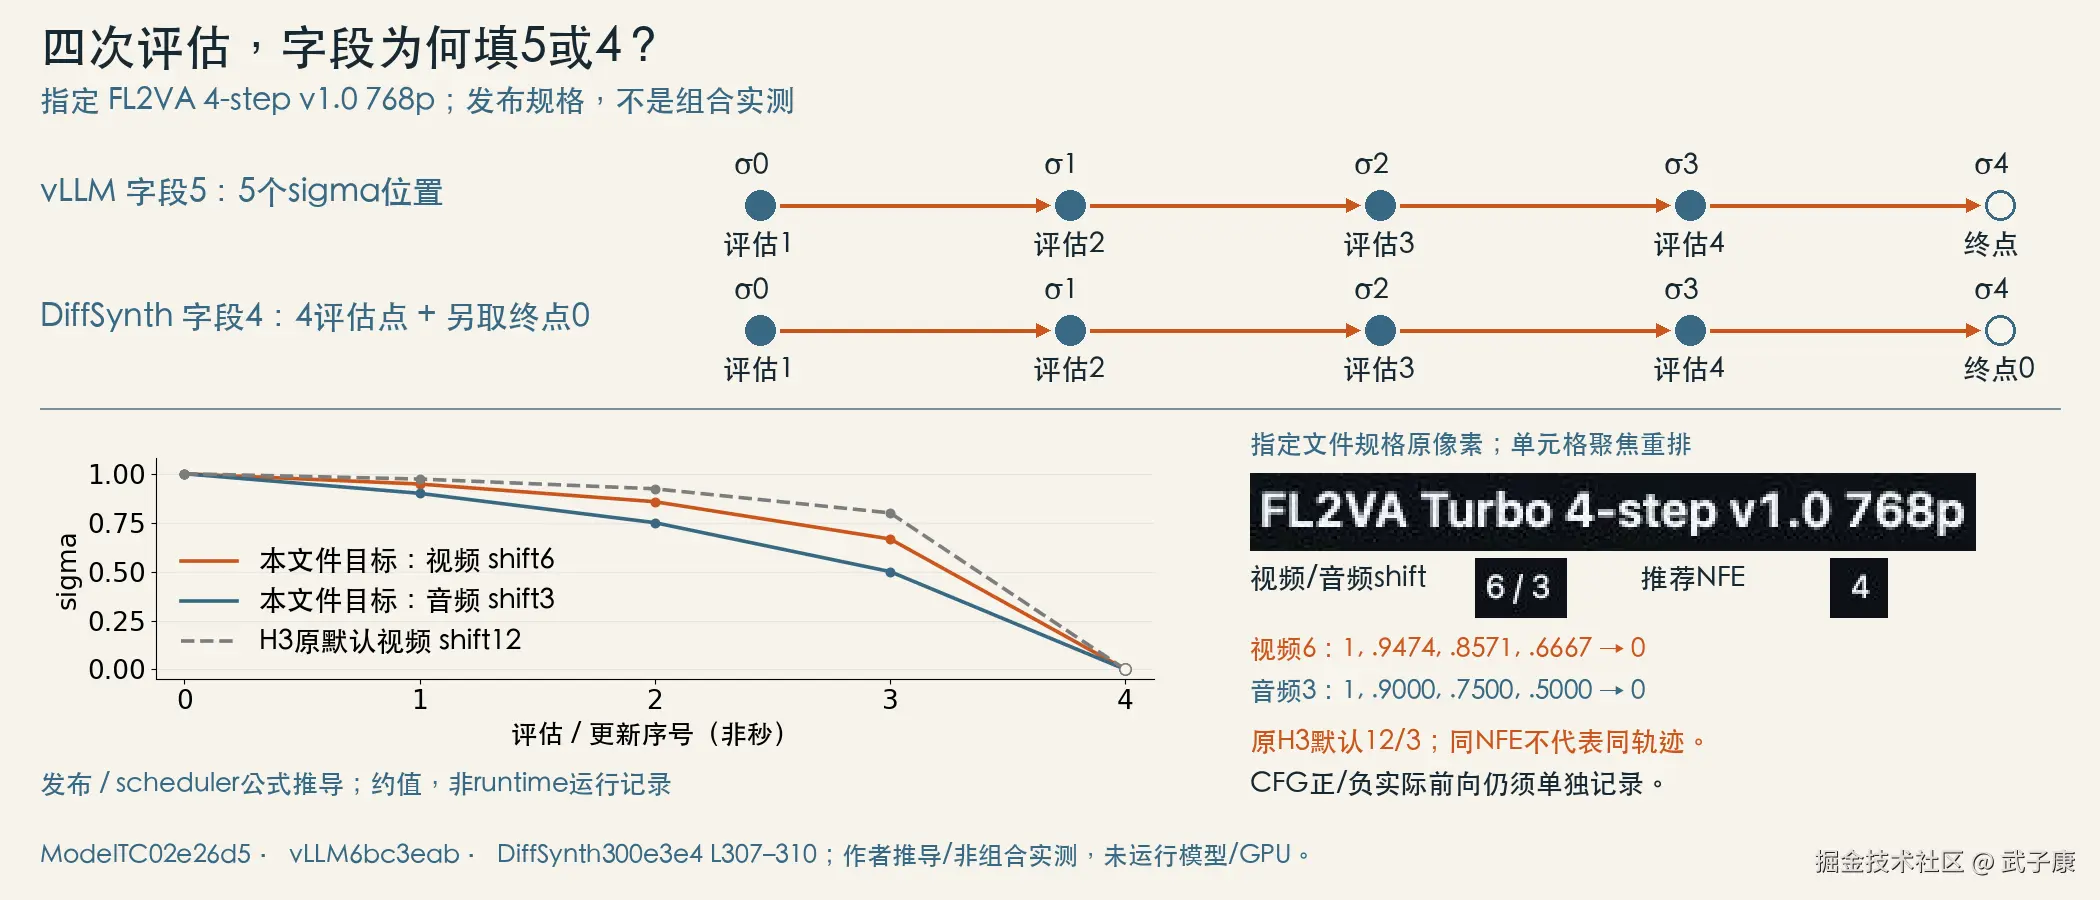
但这里有个很具体的陷阱:同一款 4-step Turbo,在发布方规格里表示四次 Transformer 评估,在当前 vLLM-Omni 接口里却要填 num_inference_steps=5,因为那条路径按五个 sigma 位置构成四次评估。把界面上的数字原样抄到另一套 pipeline,连实际执行几次去噪都可能不一样;何况还没有检查动作权重是否完整接入。
这不是证明 Turbo 与 H3-World 一定冲突。本文要回答的是:怎样把"能装两份权重"推进成一次可以解释的动作加速比较? 结论是先对齐具体权重文件、采样轨迹和动作执行路径,再做成对控制对照。少步数和第二份 LoRA 应分别改变,不能用一次成功出片替两项变化共同验收。
以下是固定源码与发布说明核对,核对日为 2026 年 10 月 17 日。没有下载权重、导入供应商模型代码或运行 GPU,文中的比较安排尚未执行,因此没有组合成功率、控制退化或加速倍数。
先弄清这份 Turbo 的"4 步"在哪里发生
固定官方页面聚焦原像素;证明规格或局部源码,不是组合运行结果。
Turbo 不是一个只决定速度的通用布尔值。LightX2V 发布方的规格按文件区分 FL2VA/T2VA 与 Ref2VA、四步与八步、544p 与 768p版本,并分别列出视频和音频的 shift。H3-World 参考推理装载的是 FL2VA 路径,不能因为都叫 H3,就拿 Ref2VA 的文件代替。
一个足够具体的候选是 minimax_h3_fl2v_turbo_4step_v1.0_768p_bf16.safetensors。发布方给它列出的训练分辨率为 1344×768、视频/音频 shift 为 6/3、推荐 NFE 为 4。这里列的是发布方的规格,不代表 H3-World 已在这个尺寸验证;其参考脚本默认生成尺寸是 832×480。换用这一文件时,尺寸与训练条件的差异也要保留,不能顺手改尺寸再把所有差异归因于动作 LoRA。固定版发布规格
发布规格还给出了四次评估的网格:q=[1,0.75,0.5,0.25],经过相应 shift 得到 sigma,最后更新到零。视频 shift=12 的示例产生约 [1,0.9730,0.9231,0.8000]→0;音频 shift=3 则是 [1,0.9,0.75,0.5]→0。这些位置决定模型在哪些噪声水平预测,以及每次更新跨越多大间隔。数字同为四,并不自动保证两条实现走的是同一条轨迹。
对上述 768p v1.0 文件,当前 vLLM -Omni 的规格表把 Forwards=4 与 num_inference_steps=5 明确分列,同时要求 flow_shift=6、音频 shift=3。它还区分 Diffusers 布局和 ComfyUI 的融合 Q/K/V 导出;后者在这一集成路径中会按文件名拒绝。这个约束说明的是这套 runtime 接受什么,并不是所有 runtime 都必须拒绝 ComfyUI 文件。固定版 vLLM-Omni Turbo 说明
再回到 H3-World 指定的 DiffSynth 基础实现:set_timesteps_minimax_h3() 用 num_inference_steps+1 个等距点去掉末尾零,得到恰好 num_inference_steps 个评估点。循环遍历这些 timesteps;最后一次更新由 scheduler 单独取终点零。因此在这条路径里,参数 4 对应四次去噪循环,直接抄入 5 会变成五次,且中间采样位置也不同。固定版 FlowMatchScheduler
这里的"去噪循环次数"也要与底层模型前向次数区分:H3-World 默认 cfg_scale=1,基础 CFG 分支只计算正条件;改成非 1 时,会额外计算负条件。比较性能时应同时记录实际循环数、视频/音频 sigma 序列与正负分支次数。仅记录"steps=4",无法描述一次请求实际干了什么。
由此能得到一个立即可用的判断:减少参考脚本的 --steps,是在原 scheduler 上改变评估点;使用 Turbo,则还要接入针对少步轨迹训练的权重与对应设置。前者不会因为数字变成 4,就自动完成后者。
加载函数能累加增量,参考入口仍然只验一份动作权重
固定官方页面聚焦原像素;证明规格或局部源码,不是组合运行结果。
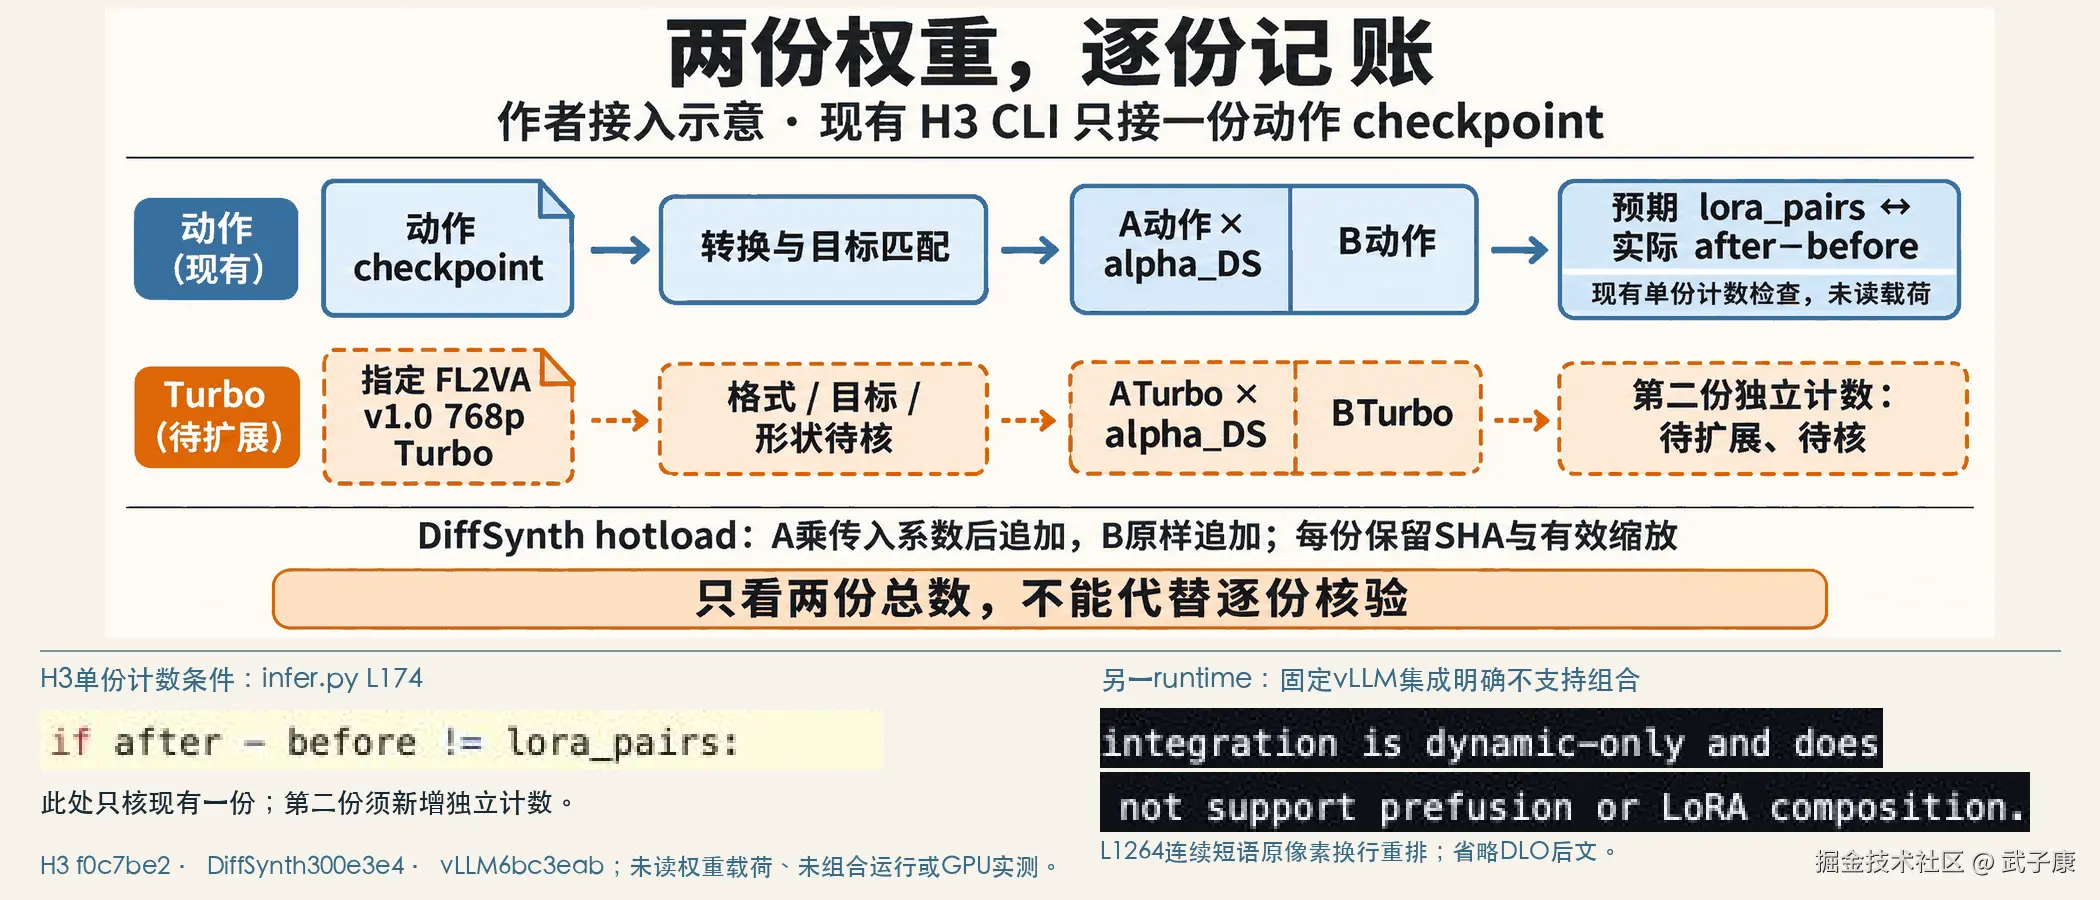
H3-World 的推理入口只接收一个 --checkpoint。它读取后筛出 .lora_A. 和 .lora_B. 权重,遇到其他张量会拒绝;接着调用 pipe.load_lora(..., hotload=True),比较挂接前后的 A 权重数量,要求增量等于 checkpoint 中的 LoRA 对数。这是很有价值的装载检查,但范围是这一份动作 checkpoint。固定版 H3-World 推理入口
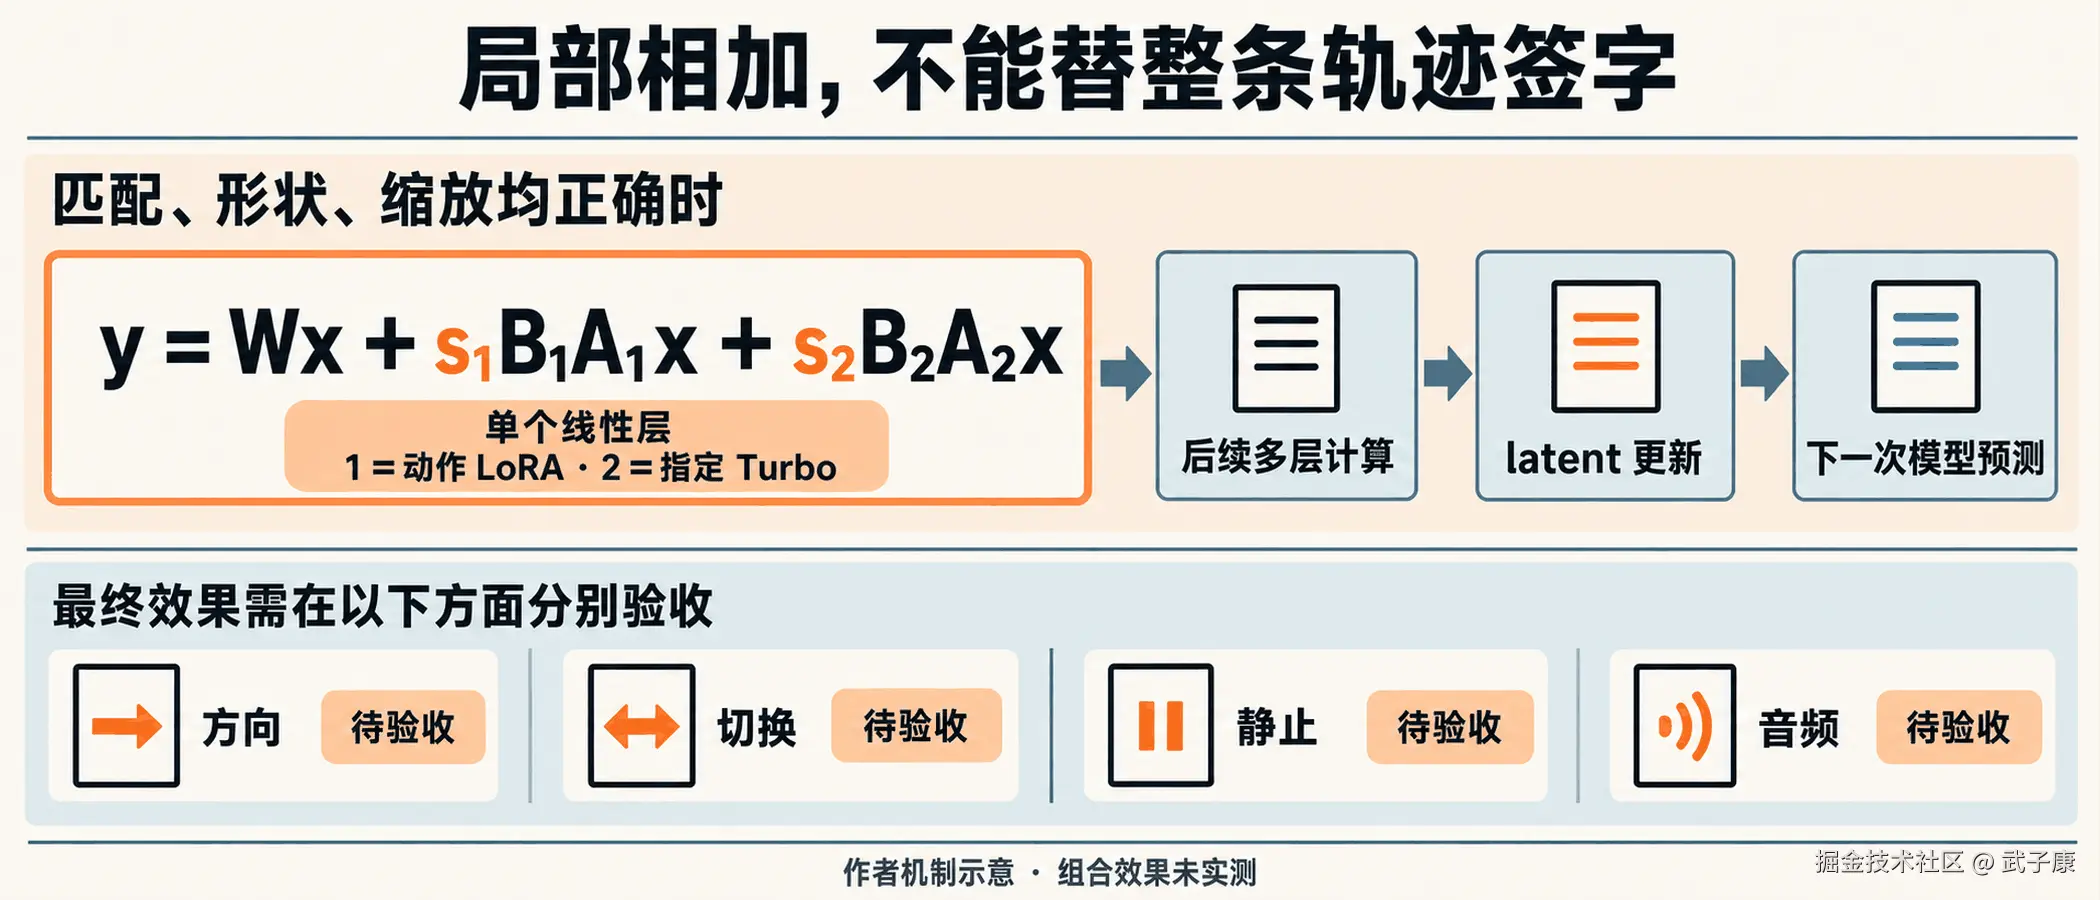
指定 DiffSynth 的 hotload 实现会把匹配模块的 A、B 分别追加到列表。没有自定义 merger 时,线性层逐对计算增量并加到输出上。对已经匹配、形状兼容、缩放正确的两组普通低秩因子,可以把这一行为写成简化的线性层关系:
y = Wx + s₁B₁A₁x + s₂B₂A₂x
这个关系解释了两份低秩增量为何有可能共存,却没有证明任意 Turbo 文件都能被当前转换器正确识别。文件命名空间、投影拆分或融合、每层目标、矩阵形状与缩放都需要逐项对上;某一份文件能在另一套 runtime 装载成功,也不会替这里的映射负责。固定版加载与追加逻辑与线性层增量计算
缩放尤其容易被一个相同的"strength=1"掩盖。当前 vLLM-Omni 的 Turbo loader按具体文件识别规格,其说明把实际增量写为请求 scale 再乘 alpha/rank,并区分文件的 alpha。DiffSynth 这里则将传入的乘数用于追加的 A;不能直接假定两个 API 中名为 alpha、scale 或 strength 的参数拥有相同语义。验收应保留最终有效乘数与推导来源,不能只保留 UI 数字。本文没有读取实际权重张量或元数据,发布说明中的 rank/alpha 也没有变成本地载荷检查结果。
同样值得区分的是 runtime 的能力边界。当前 vLLM-Omni 文档列出多种 Turbo 文件,但仍明确这条集成是动态路径,不支持 LoRA composition。它能服务基础 H3 的 Turbo,并不能据此推出可同时服务 H3-World 的动作 adapter。反过来,DiffSynth 列表可以追加增量,也不能推出它已经提供面向所有 Turbo 导出的完整接入实现。两条路径各自说明一部分事实,不能拼成"公开方案已验证组合"。
因此,若将来扩展 H3-World 入口,至少要分别记录动作与 Turbo 的预期/实际目标数、未匹配键、形状、有效缩放和文件 SHA。原来的动作挂接计数要保留,同时新增第二份权重的独立计数;把两者混成一个总数,会掩盖"一份多挂、另一份少挂"之类的错误。是否需要转换权重应由具体格式差异决定,不应先把一种导出格式当作通用格式。
相加发生在线性层,动作是否保留要看整条去噪轨迹
作者机制示意或待执行比较安排;没有组合效果或GPU实测。
即使装载与缩放都正确,线性层的加法仍然只是局部计算。它位于一个多层、含非线性与注意力操作的 Transformer 中,前一层输出会改变后一层输入;每次预测又参与下一次 latent 更新。两组参数增量能相加,不能推出两套训练得到的功能在最终视频中互不影响。
H3-World 的动作条件也不只是另一句全局 提示词 。固定补丁把逐 latent 的动作句编码,记录动作文本 span,并把这些信息送入带定向 mask 的模型路径。参考推理还显式核对导入的是否是预期补丁版本。这个动作路径应在加速比较中保持,因为一旦换回基础 H3 的普通注意力,测到的已经不是同一个动作控制方案。此处只引用与组合有关的接口,动作时间绑定和 mask 的完整推导见前篇,不再展开。
Turbo 的通用视频样例,主要说明发布方给定输入与采样设置下的输出;其中并没有替你验证 H3-World 的逐动作绑定、反向切换和静止控制。即便一段组合视频清晰、音轨存在,也可能尚未回答"该向左的这一段是否真的向左"。这是验收对象不同带来的缺口,不是本文观察到了动作已经退化。
减少评估点后,每次 latent 更新跨越的 sigma 间隔会改变。若两份 adapter 组合影响某些时间区间的条件响应,结果可能反映到动作幅度、反向切换或静止漂移;这些都是待验证假设,不能写成已发生的现象。也不能把一次异常直接归因于"同层 LoRA 冲突":错误映射、缩放、sigma 设置或动作输入,都可能造成相似表面结果。
一个更简单的替代方案,是先仅在动作参考路径降低步数,观察自己的工作负载是否已经可接受。这样少一次权重适配工程,但依然需要动作质量比较,不能假定多步模型在少步设置下等效。如果这一结果已经满足需求,就没有必要为了"Turbo"这个名字继续叠加复杂度。若不满足,再评估特定 蒸馏 权重,才知道它试图解决哪一个实际缺口。
用一张成对比较记录,区分步数变化与第二份权重
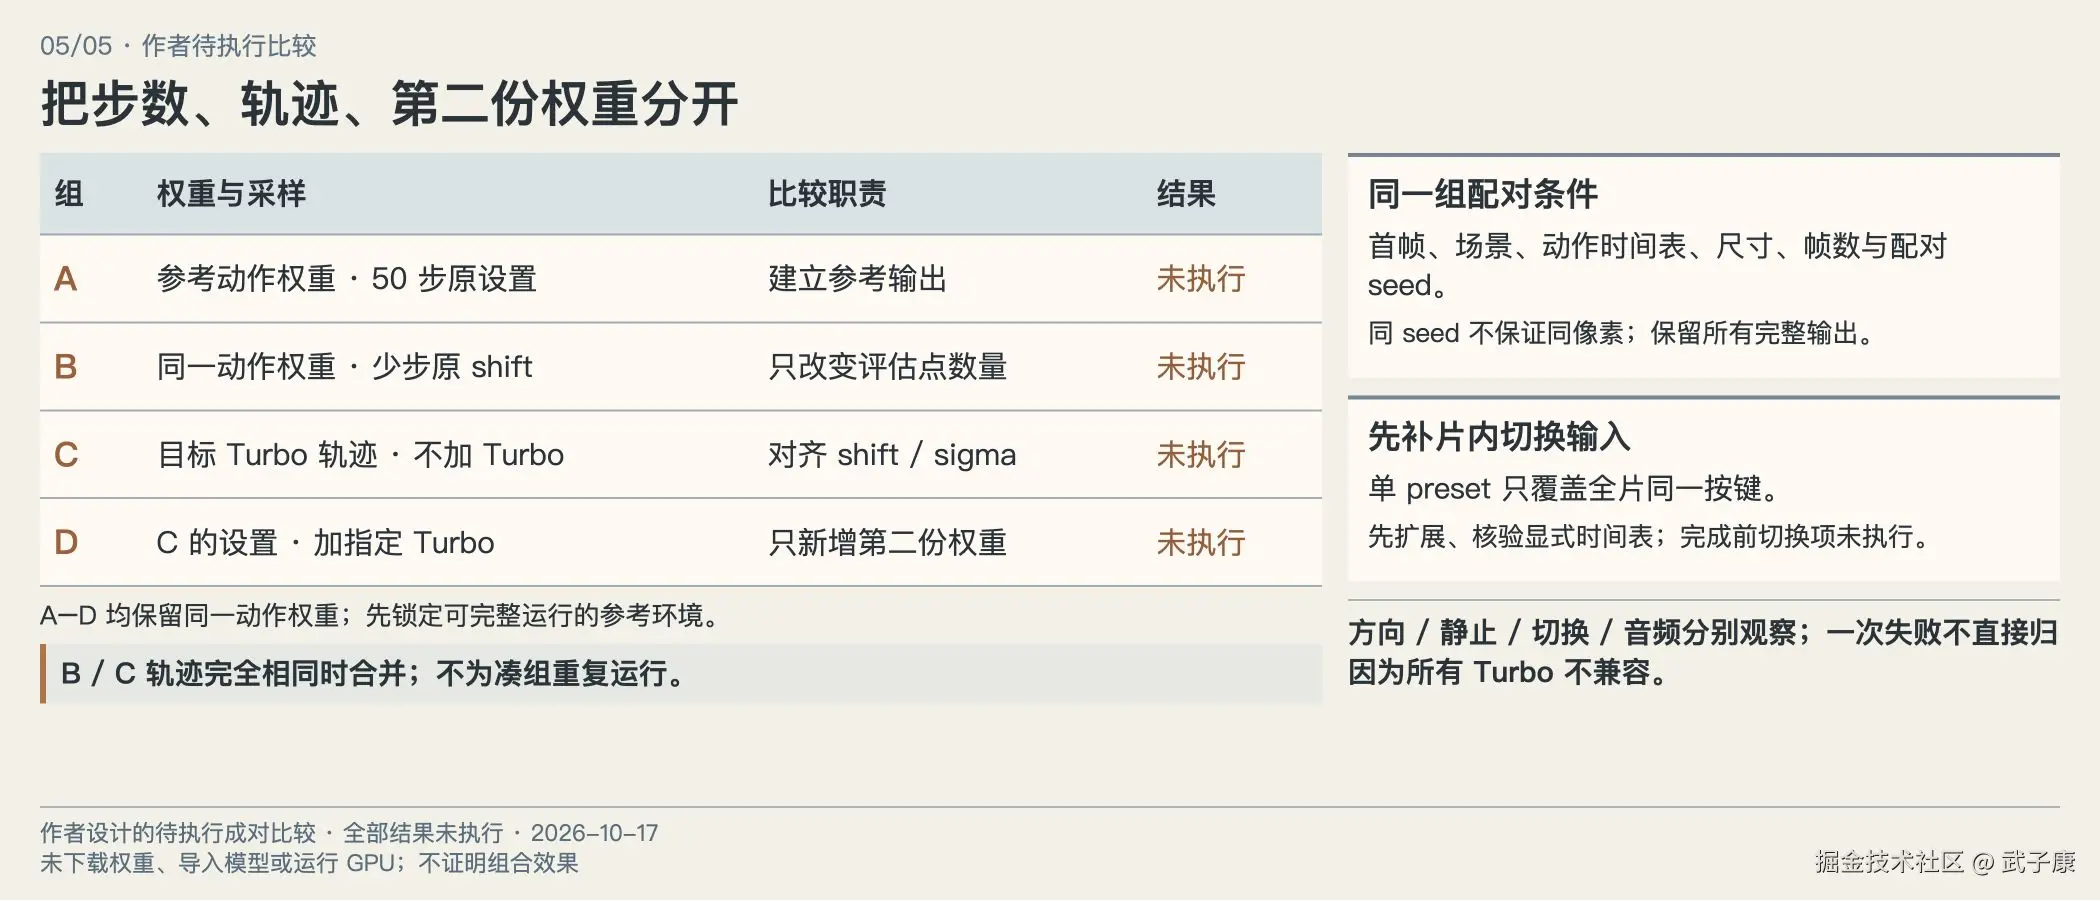
作者机制示意或待执行比较安排;没有组合效果或GPU实测。
下面给出作者设计的待执行比较安排。它不是现成官方 benchmark,也不预设哪一组会赢。首先锁定一个可完整运行的 H3-World 参考环境;若原路径尚不能完成,先保留失败阶段,不能跳过基线,用另一套能够出片的 runtime 代填。
| 组别 | 权重与采样 | 要回答的唯一变化 | 本次结果 |
|---|---|---|---|
| A | H3-World 动作权重,参考 50 步与原设置 | 参考动作路径能否完成,输出如何 | 未执行 |
| B | 同一动作权重,只减少评估点,保留原 shift | 步数改变本身带来什么 | 未执行 |
| C | 同一动作权重,在目标 Turbo 轨迹上运行,不加 Turbo 权重 | 对齐目标 shift/sigma 后的无 Turbo 对照 | 未执行 |
| D | C 的设置加上指定 Turbo 权重,其他输入一致 | 在这一少步轨迹上,第二份权重改变什么 | 未执行 |
若 B 与 C 的轨迹完全相同,可以合并,不为了凑四组重复运行。若要单独验证 Turbo 导出是否接对,可增加无动作 adapter 的基础模型对照,但它不能替 A--D 的动作验收。768p Turbo 与参考 832×480 存在差异时,先明确你验证的是目标尺寸的迁移,还是发布方配置复现;两种问题都可以做,但不能混写为同一结论。
每组使用相同首帧、场景、动作时间表、分辨率、帧数和一组配对 seed,保留所有完整输出。相同 seed 只负责配对随机条件,不保证不同模型轨迹产生相同像素;一次 seed 通过也不代表总体稳定。冷启动、条件编码、去噪、解码和完整输出耗时分别记录,确认缓存、卸载与编译设置未同时变化。文中没有给出应当跑多少个 seed 的统计保证,实际样本量应随要宣称的结论确定。
动作场景至少应覆盖:持续向左与持续向右、静止,以及先左后右和先右后左。这里有一个实际限制:参考 CLI 的 --action-preset 会把同一按键组合复制到全片,不能直接表达片内反向切换。切换场景需要在原动作脚本接口上增加显式时间表输入,保留每个 latent 的动作句及映射;在接口完成与核验之前,切换项应继续标为未执行,不能拿两段独立片段冒充一次片内切换。
观察时,把期望动作区间与视频时间轴对齐:左右段的运动方向是否一致、反转之后何时出现持续方向变化、静止段是否持续漂移,并单独观察动作幅度和画面身份。音频也要单列连续性、噪声和明显异常,不能因为文件含音轨就判音频质量通过。方向可借助光流和人工复核,但对象运动、镜头转动与遮挡会混淆同一指标,应预先定义目标与标注规则,而不是把所有场景塞进一个"动作成功率"。这些是采集要求,本次没有测量值。
这张记录最有用的地方在失败解释。A 到 B 发生变化,说明原模型对更少评估点的响应值得调查;B 到 C 变化,要回看目标轨迹;C 到 D 变化,才把关注点缩小到第二份权重及其装载、缩放和组合计算。即使 D 不满足预先约定的动作标准,也只能证明这组文件、参数与输入下不满足要求,不能直接宣布"所有 Turbo 都不兼容"或"必须联合训练"。联合蒸馏可以是后续研究选项,其成本和收益仍需要另行证据。
最终,接入判断可以说得很具体:你知道是哪一份 Turbo、实际走了哪些 sigma、两份增量分别挂到了哪里,也有同一少步轨迹下加与不加 Turbo 的动作对照,才有依据把一次出片描述为一次可解释的加速尝试。在此之前,"两份 LoRA 都能加载"是重要的装载进展,距离"动作控制在加速后仍满足要求"还缺完整的输出比较。
来源与核验范围
H3-World 固定版本为 f0c7be2acbbde8256b2473f6e7b088f58272acae,基础 DiffSynth 为仓库指定的 300e3e4da76e881d5e6bd97d897810c18f6e4893。动作补丁只做文本应用与静态检查,没有导入运行。Turbo 发布规格固定于 ModelTC 02e26d591f7a04d5d1a074c9566d5dd4f22f6225,模型卡快照为 a29e57d195f80ead07c89f89e55ecf2911e893c5;vLLM-Omni 集成说明固定于 6bc3eabd26e6d7fb78601fbbd775e75a50ddd81d。这些约束不能外推为未来所有版本。
原始研究笔记中的显卡耗时、缓存收益、Turbo 组合质量与"联合蒸馏最可靠"等推断,没有作为本篇事实。本文也没有验证权重载荷、真实中间张量、成片质量或 A6000 性能;读者表格中的全部结果保持未执行。