原文:mp.weixin.qq.com/s/lEF1nq0dw...(2026年10月09日)
想象一下:你请了一位"全能家教",他上知天文、下知地理。可当你让他用法语写文案、按公司模板填表,或者做一道他从没见过的题时,他要么答错,要么干脆"编"一个。
这时候很多人的第一反应是:给他"补课"(训练)一下,尤其是上强化学习。
先等等。同样一句"补课",其实可能是三种完全不同的病:有的是没学过(缺知识),有的是不会按要求答(缺规矩),还有的是会答但不稳、没见过新花样(缺技巧)。 药不对症,花再多钱也没用。
这篇文章要做的,就是帮你把"模型做不好一件事"这件事,拆成上面这三种病,然后对号入座。
先搞懂一个词:模型到底在"干什么"
要理解后面所有内容,只需要先明白一件事:大模型最核心的工作,叫 "预测下一个词"。
给它一句话的前半段,让它猜下一个"词"是什么。这里的"词",专业上叫 token(词元) ------你可以把它想成一块块乐高积木:一段文字会被拆成小块,"我喜欢编程"可能被拆成"我""喜欢""编程"三块。
模型每猜一次,就拿自己的答案跟"标准答案"比一比,差距越大,就越用力地调整内部参数。这个"差距",专业上叫 损失(Loss) ,你就把它理解成考试里答错的扣分。
在几万亿字的互联网文本上反复做这件事,模型就慢慢学会了语法、常识和基本推理。这里有个关键点,后面会一直用到:模型每次的输出,本质上是"一长串候选词各自的概率"------就像一次投票,它给每个可能的词都打了分。所谓"训练",做的就是把"我们想要的词"票数调高、"不想要的"调低。
后面的四个阶段,区别只在于:我们想要什么,以及用什么信号来定义"想要"。
一个模型,是怎么"长大"的?
现代模型的能力,通常分四步练成。用"一个人求学"来类比最好懂:
① 预训练(Pre-training)= 读完图书馆所有的书。 在海量互联网文本上做"预测下一个词"。这一步让模型学会语言规律、世界知识和基本推理。结果是:博学,但还不太会好好回答问题。 这是最贵的一步,动辄几千万美元。
② Mid-training(中期训练)= 集中研修专业教材。 从一个已有基础模型出发,在目标语言、领域文档、代码等数据上继续"预测下一个词",补上通识教育没覆盖的"教材章节"。可以理解成一个针对某门专业的强化补习班。
③ SFT(监督微调)= 老师手把手示范标准答案。 用几千到几万条"问题---标准回答"的样例,教模型该用什么格式、什么语气、什么流程来回答。它把"博学但话说不利索"的模型,变成"听得懂指令、输出规整"的助手。
④ RL(强化学习)= 自己下场刷题、按得分复盘。 不再照着标准答案抄,而是让模型自己多试几次,把做得好的行为概率调高、做得差的调低。
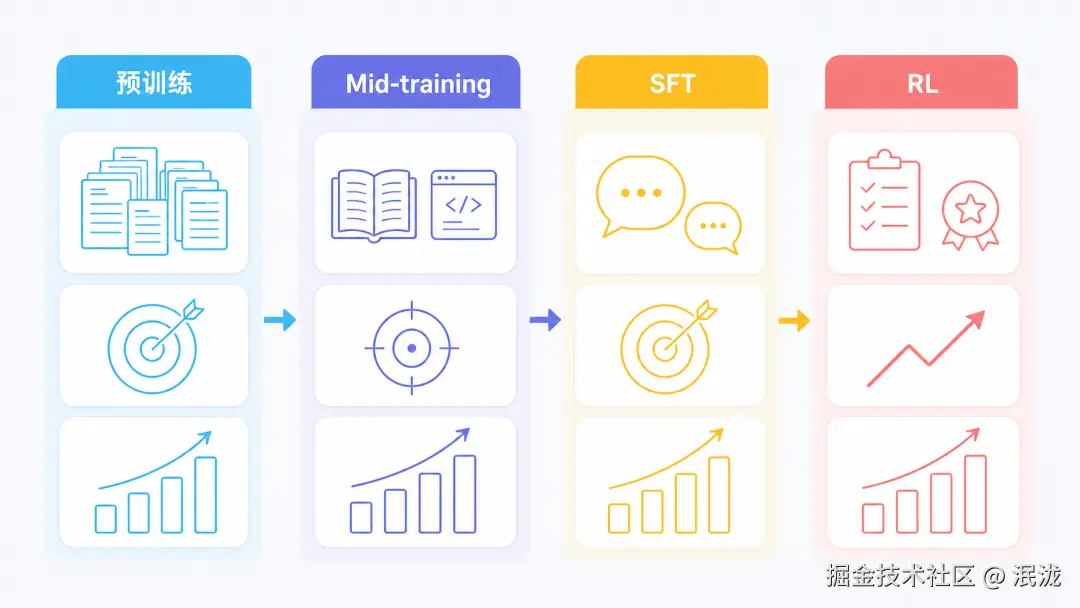
四个阶段用的数据、优化目标、代价都不一样------这就像"读书、补习、模仿老师、自己刷题",看着都叫"学习",其实完全不是一回事。
SFT 的秘密:它和预训练其实是同一件事
这里有个很多人都会误解的点:SFT 不是什么黑科技。从数学上看,它和预训练干的是同一件事------都是"预测下一个词"。
差别只有两处。
一是数据变了。预训练用的是杂乱无章的互联网文本;SFT 用的是精心准备好的"问题+标准答案"。
二是只对着"答案"算账 。一条 SFT 样例包含"问题"和"回答"两部分。我们不希望模型学"怎么提问",只希望它学"怎么回答",所以在算损失的时候,把问题部分"捂住",只对回答部分扣分、纠正。
打个比方:老师批改作业时,只针对学生写的答案(而不是题目本身)打勾打叉。这就是 SFT 在全流程里唯一实质性的特殊之处。
所以 SFT 的本质是:用很小的代价,把一套稳定的"输入→输出"习惯刻进模型 。它刻进去的是"格式、风格、流程"这类规矩 (该怎么说、怎么做),而不是大量事实知识(知道什么)。想让模型"知道更多",得靠预训练或者外挂资料库。
SFT 和 RL,到底差在哪?
这是全篇最值得记住的一组对比,一句话:SFT 靠"背",RL 靠"练"。
为什么?因为两者的目标不同。SFT 追求的是把标准答案复现得越像越好 (就像背课文);RL 追求的是把能拿到高分的做法概率调高(就像刷题找规律)。
再换个说法。一道题往往有好几种合理答法,每种答法就像"投票"里的一个高票选项。SFT 会尽量把训练里见过的几种答法都学会、都覆盖 ;RL 则倾向于把票集中投向那几个得分最高的答法。
于是就有了各自擅长的场景:SFT 擅长把"已知的多种标准写法"都覆盖住,RL 擅长从一堆尝试里"挑出最优做法"。
用一个生活化的比喻:SFT 是"照着地图认真学",RL 是"拿着奖励这枚指南针去探索地图外的路"。地图和指南针,有一个不准都会迷路。
(补充一句:说"SFT 会背、RL 会举一反三",是实验里的普遍倾向,不是铁律。数据足够多样时,SFT 也能举一反三;奖励设计得不好,RL 一样会钻空子走歪。)
实战:先"诊断",再"开药"
所以,面对"模型做不好",正确的姿势不是马上挑算法,而是先看病、再开药:它缺的到底是知识、规矩,还是技巧?
•
某个领域概念或基本操作,它压根不会 (比如完全看不懂某种语言、某类专业文档)→ 缺的是知识 ,该做 Mid-training(如果是需要经常更新的事实,则用外挂资料库)。
•
它偶尔能答对,但格式乱、工具不会调、语气不稳 → 缺的是规矩 ,用 SFT。
•
它已经能有几次答对,但好答案出现得太少、遇到新情况就失灵 → 缺的是技巧 ,这才轮到 RL 上场。
把它整理成一句更好记的口诀:
先看能不能不改模型就解决(有些问题靠优化提示词、加工具、管好上下文就行,根本不用训练;事实老是要更新的,用外挂资料库)。
再看它"偶尔能不能答对"(专业上叫看 pass@k------让你多试 k 次、至少对一次的几率。如果试很多次都对不了,说明是真不会,先去补课)。
能答对但答不规范,就用 SFT 立规矩------别指望用它来硬灌知识。
只有在"会做但做得少"时,才用 RL 去把好做法放大。
最后,记住两条比算法更重要的事
这个顺序不是说每个项目都得从头到尾跑一遍。强一点的模型可能直接进 RL,纯粹练格式的任务可能只要 SFT,稳定的领域知识可能只做 Mid-training 就够。关键是每一步都有明确、可检验的"进门条件",而不是把"预训练→Mid-training→SFT→RL"当成必须走完的仪式。
而全篇最反直觉、也最值钱的一条经验是:数据和环境,比算法重要得多。
选 PPO 还是 GRPO(后面文章会讲,都是 RL 的具体算法),其实关系不大;真正决定成败的是三件事:补课的教材(Mid-training 数据)齐不齐、示范样例(SFT 数据)好不好、练习的环境和打分(奖励)靠不靠谱。很多情况下,前两样做好了,你根本用不着做 RL。
所以下次想"是不是该微调了",先别急着挑工具。把"它做不好"这句话拆开看:是不知道、不会说,还是不稳? 想清楚这一点,你就已经超过大多数人了。
本篇名词速查
•
token(词元):模型眼中最小的文字"积木"。
•
损失(Loss):模型答案和标准答案之间的差距,像考试扣分。
•
预训练:在互联网海量文本上"预测下一个词",相当于打地基。
•
Mid-training:用专业/领域数据继续预训练,相当于"补专业课"。
•
SFT(监督微调):用"问题→标准答案"样例教模型"怎么答"。
•
RL(强化学习):让模型自己多试,按结果好坏调整行为,相当于"刷题复盘"。
•
RAG:给模型外挂一个可随时查阅的资料库,适合经常更新的事实。