原文:mp.weixin.qq.com/s/x1XT1Ch2u...(2026年10月08日)
 有一组对比,你看完可能会愣一下。
正常人说话的速度,大约是打字的四倍。
而且说话不占用你的双手,也不占用你的视线。
这意味着什么?
意味着当你手上正忙、眼睛正盯着别处时,语音几乎是唯一还能高效输入输出的通道。
所以语音的价值,从来不只是"把文字换成声音"那么简单。
它真正在做的事,是把 Agent 放进一个持续工作、随时可能被打断的回路里。
从"你打字它回字",变成"你说着,它听着,随时能接话"。
这一篇,我们看语音 Agent 的三次进化,以及一个更深的问题:边听边说,和深度思考,能不能同时做到?
三次进化:从级联,到全模态,到全双工
语音系统的架构,大致走了三个阶段。它们不是简单的新旧替代,而是不同约束下的取舍。
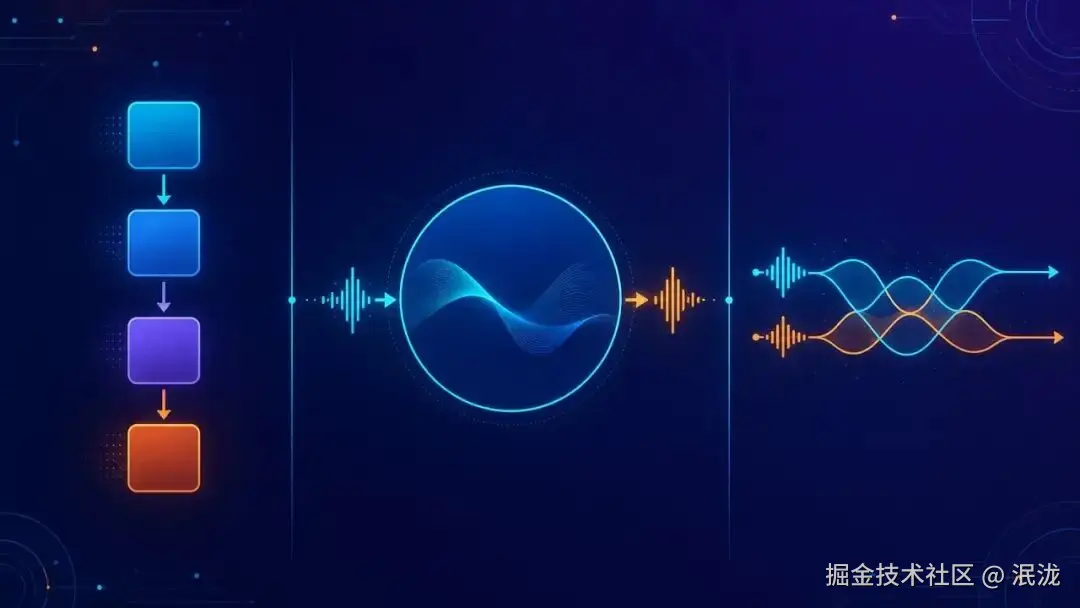 范式一 · 级联流水线。
这是绝大多数商业语音助手的老路:VAD → ASR → LLM → TTS.
先判断你说完没有(VAD),再把语音转成文字(ASR),再让语言模型理解和生成(LLM),最后把文字念出来(TTS)。
好处是模块清晰、好替换、好调试。坏处也很直接:每一级都在累积延迟,而且语气、情绪这些副语言信息,在转成纯文本的那一刻就丢了。
更麻烦的是,静音阈值会带来等待和误切分;人名、邮箱、专有名词也可能被分片识别而出错。
范式二 · 端到端全模态(Omni)。
用同一个模型,直接听音频、生成回复、再输出语音。
于是它有机会保留语气、情绪和环境声,延迟也更低。
但它仍然假设"轮流说话",通常还得靠 VAD 来判定发言权------你说一串数字,中途停顿一下,照样可能被误判成"说完了"。
范式三 · 全双工。
它不再预设轮次,而是持续听、持续说,并不断决定:继续、停顿、打断,还是调用工具。
2024 年 Kyutai 的 Moshi 是研究上的先声------它并行建模用户和模型的音频流,让重叠说话和打断,成为模型的自然行为。
Thinking Machines Lab 把这条路线称为交互模型 :交互性不再靠外挂的 VAD 拼装,而是内建在模型里。 它甚至可以把完整对话委派给后台的推理模型,自己继续维持话头。
OpenAI 的 GPT-Live 则把全双工带到了生产规模:持续处理输入输出,能等待、能附和、能被打断,还能做实时翻译。
一句话总结这三次进化的主线:
如何摆脱"轮流说话",以及摆脱对"该谁说话"的猜测。
更深一层:快思考回应,慢思考回答
语音交互还有一个矛盾,绕不开:
"交互表现"和"智能上限",是两个维度。
前台模型要在你还"在线"时及时回应;后台模型则可以花更多时间深思。
这两种需求怎么调和?有三种方案,是设计取舍,不是线性迭代。
方案一:快思考回应,慢思考回答。
快的一边在几百毫秒内先给个即时回应,慢的一边在后台做更深的推导。
问题是:简单问题被重复处理,复杂问题还可能前后矛盾------快模型先说"买吧",慢模型随后发现套餐缺关键功能,你在几秒内听到两个打架的答案。根因是:两个实例各自独立想了一次。
方案二:快思考交互,慢思考提醒。
让后台模型通过状态栏或专用接口,给前台"递小抄",前台维持话头、决定怎么表达。
它比方案一稳,但通信是间接的:前台可能误解建议,也看不到后台的中间思考;后台完成前,你追问,前台只能靠自己的能力应答。它能自然地"等结果",但还做不到真正的边想边说。
方案三:端到端,把"想"和"说"统一。
把思考能力直接内化进端到端音频模型。
代表是 Step-Audio R1,它用两个互补机制解决两个问题:
›
模态锚定思考蒸馏(MGRD) ,让模型基于声学特征去思考,保证"想得对";
›
MPS 双脑架构,让构思与表达并行,保证"说得及时"。
 理想的模型应该是:从音高、节奏和语调里判断情绪,而不是只看一句干巴巴的转录文本。
写在最后
语音为什么重要?
不是因为它酷,而是因为它足够自然。
它把你从键盘和屏幕前解放出来,让 Agent 真正进入一个"持续在场"的状态:能被打断,能等待,能在你说到一半时插话,也能在你停顿时接上。
从级联到全模态,再到全双工,语音 Agent 走的每一步,都是在把"轮流说话"这四个字一点点擦掉。
而下一个真正分高下的地方,是它能不能在及时回应 的同时,依然想得够深。
这,才是语音正在成为 Agent 最自然接口的底层原因。