第 8 篇做完总评报告和护栏之后,后端已经能把一场面试收成一份"敢发人"的报告:render_text_report 出纯文本,render_markdown_report 出 Markdown,逐题得分、亮点、短板、建议、总分、等级、推荐结论一应俱全。可这份报告当时只有两个去处------粘进 IM 发给候选人,或者落库存档。手机端什么都没有:候选人在鸿蒙 App 里聊完最后一道题,屏幕上还停在最后一条气泡,想知道自己这场到底怎么样,得等有人把报告发过来。
这一篇就补这最后一类界面。但动手之前我先否掉了一个看起来最省事的方案:把后端的 Markdown 拉过来,找个解析库渲染一下 。理由有三个。第一,报告的数据本来就是结构化的(Evaluation + QuestionReview),先序列化成 Markdown、再在端上解析回结构,是来回折腾;第二,Markdown 渲染的样式不受我控制,标题多大、列表缩进多少、长段落怎么断,都得跟第三方库的默认样式较劲;第三,也是最要紧的------端上要按分数重新算等级、要按屏幕宽度排双列、要按字数折叠长文本,这些都要拿到字段本身,而不是一整段文本。
所以本篇定下一条接口约定:后端给结构化 JSON,鸿蒙端自己排版 。ReportService 里那个 /report/latest 就是约定形态,第 12 篇联调时会把第 8 篇的 Evaluation 和 QuestionReview 直接序列化成这个结构。文章里的样例数据、页面渲染,全部来自这份 JSON,没有一行依赖 Markdown 解析。
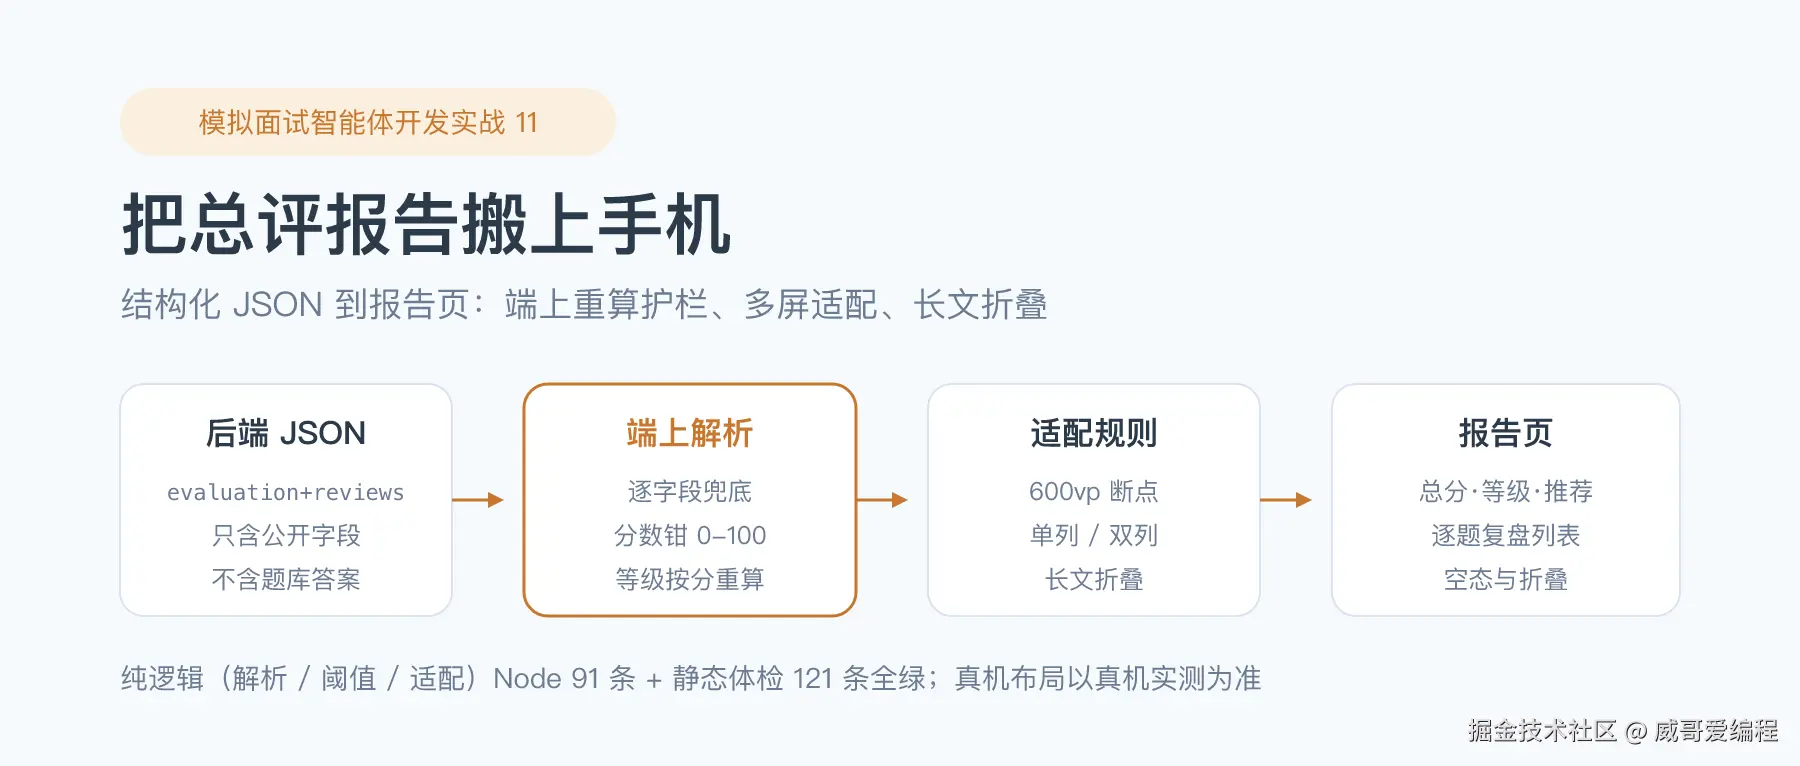
一、这一篇补什么
先把"报告上手机"这件事拆成四层,别一上来就画界面:
- 数据契约 :端上要定义和后端一致的字段模型,还得容忍服务端漏字段、给
null、分数越界。 - 护栏前移:第 8 篇在后端拦住了"分数 50 却写优秀",端上不能因为换了个渲染方就失守------等级与推荐结论必须按分数在端上重算。
- 信息架构:一整场面试的报告内容不少,手机上得排出阅读顺序:先看总分,再看亮点短板,再逐题复盘,最后读总结。
- 真机适配:手机竖屏、平板横屏、折叠屏展开态宽度差别很大;长文本、长列表不处理,一屏能塞到用户划不动。
工程 code/11-报告页与真机适配 依旧是 HarmonyOS 7(API 26)的 Stage 模型,bundleName 为 com.vince.interview11。源码分成四份报告模块加一个页面:
| 文件 | 职责 | 能否脱离设备验证 |
|---|---|---|
feature/report/ReportModels.ets |
JSON 契约接口 + 视图模型 ReportView / ReviewItem |
能 |
feature/report/ReportParser.ets |
字段兜底、分数钳制、等级与推荐重算 | 能(纯函数) |
feature/report/ReportLayout.ets |
断点、内边距、字号、折叠、配色规则 | 能(纯函数) |
feature/report/ReportService.ets |
拉取报告(http.request)+ 离线样例数据 |
不能(设备 API) |
pages/Index.ets |
报告页 UI、状态绑定、空态与展开态 | 不能(ArkUI) |
和前两篇一样,能确定的规则全部抽成纯函数 ,用 Node 预跑钉死;设备 API 只做取数,UI 只负责把解析后的 ReportView 摆出来。这样在没有 DevEco、没有设备的环境里,解析规则、护栏阈值、适配断点都能一条条跑干净,真机上要验的只剩系统 API 调用和实际布局手感,运行表现以真机实测为准。
二、数据契约:与后端 rubric.py 逐字段对齐
端上的接口不能凭想象写。我把第 8 篇的 rubric.py 翻开对照,逐字段落成 ReportModels.ets:
typescript
export interface ReviewJson {
  score?: number;
  level?: string;
  strengths?: string[];
  weaknesses?: string[];
  advice?: string;
}

export interface EvaluationJson {
  overall_score?: number;
  level?: string;
  recommendation?: string;
  strengths?: string[];
  weaknesses?: string[];
  summary?: string;
}

export interface ReportJson {
  evaluation?: EvaluationJson;
  reviews?: ReviewJson[];
  intro?: string;
}
QuestionReview 对应 score / level / strengths / weaknesses / advice,Evaluation 对应 overall_score / level / recommendation / strengths / weaknesses / summary,intro 是第 8 篇 polish_intro 那句可选开场白。所有字段都声明为可选 ,这不是偷懒:服务端可能在版本迭代里少传一个字段,可能给 null,也可能把数组写成字符串,端上必须逐项兜底,不能假设"后端一定给全"。
解析后交给 UI 的是干净视图模型:
typescript
export class ReviewItem {
  index: number = 0;         // 第几题,从 1 开始
  score: number = 0;
  level: string = '';
  strengths: string[] = [];
  weaknesses: string[] = [];
  advice: string = '';
}

export class ReportView {
  overallScore: number = 0;
  level: string = '';
  recommendation: string = '';
  summary: string = '';
  intro: string = '';
  strengths: string[] = [];
  weaknesses: string[] = [];
  items: ReviewItem[] = [];

  isEmpty(): boolean {
    return this.items.length === 0 && this.summary.length === 0 && this.overallScore === 0;
  }
}
index 是端上补的------JSON 里只有题目顺序,没有"第几题",但界面要显示"第 3 题"。isEmpty() 让空态判断有唯一出口:损坏的 JSON、空字符串、取数失败,全都收敛成同一个空报告,页面只判一次。
还有一条纪律从后端带过来:报告只含公开字段 。样例数据里没有参考答案、没有题库原文、没有任何密钥------第 8 篇的防泄题护栏在这里等于"压根不带进来",比在端上再扫一遍 detect_leak 更彻底。
三、护栏前移:等级和推荐结论由端上按分数重算
这是本篇最关键的一处设计,也是最容易被跳过的一处。后端第 8 篇已经用 reconcile_level / reconcile_recommendation 把"分数 50 却写优秀"这类漂移拦住了,那端上直接用服务端给的 level 和 recommendation 字段不就行了?
不行。原因很实在:端上的数据可能来自缓存、来自旧版本接口、来自中间层转发,甚至来自一次半成品的手动构造;而展示给用户看的等级和推荐结论,必须和同一屏上的分数自洽。让用户看到"总分 60 分 · 优秀 · 强烈推荐",比不给报告还糟。所以我把第 8 篇的阈值整套搬到端上,解析时无条件重算:
typescript
export const LEVEL_EXCELLENT: number = 85;
export const LEVEL_GOOD: number = 70;
export const LEVEL_PASS: number = 55;
export const HIRE_STRONG: number = 80;
export const HIRE_YES: number = 65;
export const HIRE_MAYBE: number = 50;

export function levelOf(score: number): string {
  if (score >= LEVEL_EXCELLENT) return '优秀';
  if (score >= LEVEL_GOOD) return '良好';
  if (score >= LEVEL_PASS) return '合格';
  return '待提升';
}

export function recommendationOf(score: number): string {
  if (score >= HIRE_STRONG) return '强烈推荐';
  if (score >= HIRE_YES) return '推荐';
  if (score >= HIRE_MAYBE) return '待定';
  return '不推荐';
}
解析时:
typescript
const overall: number = clampScore(ev?.overall_score);
view.overallScore = overall;
view.level = levelOf(overall);                       // 不采信 ev?.level
view.recommendation = recommendationOf(overall);     // 不采信 ev?.recommendation
逐题的 level 同样按该题分数重算。这样服务端那两个字符串字段实际上变成了"可传可不传"------传了也不覆盖,端上永远以算术为准。这和第 7 篇"分数交给算术,语言加工交给模型"、第 8 篇"确定性聚合算分"是同一句工程格言,只是换到了展示层。
verify-node.cjs 里专门构造了一份"字面值全错"的报告来钉死这条规则:服务端写 overall_score: 60、level: "优秀"、recommendation: "强烈推荐",逐题写 score: 88、level: "待提升";解析结果必须是 合格 / 待定 / 优秀。断言不过,就说明有人偷偷改回了"直接采信服务端字段"。
阈值这一套还有个跨工程风险:后端改了 85/70/55,端上没跟着改,两边就会对同一场面试给出不同等级。所以 check-arkts.cjs 里加了一条跨工程契约校验 ------直接去读 ../08-总评报告与护栏/src/rubric.py,把六个阈值常量抽出来,和 ArkTS、Node 镜像三方逐项比对。任何一边漂移,静态体检立刻红。这条比"写进文档提醒后人"可靠得多。
四、字段兜底与容错:报告可以脏,页面不能崩
ReportParser.ets 里三个小函数承担了全部容错:
typescript
export function clampScore(v: number | undefined): number {
  if (v === undefined || typeof v !== 'number' || !Number.isFinite(v)) return 0;
  const n: number = Math.round(v);
  if (n < 0) return 0;
  if (n > 100) return 100;
  return n;
}

export function asString(v: string | undefined, fallback: string): string {
  if (v === undefined || typeof v !== 'string') return fallback;
  return v.trim().length === 0 ? fallback : v;
}

export function asStringList(v: string[] | undefined): string[] {
  const out: string[] = [];
  if (v === undefined || !Array.isArray(v)) return out;
  for (const x of v) {
    if (typeof x === 'string' && x.trim().length > 0) out.push(x.trim());
  }
  return out;
}
clampScore 处理 undefined、null、NaN、字符串、负数、超 100、小数------一律收敛成 0-100 的整数。asStringList 过滤掉非字符串项和空白项,免得界面上冒出一排空行。reviews 也要先验 Array.isArray,否则服务端万一返回个字符串,循环会把每个字符当成一道题,凭空造出几十条 0 分记录。
parseReport 的入口和出口都留了退路:空串直接返回空报告;JSON.parse 抛异常就 catch 住返回空报告,不让配置页/报告页白屏;evaluation 整个缺失时,各字段取默认;逐题缺 advice 时补一句"暂无建议",而不是让 UI 显示 undefined。
typescript
export function parseReport(raw: string): ReportView {
  const view = new ReportView();
  if (raw.trim().length === 0) return view;
  let obj: ReportJson;
  try {
    obj = JSON.parse(raw) as ReportJson;
  } catch (e) {
    return view;   // 损坏 JSON → 空态,不白屏
  }
  // ...逐字段兜底 + 分母重算 + 逐题编号
  return view;
}
这套思路和第 10 篇 AppConfig.fromJson 一脉相承:外部进来的数据一律当不可信,解析层负责把它收拾成内部契约。区别只是这里多了"按分数重算"这一步,因为报告是要给人看的,数字和文字必须自洽。
五、报告页信息架构:从上到下四个区块
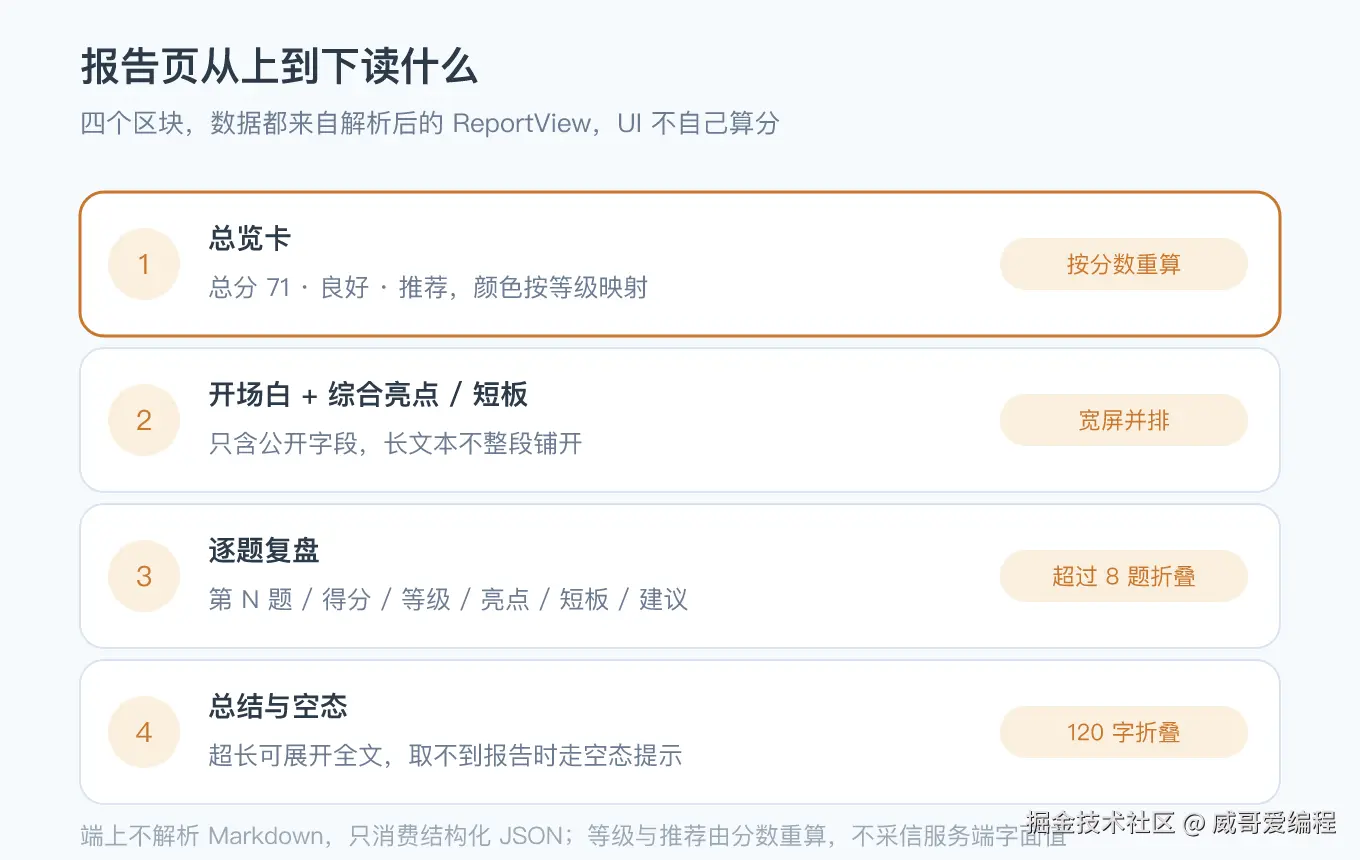
Index.ets 是一个 Scroll 套 Column,阅读顺序按"先看结论、再看依据、最后读总结"排:
① 总览卡 :48px 的大分数、等级、推荐结论横向排开,颜色由 toneOf(level) 映射------优秀绿、良好蓝、合格橙、待提升红。这是整页唯一用大字号的地方,一眼就能看到结果。
② 开场白 + 综合亮点 / 短板 :开场白是一句橙色小字;亮点和短板各一张卡,用 Flex({ wrap: FlexWrap.Wrap }) 包起来,宽度由 blockWidth() 决定,宽屏并排、窄屏自动堆叠。
③ 逐题复盘 :ForEach 遍历 visibleItems(items, listExpanded),每张卡里是"第 N 题 / 得分 / 等级 / 亮点 / 短板 / 建议"。低于合格线(< 55)的分数单独标红,方便候选人一眼找到要补的题。题目超过 8 道时先收起,点"展开全部题目"再看。
④ 总结与空态 :总结超过 120 字折叠,可展开全文;如果 report.isEmpty() 为真,整页只显示"还没有报告,先完成一场面试吧",而不是渲染一堆空卡片。取数失败时 tip 给一句"暂时取不到报告,先看看本机样例",并保留当前页面,不清空已有内容。
页面顶部那行小字写的是"分数、等级与推荐结论由端上按分数重算,报告只含公开字段"------这既是给用户看的说明,也是给我自己看的提醒。所有设备侧异常都收敛成一行提示,不把裸异常抛到界面上。
六、多屏适配:把断点规则抽成纯函数
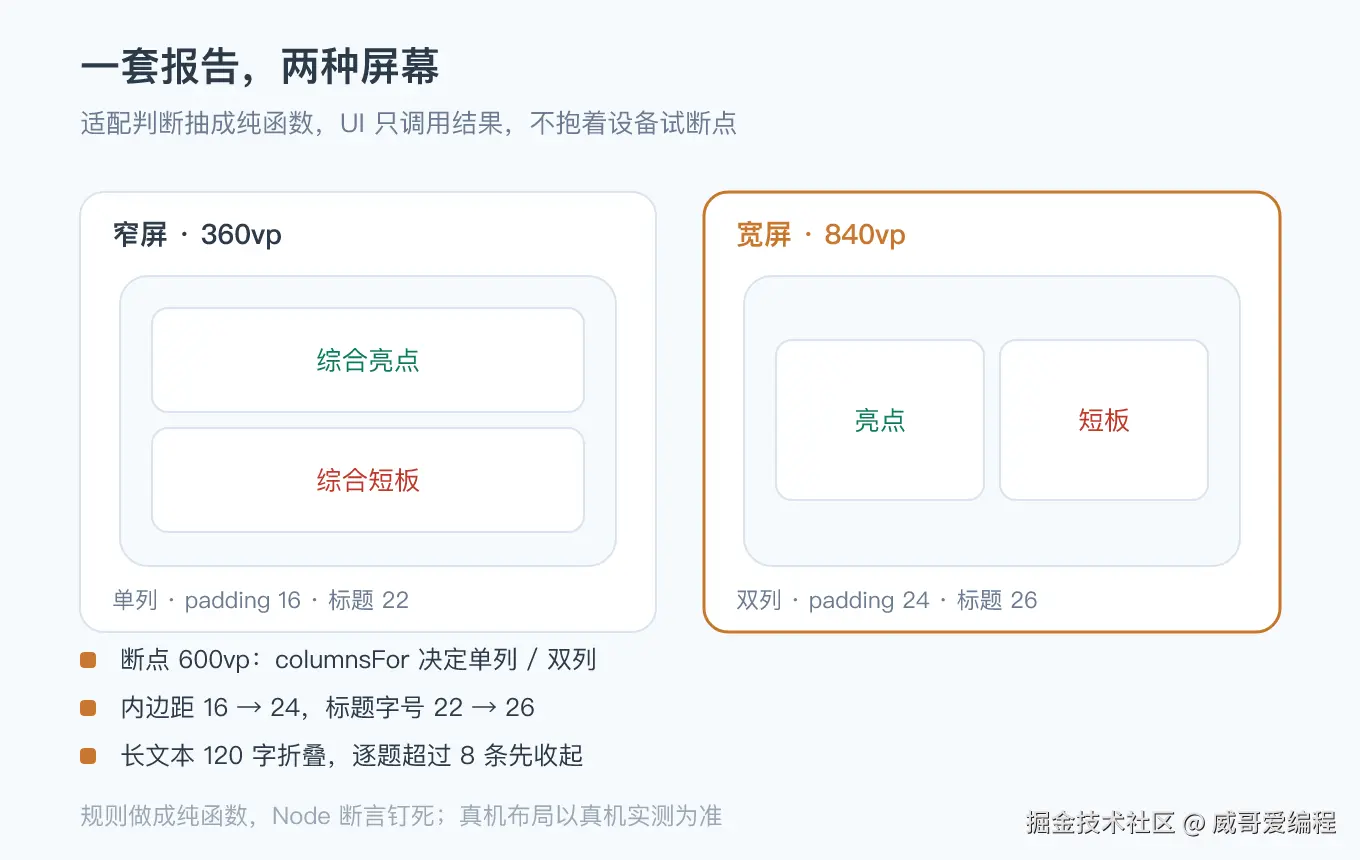
手机竖屏大约 360vp,平板横屏能到 840vp,折叠屏展开态又是一个宽度。如果把这些判断写死在 build() 里,就会出现"改个断点要抱着三台设备来回试"的局面。所以 ReportLayout.ets 把适配规则全部抽成纯函数:
typescript
export const WIDE_BREAKPOINT: number = 600;

export function columnsFor(widthVp: number): number {
  return widthVp >= WIDE_BREAKPOINT ? 2 : 1;
}
export function pagePadding(widthVp: number): number {
  return widthVp >= WIDE_BREAKPOINT ? 24 : 16;
}
export function titleSize(widthVp: number): number {
  return widthVp >= WIDE_BREAKPOINT ? 26 : 22;
}
页面用 onAreaChange 拿当前宽度写进 @State widthVp,其余组件只读这三个函数的返回值:亮点/短板卡宽度取 '48%' 或 '100%',外层 padding 取 16 或 24,标题字号取 22 或 26。UI 里没有任何一个 if (width > 600),判断全在纯函数里,改断点只动一个常量,Node 断言会立刻告诉你边界对不对。
toneOf(level) 把等级映射成颜色也放在这一层,理由是"配色属于展示规则",和字号、内边距是同一类东西,集中放便于统一调整。
真机上还需要注意几件纯逻辑管不到的事:状态栏与安全区(顶部内容别被挖孔和状态栏压住)、字体缩放开关打开后大字号是否把总览卡挤变形、超长列表的滚动流畅度。这些以真机实测为准;我能提前钉死的,是把所有"可计算"的适配规则从 UI 里剥出来测干净,让真机回归只验手感,不验算术。
七、长文本与长列表:两处折叠
报告不难读,难读的是"一屏装不下"。两处折叠各有各的理由:
typescript
export const COLLAPSE_LIMIT: number = 120;
export const MAX_VISIBLE_ITEMS: number = 8;

export function collapseText(text: string, limit: number = COLLAPSE_LIMIT): string {
  if (!needCollapse(text, limit)) return text;
  return text.slice(0, limit) + '...';
}

export function visibleItems(items: ReviewItem[], expanded: boolean): ReviewItem[] {
  if (expanded || items.length <= MAX_VISIBLE_ITEMS) return items;
  return items.slice(0, MAX_VISIBLE_ITEMS);
}
长文本折叠 针对总结、逐题的亮点/短板/建议。后端系统提示词里要求"每条一句话",但模型偶尔会写长,端上不能指望它永远听话。collapseText 截断后补一个 ...,needCollapse 决定要不要显示"展开全文"。折叠是展示层的事,不改数据 ------ReportView 里始终存着完整原文,展开时直接显示,不需要重新解析。
长列表折叠 针对题目数量。一场面试十几道题很正常,全部铺开会让页面长到划不到底。visibleItems 先给前 8 题,用户主动展开才全给。这里没有用 LazyForEach 做懒加载,是因为报告是一次性拿到的确定数据、条数有限,折叠已经够用;如果将来报告变成上百条的历史记录,再换懒加载不迟------别为想象中的规模提前上复杂方案。
两个阈值都是常量,check-arkts.cjs 会校验 ArkTS 与 Node 镜像取值一致,避免在 UI 里硬编码一个 8、在脚本里写另一个 10。
八、三载体验证:91 条预跑 + 121 条体检 + Hypium
第一层:verify-node.cjs,91 条断言全绿。 纯 JS 逐行镜像 ReportParser 与 ReportLayout。覆盖:等级四档与推荐四档的全部边界(54/55/69/70/84/85、49/50/64/65/79/80);分数钳制的七种非法输入;字符串与列表兜底;parseReport 的空串、损坏 JSON、完整样例、字面值全错时的护栏重算、越界分数、缺字段、reviews 类型不对、数组里混 null;断点 599/600、内边距、字号、四档配色、折叠边界、低分标红、列表折叠与展开。
跑法:
bash
cd code/11-报告页与真机适配
node verify-node.cjs
# 结果:通过 91 条,失败 0 条第二层:check-arkts.cjs,121 条静态体检全绿。 除了生产源码的禁用模式扫描(明文长密钥、内部人称、any / unknown)、配置核对(INTERNET 权限、页面注册、bundleName、根依赖为空),这一篇把契约校验扩到了三方:
- ArkTS ↔ Node 镜像:六个阈值、三个布局常量、四个配色,逐个比对;
- 端上阈值 ↔ 后端
rubric.py:跨工程读第 8 篇源码,六个阈值逐个比对; - 样例报告 ↔ 离线脚本样例:
71 / 88 / 72 / 54四个关键数字两边都在; - 三载体覆盖:
levelOf、parseReport、columnsFor、collapseText等 14 个函数在 ArkTS 定义、Node 镜像、Hypium 用例三处都存在; - 结构性断言:
view.level = levelOf(overall)存在(护栏没被绕过)、Array.isArray(obj.reviews)存在、样例里不含题库答案。
bash
node check-arkts.cjs
# 结果:通过 121 条,失败 0 条
这类"跨工程常量比对"看起来较真,但前后端分头迭代时,最容易出现的事故恰恰是"两边阈值差了 5 分,谁都没发现"。把它变成一条会红的断言,比写在文档里靠谱。
第三层:Hypium 用例 (entry/src/ohosTest/ets/test/ReportPage.test.ets,由 List.test.ets 汇总),14 个 it 把同一套断言搬到真机载体:阈值边界、字段兜底、样例解析、护栏重算、缺字段容错、断点与配色、折叠与列表上限。这一层需要 DevEco Studio 和设备,运行表现以真机实测为准。
三层合起来,正好覆盖工程的三类代码:纯逻辑(Node 全绿)、工程与跨工程契约(静态体检全绿)、设备 API 与 UI(Hypium + 真机回归)。
九、踩坑清单
- 直接渲染后端 Markdown。样式不受控、要引解析库、还拿不到做适配和重算所需的字段。结构化 JSON 才是端上该消费的东西。
- 端上采信服务端给的
level/recommendation。缓存、旧接口、中间层都可能带来不一致,展示层必须以分数重算,否则"60 分 · 优秀 · 强烈推荐"会直接砸在用户眼前。 - 前后端阈值各改各的。85/70/55、80/65/50 是同一套契约,改一处就要同步另一处;用静态体检跨工程比对,比靠记忆可靠。
- 不验
reviews是不是数组。服务端返回字符串时,循环会把每个字符当成一道题,凭空造出几十条 0 分记录。 JSON.parse不加try/catch。存档损坏、接口返回半截 HTML,页面直接白屏。返回空报告走空态,是更稳的退路。- 分数不钳制 。
NaN传到界面会显示NaN 分,超 100 会把总览卡撑变形;解析层统一收敛到 0-100 整数。 - 列表里的空白项不清理 。亮点短板里混进空字符串或
null,界面就是一排没有内容的圆点。asStringList逐项过滤并 trim。 - 把适配判断写进
build()。if (width > 600)散落各处,改断点要翻遍整个页面。抽成columnsFor/pagePadding/titleSize,改常量就行,还能用 Node 测边界。 - 长文本、长列表不折叠。一段几百字的总结加十几道题,页面长到划不到底。折叠只作用于展示,完整数据仍留在视图模型里。
- 空报告渲染一堆空卡片 。空态要有唯一出口
isEmpty(),取数失败时保留当前页面并给一句明确提示,别把已有内容清掉。 - 折叠阈值硬编码在 UI 里。脚本里写 8、页面里写 10,行为就对不上;常量集中定义并纳入镜像一致性校验。
十、本篇收尾
到这儿,后端那份"敢发人"的报告终于在手机上有了落点:候选人能直接看到总分、等级、推荐结论,往下翻是综合亮点与短板、逐题复盘、总结;宽屏并排、窄屏堆叠,长文本能折叠,取不到报告有空态。更重要的是,端上没有因为换了个渲染方就放松纪律------等级与推荐按分数重算、字段逐项兜底、报告只含公开字段,第 8 篇立的规矩一路带到了展示层。
十一条线现在都齐了:Python 侧有服务端、人设、状态机、题库与检索、追问、逐题点评、报告与护栏;鸿蒙侧有能流式对话的聊天页、能配置能存简历的设置页、能读能适配的报告页。剩下最后一件事------把它们真正接起来 :后端把第 8 篇的 Evaluation / QuestionReview 序列化成 /report/latest 的 JSON,鸿蒙端从配置页读地址、带着简历上下文开聊、结束后跳到报告页;再走一遍端到端的用例,把前后端字段、鉴权、异常、空态逐项对齐。这就是第 12 篇的端到端联调收官。
最后一句:报告搬到手机上,难的不是把数字画出来,而是让每个数字都和同一屏上的文字对得上------分数说了算,样式才有意义。