写到第 11 篇,十二篇里已经有十一篇各自跑通了:Python 侧的服务端、人设、状态机、题库检索、追问、逐题点评、报告护栏,鸿蒙侧的聊天页、配置页、报告页,每个工程都有自己的测试,全绿。但我心里一直清楚一件事------各自能跑和接起来能跑,是两回事。
最容易出事的地方从来不是某个模块内部的逻辑,而是模块之间那层"约定":鸿蒙端 buildRequestBody 里写的是 resume_context,后端接收的模型里是不是同一个名字?后端 Evaluation 序列化出来的字段,端上 ReportJson 是不是逐字对得上?第 8 篇定下的 85/70/55,端上第 11 篇重算时有没有悄悄改过?SSE 每一行是不是真的以 data: 开头、以 [DONE] 收尾?这些东西单测测不到,因为两边的单测各自只认识自己那一半。
所以收官这篇不做新功能,只做一件事:把 01 到 11 真正接起来,并且把"接得上"变成会自动变红的断言。
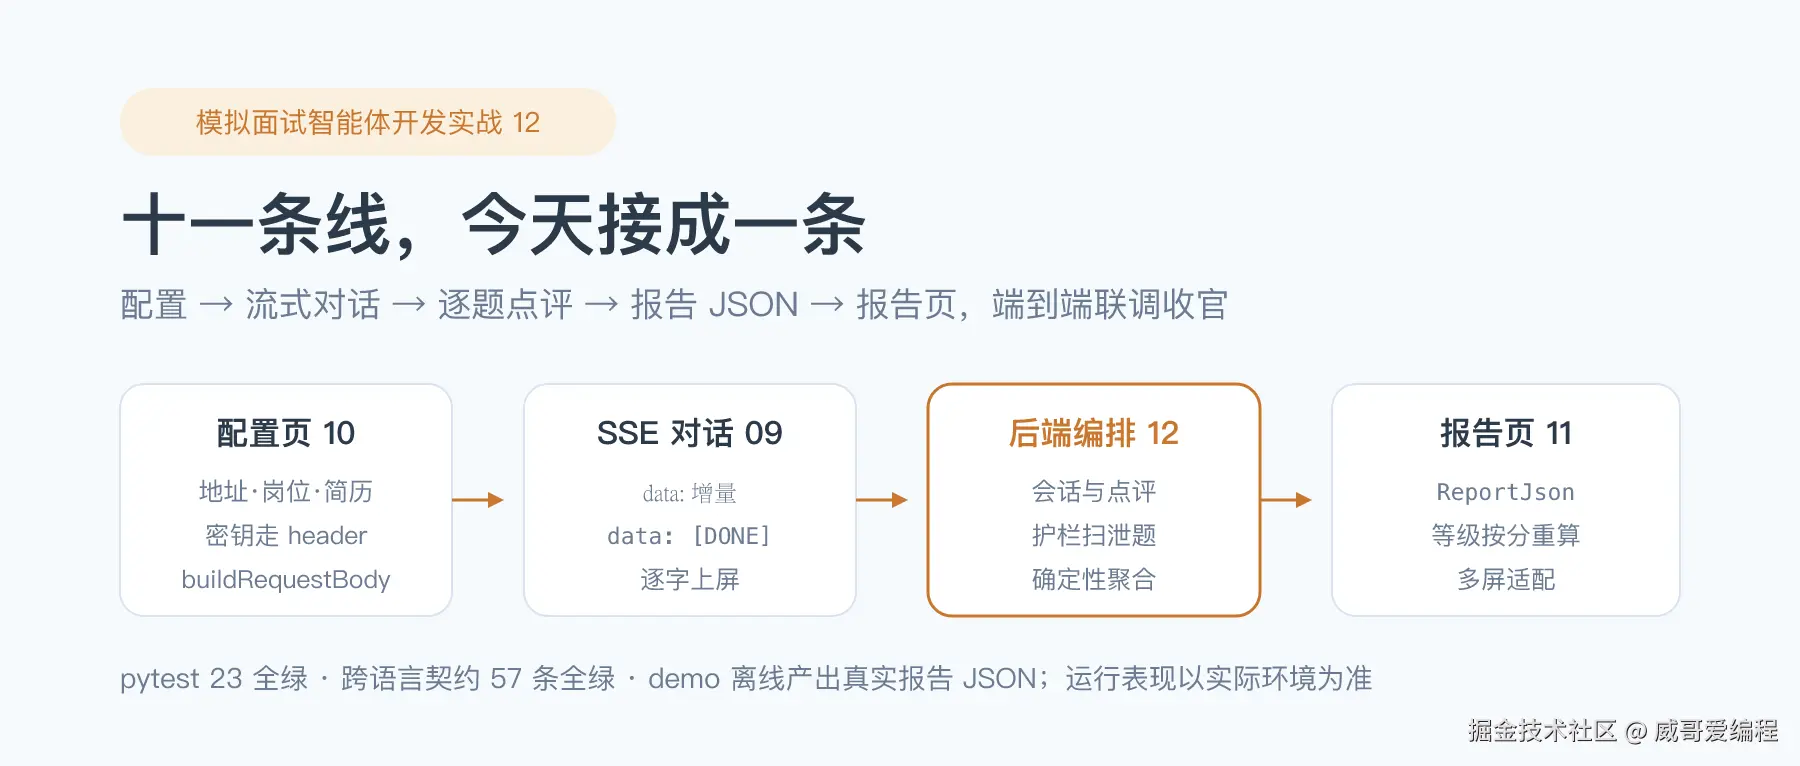
一、收官要补的三个断点
先把"联调"这个词拆开,别写成一篇泛泛的总结。我要验的是三类断点:
- 字段断点 :请求体从鸿蒙端发出到后端接收,报告从后端产出到端上解析,字段名必须逐字一致。差一个字母,端上拿到的是
undefined,而且不报错------这是最阴的一种 bug。 - 格式断点 :SSE 是文本协议,第 9 篇的解析器按行切
data:、认[DONE];后端只要多输出一个空行、把增量里塞进换行,或者忘了结束标记,界面就永远停在"面试官思考中"。 - 纪律断点:密钥不进请求体、报告不含题库答案、等级与推荐按分数重算------这些前十一篇立的规矩,串起来之后还成不成立?会不会在某个转换层被漏掉?
工程 code/12-端到端联调 是一个 Python FastAPI 服务,用 TestClient 离线跑完整链路(不启动真实服务、不联网、不需要 Key)。它把三件事收在四个接口里:
| 接口 | 对应篇章 | 作用 |
|---|---|---|
GET /health |
02 服务端基座 | 联调自检,确认服务与模型名 |
POST /chat/stream |
09 / 10 | 接收鸿蒙端请求体,SSE 流式回增量 |
GET /report/latest |
08 / 11 | 输出端上报告页消费的结构化 JSON |
POST /session/reset |
本篇 | 用例之间重置内存会话 |
源码只有五份:rubric.py(直接复用第 8 篇,阈值与两套模型)、contract.py(前后端契约)、session.py(会话编排)、guardrails.py(出口护栏)、app.py(接口层)。没有一份是重复实现业务逻辑------前十一篇写好的东西,这里只做搬运和对接。
二、契约层:把字段名写成常量,而不是靠记忆
contract.py 是整篇的心脏。它定义端上 ReportJson 的等价物,并把字段名显式列成常量:
python
REPORT_KEYS = ["evaluation", "reviews", "intro"]
EVALUATION_KEYS = [
    "overall_score", "level", "recommendation", "strengths", "weaknesses", "summary"
]
REVIEW_KEYS = ["score", "level", "strengths", "weaknesses", "advice"]

class ReportPayload(BaseModel):
    intro: str = ""
    evaluation: EvaluationPayload
reviews: list[ReviewPayload] = Field(default_factory=list)三组常量不是为了好看,是给跨语言校验 用的:verify-contract.cjs 会去读第 11 篇的 ReportModels.ets,用正则把 interface ReportJson / EvaluationJson / ReviewJson 的字段名抽出来,和这里的 REPORT_KEYS / EVALUATION_KEYS / REVIEW_KEYS 逐项比对,再拿 demo 实际产出的 JSON 键集合对一遍。三方不一致,校验立刻红。以后谁在端上加了个字段、后端没跟上,不用等真机白屏才发现。
转换函数 to_report_payload 把第 8 篇的 Evaluation + QuestionReview 变成端上结构,同时守住第 7、8 篇那条纪律:
python
def to_report_payload(evaluation, reviews, intro="") -> ReportPayload:
    scores = [r.score for r in reviews]
    overall = round(sum(scores) / len(scores)) if scores else 0
    return ReportPayload(
        intro=intro,
        evaluation=EvaluationPayload(
            overall_score=overall,
            level=level_of(overall),                 # 不采信 evaluation.level
            recommendation=recommendation_of(overall),  # 不采信字面值
            strengths=list(evaluation.strengths),
            weaknesses=list(evaluation.weaknesses),
            summary=evaluation.summary,
        ),
        reviews=[ReviewPayload(score=r.score, level=level_of(r.score), ...) for r in reviews],
    )
等级和推荐结论在这里又重算了一次 。第 8 篇后端护栏算过,第 11 篇端上解析器也算过,中间这层转换照算不误。三处都按分数说话,就没有哪一层能把"60 分 · 优秀"混进报告里。测试用例专门传了一份字面值全错的 Evaluation 进来,断言输出仍然是正确的等级与推荐。
三、会话编排:为什么这里不调真模型
session.py 里有个 ChatRequest,字段与第 10 篇 AppConfig.buildRequestBody 完全对齐:
python
class ChatRequest(BaseModel):
    model: str = DEFAULT_MODEL
    message: str = ""
    position: str = ""
    difficulty: str = "中级"
resume_context: str = ""注意这里没有密钥字段 。第 10 篇把密钥放在请求头,联调服务也按这个约定来------请求体里出现 apiKey,等于在访问日志、代理日志里多留一份凭据。verify-contract.cjs 里专门有断言钉住这一点。
InterviewSession.push() 做三件事:记下这一轮的配置(岗位、难度、模型、有没有带简历上下文)、按回答产一条逐题点评、把"面试官下一句话"切成 4 字一块的 SSE 增量:
python
def push(self, req: ChatRequest) -> list[str]:
    self.last_position = req.position
    self.last_difficulty = req.difficulty
    self.has_resume_context = len(req.resume_context) > 0
    self.reviews.append(_review_for(req.message))
    prompt = _NEXT_PROMPTS[min(self.turns - 1, len(_NEXT_PROMPTS) - 1)]
    if self.has_resume_context:
        prompt = "结合你的简历," + prompt
return [prompt[i : i + 4] for i in range(0, len(prompt), 4)]这里必须说清楚:面试官回复和逐题点评都是离线确定性替身,不是真的调模型 。score_of 按回答长度给 88 / 72 / 54 三档固定分,_review_for 按分数档给固定文案。这么做不是偷懒,是联调的目标决定的------这一篇要验的是「请求体能不能收到、SSE 格式对不对、报告字段能不能对上、护栏会不会放行」,这些都不该受模型输出随机性干扰。真实点评由第 7 篇的 reviewer 接模型完成,真实追问由第 6 篇的追问引擎完成,把它们插进 push() 的位置即可,链路本身不用改。
全系列的测试纪律一直是"外部依赖用 stub/mock、离线全绿、不依赖真实密钥",这一篇只是把同样的做法用在了联调层。生产环境还需要把内存单例 _SESSION 换成按会话 ID 索引的持久层,那是工程化的下一步,不影响本篇验证的契约。
finish() 把累积的逐题点评聚合成总评:分数取算术平均,亮点短板去重保序截断(与第 7 篇 aggregator 一致),再交给 to_report_payload 转成端上结构。三条不同长度的回答恰好得到 88 / 72 / 54,平均分 71,等级"良好"、推荐"推荐"------和第 11 篇报告页里的样例数据完全对上。样例不是编出来的,是这条链路真跑出来的。
四、SSE 与报告接口:格式对齐第 9 篇
app.py 的流式接口写得很短,但每个细节都对着第 9 篇的解析器:
python
@app.post("/chat/stream")
def chat_stream(req: ChatRequest):
    if not req.message.strip():
        raise HTTPException(status_code=400, detail="message 不能为空")
    if req.difficulty not in ("初级", "中级", "高级"):
        raise HTTPException(status_code=400, detail="difficulty 只能选 初级 / 中级 / 高级")
    chunks = get_session().push(req)

    def generate():
        for piece in chunks:
            yield "data: " + piece + "\n"
        yield "data: [DONE]\n"

    return StreamingResponse(generate(), media_type="text/event-stream")
每行严格 data: 开头、行尾换行、最后一行 [DONE]。第 9 篇的 SseStreamParser 按 \n 切行、剥 \r、忽略非 data: 字段、认 [DONE] 结束------两端格式必须一模一样。增量块里不能有换行 ,否则一个逻辑增量会被解析器切成两条事件。这也是为什么 push() 切成 4 字一块而不是按句子切。
GET /report/latest 在返回之前先过护栏:
python
payload = get_session().finish()
warnings = validate_report(payload)
if warnings:
    raise HTTPException(status_code=500, detail=";".join(warnings))
return payload.model_dump()
护栏 guardrails.py 是第 8 篇思想的精简联调版:把整份报告序列化后扫一遍泄题词(参考答案、标准答案、答案原文、题库原文),再验总分是否等于逐题平均、逐题分数有没有越界。任何一条不过,宁可 500 也不把有问题的报告发到端上。加上第 8 篇"渲染层只放公开字段"、第 11 篇"报告只含公开字段",这里是第三道,位置在接口出口。
五、离线 demo:一条用例走完全链路
demo.py 用 TestClient 把整条链路跑一遍,不启动服务:健康检查 → 三轮带配置与简历上下文的对话 → 取报告 → 把报告写成 artifacts/report.json。真实输出:
kotlin
① 健康检查: {'status': 'ok', 'model': 'deepseek-ai/DeepSeek-V3', 'version': '1.0.0'}
② 第 1 轮 SSE:8 行,末行 data: [DONE],拼接「结合你的简历,请接着说说你在项目里承担的具体职责。」
② 第 2 轮 SSE:7 行,末行 data: [DONE],拼接「结合你的简历,这个方案在生产环境遇到过什么问题?」
② 第 3 轮 SSE:7 行,末行 data: [DONE],拼接「结合你的简历,最后总结一下这场的收获与不足。」
③ 报告接口: 200
   总分 71(良好)/ 推荐
   逐题得分: [88, 72, 54]
④ 报告已写出: artifacts/report.json
写出来的 JSON 顶层只有 intro / evaluation / reviews,evaluation 六个字段、reviews 每项五个字段,一道题的 advice 是"给关键指标加上量化说明,再说清取舍依据"。没有题库答案、没有密钥、没有 resume_context------请求里带进来的简历上下文,不会顺着报告回流到端上。
那份 report.json 不是给人看的,是给下一步用的。
六、跨语言契约校验:让 Python 的 JSON 用端上的规则反验
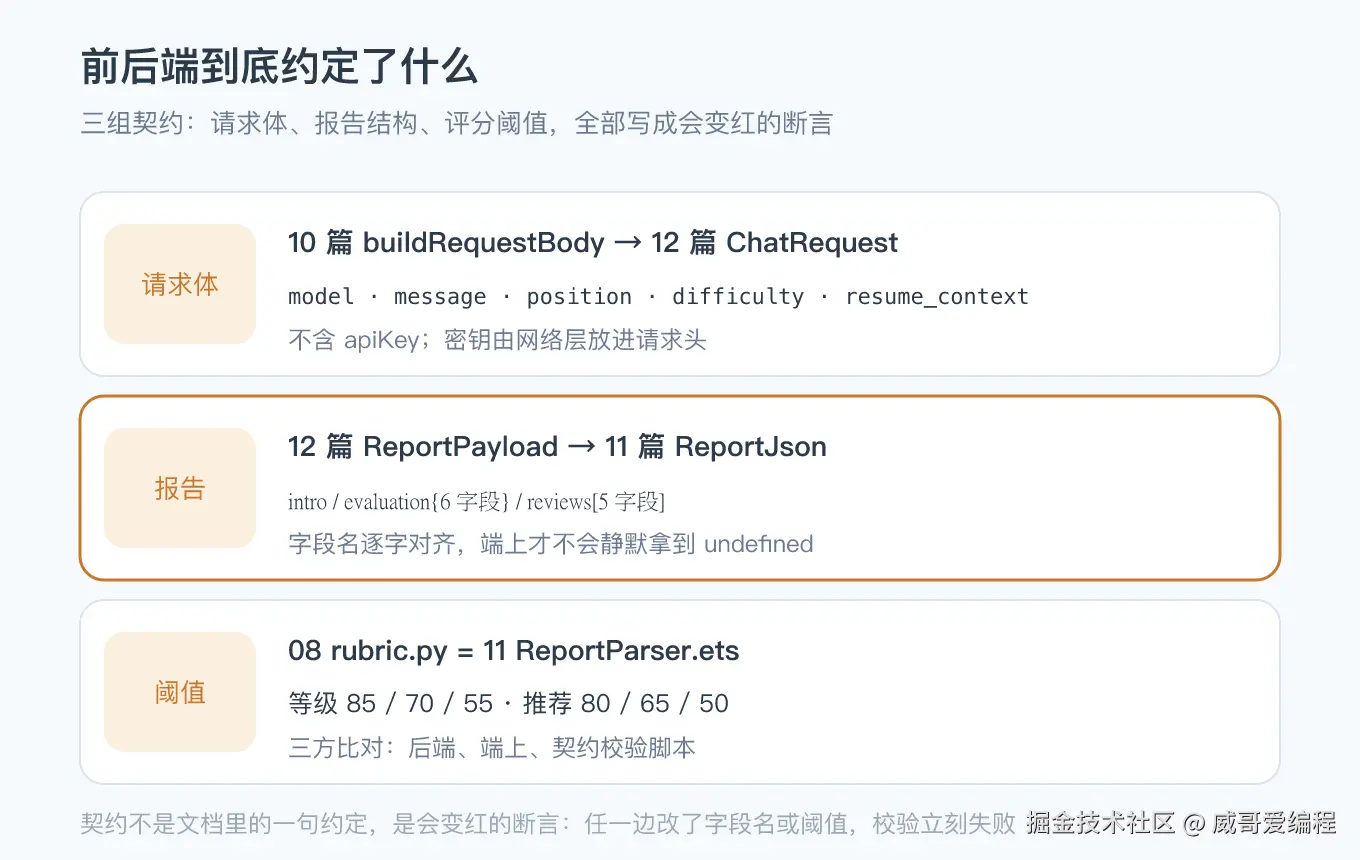
verify-contract.cjs 是这一篇我最想留下的东西。它读 demo 产出的真实 JSON,然后做三件单测做不到的事:
- 字段名三方比对 :从第 11 篇
ReportModels.ets抽 ArkTS interface 字段、从contract.py抽 Python 常量、从report.json抽实际键,三组排序后逐项相等。 - 阈值三方比对 :从第 8 篇
rubric.py、第 11 篇ReportParser.ets、校验脚本自身,抽 85/70/55 与 80/65/50 六个常量逐个核对。 - 用端上的规则解析真实报告 :脚本里镜像了第 11 篇的
clampScore/levelOf/recommendationOf,拿它们去解析report.json,断言总分 71、等级"良好"、推荐"推荐"、三题 88/72/54、题号 1..3、每题都有建议。
除此之外还扫了泄题词与敏感字段、核对第 10 篇请求体五个字段与 ChatRequest 的对应关系、确认两端都没有 apiKey、确认第 12 篇按 data: + [DONE] 输出且第 9 篇解析器认这两样、确认四个接口都在。
bash
cd code/12-端到端联调
../_venv/bin/python demo.py
node verify-contract.cjs
# 结果:通过 57 条,失败 0 条这类校验的价值在于,它验的是两个独立代码库之间的约定,而不是任何一边自己的正确性。后端单测全绿、端上单测全绿,字段名差一个字母照样两边都绿------只有把真实产物拿到对面规则里跑一遍,这个洞才会露出来。
七、验证结果
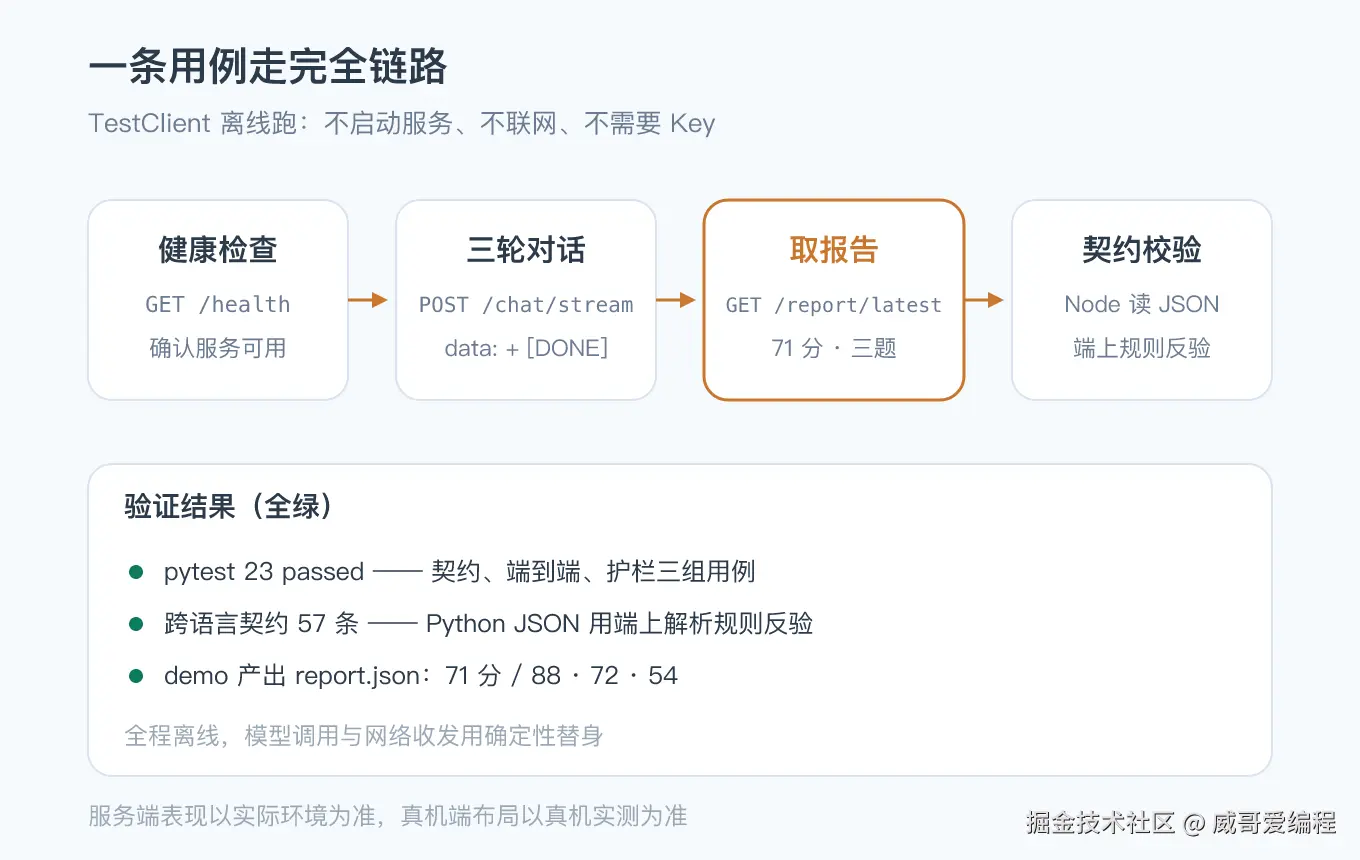
pytest 23 个用例全绿 (../_venv/bin/python -m pytest --capture=no -p no:cacheprovider -q),分三组:
test_contract.py:契约键集合、算术平均、等级/推荐重算、逐题等级重算、空报告、字段边界校验;test_end_to_end.py:健康检查、SSE 行格式与结束标记、配置字段确实到达后端、无简历时不加前缀、三轮对话到报告的完整链路、空会话报告、参数校验(空 message / 非法难度)、会话重置;test_guardrails.py:泄题词命中与自定义词、干净报告无告警、summary 与 advice 里藏泄题词被抓、总分不自洽被抓、分数越界被抓。
跨语言契约 57 条全绿,加上 demo 离线产出真实报告 JSON。整个工程不联网、不需要密钥、不启动服务,跑一遍几秒钟。服务端表现以实际环境为准,真机端布局以真机实测为准。
八、踩坑清单
- 字段名差一个字母,两边单测都绿 。端上拿到
undefined还不报错。把键集合写成常量并三方比对,是唯一可靠的解法。 - 前后端阈值各改各的。85/70/55、80/65/50 在第 8、11、12 三处出现,任何一处漂移都会让同一场面试算出不同等级。跨工程读源码比对,比写进文档管用。
- SSE 增量块里带换行。第 9 篇按行切事件,一个逻辑增量被切成两条,界面出现半句话。增量要么保证无换行,要么在解析层做缓冲。
- 忘了
[DONE]。第 9 篇的控制器靠这个标记落终态,缺了气泡会永远停在"思考中"。流式协议里"结束"必须显式,不能靠"没数据了"暗示。 - 把密钥塞进请求体 。日志、代理、抓包各留一份。第 10 篇放 header,第 12 篇的
ChatRequest里不能有这个字段,校验脚本钉死。 - 报告里回流
resume_context或题库答案。请求里带进来的简历上下文属于输入,不该出现在给候选人看的报告里;出口扫描再兜一层。 - 注释里的关键词误伤静态扫描 (本轮真踩到)。
session.py的注释写了"没有 apiKey 字段",全文扫描就误报"后端收了密钥"。改成只查apiKey:这种字段定义形态,别拿全文包含当证据。 - 近义泄题词互相重叠 (本轮真踩到)。测试样本"参考答案原文"同时命中
参考答案和答案原文,断言只期望一个。词表要么去重设计,要么测试样本写精确。 - 内存单例会话串用例 。上一个用例留下的逐题点评污染下一个用例。加
/session/reset,pytest 里用autousefixture 每个用例前后各清一次。 - 转换层忘了重算等级 。第 8 篇算过、第 11 篇算过,中间
to_report_payload直接透传evaluation.level就前功尽弃。每一层都按分数说话。 - 联调里调真模型。输出随机、要联网、要密钥,用例今天绿明天红。链路验证用确定性替身,模型能力交给它原本那一篇测。
九、十二篇盘点
| 篇 | 主题 | 工程验证 |
|---|---|---|
| 01 | 需求与架构:给自己造一个随叫随到的 AI 面试官 | 33 测 |
| 02 | 服务端基座与 SSE 流式输出 | 69 测 |
| 03 | 面试官人设 Prompt | 43 测 |
| 04 | LangGraph 面试流程状态机 | 56 测 |
| 05 | 题库与 RAG,出题可溯源 | 52 测 |
| 06 | 追问引擎:会深挖、会纠错 | 62 测 |
| 07 | 结构化输出:逐题点评与总评 | 16 测 |
| 08 | 总评报告与三道护栏 | 26 测 |
| 09 | 鸿蒙聊天界面 + SSE 逐字上屏 | Node 31 断言 / Hypium 15 用例 |
| 10 | 配置页与简历模块,可配可存 | Node 71 断言 / 静态体检 89 条 |
| 11 | 报告页与多屏适配 | Node 91 断言 / 静态体检 121 条 |
| 12 | 端到端联调收官 | pytest 23 测 / 跨语言契约 57 条 |
十二篇走下来,一条线是清楚的:先让机器会问,再让它会听、会追、会评,最后让人能在手机上用起来,并且用得住 。技术栈从 Python 3.13 + FastAPI + LangGraph,走到 HarmonyOS 7 的 ArkTS,中间靠一套结构化契约把它们缝在一起。每一篇的代码都放进真实工程跑过测试,外部依赖一律用替身,密钥一律 sk-****,没有一段代码是靠"看起来应该能跑"混过去的。
十、收官
到这儿,这个模拟面试智能体才算完整:在配置页填好服务端、岗位、难度,选一份简历;进聊天页,面试官结合简历流式提问,逐字上屏;答完几轮,后端按状态机编排、按参考答案点评、聚合总评、过三道护栏;报告页拿到结构化 JSON,端上按分数重算等级、按屏宽排版、把长文本折叠好,摆到候选人面前。从"我"填第一个地址,到看见那句"总分 71(良好)/ 推荐",中间十一个模块,没有一处是黑盒。
回头看,最花时间的不是某个算法,而是反复做同一件事:把不确定交给可验证的确定性。分数交给算术,语言加工交给模型;展示位只放公开字段;外部依赖用替身;字段名与阈值写成会变红的断言。这些规矩单看都很朴素,攒到一起,才让十二个独立工程敢说自己是一个系统。
系列到这里结束。但要真上线,还有五件工程化的活,各自都有明确的替换点,不用推翻重来:
- 持久层 :把
session.py里的内存单例_SESSION换成按会话 ID 索引的存储(数据库或会话服务)。push()/finish()的签名不用改,只是状态不再跟着进程走。 - 鉴权 :客户端密钥走 header 的约定已经留好,服务端补一层校验与会话归属判断;第 10 篇配置页里的
hasKey()正好是客户端侧的对应检查。 - 并发会话 :现在四个接口共用一个会话,多人同时练会串场。加上会话 ID 之后,
/chat/stream与/report/latest都要带 ID,护栏和聚合逻辑本身不动。 - 模型接入 :把
score_of/_review_for这两处离线替身,换成第 7 篇的reviewer、第 6 篇的追问引擎、第 3 篇的人设提示词。链路位置已经留好,换的是"谁来产出内容",不是"内容怎么流"。 - 真机回归:第 9、10、11 篇的 Hypium 用例与设备 API(SSE 收发、preferences、picker、多屏布局)需要在 DevEco 与真机上再跑一遍,运行表现以真机实测为准;服务端以实际环境为准。
这五件都不是文章该假装做完的事。代码和文章都留在目录里:能跑、能改、能顺着这些替换点接着往下做------这比留一句"留给读者自行扩展"实在。
最后一句:一个系统真正跑通的证据,不是十二份各自全绿的测试,而是把其中一边的真实产物,放进另一边的规则里还能全绿。