由一份小红书 2027 校招 JD 展开的专业拆解。当你不再只是「调用模型」,而是要「构建让 Agent 在生产环境中可靠运行的系统」时,需要掌握的知识体系究竟是什么?
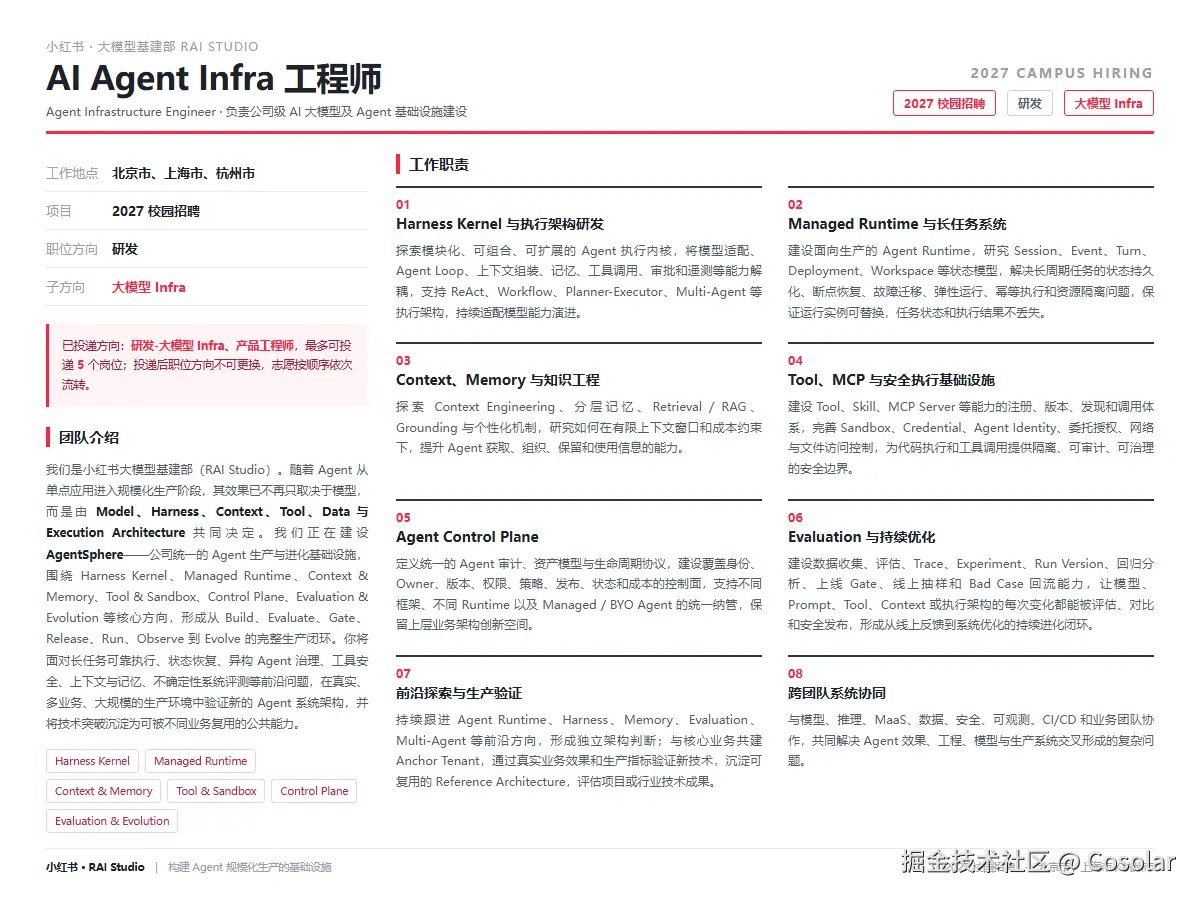
引言:一份 JD 释放的信号
最近看到一份小红书大模型基建部(RAI Studio)的校招 JD,职位是「AI Agent Infra 工程师」。它开篇就抛出一个足以定义整个方向的判断:
随着 Agent 从单点应用进入规模化生产阶段,其效果已不再只取决于模型,而是由 Model、Harness、Context、Tool、Data 与 Execution Architecture 共同决定。
这句话值得反复咀嚼。它标志着 AI 工程的重心正在发生一次根本性迁移------从 模型中心(Model-centric) 转向 系统中心(System-centric)。
过去两年,行业的大部分注意力都堆在模型本身:更大的参数、更长的上下文、更强的推理。但当 Agent 真正走进生产环境,人们发现:一个 Agent 好不好用,模型只占一部分。真正决定成败的,是围绕模型那一整套「让它能可靠工作」的基础设施------执行内核、状态管理、上下文工程、工具生态、安全边界、评估闭环。
这套基础设施,就是 Agent Infra 。而 JD 中提出的 AgentSphere ,本质上是一套 Agent 的生产与进化操作系统,覆盖从 Build → Evaluate → Gate → Release → Run → Observe → Evolve 的完整闭环。
这篇文章,我想借这份 JD 作为切片,系统性地回答三个问题:
- Agent Infra 工程师到底要掌握哪些知识?
- 这些知识如何组织成一个可学习的体系?
- 面向未来,哪些技术方向值得提前下注?
一、范式转变:为什么 Agent Infra 成为一个独立学科
要理解需要学什么,先要理解「变的是什么」。
1.1 从无状态调用到有状态执行
传统 LLM 应用是典型的 request-response 无状态模型:来一个请求,拼一个 Prompt,调一次模型,返回一个结果,结束。
Agent 完全不同。它是一个长周期、有状态、会与环境持续交互的执行过程。一次任务可能持续几分钟到几小时,跨越数十次模型调用,中途要记住做过什么、失败了什么、下一步该干什么。
这个转变带来一连串全新的工程问题:
- 任务执行到一半宕机了,怎么恢复?(状态持久化 / 断点恢复)
- 某个执行实例故障了,怎么迁移而不丢结果?(故障迁移)
- 同一个操作重试两次,会不会重复扣款?(幂等执行)
- 多个 Agent 共享资源,怎么互相隔离?(资源隔离)
这些不是「AI 问题」,而是分布式系统与基础设施工程的经典问题在 Agent 领域的新形态。这就是为什么 Agent Infra 需要独立的工程学科------它站在 AI 与 Infra 的交叉点上。
1.2 从「模型即产品」到「模型只是组件」
JD 里有一句话很关键:「这里不是建设一套固定的低代码平台,也不是为单个业务开发 Agent。」
这句话划清了 Agent Infra 的边界。它既不是低代码搭建工具(那是产品层),也不是某个业务的具体 Agent(那是应用层)。它是中间那层可复用的公共能力------让业务团队能快速构建、评估、部署自己的 Agent,而不用每次都从零解决可靠性、安全、评估这些共性问题。
这类似云计算里「PaaS 之于应用」的关系。Agent Infra 要做的,是把 Agent 生产中的共性难题沉淀成平台能力,让一次技术突破可以被公司不同业务复用。
1.3 从「凭感觉调」到「可度量、可进化」
传统 Prompt 工程很大程度依赖经验和直觉。而 JD 反复强调 Evaluation、Trace、Experiment、回归分析、上线 Gate、Bad Case 回流 ------这是一整套 AgentOps / EvalOps 的思路。
核心理念是:Agent 的每一次变化(模型、Prompt、Tool、Context 或执行架构)都必须可评估、可对比、可安全发布。没有评估体系,就没有持续优化,更谈不上「进化」。
这是一种工程成熟度的标志:从手工作坊走向可度量的工业体系。
二、七大技术支柱:Agent Infra 的知识骨架
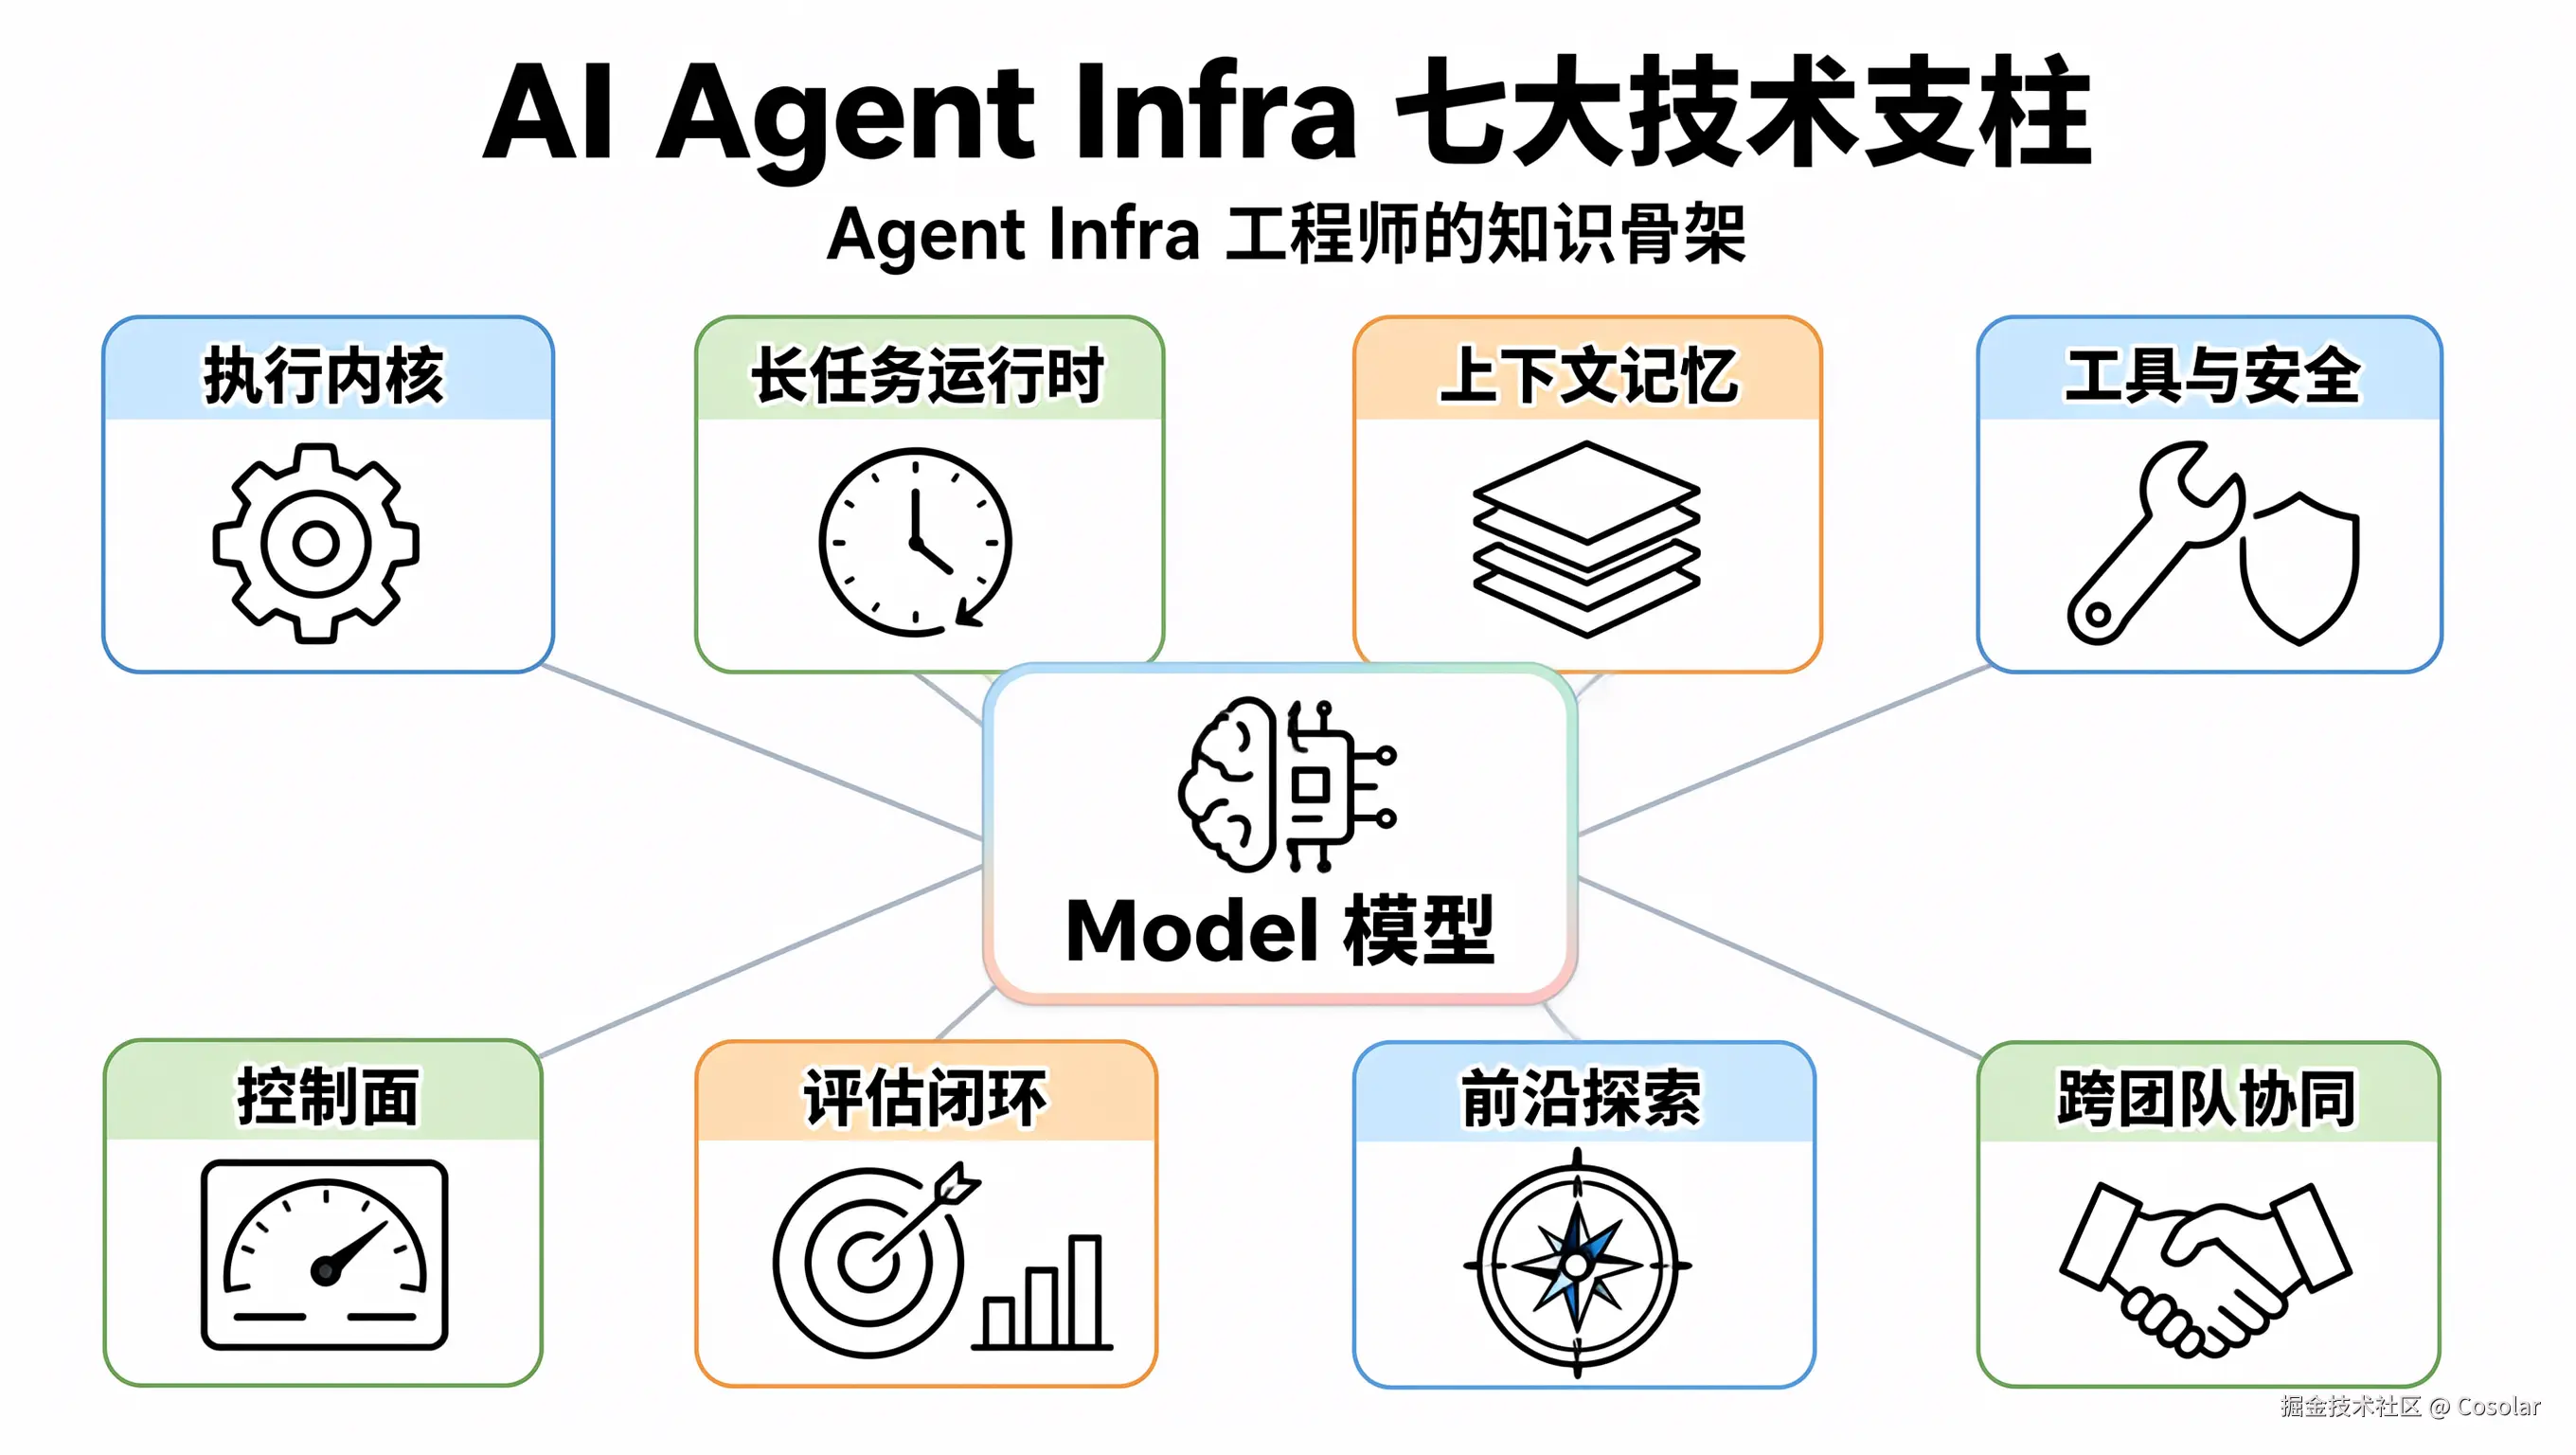
这份 JD 实际勾勒出了 Agent Infra 的七个核心技术方向。我把它称为「七大技术支柱」,逐一拆解其解决的问题、核心知识点与学习要点。
支柱一:Harness Kernel 与执行架构 ------ Agent 的「内核」
解决什么问题 :Agent 的执行逻辑千差万别(ReAct、Workflow、Planner-Executor、Multi-Agent......),如果每种架构都写一套,代码会迅速失控。需要一个模块化、可组合、可扩展的执行内核,把共性能力抽象出来。
核心知识点:
- 将模型适配、Agent Loop、上下文组装、记忆、工具调用、审批、遥测等能力解耦
- 支持 ReAct、Workflow、Planner-Executor、Multi-Agent 等多执行架构
- 执行架构随模型能力持续演进(模型更强了,编排方式可能就要变)
学习要点 :理解「Agent = Model + Harness」这一公式。模型是大脑,Harness 是神经系统。重点掌握 Agent Loop 的设计模式、不同编排范式(编排式 vs 自主式)的取舍,以及如何用插件化/积木式设计让内核可扩展。这是整个体系的地基。
支柱二:Managed Runtime 与长任务系统 ------ Agent 的「运行时」
解决什么问题:让 Agent 能在生产环境中长时间、可靠地运行。这是 JD 中篇幅最重、工程味最浓的方向。
核心知识点:
- 状态模型:Session、Event、Turn、Deployment、Workspace 的分层设计
- 可靠性机制:状态持久化、断点恢复、故障迁移、弹性运行、幂等执行、资源隔离
- 核心目标:「运行实例可以被替换,但任务状态和执行结果不会丢失」
学习要点 :这是分布式系统工程在 Agent 场景的映射。要补的知识包括:事件溯源(Event Sourcing)、状态机、幂等性设计、检查点(Checkpoint)机制、容器隔离与资源调度。这是区分「玩具 Demo」和「生产系统」的分水岭,也是最有壁垒的方向。
支柱三:Context、Memory 与知识工程 ------ Agent 的「记忆与认知」
解决什么问题:上下文窗口有限、成本有约束,但 Agent 需要获取、组织、保留并使用大量信息。如何在有限资源下让 Agent「记得住、用得好」?
核心知识点:
- Context Engineering:上下文工程(正在取代 Prompt Engineering 成为核心技能)
- 分层记忆:短期 / 长期记忆的分层设计
- Retrieval / RAG:检索增强生成
- Grounding 与个性化:让输出有据可依、贴合用户
学习要点 :从「怎么写好一句 Prompt」升级到「如何设计整个上下文系统」。重点理解上下文窗口的成本结构、信息检索与重排序、记忆的写入/遗忘/压缩策略、以及如何做 Grounding 减少幻觉。2025---2026 年最重要的趋势之一,就是 Context Engineering 的崛起。
支柱四:Tool、MCP 与安全执行基础设施 ------ Agent 的「手脚与安全边界」
解决什么问题:Agent 要调用工具、执行代码,这带来了巨大的安全挑战。如何建设一套可治理的工具生态与安全边界?
核心知识点:
- 工具生态:Tool、Skill、MCP Server 的注册、版本、发现、调用体系
- 安全基础设施:Sandbox、Credential、Agent Identity、委托授权、网络与文件访问控制
- 目标:为代码执行和工具调用提供「隔离、可审计、可治理」的安全边界
学习要点 :MCP(Model Context Protocol)正在成为 Agent 工具生态的事实标准,类似「AI 应用的 USB-C 接口」,必须掌握。同时理解沙箱技术(容器/微虚拟机)、凭证管理、最小权限原则、委托授权模型。当 Agent 能执行代码和调用工具时,安全就是第一优先级。
支柱四·补充:Agent Control Plane ------ Agent 的「控制面」
JD 中还有一个未编号但极其重要的段落------Agent Control Plane。它定义统一的审计、资产模型与生命周期协议 ,建设覆盖身份、Owner、版本、权限、策略、发布、状态和成本的控制面,支持不同框架、不同 Runtime 的统一纳管(Managed / BYO Agent)。
这本质上是 Agent 版本的「Kubernetes 控制面」------数据面负责执行,控制面负责管理与治理。理解这种「控制面 / 数据面」分离的思想,是构建大规模 Agent 平台的关键。
支柱五:Evaluation 与持续优化 ------ Agent 的「仪表盘与刹车」
解决什么问题:如何科学地评估 Agent 效果,并安全地持续迭代?
核心知识点:
- 数据收集、评估器、Trace、Experiment、Run Version
- 回归分析、上线 Gate、线上抽样、Bad Case 回流
- 目标:形成「从线上反馈到系统优化的持续进化闭环」
学习要点 :这是最容易被忽视、却最能决定长期成败的方向。要掌握:如何设计评估集与评估指标、如何做 A/B 与回归测试、如何用 Trace 做可观测性、如何建立上线门禁与灰度机制。没有 Evaluation,前面所有方向都无法形成闭环。
支柱六:前沿探索与生产验证 ------ Agent 的「研发飞轮」
解决什么问题:如何保持技术领先,并把探索成果转化为可复用的生产资产?
核心知识点:
- 持续跟进 Agent Runtime、Harness、Memory、Evaluation、Multi-Agent 等前沿方向
- 形成独立的架构判断
- 与核心业务共建 Anchor Tenant(锚定租户),用真实业务效果验证新技术
- 沉淀 Reference Architecture(参考架构)
学习要点:这是一种工作方法论------「前沿探索 → 真实业务验证 → 沉淀参考架构」的飞轮。它要求你既懂技术趋势,又能落地验证,还能抽象沉淀。
支柱七:跨团队系统协同 ------ Agent 的「工程协作面」
解决什么问题:Agent 是典型的交叉领域,效果、工程、模型、生产系统交织在一起,需要多团队协作。
核心知识点:
- 与模型、推理、MaaS、数据、安全、可观测、CI/CD、业务团队协作
- 解决交叉形成的复杂问题
学习要点:技术之外的「软技能」同样重要。要能跨团队沟通、理解不同角色的诉求、推动复杂问题落地。真正的系统级工程师,往往也是优秀的协作者。
三、知识体系分层地图:把七大支柱组织成学习路径
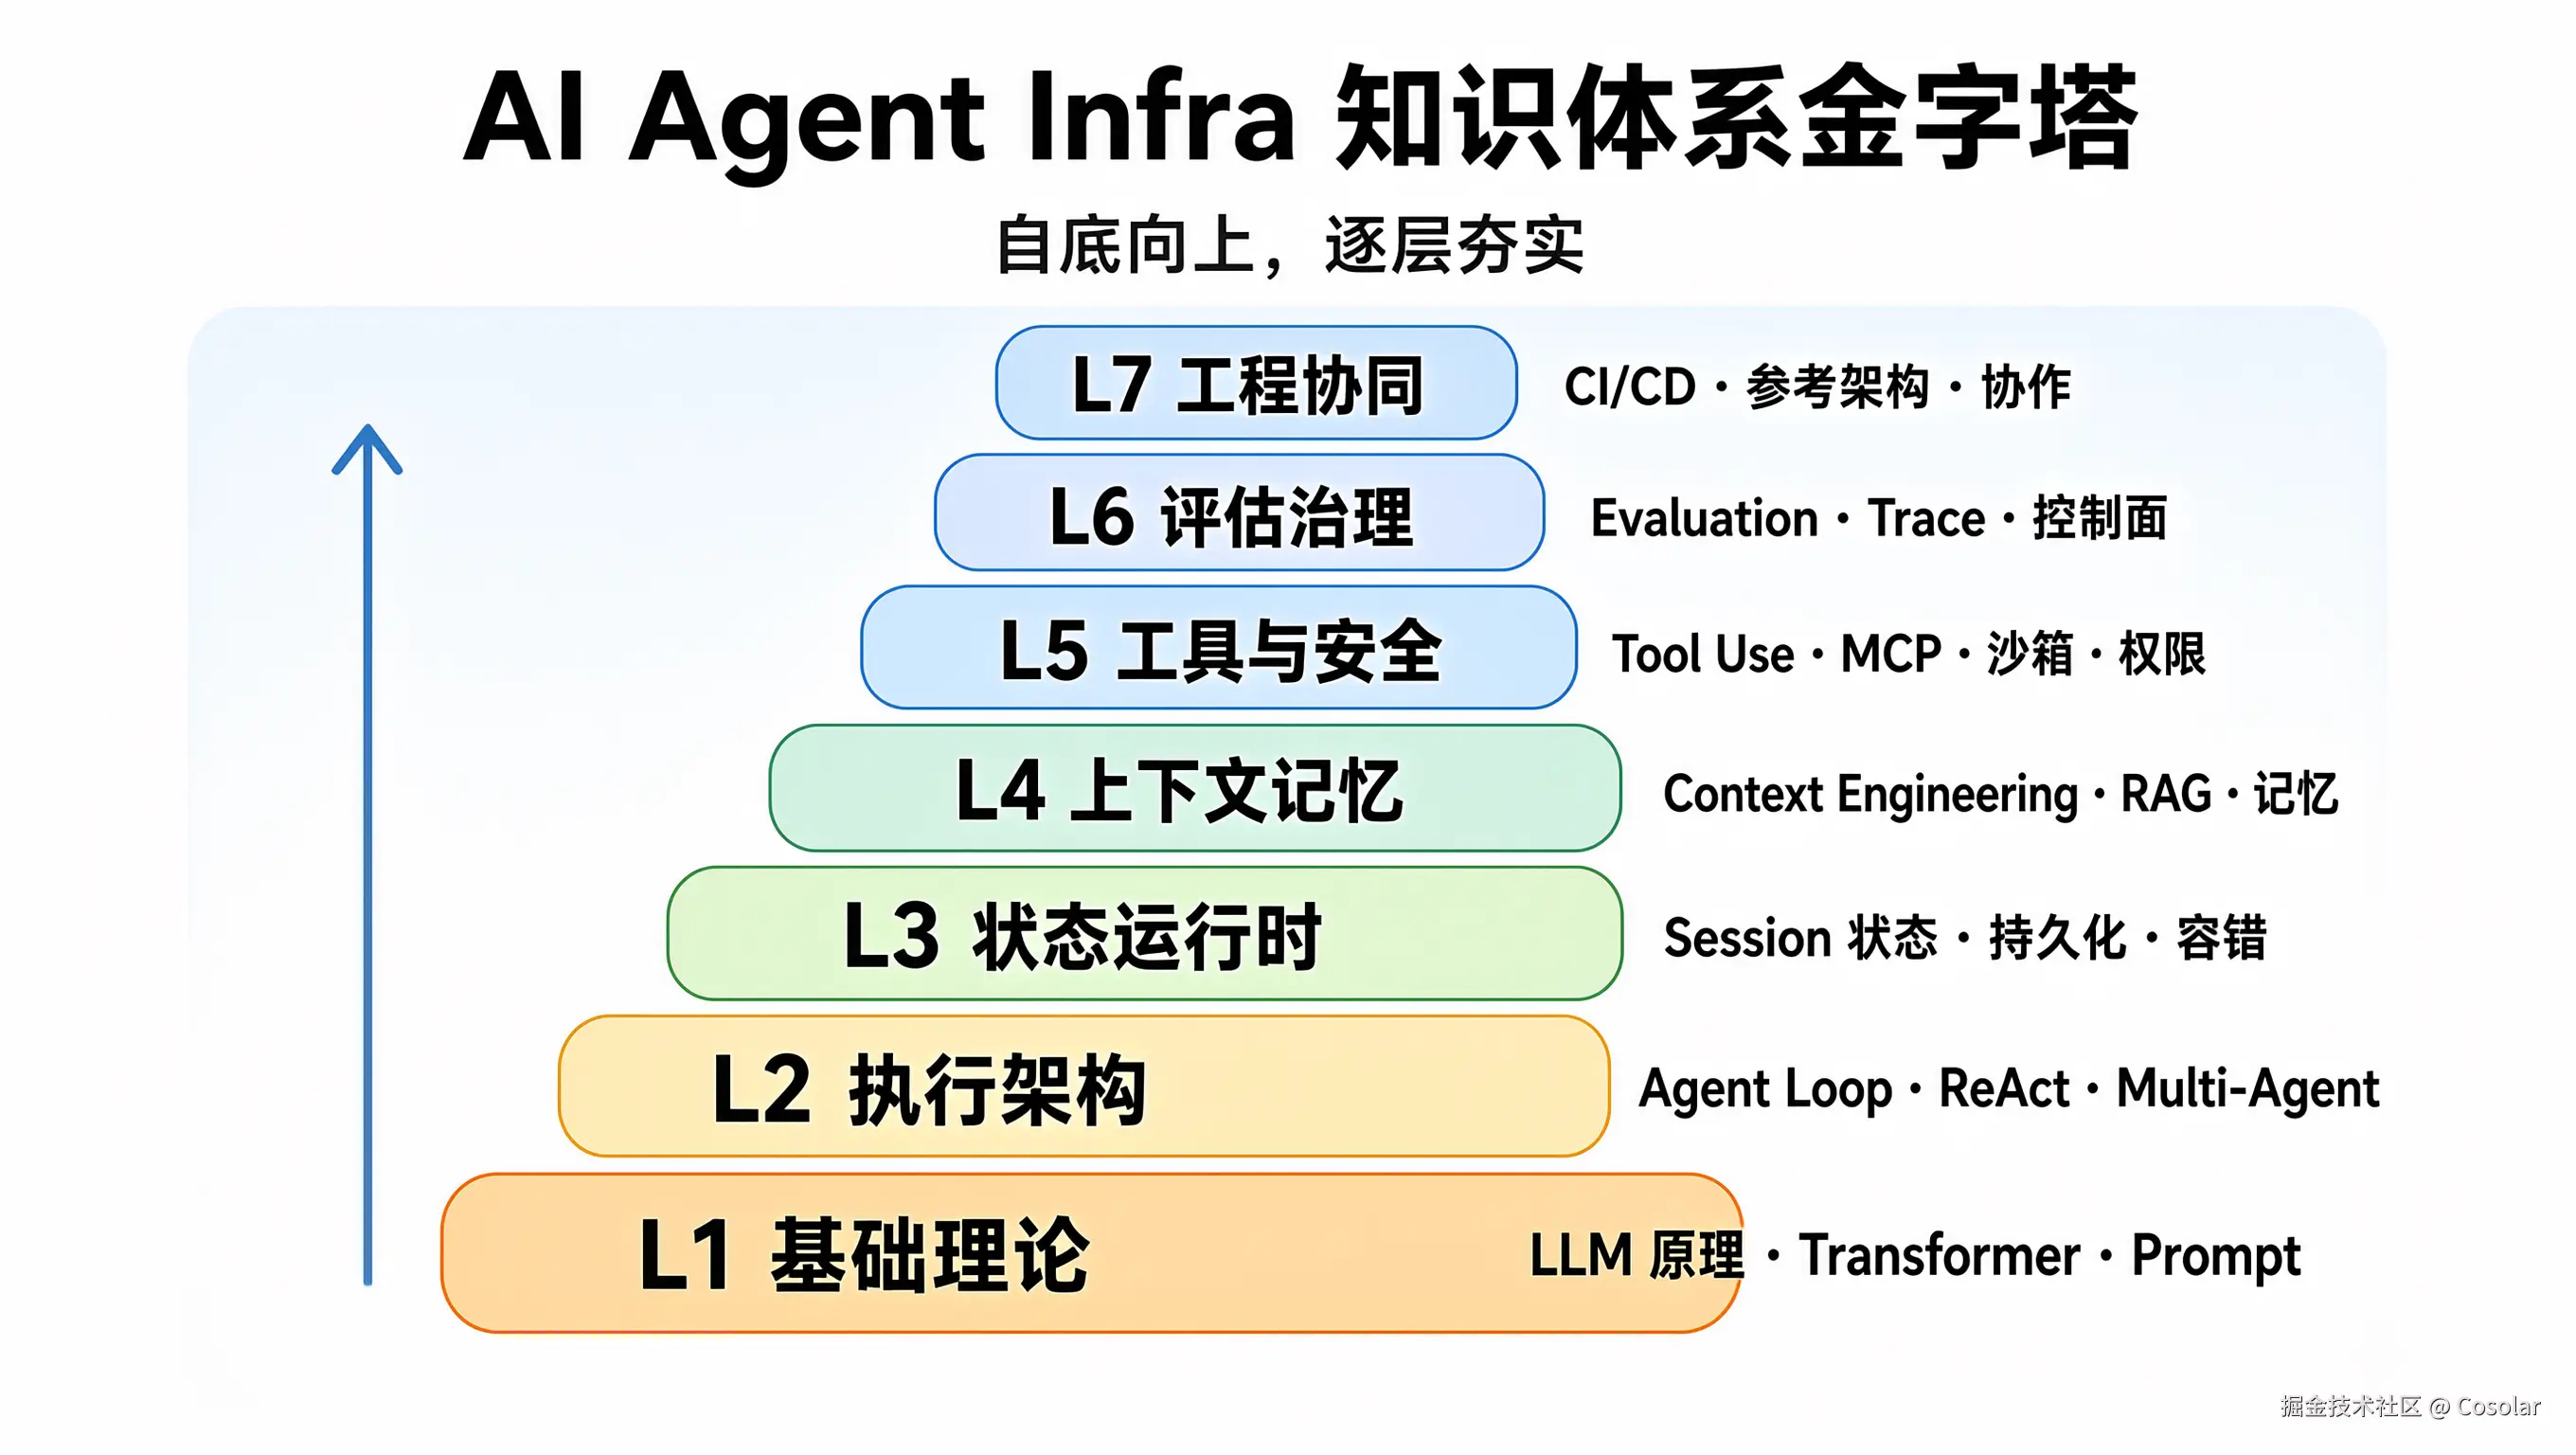
上面七个支柱是「做什么」,这一节回答「按什么顺序学」。我把整个知识体系整理成 七层金字塔,从底层基础到顶层应用:
| 层级 | 名称 | 核心内容 | 对应支柱 |
|---|---|---|---|
| L7 | 工程与协同层 | CI/CD、参考架构、跨团队协作、Anchor Tenant | 支柱六、七 |
| L6 | 评估与治理层 | Evaluation、Trace、Gate、可观测性、Control Plane | 支柱五、Control Plane |
| L5 | 工具与安全层 | Tool Use、MCP、Sandbox、凭证、权限、身份 | 支柱四 |
| L4 | 上下文与记忆层 | Context Engineering、RAG、分层记忆、Grounding | 支柱三 |
| L3 | 状态与运行时层 | Session/Event 模型、持久化、容错、分布式系统 | 支柱二 |
| L2 | 执行架构层 | Agent Loop、ReAct、Planning、Multi-Agent 编排 | 支柱一 |
| L1 | 基础理论层 | LLM 原理、Transformer、推理机制、Prompt | 地基 |
学习的关键原则:自底向上,逐层夯实。
- L1 是地基:不懂模型原理,就无法理解 Harness 为什么要这么设计。至少要理解 Transformer、注意力机制、推理过程、上下文窗口的本质。
- L2---L3 是核心壁垒:执行架构 + 运行时状态管理,是 Agent Infra 区别于普通 AI 应用的地方,也是投入产出比最高的部分。
- L4---L5 是能力放大器:上下文和工具决定了 Agent「能做什么」,安全和治理决定了它「敢不敢用在生产」。
- L6---L7 是成熟度标志:评估和协同决定了系统能否持续进化和规模化落地。
四、一条可执行的学习路径
如果你是一名想进入这个方向的工程师,我建议按以下阶段推进:
阶段一:打地基(理解模型与单 Agent 原理)
- 系统学习 LLM 基础:Transformer、Attention、Token、上下文窗口、采样策略
- 亲手实现一个最小的 Agent Loop(ReAct 模式):模型 → 思考 → 调用工具 → 观察 → 循环
- 理解 Prompt Engineering 的局限,体会 Context Engineering 的价值
阶段二:深入执行与运行时(建立核心壁垒)
- 学习一种主流 Agent 框架(如 LangGraph / AutoGen / 类似内核)的源码,理解状态机与图编排
- 补分布式系统基础:事件溯源、幂等、检查点、状态机、容错
- 动手实现一个支持「断点恢复」的 Agent 运行时 Demo
阶段三:掌握上下文、工具与安全(补齐能力面)
- 深入 RAG:向量检索、重排序、混合检索、Query 改写
- 设计分层记忆系统,理解记忆的写入、压缩与遗忘
- 掌握 MCP 协议,动手写一个 MCP Server;理解 Sandbox 与权限隔离
阶段四:建立评估与治理闭环(走向生产级)
- 搭建一套 Agent 评估体系:评估集、评估器、Trace、回归测试
- 理解 Control Plane 思想,学习可观测性与上线 Gate
- 用「真实业务验证 → 沉淀参考架构」的方式完成一个完整项目
贯穿始终的建议:一边学,一边写。Agent Infra 是工程学科,只看不练永远无法建立直觉。每学一个概念,都试着用代码把它实现出来。
五、未来技术方向的五个判断
基于这份 JD 和行业趋势,我对未来 1---3 年 Agent Infra 的技术方向做出五个判断:
判断一:Agent 执行内核走向标准化
就像容器技术催生了 Docker 与 OCI 标准,Agent 执行内核也会走向标准化。「Agent Runtime API」 有望成为新的抽象层,让上层应用在不同内核间迁移。掌握内核设计与标准化思想的人,将占据生态位。
判断二:长任务可靠性成为核心竞争力
当 Agent 从「聊几句」走向「干几小时的活」,可靠性就是一切。断点恢复、故障迁移、幂等执行、状态一致性------这些能力会从「加分项」变成「入场券」。这是最硬、最有壁垒的方向。
判断三:Context Engineering 取代 Prompt Engineering 成为核心技能
Prompt Engineering 会逐渐下沉为「基础常识」,而 Context Engineering------如何在有限上下文和成本约束下组织、检索、压缩、保留信息------将成为区分高手与新手的关键技能。RAG、记忆系统、Grounding 会深度整合进 Infra 层。
判断四:MCP 与工具生态标准化,安全成为合规刚需
MCP 有望成为 Agent 工具的事实标准,工具生态将像 App Store 一样繁荣。与此同时,随着 Agent 被赋予更多权限,安全、审计、身份、委托授权会从技术选项变成合规刚需。Agent Identity、权限治理、可审计性会成为独立赛道。
判断五:AgentOps / 自动化评估闭环成为「操作系统级」能力
未来的 Agent 平台,会像今天的 CI/CD 一样,内置完整的「评估 → 门禁 → 发布 → 观测 → 进化」闭环。EvalOps / AgentOps 会从工具变成平台的基础能力。没有这套闭环,Agent 就永远停留在「凭感觉调」的手工作坊阶段。
结语:站在 AI 与 Infra 的交叉点上
回到开篇那句话------「Agent 的效果不再只取决于模型,而是由 Model、Harness、Context、Tool、Data 与 Execution Architecture 共同决定」。
这正是 Agent Infra 工程师的价值所在:你不是去训练一个更好的模型,而是去构建一套让模型能可靠、安全、可进化地工作的系统。
这是一个横跨 AI、分布式系统、安全、工程效能的交叉学科,门槛高、壁垒深,但也正因如此,它代表着 AI 工程化的未来方向。对于愿意深耕的人来说,这里既有扎实的技术挑战,也有巨大的成长空间。
一句话总结这篇长文:
Agent 的竞争,终将是系统的竞争。得 Infra 者得 Agent。