ChatGPT 像打字机一样逐字输出,不是为了表演效果,而是 LLM 自回归生成的必然表现。这也是大厂 Java AI 岗的高频面试题,很多人只会说"就是一个字一个字生成",再往深就问不住了。这篇从原理讲到落地:下一个词预测、KV Cache、采样策略、Java 流式实现,一次讲透。
一、先说结论:LLM 本质是个"文字接龙大师"
一句话版本先给你:
LLM 本质是一个超大规模的"下一个 token 预测器"------给它前文,它算出词表上每个候选词的概率,挑一个出来,拼回输入,再算下一个,循环往复。
不神秘,数学上就是一个条件概率:P(下一个 token | 前面所有 token)。模型并不"理解"世界,它是在预训练阶段把海量语料压缩进参数,做最大似然估计------让真实语料的下一个词概率尽量高。
比如输入"今天天气真",模型输出的是这样一组概率分布:
text
好:   0.62
不错: 0.18
热:   0.09
冷:   0.05
采样出"好",再把"今天天气真好"整体喂回去,预测下一个 token,就像成语接龙:你出上句,它猜下一个字,猜完加进去,再猜下一个。
这里有两个容易误解的点,先掰扯清楚:
- LLM 不是实时搜互联网,也不是查某个固定数据库,它靠概率推理生成,所以才会"一本正经地胡说八道";
- LLM 是生成式模型,不是检索式模型,它输出的是词表上的概率分布,而不是查到的标准答案。
那这条接龙具体是怎么跑起来的?先看一遍完整的推理流水线。
二、一次推理的全流程:从一句话到概率分布
先看图,LLM 的一次前向计算会经过这么几步:
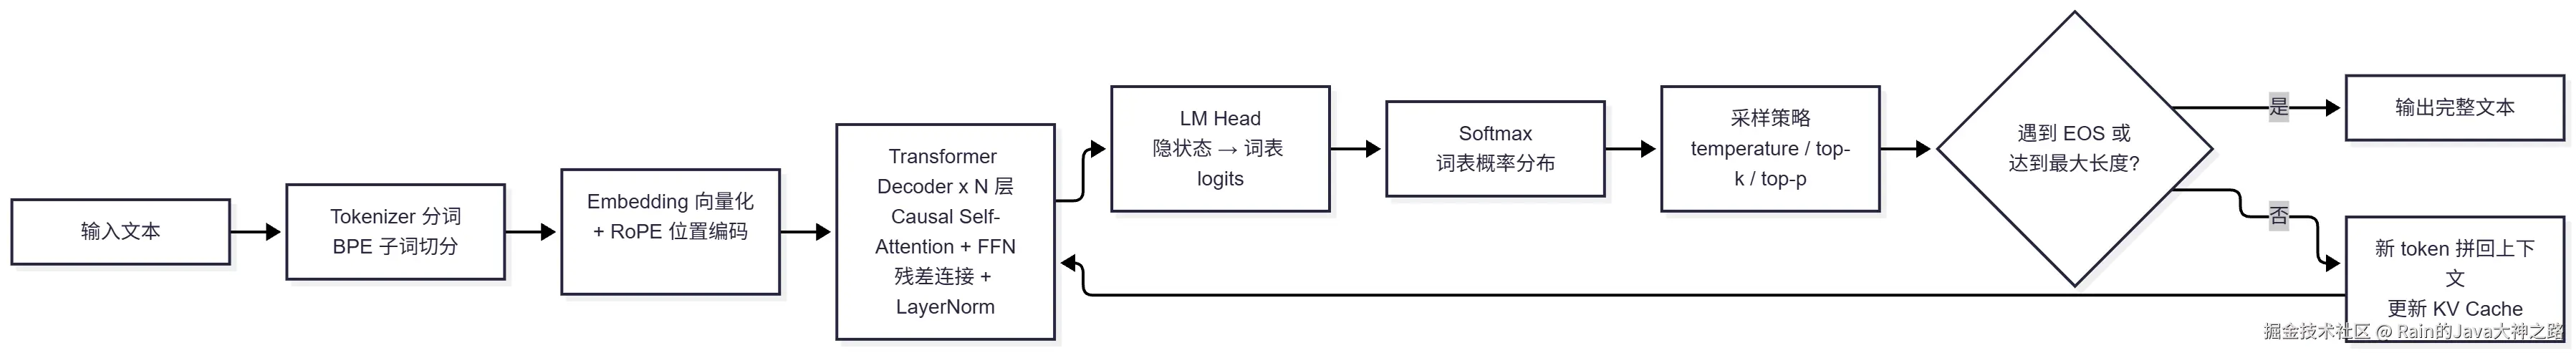
逐个拆开说。
1. Tokenizer:把文本切成词元
模型只认数字不认文字,所以第一步是把文本切成 token,转成 id 序列。主流用的是 BPE / WordPiece / SentencePiece 这类子词切分------不是按字切,而是按子词。比如 unhappiness 会被拆成 un + happi + ness,中文则常常一字一词一个 id。词表大小一般在 3 万到 15 万之间。
2. Embedding + 位置编码:让 token 变成"有序"的向量
Embedding 把 token 映射成高维向量。但注意力机制本身是不分顺序的,"猫抓老鼠"和"老鼠抓猫"在它眼里没区别,所以必须注入位置信息。主流做法是 RoPE 旋转位置编码,把"谁在前谁在后"旋进向量里。
3. Self-Attention:让每个字去"开会",决定该听谁的
一句话解释:每个 token 都去看其他所有 token,算相关性,再加权求和。具体靠 Q/K/V 三个矩阵:
- Q(Query):我想查什么;
- K(Key):每个词的"名片";
- V(Value):每个词的"实际内容"。
举个经典例子:
text
句子: "小明把苹果给了小红,因为她饿了"

Q: "她"想知道该关注谁
K: 每个词的名片
V: 每个词的内容

Attention(Q,K,V) = Softmax(Q·Kᵀ/√d) · V

结果: "她" → "小红" 的注意力权重最高 (0.87)
      "她" → "苹果" 的权重很低   (0.02)
模型就是这样"理解"了指代关系。
4. Causal Mask:只看左边,不许偷看答案
生成第 t 个 token 时,模型只能看到 0..t-1 的位置,未来位置全部挡住。这个因果掩码是自回归成立的地基------不挡住的话,模型就"作弊"了。
5. FFN + 多层堆叠 + LM Head
Attention 之后接 FFN 前馈网络做特征变换,配合残差连接和 LayerNorm 稳定训练,这样堆叠几十层,形成强表达能力。最后 LM Head 把最后一层隐状态投影到词表大小(几万到十几万维),输出 logits,再经 Softmax 变成概率分布。
关键点汇总成一张表:
| 关键点 | 一句话解释 | 加分表述 |
|---|---|---|
| Token 化 | 文本切成 token,词表 3w~15w | BPE 子词切分,unhappiness → un+happi+ness |
| Self-Attention | 每个 token 与其他所有 token 算加权相关性 | Q/K/V 三个矩阵,算相关性再加权求和 |
| 概率预测 | 输出是词表上的概率分布,不是"答案" | 所以 LLM 是生成式,不是检索式 |
流水线讲完了,但还有个问题:模型这一身本事是训练出来的,怎么训的?
三、接龙大师是怎么练成的:两阶段训练流水线
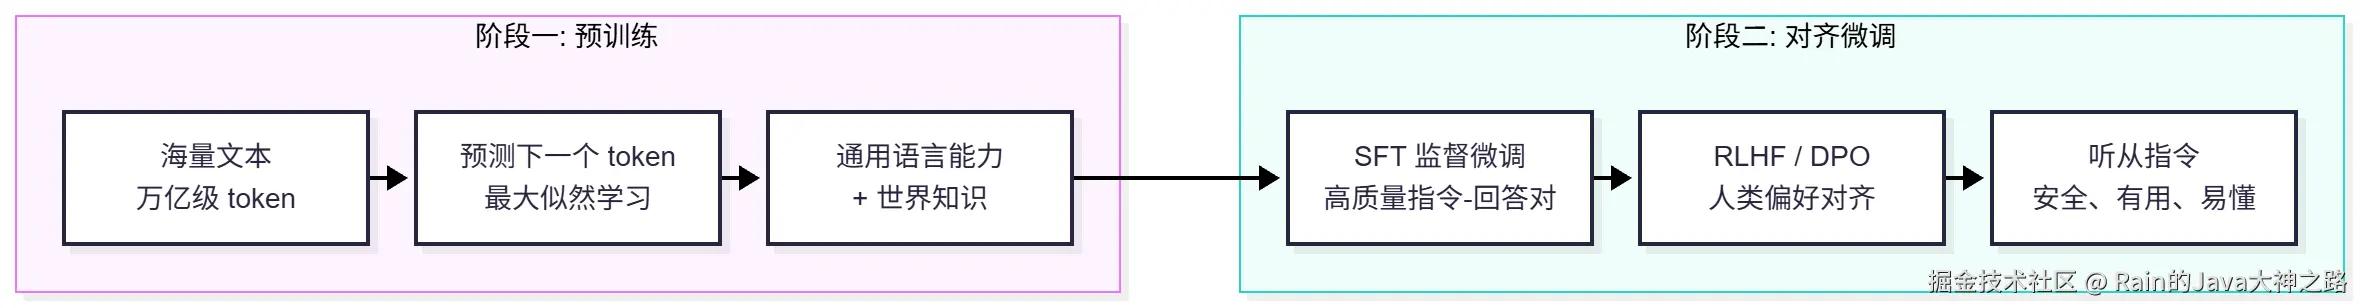
预训练是拿海量无监督文本(动辄万亿 token)喂模型,让它学人类语言的语法、知识和逻辑规律。训练目标简单粗暴:预测下一个 token。
但只会接龙的模型可能接出危险或不符合人类习惯的内容,所以要有第二步对齐微调 :先用 SFT 监督微调 ,拿高质量问答对教模型按指令回答问题;再用 RLHF / DPO 拿人类偏好数据做校准,让输出符合人类价值观。
整个生命周期拉通看:
| 阶段 | 核心目标 | 关键技术 |
|---|---|---|
| 预训练 | 学习通用语言能力与世界知识 | Transformer Decoder、自注意力、位置编码、大规模语料 |
| 对齐微调 | 让输出符合人类指令与价值观 | SFT 监督微调、RLHF / DPO 人类偏好对齐 |
| 推理生成 | 根据输入输出对应文本 | 自回归生成、KV 缓存、采样策略 |
注意,自回归是推理生成阶段的核心逻辑,也是本文的主角,下面正式请它登场。
四、自回归生成:一场一个字往外蹦的"文字接龙"
一句话定义:每次只生成一个 token,把生成的 token 拼回输入,再预测下一个......循环往复,直到生成终止符 EOS。
"自回归"这个翻译其实挺传神,拆词最好记:
- 自(Auto):上一步的输出,当作下一步的输入,自己吃自己;
- 回归(Regressive) :反复套用同一个模型、同一套参数。
数学上就是联合概率的条件概率链式分解:
P(x1,x2,...,xT)=t=1∏TP(xt∣x1,x2,...,xt−1)
翻译成人话:第 1 个词由上文决定,第 2 个词由"上文 + 第 1 个词"决定,第 3 个词由"上文 + 第 1、2 个词"决定......一步一步往后推。每个词的概率只依赖它之前的所有词------因果方向,不可逆。
来一遍完整的接龙示范:
text
Round 1: 输入 "今天"                → 预测 "天气"
Round 2: 输入 "今天天气"             → 预测 "真"
Round 3: 输入 "今天天气真"            → 预测 "好"
Round 4: 输入 "今天天气真好"           → 预测 "!"
Round 5: 输入 "今天天气真好!"         → 预测 <EOS>,停止
像多米诺骨牌,一次只能倒下一张。整个过程画成时序图:
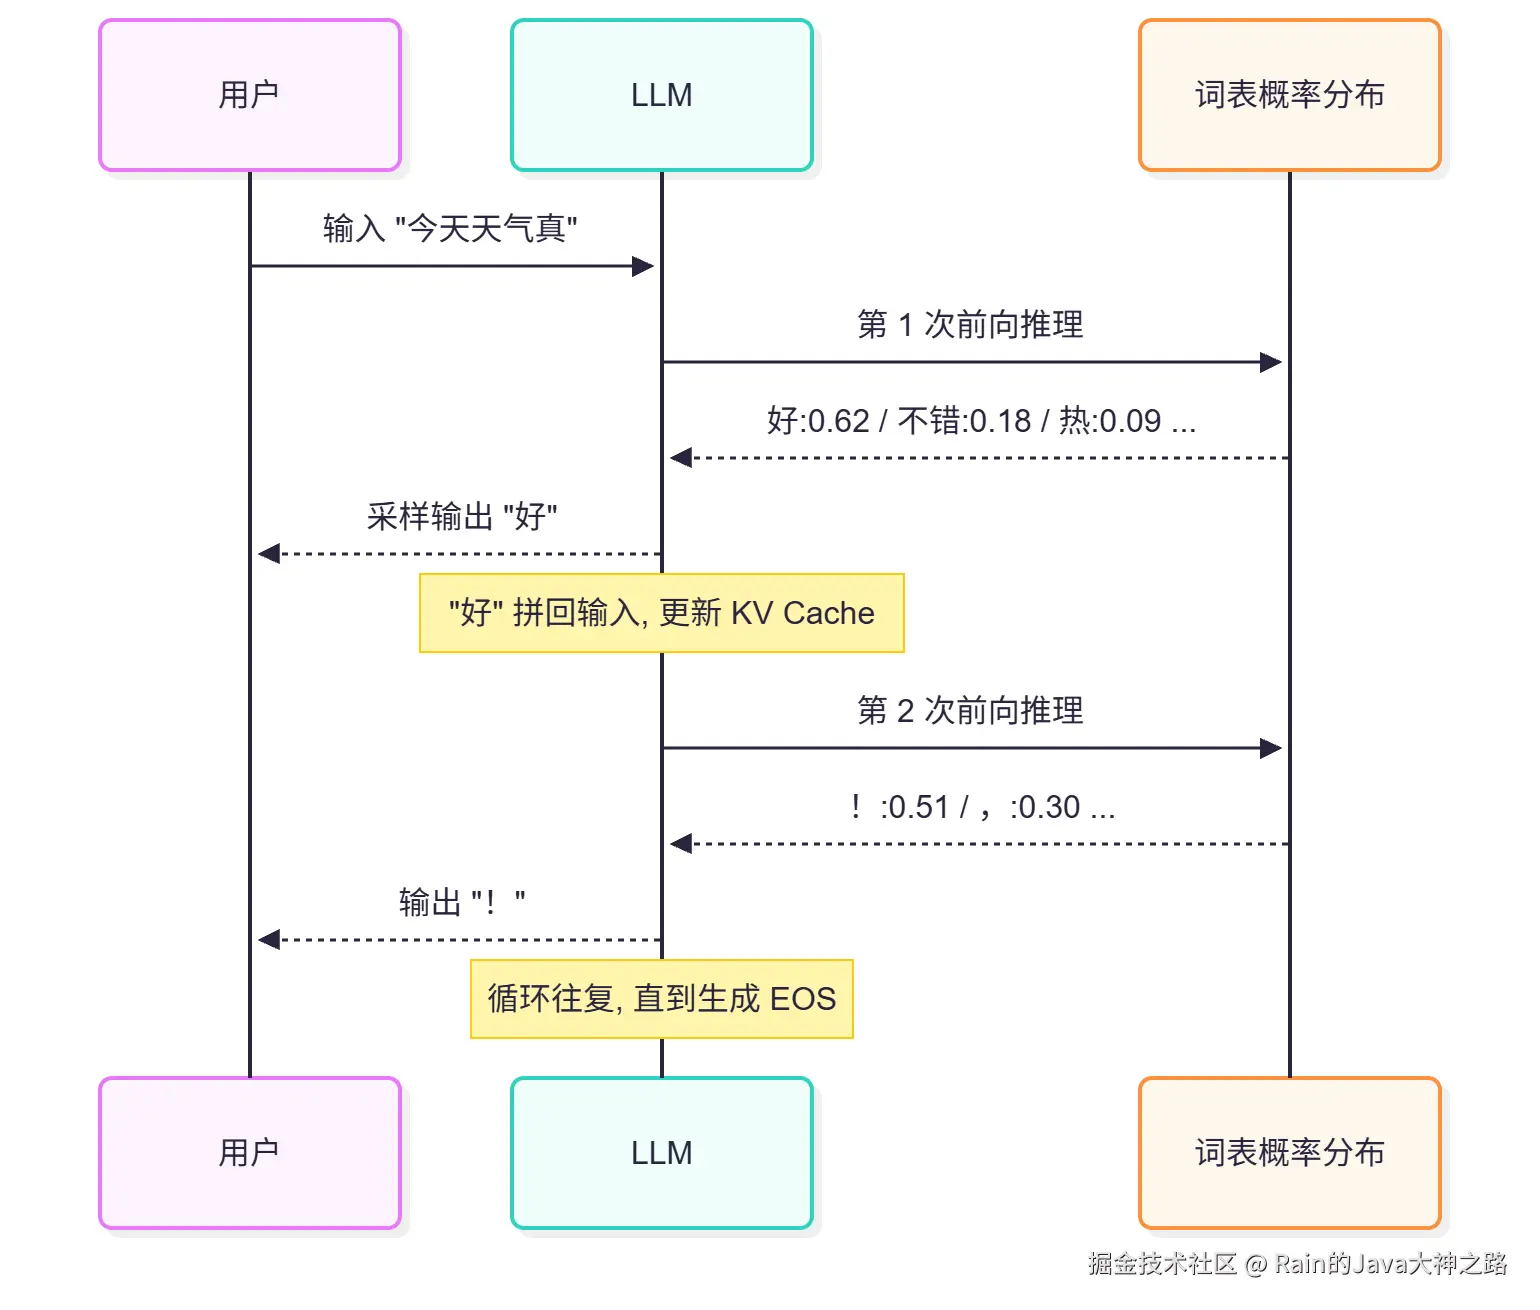
你在 ChatGPT 网页上看到的打字机效果,就是自回归生成 + 流式输出,一个字一个字蹦是真的,不是前端动画。
训练和推理:同一个模型,两种"吃法"
这里有个高频被追问的点:训练和推理用的是同一个模型,但执行方式完全不同。
| 对比项 | 训练 | 推理(自回归) |
|---|---|---|
| 输入来源 | 真实上文(Teacher Forcing) | 模型自己生成的上文(Free Running) |
| 掩码 | Causal Mask 挡未来 | Causal Mask 挡未来 |
| 执行方式 | 整句并行,一次算完所有位置的 loss | 真·串行,一个个 token 往外吐 |
| 吞吐特点 | 一次算完,效率最高 | token 级延迟,随长度线性增长 |
| Java 侧该盯啥 | 数据管道、语料清洗 | TTFT 首字延迟、TPOT 每字延迟、SSE 流式 |
有人会问:既然推理是串行,训练为什么不也串行?因为训练时答案是已知的(真实语料),用 Causal Mask 可以一次性并行算出所有位置的 loss,效率最高。那训练时为什么也要加 Causal Mask? 为了保证训练和推理的分布一致,防止模型"作弊"看到未来------不然推理时见到的场景和训练时对不上,效果直接崩。
顺带澄清一个架构误区:
- BERT 是双向的去噪自编码,擅长理解,不适合直接做生成;
- GPT / LLaMA 是 Decoder-only + 自回归,天然适合续写和对话,所以现在生成式大模型清一色走这条路。
自回归 vs 非自回归:不是只有一条路
也有非自回归的做法,一次并行全部生成出来,对比一下:
| 自回归(GPT / LLaMA) | 非自回归(BERT 填空 / MaskGIT) | |
|---|---|---|
| 生成顺序 | 串行,一个接一个 | 并行,一次出全部 |
| 长处 | 上下文连贯、质量高 | 速度快 |
| 短处 | 延迟随长度线性增长 | 连贯性差 |
| 适用 | 对话 / 写作 / 推理 | 图像生成、文本填空 |
自回归的好处是逻辑简单、生成可控、上下文连贯;缺点也很明显------串行。第 N 个 token 依赖第 N-1 个,天生没法并行,这就是 LLM 推理慢的根源。
那工程上怎么办?先认清推理的两个阶段。
五、推理的两阶段:Prefill 和 Decode,性格完全不同
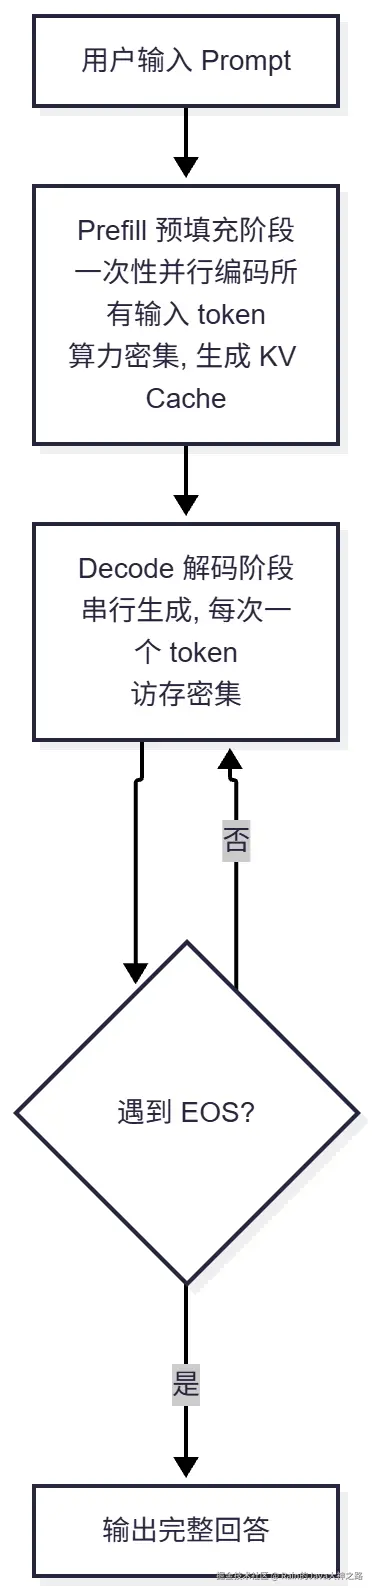
- Prefill(预填充) :把所有输入 token 一次性并行处理掉,吃满算力,是算力密集型,顺手把 KV Cache 建好;
- Decode(解码) :逐个串行生成,每步计算量不大,但要反复搬运大量参数和缓存,是访存密集型(memory-bound)。
这个差异直接决定了线上两个常聊的指标:
- TTFT(Time To First Token):首字延迟,主要受 Prefill 影响;
- TPOT(Time Per Output Token):每字延迟,由 Decode 决定。
用户盯着空白屏等,等的是 TTFT;读起来的流畅感,看的是 TPOT。而 Decode 阶段最大的优化空间,就是下一节的主角------KV Cache。
六、KV Cache:自回归的性能命脉
先算笔账:不做任何优化的话,生成第 1000 个词时,要把前 999 个词的 Attention 全部重算一遍。每步都全量重算,计算量随长度平方级膨胀,纯浪费。
KV Cache 的思路很直白:把历史 token 的 Key/Value 缓存在显存里,新 token 来了只算它自己的 Q,然后和缓存做 Attention。
| 方式 | 每步计算量 | 说明 |
|---|---|---|
| 无 KV Cache | 重算全序列 | 慢,浪费 |
| 有 KV Cache | 只算新增 token | 主流推理引擎必备 |
一句话:用显存换时间,把复杂度从 O(n²) 干到 O(n),长文本场景下推理速度能提升数倍。
这里有个高频追问:为什么只缓存 K/V,不缓存 Q?
因为 Q 是"我要查什么",每一步的 Q 只属于当前这个新 token,用完一次就没有复用价值了;而 K/V 是"被查询的名片和内容",后面每一个新 token 都要来查它们,才值得缓存。这也解释了为什么 KV Cache 会随上下文线性膨胀------显存爆炸的伏笔就在这,后面会讲怎么治。
用 Java 伪代码表示一下:
java
/**
 * KV Cache: 推理加速的关键
 * 不用每次重新计算所有历史 token 的 Key / Value
 * 真实形态: keyCache[layer][head][seq][dim], 生产上是 Tensor
 */
public class KVCache {
    private final Map<Integer, Tensor> keyCache = new HashMap<>();
    private final Map<Integer, Tensor> valueCache = new HashMap<>();

    public void append(Token newToken, int position) {
        // 只计算新 token 的 K、V 并追加进缓存,历史的不碰
        keyCache.put(position, computeKey(newToken));
        valueCache.put(position, computeValue(newToken));
    }

    public Tensor attentionWithCache(int currentPos) {
        Tensor query = computeQuery(currentToken);   // Q 只算当前位置的
        // 复用历史 K/V, 避免 O(n²) 重复计算
        return attention(query, keyCache, valueCache, currentPos);
    }
}
但 KV Cache 是有代价的:缓存随上下文线性增长,并发一高显存就爆。工业界的解法:
- PagedAttention(vLLM 的核心) :像操作系统管理虚拟内存一样,把 KV Cache 按"页"管理,按需分配、随时回收,还支持多请求前缀共享,显存利用率大幅提升;
- K/V 量化:用 FP8 等低精度压缩缓存体积;
- 工程侧淘汰策略 :会话级 LRU、
maxContext限流、请求取消时主动释放缓存。
划重点:PagedAttention 的分页思想,跟操作系统虚拟内存几乎一个套路------分页、按需分配、碎片治理。这就是后端工程师学 AI 的知识迁移优势,面试聊到这个,档次直接上一级。
缓存的问题解决了,每一步都输出了 logits 概率分布,新问题来了:怎么从里面挑一个词?
七、采样策略:不是取最大概率那么简单
有同学会说,每次取概率最大的不就完了?这叫 Greedy 贪心解码,稳定但死板,容易复读,输出千篇一律。真实系统都是采样:
| 参数 | 作用 | 效果 |
|---|---|---|
temperature |
调概率分布的平滑度 | <1 分布变尖,保守稳定;>1 分布变平,发散有创意 |
top_k |
只在前 K 个候选里采样 | 控制发散程度 |
top_p |
按累积概率截断(核采样 nucleus) | 更动态,0.9 时兼顾多样性又不跑偏 |
repetition_penalty |
抑制重复内容 | 常用 1.1~1.3 |
stop_words |
遇到指定词停止生成 | 业务侧停止控制 |
采样流程有固定顺序,顺序不能乱:

两个实战经验:
① Softmax 一定要先减 max。 直接对 logits 做 exp,数值稍大 float 就溢出,当场 NaN。先减去最大值,数学上等价,数值上稳定------这个细节大厂面试爱问,线上真踩过。
② temperature=0 也不完全确定。 理论上它退化成 greedy decode,结果应该可复现,但 GPU 浮点运算存在非确定性,严格场景别指望完全一致,得固定种子 + 低温组合着用。
复读机问题:三层兜底
重复是自回归的常见病:输出不断喂回输入,错误会累积放大,模型卡在"很好很好很好"里出不来。本质是暴露偏差(Exposure Bias)+ 采样空间塌缩,工程上一般三层兜底:
- 采样层:Top-P 0.8~0.9 + Temperature 0.7,砍掉尾部低质 token;
- 惩罚层 :对最近 N 个 token 的 logits 施加
repetition_penalty惩罚;- 产品层:检测到连续重复的 n-gram,触发重生成或直接打断。
如果还能碰训练侧,可以加 unlikelihood training,专门惩罚重复。
记住一句话:LLM 生成不是"查答案",而是**"按概率采样"**------这是所有输出不确定性的根源。
如果你也在学大模型工程,可以先点个关注,下一篇拆"Attention 为什么要除以 √d",这道追问一半人答不上来。
八、Java 实战:把流式生成链路串起来
先说清楚定位:真实推理跑在 GPU 上,活在 vLLM / Triton 里,Java 不用重造推理引擎 。但模型不归我们训,这条串行链路的低延迟和可治理,归我们管。真实链路长这样:
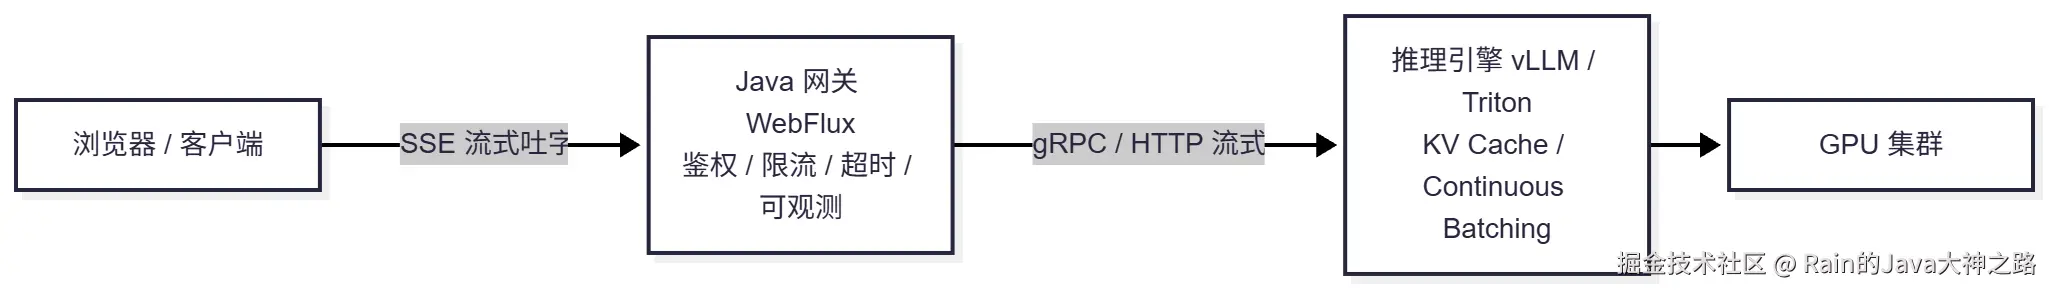
Java 侧该干的活,列个清单:
- 流式输出:SSE / WebSocket;
- 超时与取消、资源释放;
- Token 级限流、租户配额;
- 会话上下文管理;
- 模型服务网关与降级(兜底小模型)。
而 AI 方向 Java 研发的核心阵地就在这:RAG 编排、Agent 调度、流式输出、服务治理。下面用代码把整条链路串起来。
1. 生成配置:采样参数全部配置化
java
public record GenerateConfig(
        int maxNewTokens,
        float temperature,
        int topK,
        float topP,
        int eosTokenId
) {
    public static GenerateConfig ofDefault() {
        // 常用组合: temperature 0.7 + top-p 0.9, 兼顾稳定与多样
        return new GenerateConfig(256, 0.7f, 50, 0.9f, 2);
    }
}
2. 自回归主循环:一段代码看懂本质
java
/**
 * LLM 自回归生成服务(Java 编排层)
 * 亮点: Prefill/Decode 分离、KV Cache 增量推理、
 *      多重停止条件、可直接对接流式输出
 */
public class AutoregressiveGenerator {

    private final LlmModel model;      // 真实场景对接 vLLM / ONNX Runtime / 推理网关
    private final Tokenizer tokenizer;
    private final TokenSampler sampler;

    public String generate(String prompt, GenerateConfig config) {
        // 1. 编码: 文本 → token id 序列
        List<Integer> tokenIds = new ArrayList<>(tokenizer.encode(prompt));

        // 2. Prefill: 一次性并行处理全部 prompt, 建立 KV 缓存
        KVCache kvCache = model.prefill(tokenIds);

        StringBuilder result = new StringBuilder();
        for (int step = 0; step < config.maxNewTokens(); step++) {
            // 3. Decode: 只喂上一步的新 token, 复用 KV Cache
            //    性能关键: 避免每步重算整段前缀
            int lastToken = tokenIds.get(tokenIds.size() - 1);
            float[] logits = model.forwardOneStep(lastToken, kvCache);

            // 4. 采样: temperature → top-k → top-p
            int nextToken = sampler.sample(logits, config);

            // 5. 停止条件: EOS / 最大长度(生产再加超时与取消信号)
            if (nextToken == config.eosTokenId()) {
                break;
            }

            // 6. 自回归的精髓: 把刚生成的 token 拼回序列
            tokenIds.add(nextToken);
            result.append(tokenizer.decode(nextToken));
        }
        return result.toString();
    }
}
3. 流式版本:打字机效果就是这么实现的
java
/**
 * 流式生成: 每个 token 实时推给前端
 * doOnCancel 是踩坑点: 前端关页面必须释放 KV 缓存,
 * 否则显存慢慢漏, 服务跑几天就得重启
 */
public Flux<String> generateStream(String prompt, GenerateConfig config) {
    List<Integer> ids = tokenizer.encode(prompt);
    KVCache cache = model.prefill(ids);

    return Flux.generate(
        () -> new StepState(ids.size(), cache, 0, lastOf(ids), false),
        (state, sink) -> {
            // 三重停止: 最大长度 / EOS / 外层再加 timeout + cancel
            if (state.step() >= config.maxNewTokens() || state.done()) {
                sink.complete();
                return state;
            }
            // 只喂「上一个 token」+ cache, 不重算整段前缀
            float[] logits = model.forwardOneStep(state.lastToken(), state.cache());

            int next = sampler.sample(logits, config);
            if (next == config.eosTokenId()) {
                sink.complete();
                return state.markDone();
            }
            sink.next(tokenizer.decode(next));   // SSE 推前端, 首字不等全篇
            return state.advance(next);
        }
    ).doOnCancel(cache::release);   // 关键: 断连时回收缓存
}
4. 采样器:顺序和数值稳定性
java
/**
 * 采样: 顺序很重要 ------ Temperature → Top-K → Top-P → 随机采样
 */
public class TokenSampler {

    public int sample(float[] logits, GenerateConfig config) {
        // 1. 温度缩放 + Softmax: T<1 锐化更稳, T>1 平滑更发散
        float[] probs = softmax(logits, config.temperature());
        // 2. Top-K: 只保留概率最大的 K 个候选
        List<Integer> candidates = topKFilter(probs, config.topK());
        // 3. Top-P(核采样): 累积概率达到 p 就截断
        candidates = nucleusFilter(candidates, probs, config.topP());
        // 4. 轮盘赌: 候选集内按归一化概率随机抽一个
        return rouletteWheelSelect(candidates, probs);
    }

    private float[] softmax(float[] logits, float temperature) {
        // 亮点: 先减 max 防 exp 溢出, 数值稳定
        float max = Float.NEGATIVE_INFINITY;
        for (float v : logits) max = Math.max(max, v);

        float temp = Math.max(temperature, 1e-5f);
        float sum = 0f;
        float[] probs = new float[logits.length];
        for (int i = 0; i < logits.length; i++) {
            probs[i] = (float) Math.exp((logits[i] - max) / temp);
            sum += probs[i];
        }
        for (int i = 0; i < probs.length; i++) probs[i] /= sum;
        return probs;
    }

    private List<Integer> nucleusFilter(List<Integer> cand, float[] probs, float topP) {
        cand.sort((a, b) -> Float.compare(probs[b], probs[a]));
        float cum = 0f;
        List<Integer> nucleus = new ArrayList<>();
        for (int id : cand) {
            nucleus.add(id);
            cum += probs[id];
            if (cum >= topP) break;   // 累积概率达到核阈值即截断
        }
        return nucleus;
    }
    // topKFilter / rouletteWheelSelect 略, 逻辑同名字所示
}
5. Spring AI 快速接入
不想自己写循环,Spring AI 已经封装好了:
java
@RestController
public class ChatController {

    private final ChatModel chatModel; // Spring AI 统一抽象

    public ChatController(ChatModel chatModel) {
        this.chatModel = chatModel;
    }

    @GetMapping("/stream")
    public Flux<String> stream(@RequestParam String prompt) {
        return chatModel.stream(new Prompt(prompt))
                .map(resp -> resp.getResult().getOutput().getText())
                .filter(Objects::nonNull); // 流式吐字
    }
}
流式输出(SSE / WebFlux)的本质,就是把自回归的每个 token 实时推给前端------原理和工程在这一下就串起来了。
6. WebClient 调 OpenAI 兼容协议
真实业务里更多是远程调模型服务:
java
@Service
public class ChatStreamService {

    private final WebClient webClient = WebClient.builder()
            .baseUrl("https://open.bigmodel.cn/api/paas/v4")
            .build();

    public Flux<String> streamChat(String userMessage) {
        return webClient.post()
                .uri("/chat/completions")
                .header(HttpHeaders.AUTHORIZATION, "Bearer " + apiKey)
                .bodyValue(Map.of(
                        "model", "glm-4",
                        "messages", List.of(Map.of("role", "user", "content", userMessage)),
                        "stream", true   // 流式开关, 逐 token 增量推送
                ))
                .retrieve()
                .bodyToFlux(String.class)
                .filter(line -> !"[DONE]".equals(line))
                .map(this::extractDeltaContent)   // 解析每帧的增量 token
                .timeout(Duration.ofSeconds(60))
                .retryWhen(Retry.backoff(2, Duration.ofMillis(500)));  // 指数退避重试
    }
}注意重试一定要指数退避,LLM 超时后无脑重试,会把 GPU 瞬间打满------重试风暴打挂推理服务这种事,真不少见。
7. Java 21 虚拟线程:低成本扛高并发流式
流式调用是典型的长连接 IO 密集任务,平台线程一个请求占一个,扛不住,虚拟线程正好对口:
java
// Java 21+: 用虚拟线程低成本支撑高并发 LLM 流式调用
try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
    IntStream.range(0, 10_000).forEach(i -> executor.submit(() -> {
        var req = HttpRequest.newBuilder(URI.create(llmUrl))
                .header("Content-Type", "application/json")
                .POST(HttpRequest.BodyPublishers.ofString(json))
                .build();
        var resp = httpClient.send(req, HttpResponse.BodyHandlers.ofLines());
        resp.body()
            .filter(line -> line.startsWith("data:"))   // OpenAI / vLLM SSE 格式
            .forEach(this::pushToClient);               // 逐 token 推给前端
        return null;
    }));
}
一个容易忽视的坑:Tokenizer 一致性
推理服务多在 Python 侧,如果 Java 侧另搞一套分词,两边 Tokenizer 不一致,同一句话编码结果不同,输出直接错乱。解法:统一 Tokenizer(比如用 HuggingFace Tokenizers 的 Java binding),并把 encode 结果缓存,避免重复计算。
KV Cache 降计算、Top-p 控多样性、SSE 做流式、虚拟线程 / WebFlux 抗高并发------这四板斧下去,Java 侧就能把 LLM 接得明明白白。但真上了线,还有更棘手的问题等着你。
九、八大难点与解决方案
把 LLM 工程化的常见难点归成三类:性能成本、生成质量、Java 工程。先看表,再展开重点。
性能与成本类
| 难点 | 本质原因 | 解决方案 |
|---|---|---|
| 串行生成慢 | 每个 token 都要一次前向,天生无法并行 | KV Cache 复用、Continuous Batching、投机解码、INT4/INT8 量化 |
| Attention 计算/显存爆炸 | Attention 是 O(n²) 复杂度 | FlashAttention、滑动窗口注意力(Mistral)、PagedAttention |
| KV Cache 显存膨胀 | 缓存随上下文线性增长,并发一高就 OOM | PagedAttention 分页 + 前缀共享、K/V 量化(FP8)、会话级 LRU、maxContext 限流、cancel 时释放 |
| 吞吐低 | 单条请求打不满 GPU | Continuous / Dynamic Batching、Prefix Caching、请求队列 |
| 部署成本高 | 模型太大,普通服务器部署不了 | 量化(4bit/8bit)、剪枝、知识蒸馏、LoRA 轻量化微调、张量/流水线并行分布式部署 |
| 延迟-吞吐-成本不可能三角 | 三者难以兼得 | PD 分离架构:Prefill / Decode 分离部署,各自配最优硬件 |
两个值得展开的亮点:
投机解码(Speculative Decoding) :让小模型先"猜" N 个 token,大模型再一次性并行验证,猜对就直接采纳,提速 2~3 倍 。本质是用廉价计算去赌昂贵的串行,非常聪明的设计。还有 Medusa,给大模型加多个预测头并行预测,思路类似。
Continuous Batching(连续批处理) :传统静态批处理要等一批里最慢的请求,快的只能干等,GPU 空转;连续批处理按迭代粒度动态组批,谁完成谁出队,新请求随时插入,GPU 始终满载,吞吐翻几倍。这是 vLLM / SGLang 高吞吐的标配。
生成质量类
| 难点 | 本质原因 | 解决方案 |
|---|---|---|
| 幻觉 | 只建模"像不像",不理解"对不对" | RAG 检索增强、CoT 思维链、引用溯源、生成后事实校验、低温、Function Call 工具调用、SFT+DPO 高质量对齐、认知稳态治理(让模型知道自己不知道) |
| 重复退化 | 暴露偏差 + 采样空间塌缩 | Repetition Penalty(1.1~1.3)、Top-P / Temperature 调参、产品层 n-gram 检测重生成、unlikelihood training |
| 输出不可控 | 自由文本容易跑偏 | System Prompt 约束、Function Calling、JSON Schema 校验、Grammar / JSON 约束解码 |
| 长上下文退化 | 超出训练长度 RoPE 掉点、注意力失焦 | RoPE scaling / NTK 外推、滑动窗口注意力、RAG 检索切块而非整篇塞 prompt、摘要压缩、向量检索记忆,支撑 128K 级长上下文 |
| 训练-推理不一致 | 训练喂真值,推理喂自己的输出 | Scheduled Sampling、RLHF 偏好对齐 |
| 输出不稳定 | 采样本身有随机性 | 降低 temperature、固定种子、Top-P / Top-K 约束 |
关于幻觉,一句话最实在:别让模型裸答。事实类业务要么上 RAG 外挂知识库,要么让它走 Function Call 调工具,再配上引用溯源------概率模型不保证事实,这不是 bug,是机制。
Java 工程类
| 难点 | 本质原因 | 解决方案 |
|---|---|---|
| 用户盯着空白屏 | 首字延迟高 | SSE 流式首字优先、首包优化、断线重连 |
| 背压与断连 | 模型生成慢、前端关页面、线程池被打满 | Flux 背压、信号量限流、异步 gRPC 不阻塞 Tomcat 线程、doOnCancel 回收缓存、SSE 心跳 |
| 高并发 GPU 压力大 | GPU 昂贵,容易被打满 | Token 级限流、请求队列、租户配额、降级小模型、Resilience4j 熔断 |
| 会话上下文膨胀 | 多轮对话历史越滚越大 | 滑动窗口截断、摘要压缩、向量检索记忆 |
| Java 与推理栈集成 | 推理在 Python / GPU 服务里 | gRPC / HTTP / SSE 调用;DJL / ONNX Runtime;统一 Tokenizer 避免跨语言偏差 |
推理框架怎么选
最后看下主流推理框架,按场景选型:
| 框架 | 核心亮点 | 适用场景 |
|---|---|---|
| vLLM | PagedAttention,显存利用率高 | 高吞吐在线服务 |
| TensorRT-LLM | NVIDIA 硬件深度优化 | NVIDIA GPU 上追求极致性能 |
| SGLang | 结构化生成优化 | 复杂多轮对话、结构化输出 |
Java 生态这边可以提 DJL、ONNX Runtime,或者直接调 vLLM 的 OpenAI 兼容接口 / Java SDK------模型服务黑盒化,治理能力握在自己手里。
十、面试追问小抄
这道题在面试里通常只是开胃菜,追问才是深水区。高频问题清单,提前备好:
Q1:为什么用 Self-Attention 不用 RNN? 训练可并行,长距离依赖直接建模------任意两个 token 之间的路径长度是 O(1),RNN 得一步步传。
Q2:temperature=0 就完全确定了吗? 理论上退化成 greedy decode,但 GPU 浮点运算存在非确定性,别指望严格复现。
Q3:自回归能不能加速? 投机解码:小模型先猜 N 个,大模型一次验证;还有 Medusa 多头并行预测。
Q4:Prefill 和 Decode 阶段的区别? Prefill 并行、算力密集;Decode 串行、访存密集(memory-bound)。所以推理优化大多在"怎么省访存"上做文章。
Q5:训练时为什么也要加 Causal Mask? 保证训练和推理的分布一致,防止模型"作弊"看到未来。
Q6:KV Cache 为什么只缓存 K/V,不缓存 Q? Q 只属于当前新 token,用完即弃;K/V 要被后面所有 token 查询,才值得缓存。
Q7:Continuous Batching 怎么提升吞吐? 按迭代粒度动态组批,完成的请求立刻出队、新请求随时插入,避免短请求等长请求,GPU 始终满载。
Q8:让你设计一个 Java LLM 网关,怎么分层? 路由 + 鉴权 + 流式 + Batching + 限流 + 缓存 + 可观测,模型推理交给 vLLM / Triton,网关只做治理。
面试官其实就看四个维度:概念准确度 (Token / Attention / 概率分布)、深度 (公式、KV Cache、O(n²)→O(n))、工程落地 (采样参数、流式、能写代码)、问题意识(幻觉 / 延迟 / 复读,有解法清单)。能主动把话题往 TTFT、KV Cache、背压释放上引,基本就和"背过博客"的候选人拉开差距了。
最后送个记忆口诀:
分词向量进 Transformer, 因果掩码只看左; 预测下一个 token, 拼回去再预测------就是自回归。
十一、写在最后
三句话收束全文要点:
- LLM 本质:基于 Transformer 把海量语料压成条件概率分布,给定上文,预测下一个 token;
- 自回归生成:条件概率的链式分解,把输出回灌成输入,逐 token 生成,串行是它的命门,也是所有优化的起点;
- 工程关键:Prefill 并行 + Decode 串行,靠 KV Cache、采样策略、流式输出、批处理这四板斧,撑起大模型的线上体验。
四条落地建议:
- 接 LLM 先上流式输出,首字延迟从秒级降到毫秒级,体验直接上一个档次;
- 采样参数配置化,代码生成用低温求严谨,创意文案用高温求发散,不同场景不同 profile;
- 把 LLM 当"不可靠下游"治理:超时、退避重试、限流、降级、断连释放缓存,一个都不能少;
- 别让模型裸答,事实类业务上 RAG 或工具调用,配上引用溯源。
如果这篇文章对你有帮助,点赞、在看、关注就是最大的支持,号里会持续更新 AI + Java 工程化的实战内容。
最后留个互动话题:你在项目里用的 temperature / top_p 组合是多少?踩过哪些复读或幻觉的坑? 评论区聊聊你的经历。