利益相关:我是「页边 ThinRead」的作者。项目 MIT 开源,macOS 桌面端,当前版本 0.2.2。
这篇不讲怎么接大模型。它是一份已经发布的桌面产品复盘:哪些架构约束最后真的改变了产品,哪些看起来正确的做法其实走不通。
页边想解决的问题很具体:读完一章之后,能不能留下一篇可以继续改的稿子、几张有原文依据的卡片,以及一条和其他书之间的连接?
它不是一个书摘仓库,也不是问答机器人。主链路是:
text
导入 → 阅读 → 读薄 → 卡片 → 连接 → 成书 / 分享卡 / 播客当前版本大概能做这些事:
- 导入 EPUB、PDF、MOBI 等 8 种文件,也能导入网页、OPDS、微信读书、Readwise 和 Kindle 划线;
- 扫描版 PDF 用 macOS PDFKit + Vision 做 OCR,单次最多 300 页;
- 按断言把整章改写成底稿,保留观点和原文依据;
- 从底稿提炼卡片,每张卡片要求逐字引用;
- 本地语义索引做跨书回声、知识地图和人物关系图;
- 成书、Markdown / HTML / 排版 PDF、6 种分享卡、小红书 3:4 图文、千问 TTS、A/B 双人播客;
- 19 个 AI 工作台工具,共用同一份书和笔记;
- Electron + React + TypeScript,数据落在本地 SQLite 和文件里。0.2.2 把数据库拆成
db-books/db-notes/db-content/db-reading/db-health,db.ts只保留兼容门面。
下面按真实的取舍来讲:为了让"本地优先"和"引用可信"不只是宣传语,代码里到底做了什么。
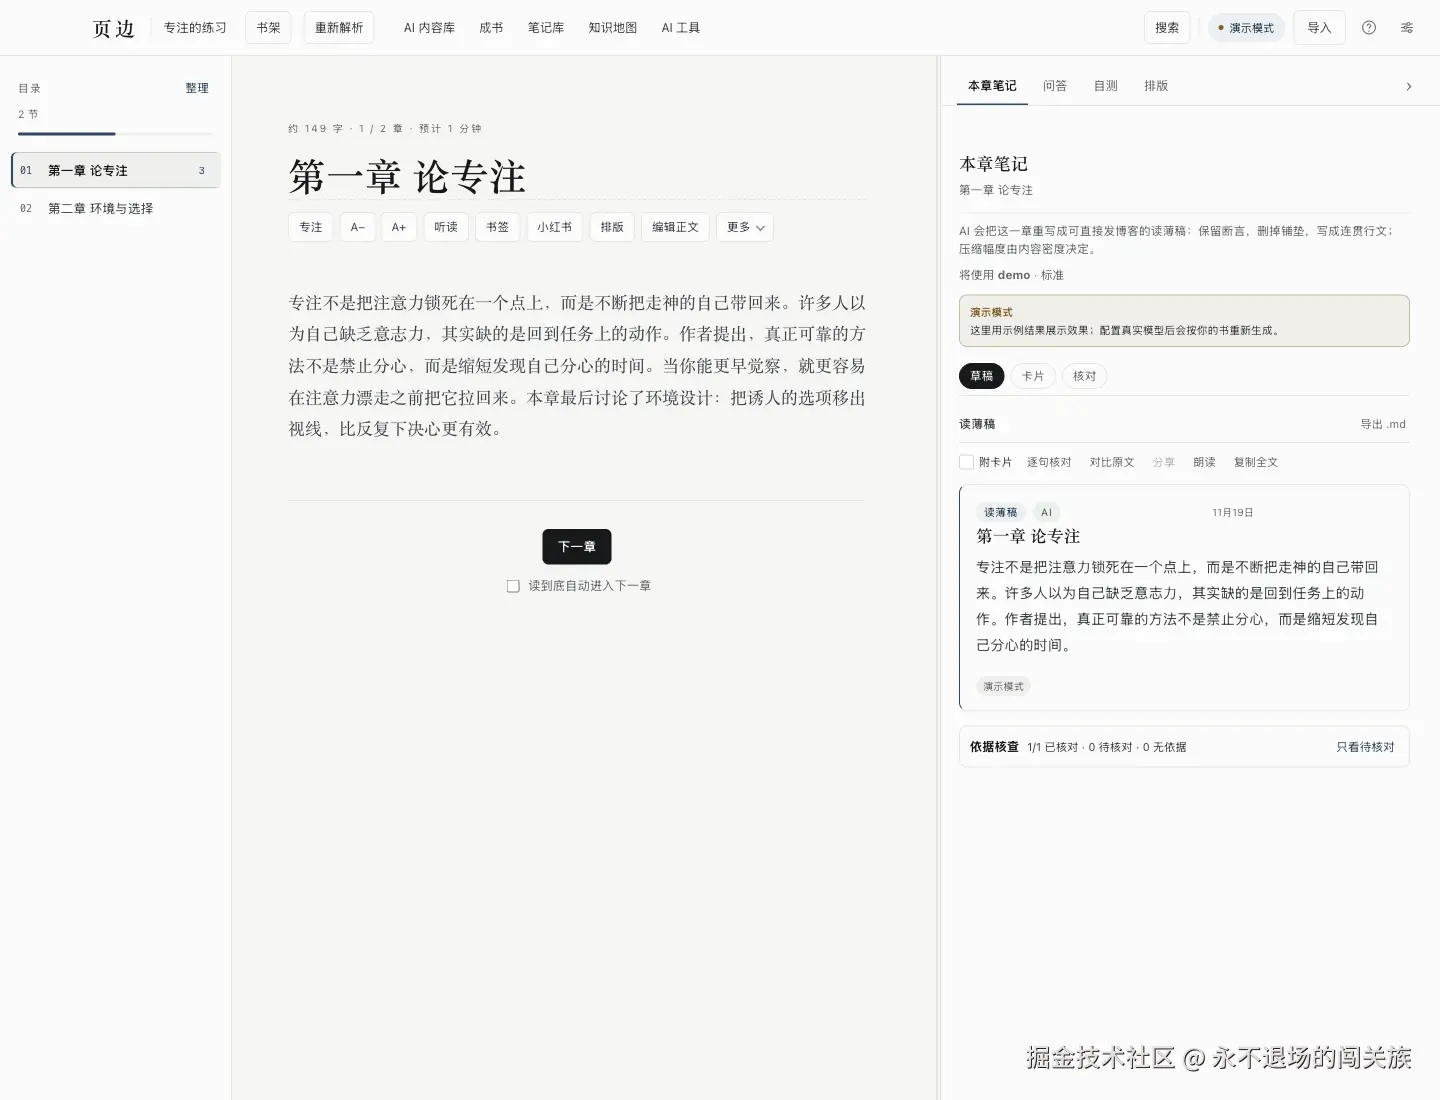
图 1:阅读器里的正文、本章笔记和读薄稿
两条不能妥协的约束
页边有两个不肯让步的地方。
一个是数据边界。书、章节、笔记、生成历史都在本机;AI 调用由用户显式触发;语义计算在本地完成。这不是写在隐私政策里的承诺,是架构本身。
另一个是模型输出不可信。生成结果要经过引用核对、结构校验和可回滚的写入,不能直接覆盖用户的数据。
这两句话落到工程上,会变成一串很具体的问题:
- 哪些计算必须留在本机,哪些可以出网?
- 流式输出到一半断了,已经写入的笔记怎么办?
- 模型把引用改了一个字,算不算通过?
- 本地向量模型首次下载和索引重建怎么处理?
- 用户换模型、换服务商,流式协议、JSON 模式、缓存策略都不一样,抽象层怎么切?
下面按这些问题拆。
数据流和边界
整体结构不复杂,但边界卡得很死:
text
┌──────────────────────────────────────────┐
│ Renderer: React + TypeScript             │
│ 书架 / 阅读器 / 笔记库 / 工作台 / 设置     │
└───────────────────┬──────────────────────┘
                    │ typed IPC(preload)
┌───────────────────▼──────────────────────┐
│ Electron main                            │
│ 导入 / 解析 / AI / 导出 / 备份 / 任务中心  │
└───────┬──────────────────┬───────────────┘
        │                  │
   SQLite + 文件       模型服务(可选)
        │
  本地 BGE-small-zh 向量索引
几个关键边界:
- 渲染进程不能直接 import Electron 或 Node 内置模块,CI 里有
check:boundaries拦; - 主进程负责文件、数据库、模型调用、导出和备份,渲染进程只通过 typed IPC 说话;
- 书文件、数据库、导出物都在本机。主要的出网路径只有三条:用户主动触发的模型调用、网页 / OPDS 导入,以及首次下载约 23 MB 的量化向量模型;
- API Key 存在系统钥匙串;钥匙串不可用时回退到
0600文件,并在设置里明确告诉用户这是明文。
这个结构不新,但它让"local-first"变成了可以检查的约束,而不是一句口号。
导入链路里,脏数据是常态
阅读工具的第一道坎不是 AI,是导入。EPUB 的目录结构千奇百怪,PDF 有扫描版、双栏、页眉页脚、代码块,网页正文里混着导航和广告,微信读书、Readwise、Kindle 的划线格式又各不相同。
处理顺序是:先判断来源和格式,再做正文抽取或 OCR,然后分章,最后才进阅读器。扫描版 PDF 用 PDFKit 渲染页面、Vision 逐页 OCR;Docling 深度解析用来恢复代码换行和缩进;目录页、版权页和广告页会被识别并隐藏。
这块没有"一次做完"的捷径。每多支持一种输入,就多一堆边界情况。但它决定了后面的读薄和卡片是不是建立在干净文本上。
引用核对:让模型过不了这一关
AI 笔记最危险的地方,是它看起来很对,引用却是编的。
页边的规则很简单:每张生成的卡片必须带一段原文引用,引用必须能在章节正文里逐字找到;找不到就标成"待核对"或"无引用",不允许冒充作者原话。
简化后的逻辑大概是这样:
ts
// 简化示意:normalize 的具体实现省略
declare function normalize(value: string): string

function verifyQuote(quote: string, chapter: string) {
  const q = normalize(quote)
  const c = normalize(chapter)

  if (!q) return { status: 'missing' as const }
  return c.includes(q)
    ? { status: 'verified' as const }
    : { status: 'pending' as const }
}

// normalize 会处理空白、换行、全半角标点和 OCR 噪声;
// 实际实现还会保留原文位置,方便点击回到章节。
代价是有的:
- 模型偶尔改一个词、合并两句话,引用就会失败;
- OCR 噪声会让一些本来正确的引用变成"待核对";
- 用户会看到更多"不完美"的状态,而不是一个干净漂亮的摘要。
但它换来了一个更重要的东西:用户敢引用。对阅读笔记来说,可信度比覆盖率重要。宁可少一张卡片,也不要多一条假引用。
引用状态要进入 UI
"核对"不能只停在数据库里。页边把每条引用标成已核对 / 待核对 / 无引用,笔记库可以按这个筛,章节有覆盖度,读薄稿、成稿和报告可以做版本 diff。
这带来一个反直觉的体验:用户第一眼看到的不是"完美笔记",而是"哪些地方还需要看"。但这正是阅读工具该有的样子。AI 负责起草,人负责确认。
流式输出,但不能写半成品
模型输出是流式的,但数据库写入不能是流式的。
页边的做法:
- 宽松解析流式片段。模型可能在 JSON 前后加说明文字,也可能在流式过程中输出不完整结构,先用宽松解析拿到候选对象;
- 字段和类型归一化。把常见的枚举、空值、数组和字符串混用修到可校验的形态;
- zod 校验。通过后才允许写库;
- 纯文本 JSON 兜底。结构化解析失败时,再尝试从纯文本里提取 JSON;
- 失败不覆盖。无效 payload 直接拒绝,不会把原来好的笔记冲掉。
还有一个容易忽略的点:格式化和改写要可回滚。页边把格式化结果单独存在 formatted_html 里,原始 HTML 不销毁;成稿历史保留多个版本,最多 40 个,可恢复。
这套东西的工程成本不低,但它避免了一类很恶心的问题:用户看到一半结果,刷新之后笔记变成半截,或者原始内容被一次失败的重写覆盖。
本地向量:不把笔记传上去
跨书连接是页边和普通笔记工具差别最大的地方,也是最容易做成"云端黑盒"的地方。
页边的选择是:用本地 BGE-small-zh 计算笔记向量,索引和缓存都留在本机。
具体做法:
- 对笔记标题、标签和正文做 embedding;
- 向量缓存到本地,按内容哈希更新;
- 跨书回声、知识地图、人物关系图共用这份索引;
- 笔记内容不出网。只有用户主动调用在线模型时,才发送必要的章节正文。
代价也很明确:
- 首次要下载约 23 MB 的量化模型;
- 索引重建需要时间,书多的时候更明显;
- 中文语义效果优先,其他语言的跨书召回会弱一些;
- 本地模型的能力上限不如最大的云端模型。
但这是我认为值得的取舍。阅读笔记是很私人的数据,如果为了"更准一点"把所有笔记上传到云端,产品的信任基础就变了。
模型层:AI 是可选件
页边没有把产品绑死在一家模型上。当前内置 13 套预设(12 家服务商加演示模式),包括 DeepSeek、智谱 GLM、Anthropic、OpenAI、Moonshot、阿里云百炼、OpenRouter、OpenCode Zen / Console、OpenCode Go、OpenDesign Cloud,以及本地 Ollama 和 LM Studio。任意 OpenAI 兼容端点也可以填。
抽象层不是换一个 baseURL 就结束了。实际要处理的差异包括:
- 流式响应的分片格式;
- JSON 模式、结构化输出的支持程度;
- Anthropic 的
cache_control和 OpenAI 兼容端的自动前缀缓存; - 千问 TTS 的原生协议;
- 不同服务商的限流、错误码和重试策略;
- 本地 Ollama / LM Studio 没有 Key、模型名不固定的情况。
主流程统一走 OpenAI 兼容层,Anthropic 和 TTS 用原生适配器;失败只对 429、5xx、超时这类可恢复错误做指数退避重试。
| 差异点 | 处理方式 |
|---|---|
| 流式分片 | 统一适配成增量文本 |
| JSON 输出 | 优先结构化解析,失败走纯文本兜底 |
| 前缀缓存 | Anthropic 显式 cache_control,OpenAI 兼容端依赖自动缓存 |
| 本地模型 | Ollama / LM Studio 免 Key、模型名不固定 |
| TTS | 千问原生协议单独适配 |
还有一个产品判断:AI 是可选件。没有 API Key 时,演示模式可以走完整条链路;本地 Ollama 也能免 Key 使用。用户可以先看清楚"读薄、卡片、核对、导出"到底长什么样,再决定要不要接真实模型。
数据完整性:本地产品没有服务端兜底
阅读工具的数据是长期资产。功能少一点可以补,数据坏了很难救。
页边在数据层做了这些事:
- SQLite 迁移按
PRAGMA user_version顺序执行,事务内失败回滚; settings.json用临时文件加 rename 原子替换;损坏文件保留为.corrupt-<timestamp>,在界面里提示,而不是静默重置;- 笔记读取时也做校验:非法枚举降级为安全值,坏 JSON 跳过并计数,计数进入诊断包;
- 书、章节、笔记、生成物都有 30 天回收站;
- 合并、拆分、重解析、删除前自动备份;自动备份保留 8 份;
- 书文件按内容哈希去重,备份不会因为重复文件膨胀。
这些工作用户平时看不见,但它们是"本地优先"能成立的前提。云端产品可以靠服务端兜底,本地产品只能靠自己的写入路径足够克制。
跨设备也一样:没做实时同步,只做手动快照。可以推整库,也可以只推一份不含书文件的精简笔记快照;快照可选 AES-256-GCM 加密成 .thinsync,口令不落盘。合并时按时间戳只取较新的笔记、PDF 标注、书签、阅读位置、统计和周复盘,不删除本地内容;本地没有的书会连同章节和书文件一起导入。恢复前会先备份当前状态,还可以先"比较"本地和远端的记录数量,再决定合并还是整库恢复。
这个方案不性感,但它承认了一个事实:本地优先的同步,难点不在把文件传上去,而在两边都改过之后,怎么不悄悄丢数据。
成本和速度
AI 阅读工具很容易变成"每点一次都在烧 token"。页边做了几层缓存和并发控制:
- 读薄按段落并发,标准 / 快速模式最多 6 路,深度模式 4 路;
- 断言审计和卡片提取并行;
- 结果按"章节内容 + 模型 + 质量档位"的内容哈希缓存 14 天,命中时 0 token;
- 深度模式复用 24k token 的源文前缀,Anthropic 用显式
cache_control,OpenAI 兼容端依赖自动前缀缓存; - 短章节、低压缩比、小卡片集会自动跳过不划算的阶段;
- 全文索引缓存成
search-index.json.gz,签名不变时直接加载; - 生成快照按"工具 + 范围"只保留最近 30 个,收藏和当前版本不剪。
这些优化不改变产品形态,但会直接影响用户愿不愿意长期用。一个每次读一章都要重新算全书的工具,很难成为日常工具。
视觉 PDF 的跨平台渲染
视觉 PDF 是导入链路里最贵的一步:把每一页渲染成图片,再交给视觉模型转成 Markdown。它适合扫描版、教材、跨页表格和图表很多的 PDF,但也最容易把平台限制暴露出来。
最早的实现只支持 macOS:主进程调用一个 Swift 脚本,用 PDFKit 把页面导成 JPEG。Windows / Linux 上点下去只会得到一句"暂不支持"。这不算错,但对一个 local-first 工具来说,渲染层被一个平台写死,后面的跨平台就无从谈起。
0.2.2 的做法是加一条跨平台兜底,而不是重写整条链路:
ts
// 先试 macOS 的 Swift 渲染
let rendered = await renderPdfPages(sourcePath, imageDir, batch)

// 失败或平台不支持时,用 pdfjs + @napi-rs/canvas 栅格化
if (rendered.length === 0) {
  rendered = await renderPdfPagesWithCanvas(doc, imageDir, batch, signal)
}
两个渲染器输出同样的 page-<n>.jpg,后面的读图、缓存、失败页兜底完全不用改。每批 120 页,批内并发 2;页面按 1.5 倍渲染,JPEG 质量 72,既保证模型能看清表格,又不至于把图片体积翻几倍。
真正花时间的是一个很隐蔽的坑:pdfjs 在 Node 里默认 disableFontFace: true,会用自带的 Path2D 描字;而 @napi-rs/canvas 的 Path2D 不是同一个实现,ctx.fill(path) 会直接抛 CanvasFillRule 枚举错误。关掉 disableFontFace,让它走正常的 fillText,图片才稳定出来。
缓存也按页做:键是"模型 + 上一页末尾 + 图片哈希",重跑同一页不会重复烧 token;跨页表格和公式会保留上一页的上下文,避免每页都从零开始。识别出的块还会整理成「表格与公式索引」,导入后生成可编辑的卡片,而不是只在正文里留一段 Markdown。
需要说清楚的是:这只是渲染层跨平台,当前发布的安装包仍然只有 macOS。Windows / Linux 还需要实机验证、OCR 引擎和安装包适配。但至少,视觉 PDF 不再是一个从架构上就锁死单平台的功能。
没走通的路
复盘里更有价值的部分,往往是"没做什么"。
页级摘要。 早期很容易做成"每页生成一段摘要",看起来功能很全,但输出仍然是一堆碎片。用户不会因为摘要更多而更容易写作。后来改成"按断言重写整章",产物才立得住。
云端优先。 云端做向量、存储和协作会简单很多,但会改变隐私边界和迁移成本。选择本地优先,就要接受同步、备份、跨设备这些事更难做。
全自动替用户读书。 "导入一本书,直接给你一篇成稿"听起来很吸引人,但它会把引用核对和人工判断挤掉。我的底线是:AI 可以起草,引用必须能回到原文。
一开始就做全平台。 macOS 的 PDFKit、Vision OCR、钥匙串让本地链路更快落地;Windows 和 Linux 需要新的 OCR 引擎和实机验证。现在只发 macOS Apple Silicon,未签名构建。这不是不想做,是不想用一个没验证过的版本消耗信任。
怎么验证它不是演示壳
截至 0.2.2,仓库里有近 300 个回归测试,覆盖划线解析、OCR 分章、发布包、分类、关系图、全文索引、备份恢复、schema 校验和迁移。
除此之外还有:
- Headless Electron smoke tests,覆盖书架、搜索、划词操作、TTS、笔记编辑、地图、导入和分页;
- Storybook 像素基线,CI 里做 diff,布局漂移会让构建失败;
- axe-core 注入 UI smoke test,扫描 WCAG 2A/2AA 的 critical / serious 问题;
- CI 不需要 API Key:真实模型响应录制一次,之后回放;
check:boundaries阻止渲染进程直接依赖 Electron / Node,架构边界由 CI 守。
这些测试不能证明产品一定好用,但至少能证明它不是只有几张截图的 demo。
适合谁,不适合谁
适合:
- 主要读非虚构,读完之后确实要写点东西的人;
- 愿意花时间核对引用,而不是只要一个"看起来很美"的摘要的人;
- 在意书和笔记留在本机的人;
- 用 macOS,能接受未签名构建和手动安装的人。
不适合:
- 想要"AI 替你读书"、直接看结论的人;
- 需要书源、盗版下载或全网书库的人;
- 需要记忆卡、考试队列、间隔重复的人;
- 需要多人协作、云端账号、实时同步的人;
- 现在就要 Windows / Linux / 移动端的人。
如果重来一次
我会更早把"引用核对"做成 UI 的一等状态,而不是先做漂亮的摘要。会更早接受本地产品没有服务端兜底,把备份、迁移、损坏恢复放进第一版。也会更早把模型层抽象出来,而不是先绑一家服务商再拆。
还有一点:会更早承认产品有边界。页边不替用户读书、不提供书源、不做记忆卡、不做云端协作。这些"不做"省下来的时间,最后都变成了把读薄、卡片、核对做扎实。
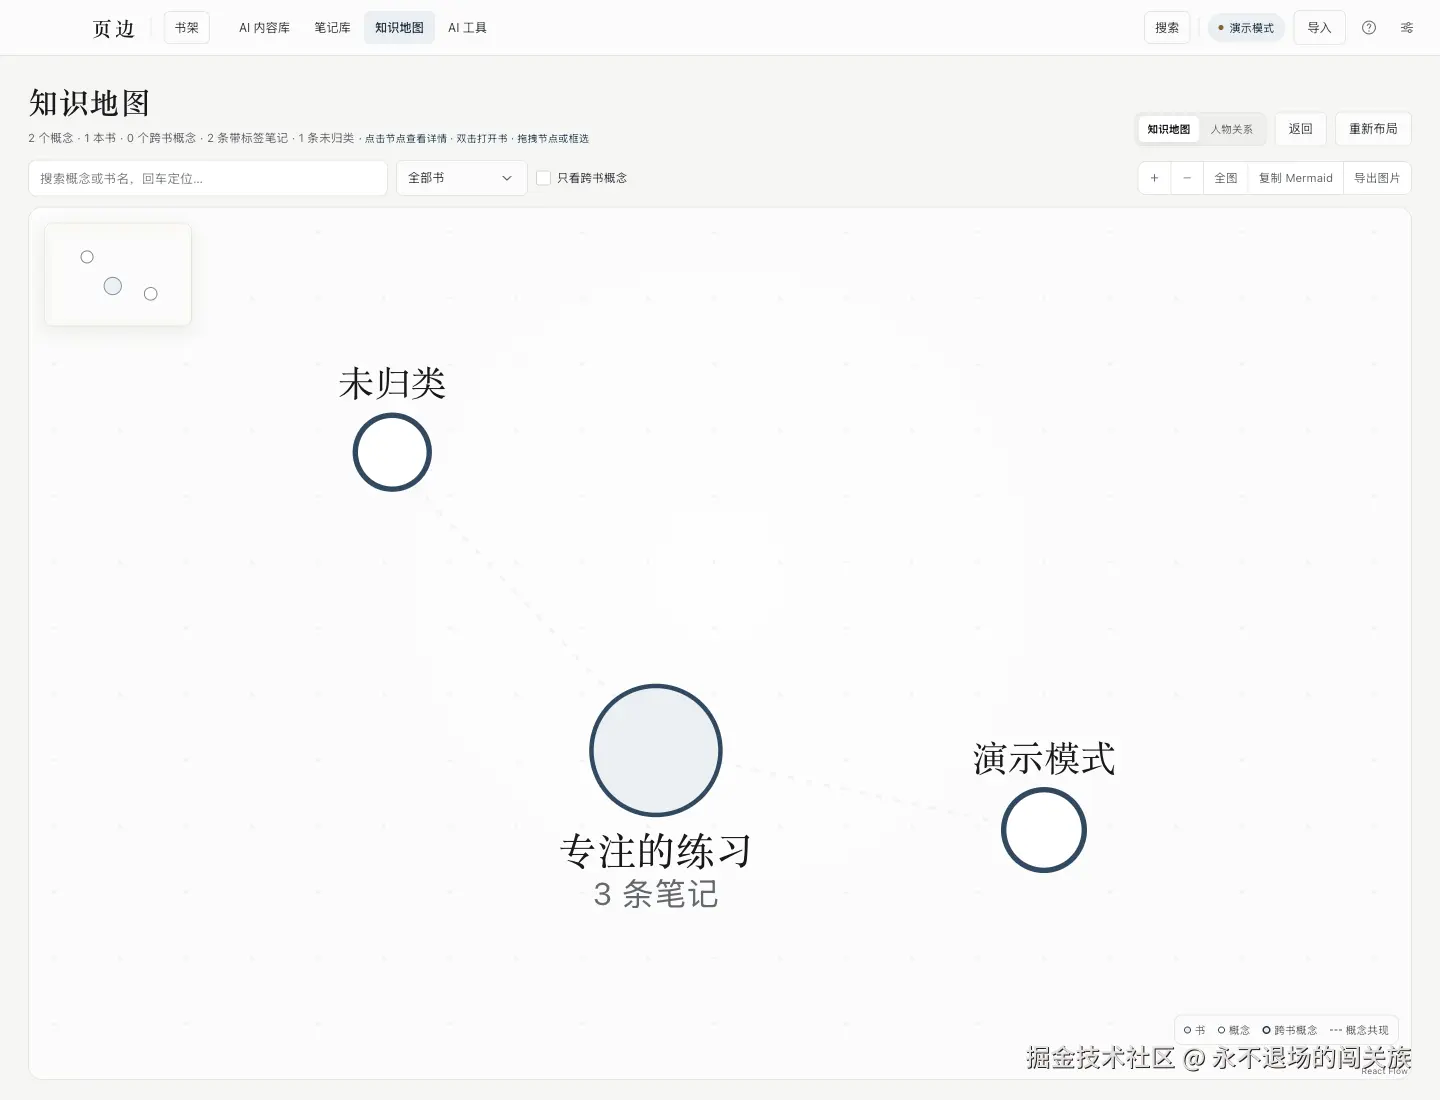
图 2:知识地图
怎么试
- GitHub:github.com/qweijiaq/Th...
- 官网:thinread.weijia.asia/
- 留言与公开路线图:feedback.weijia.asia/p/thinread
- 下载:github.com/qweijiaq/Th...
当前版本 0.2.2,macOS Apple Silicon,MIT 开源,构建未签名。第一次打开如果提示"无法验证开发者",在 Finder 里右键应用,选择"打开",或者到"系统设置 → 隐私与安全性"里允许本次打开。
如果你只想看效果,可以先不配 Key,用内置演示书走一遍读薄、卡片、核对、导出。觉得这条链路成立,再考虑接自己的模型。
Local-first 不是"永远不上云",而是每一条出网路径都能解释清楚,每一份本地数据都有可恢复的写入路径。
页边离"完美"还很远:同步、数据库加密、跨平台 OCR、移动端都还在路上。但它至少在两个地方没有妥协:书和笔记先属于用户;模型可以起草,引用必须回到原文。
如果这两条也是你在意的,欢迎试试。点个 star、提 issue,或者去公开留言板写你卡在哪一步,都是支持;也欢迎在评论区聊聊你的读书笔记流程。