项目地址 :github.com/iweidujiang...(欢迎 Star)
用 AI 解释 Trace 很香,账单更香
0.3.0 起,insight-server 可以可选地调 OpenAI 兼容接口,给 Trace、错误聚合、告警附一段短解读,开关默认关,配了 key 才会真发 HTTP。
模型调用和扫内存不是一个量级:一次 Chat Completions 要钱、要等、还可能被并发点爆。告警扫描如果每分钟都触发一次解读,Token 会先于 Span 把额度打光。
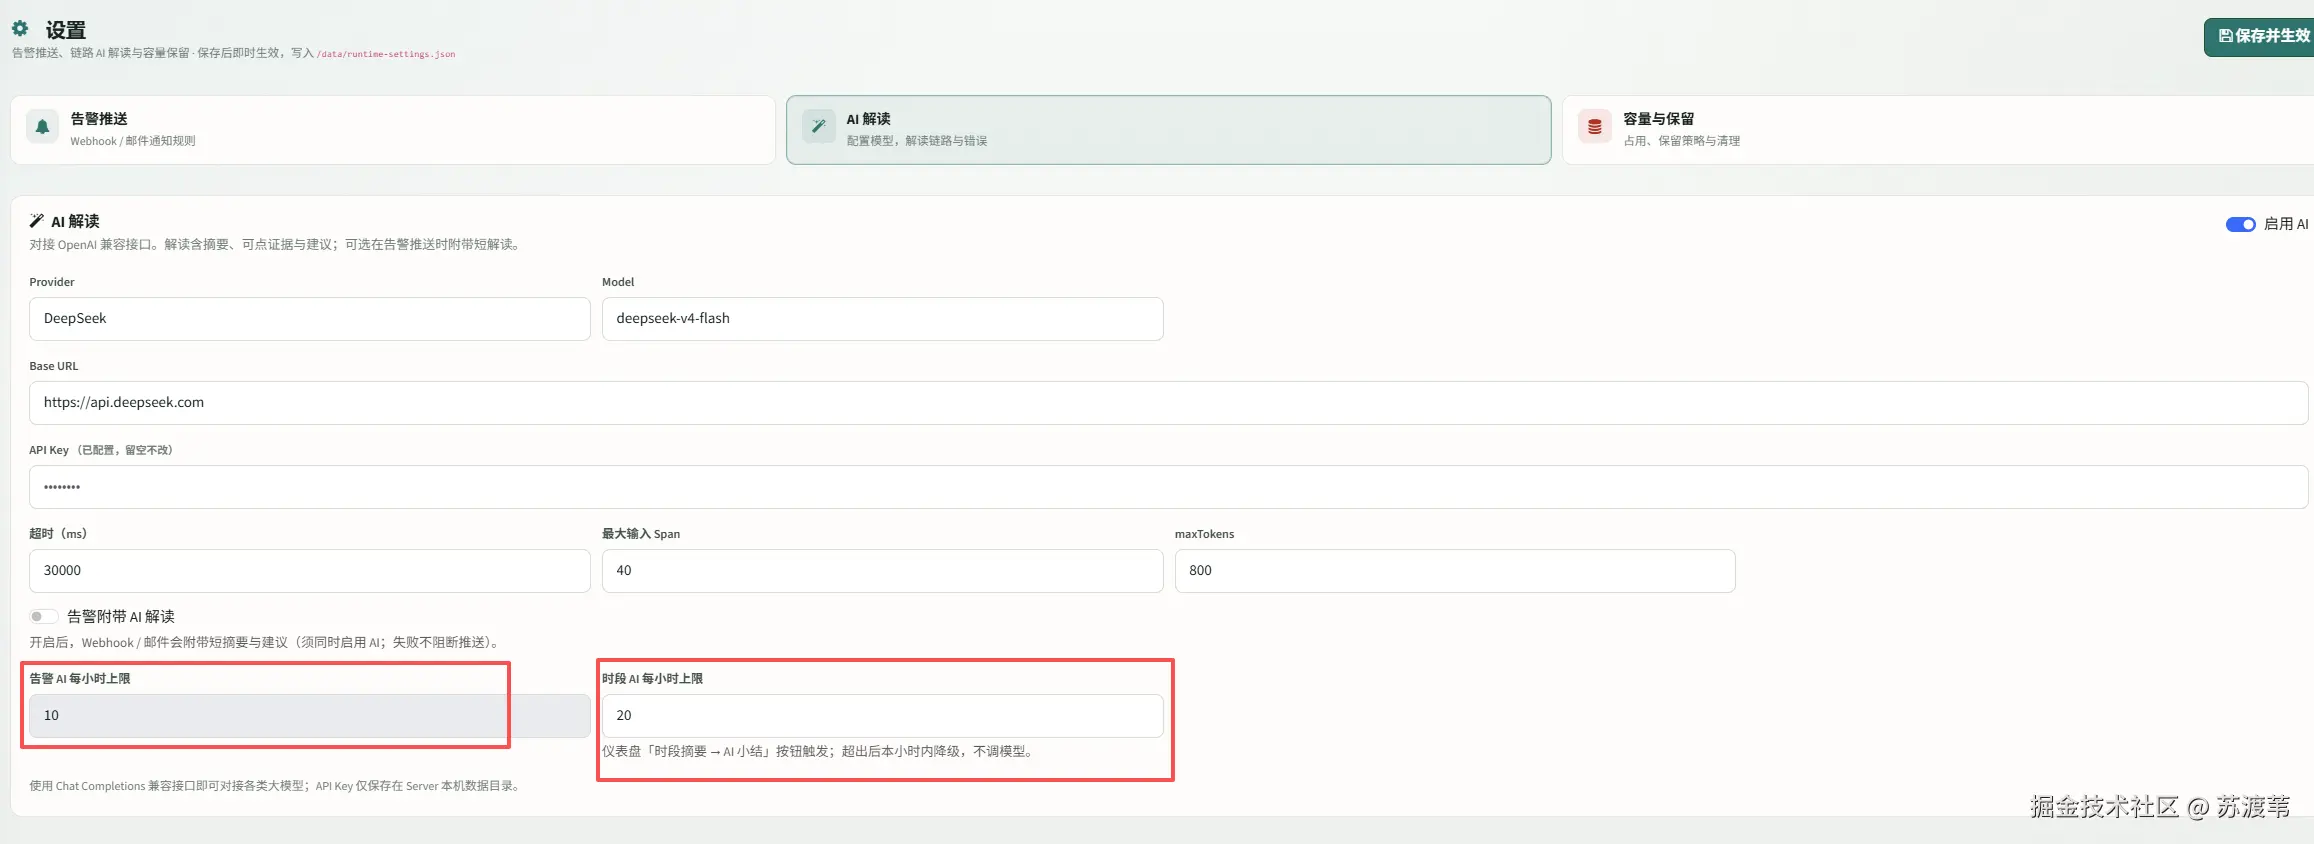
所以 InsightAiExplainService 里没有上来就 httpClient.send,先过一道每小时上限。默认告警附带 AI 每小时 10 次,仪表盘时段小结每小时 20 次。超了不抛 500,告警照推指标,只是这次不调模型。
这篇要看的就是这道上限怎么实现:字段类型为什么是 ConcurrentLinkedDeque<Long>,以及 tryAcquireQuota 怎样丢掉一小时前的时间戳。
代码在此:
io.github.iweidujiang.springinsight.server.ai.InsightAiExplainService
限流记的是时间戳,不是一个整数加一
很多人一提限流就想到 AtomicInteger:调一次 incrementAndGet,到点清零,整点清零是固定窗口,59 分到了 10 次,1 分又能再来 10 次,边界上会打满两倍。
Insight 要的是 滑动 1 小时:任意时刻往回看 60 分钟,最多 N 次。
那就得记住每一次调用发生在哪一毫秒,过期的从队列头扔掉,剩下的条数就是当前窗口占用。
java
/** 告警 AI 调用时间戳(epoch ms),用于每小时限流 */
private final ConcurrentLinkedDeque<Long> alertAiCallTimes = new ConcurrentLinkedDeque<>();

/** 时段 AI 小结调用时间戳(epoch ms),用于每小时限流 */
private final ConcurrentLinkedDeque<Long> periodAiCallTimes = new ConcurrentLinkedDeque<>();
两份队列,两套上限,告警扫得很勤,时段小结是人点的,不能共用一个计数,否则告警把配额吃完,控制台按钮会一起灰掉。
上限来自设置页,启动配置也能写:alertMaxPerHour 默认 10,periodMaxPerHour 默认 20。小于等于 0 直接视为不允许调用。
为什么是 ConcurrentLinkedDeque
Deque 是双端队列:头上删过期,尾上追加本次。LinkedList 也能干这事,但告警线程和用户点「解释」可能同时进来,普通 LinkedList 没有并发约定。
ConcurrentLinkedDeque 从 Java 7 就有,无界、无锁(CAS),peekFirst / pollFirst / addLast 都是线程安全的单次操作。
这里不需要 BlockingQueue 那种「队列满了就等」------限流失败要立刻返回,让告警走只推指标的分支。
同一套结构还用在 InsightAiAuditLog:最近 100 条 AI 调用记录,addFirst 新的,超了 removeLast 挤掉最旧的。
一边当滑动窗口,一边当有界审计,都是「两头都能动」。
同一个类里还有两处 JDK 较新的写法,和限流无关,但读源码时会碰到:
- 给模型的 system prompt 用了 文本块 (Java 15 正式进入):
""" ... """,多行提示词不用一堆\n拼接。 filterServiceRows里用了 模式匹配 instanceof (Java 16):if (!(raw instanceof List<?> list)),判断完直接得到list,少一次强制转换。
Insight 主线是 JDK 17+,这些都能直接用。
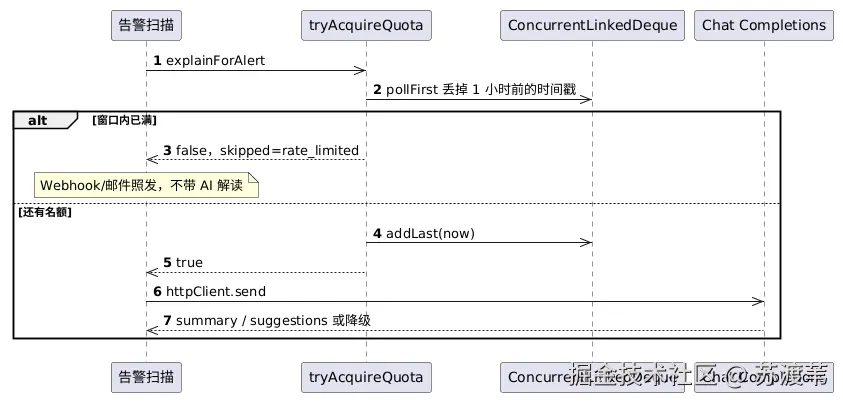
tryAcquireQuota:先挤掉过期的,再决定进不进
整段逻辑不到 20 行:
java
private static boolean tryAcquireQuota(ConcurrentLinkedDeque<Long> times, int maxPerHour) {
    if (maxPerHour <= 0) {
        return false;
    }
    long now = System.currentTimeMillis();
    long cutoff = now - 3_600_000L;
    while (true) {
        Long oldest = times.peekFirst();
        if (oldest == null || oldest >= cutoff) {
            break;
        }
        times.pollFirst();
    }
    if (times.size() >= maxPerHour) {
        return false;
    }
    times.addLast(now);
    return true;
}
读的顺序可以记成四步:
- 上限非法,直接拒绝。
cutoff是一小时前。队头时间戳比它还早,就pollFirst,直到队头落在窗口内或队列空了。- 剩下的条数已经到达上限,返回
false,不往队列里写。 - 否则
addLast(now),占用这一次。
告警路径里,占用成功才去调模型;失败只打日志,payload 带 skipped=true、skipReason=rate_limited:
java
if (!tryAcquireAlertQuota(maxPerHour)) {
    out.put("skipped", true);
    out.put("skipReason", "rate_limited");
    log.info("[AI] 告警解读达每小时上限({}),本次只推指标", maxPerHour);
    return out;
}
时段小结同样:超限走降级文案,告诉你本小时到顶了,可以去设置里把上限调高。
注意配额是在 发 HTTP 之前 占用的,模型超时或 4xx 也算一次。宁可偶发少调,也不要失败重试把窗口打穿。
并发下它精确吗
ConcurrentLinkedDeque 的单个方法是线程安全的,tryAcquireQuota 却是 peek、poll、size、add 拼起来的。
两个线程同时看到 size() == 9(上限 10),可能都 addLast,窗口里短暂变成 11。
size() 本身也不是 O(1),要遍历节点,告警默认每小时 10 次,遍历这点开销可以忽略;真要做十万 QPS 的网关限流,不该用这个结构。
对 Insight 来说,多放行一两次模型调用,比引入 Redis、Guava RateLimiter 或再加一把全局锁更划算。
单进程、低频、失败就降级,滑动窗口用 deque 记时间戳够用。
重启后队列是空的,配额会重置。审计日志同样只在进程内,这和 Span 默认内存是一类取舍。
超限不是故障,是这次不花钱
Trace / 错误页的「解释」走 gateOrNull:没开 AI、没配 key,返回 degraded=true 的说明,HTTP 仍是 200。
告警附带解读走另一条:quota 没抢到就 skipped,指标该推还推。
两套失败都故意不把监测中心打成 5xx,模型是可选项,限流也是可选项的保护罩,不能反过来把告警通道堵死。
设置页可以改每小时上限。调太高等于把保护拆掉;调成 0,告警路径会直接视为不允许调用。
滑动窗口看完,账单才跟得上告警频率
Insight 把每次 AI 调用的时间戳放进 ConcurrentLinkedDeque,tryAcquireQuota 丢掉一小时前的,再比较条数和上限,告警和时段小结各用一条队列,超限不调模型、不报 500。
它不是分布式令牌桶,并发下可能多放行一两次,失败的调用也会占名额。
单进程、每小时十几次这个量级,deque 记时间戳足够清楚,也少一堆依赖。
最后:欢迎围观 Spring Insight
Spring Insight 是给 Spring Boot / Spring Cloud 用的轻量监测工具:业务服务加 spring-insight-agent-starter 上报,旁边跑一个 insight-server,控制台就能看服务拓扑和链路详情。
仓库在这:
🔗 GitHub :github.com/iweidujiang...
跪求 Star,遇到问题直接开 Issue。