阿里开源的代码审查工具 open-code-review(命令名 ocr,下文简称 OCR)这周在 GitHub 周榜涨了 4,457 星。README 称它和 Claude Code 用同一个模型时,准确率和 F1 明显更高,token 只用约 1/9。
本文先介绍 OCR 是什么、用在哪些场景、流水线怎么设计,再用它公开的评测脚本做一次同模型对比:Claude Code 2.1.330 对 OCR 1.13.13,两边都接 Claude Opus 5.5,随机抽 20 个 PR。结果是两边花费只差 6%,召回率 Claude Code 37%、OCR 16%,准确率 OCR 44%、Claude Code 28%。最后按场景给出使用建议。
open-code-review 简介
OCR 是一个用 Go 写的命令行工具,Apache-2.0 协议,通过 npm 安装:npm install -g @alibaba-group/open-code-review。README 介绍,它原本是阿里集团内部的官方 AI 代码评审助手,两年里服务了数万名开发者,之后孵化成开源项目。
它的工作方式是:读取 Git diff,把改动的文件交给一个能调用工具的 agent,由配置好的大模型审查,输出带行号的结构化评论。agent 可以读完整文件、搜索代码库、查看其他改动文件,不只看 diff 本身。
OCR 不自带模型,使用前要用 ocr config provider 和 ocr config model 配好模型端点。没有单独的 API key 时,可以改用委托模式,由 Claude Code 这类编码 agent 用自己的模型来审,区别见下文「工作原理」。
使用场景
OCR 覆盖了从本地提交前到 CI 的几种用法:
- 提交前自查 :在仓库里直接运行
ocr review,审查暂存区、工作区和未跟踪文件的全部改动。 - 审查分支或单个提交 :
ocr review --from main --to feature-branch审查分支自分叉以来的改动,--commit <sha>只审一个提交。 - 整文件扫描 :
ocr scan不看 diff,直接审整个仓库或指定目录,适合接手陌生代码。 - 接入 CI:官方提供 GitHub Actions 和 GitLab CI 配方,在 PR / MR 上运行。GitHub 版会把结果写成行内评论,外加一条持续更新的汇总评论。
- 在编码 agent 里调用 :为 Claude Code、Codex、Cursor、Kimi Code 提供了插件和 skill。Claude Code 装好插件后,用
/open-code-review:review(原生模式)或/open-code-review:delegate-review(委托模式)发起审查。 - 在编辑器里使用:仓库里还有 VS Code 和 IntelliJ IDEA 插件,可以在编辑器里逐条应用、忽略评论,或标为误报。
工作原理
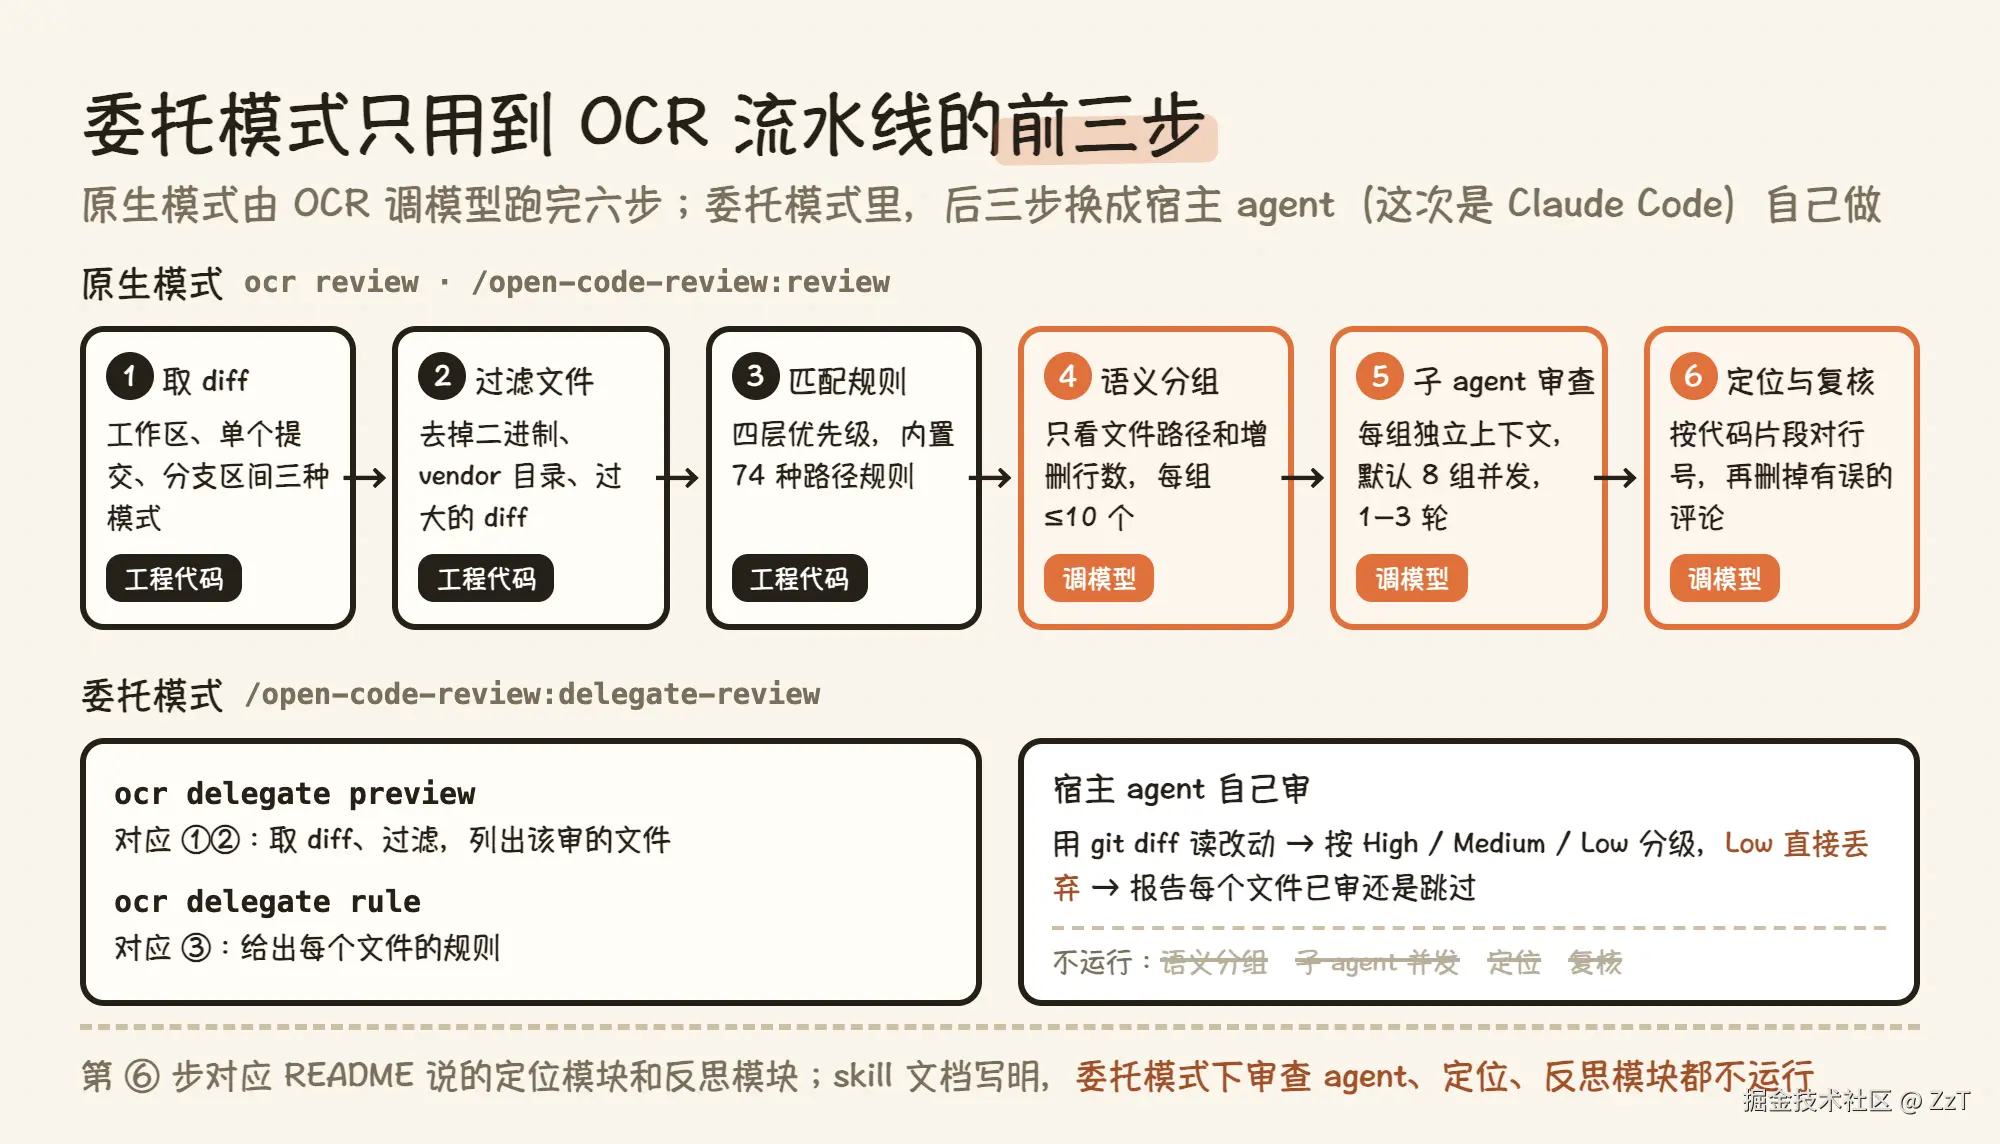
README 把 OCR 的设计出发点归结为通用 agent 做代码审查时的三个问题:
- 覆盖不全:改动较大时,agent 只挑一部分文件审,其余漏掉。
- 位置漂移:报出的问题和实际代码位置对不上,行号或文件偏了。
- 质量不稳:审查流程完全靠自然语言 skill 驱动,难以调试,prompt 稍有变化,质量就明显波动。
OCR 的做法是把不能出错的步骤交给确定性的工程代码,只把需要动态判断的部分交给 agent。
原生模式
原生模式下,ocr review 分六步执行:
- 取 diff:按工作区、单个提交或分支区间三种模式,从 Git 取出改动。
- 过滤文件 :二进制文件、
vendor和node_modules这类目录、不支持的扩展名,以及 diff 本身就过大的文件,在这一步排除。 - 匹配规则 :给每个文件挑一份审查规则,按四层优先级查找:命令行
--rule、项目里的.opencodereview/rule.json、用户目录下的全局配置、内置规则。内置规则按 74 种路径模式区分 Java、Go、TypeScript、YAML、pom.xml等文件类型。 - 语义分组:只把文件路径、状态和增删行数发给模型,不发 diff 内容,由模型把相关的文件归成一组,例如接口和实现、同一份配置的多语言版本。每组最多 10 个文件。
- 子 agent 审查 :每组交给一个独立上下文的子 agent,默认 8 组并发。改动较大的组(单文件改 50 行以上,或多文件合计 100 行以上)先做一次规划。审查时 agent 可以调用读文件、读 diff、找文件、搜代码 4 个只读工具,用
code_comment提交评论。--effort决定审查轮数,low 1 轮、medium 2 轮、high 3 轮;第二轮起把已确认的评论传回去,让模型找新的问题。 - 定位与复核:每条评论带着它指向的原代码片段,OCR 拿这段代码去 diff 里匹配出准确行号,匹配不上时再让模型重新定位。最后再调一次模型,对照 diff 删掉可以证明有误的评论。
架构文档里的这两步,对应 README 说的独立「定位模块」和「反思模块」。至于 token 为什么省,README 归因于专门为代码审查调过的 prompt 和工具集,工具集是分析大规模生产数据里的工具调用记录后精简出来的。
委托模式
委托模式下,OCR 不调用模型,只做前三步:ocr delegate preview 取 diff 并过滤,列出该审的文件;ocr delegate rule 给出每个文件的规则。之后由宿主 agent 自己用 git diff 读改动并审查。
Claude Code 插件的委托命令对后半段也有规定:每条问题分 High、Medium、Low 三级,Low 直接丢弃;要报告每个文件是已审还是跳过,以及覆盖率;默认还会自动修复 High 和 Medium 里安全、明确的问题。
OCR 的 skill 文档写明,委托模式下它自己的审查 agent、定位模块和反思模块都不运行。也就是说,分组、并发子 agent、定位和复核这些 README 重点介绍的设计,只在原生模式里生效。
对比 Claude Code 实测
README 的对比结论来自它自己的榜单,而评测数字有保质期。榜单图最后一次更新是 8 月 5 日,它测的 Claude Code 2.1.169 发布于 6 月 8 日,到现在版本号已经走到 2.1.330,其中 11 月 19 日的 2.1.328 刚改过 /code-review 报什么、怎么分级。所以我用当前版本重跑了一遍。
1/9 的来源
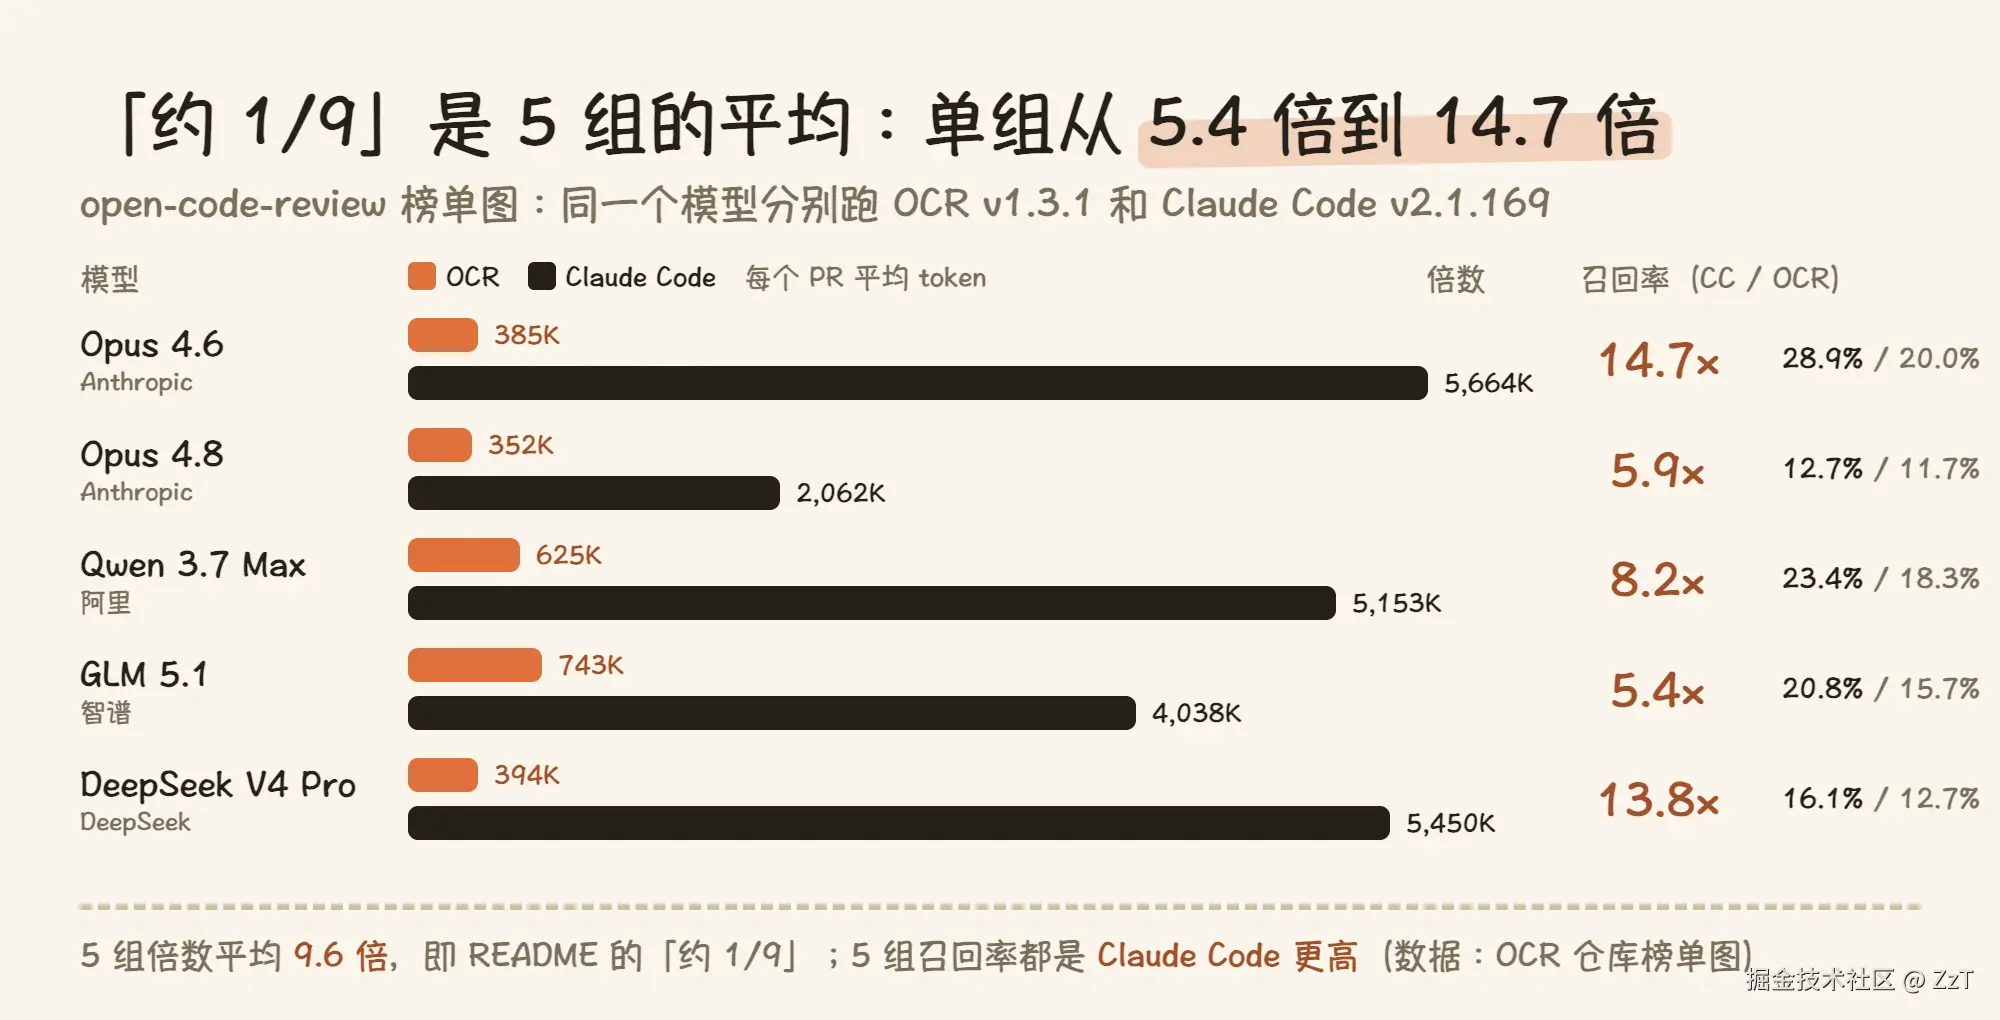
OCR 的 README 里放了一张榜单图。图里有 5 个模型各跑了两遍,一遍用 OCR v1.3.1,一遍用 Claude Code v2.1.169,评测集是 200 个 PR、1,505 条专家确认过的参考评论。
按图里每个 PR 的平均 token 算,Claude Code 是 OCR 的 5.4 倍到 14.7 倍,5 组平均 9.6 倍,对应 README 的「约 1/9」。倍数最大的一组是 Opus 4.6:OCR 每个 PR 用 38.5 万 token,Claude Code 用 566.4 万。
同一张图里还有两点值得注意:
- 5 组的召回率都是 Claude Code 更高。 差距最大的 Opus 4.6 一组,Claude Code 28.9%,OCR 20.0%。README 自己也写了这一点,说这是为了少报噪音做的取舍。
- Claude Code 输在报得太多。 还是 Opus 4.6 那组,200 个 PR 报了 5,980 条,平均每个 PR 30 条,准确率只有 7.23%。
Claude Code 版本变化
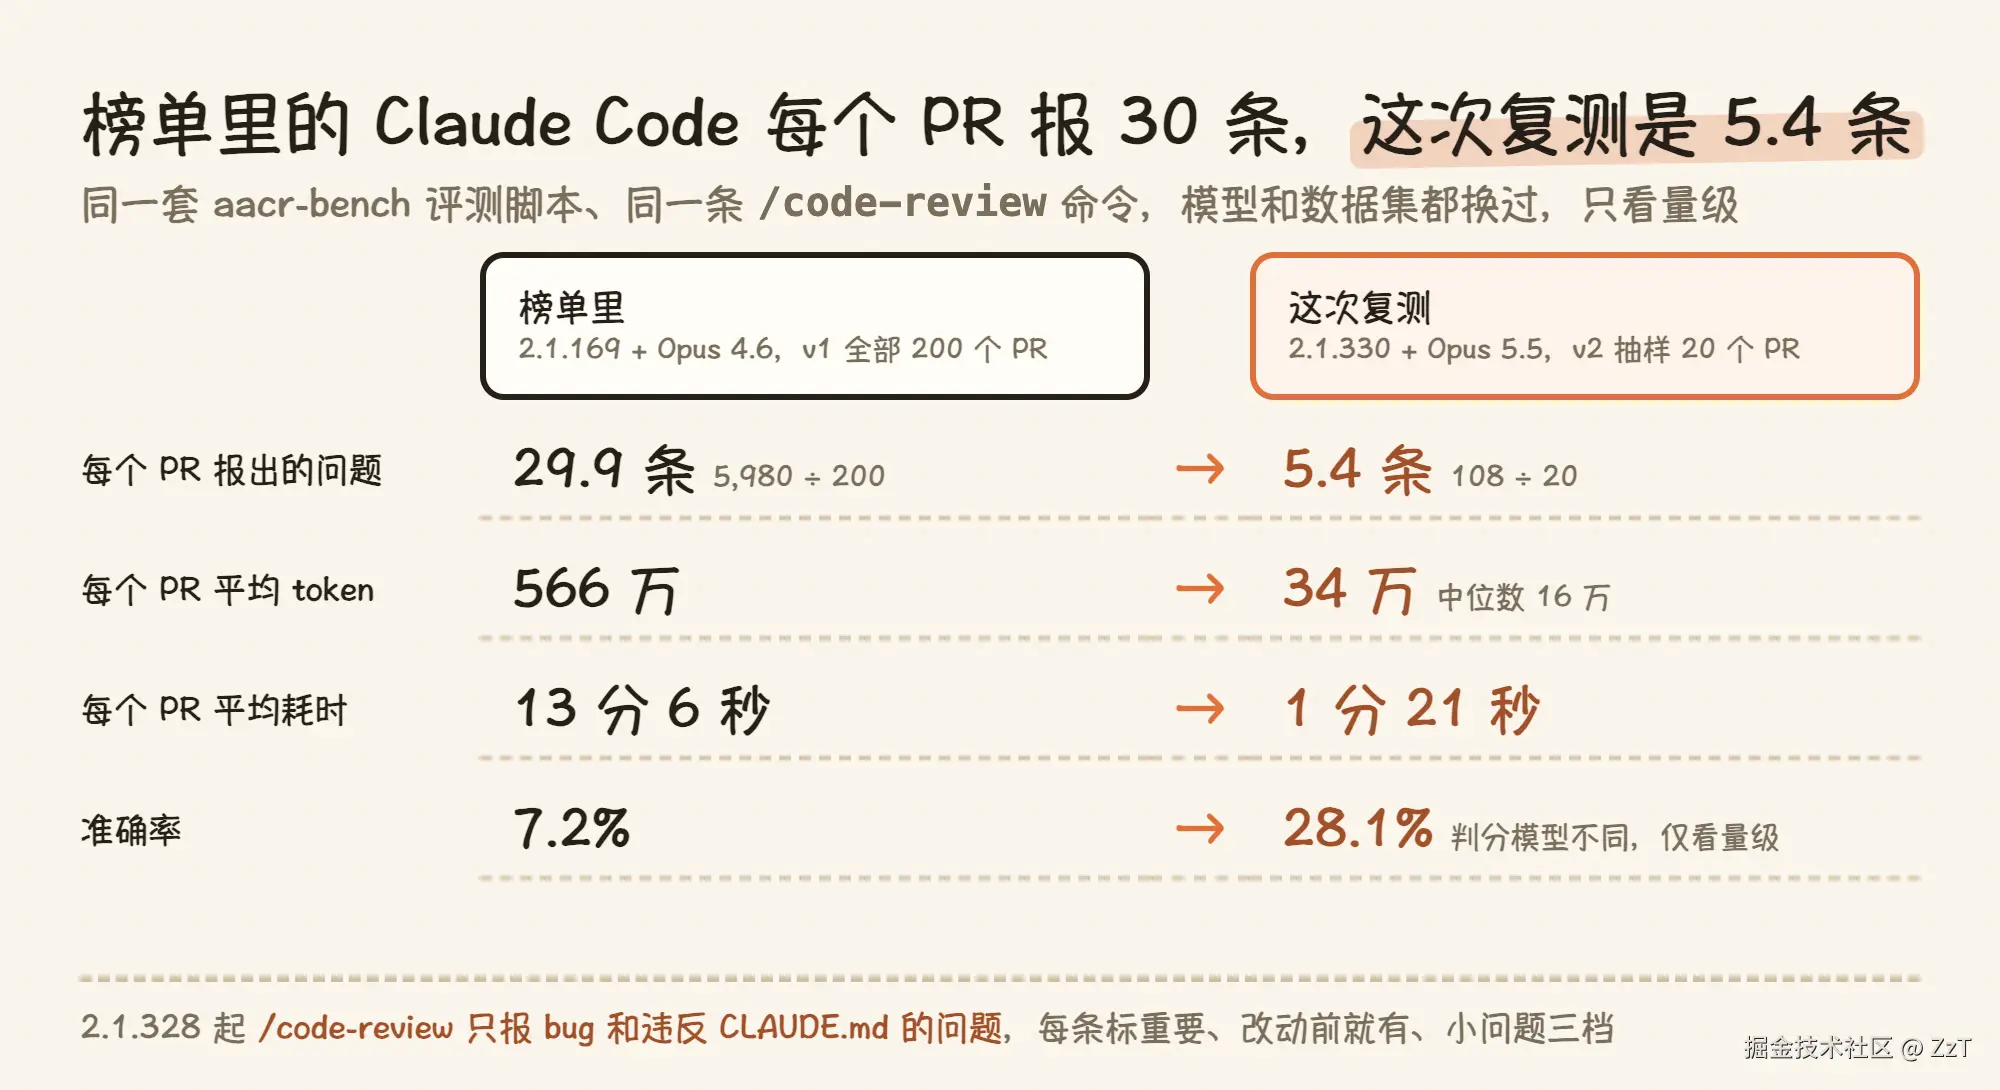
榜单里 Claude Code 的版本是 2.1.169,6 月 8 日发布。到 11 月 20 日,Claude Code 已经发到 2.1.330。
中间和代码审查直接相关的一次改动在 2.1.328(11 月 19 日)。changelog 原文:
Changed
/code-reviewon most models to report only bugs and CLAUDE.md violations; run/simplifyfor reuse, simplification and efficiency cleanups
同一版还让 /code-review 给每条结果标 Important、Pre-existing 或 Nit 三档。复用、简化、效率方面的清理建议改由 /simplify 负责,不再混在审查结果里。
用 aacr-bench 同一套脚本、同一条 /code-review 命令跑当前版本,每个 PR 平均报 5.4 条,用 34 万 token,耗时 1 分 21 秒。榜单里对应的数字是 30 条、566 万 token、13 分 6 秒。
这组对比里模型也从 Opus 4.6 换成了 Opus 5.5,数据集从 v1 的 200 个 PR 换成 v2 抽样的 20 个,所以分不清多少来自 Claude Code 版本、多少来自模型。能确定的是,榜单里那个「每个 PR 报 30 条」的 Claude Code,已经不是现在用户手里的版本。
复测设置
两边都用我的 Claude 订阅跑 Opus 5.5,评测流程全部用 aacr-bench 原版代码,只替换了「怎么启动 Claude」这一步。
- 样本 :用 aacr-bench 自带的转换器
--version v2 --limit 20 --seed 42随机抽样,得到 13 个仓库的 20 个 PR、97 条参考评论,换同一个种子可以复现同一批。 - Claude Code 组 :Claude Code 2.1.330,命令和 aacr-bench 里的写法一致:
claude -p "/code-review <base>...<head>"。 - OCR 组 :OCR 1.13.13 的 Claude Code 插件,命令是
/open-code-review:delegate-review --from <base> --to <head>,加一句「只评审、不改文件」,跳过自动修复。 - 两组相同的部分 :同样的工具权限(读文件、搜索、
git、ocr),都禁止改文件;都排除我本机的个人配置、CLAUDE.md 和 MCP 服务,只留被测仓库自己的项目配置。 - 判分 :aacr-bench 原版
judge.py,判分模型换成 Claude Sonnet 5.5,每组判 3 轮取平均。榜单用的判分模型没有公开。
OCR 组用委托模式,是因为原生模式需要单独的模型 API key,不能用 Claude 订阅。所以这次复测回答的是:手里只有 Claude 订阅时,Claude Code 自带的 /code-review 和 OCR 的审查流程,用同一个模型谁的效果更好。原生模式那句「1/9」要另外配 API key 才能直接验证。
token 与花费
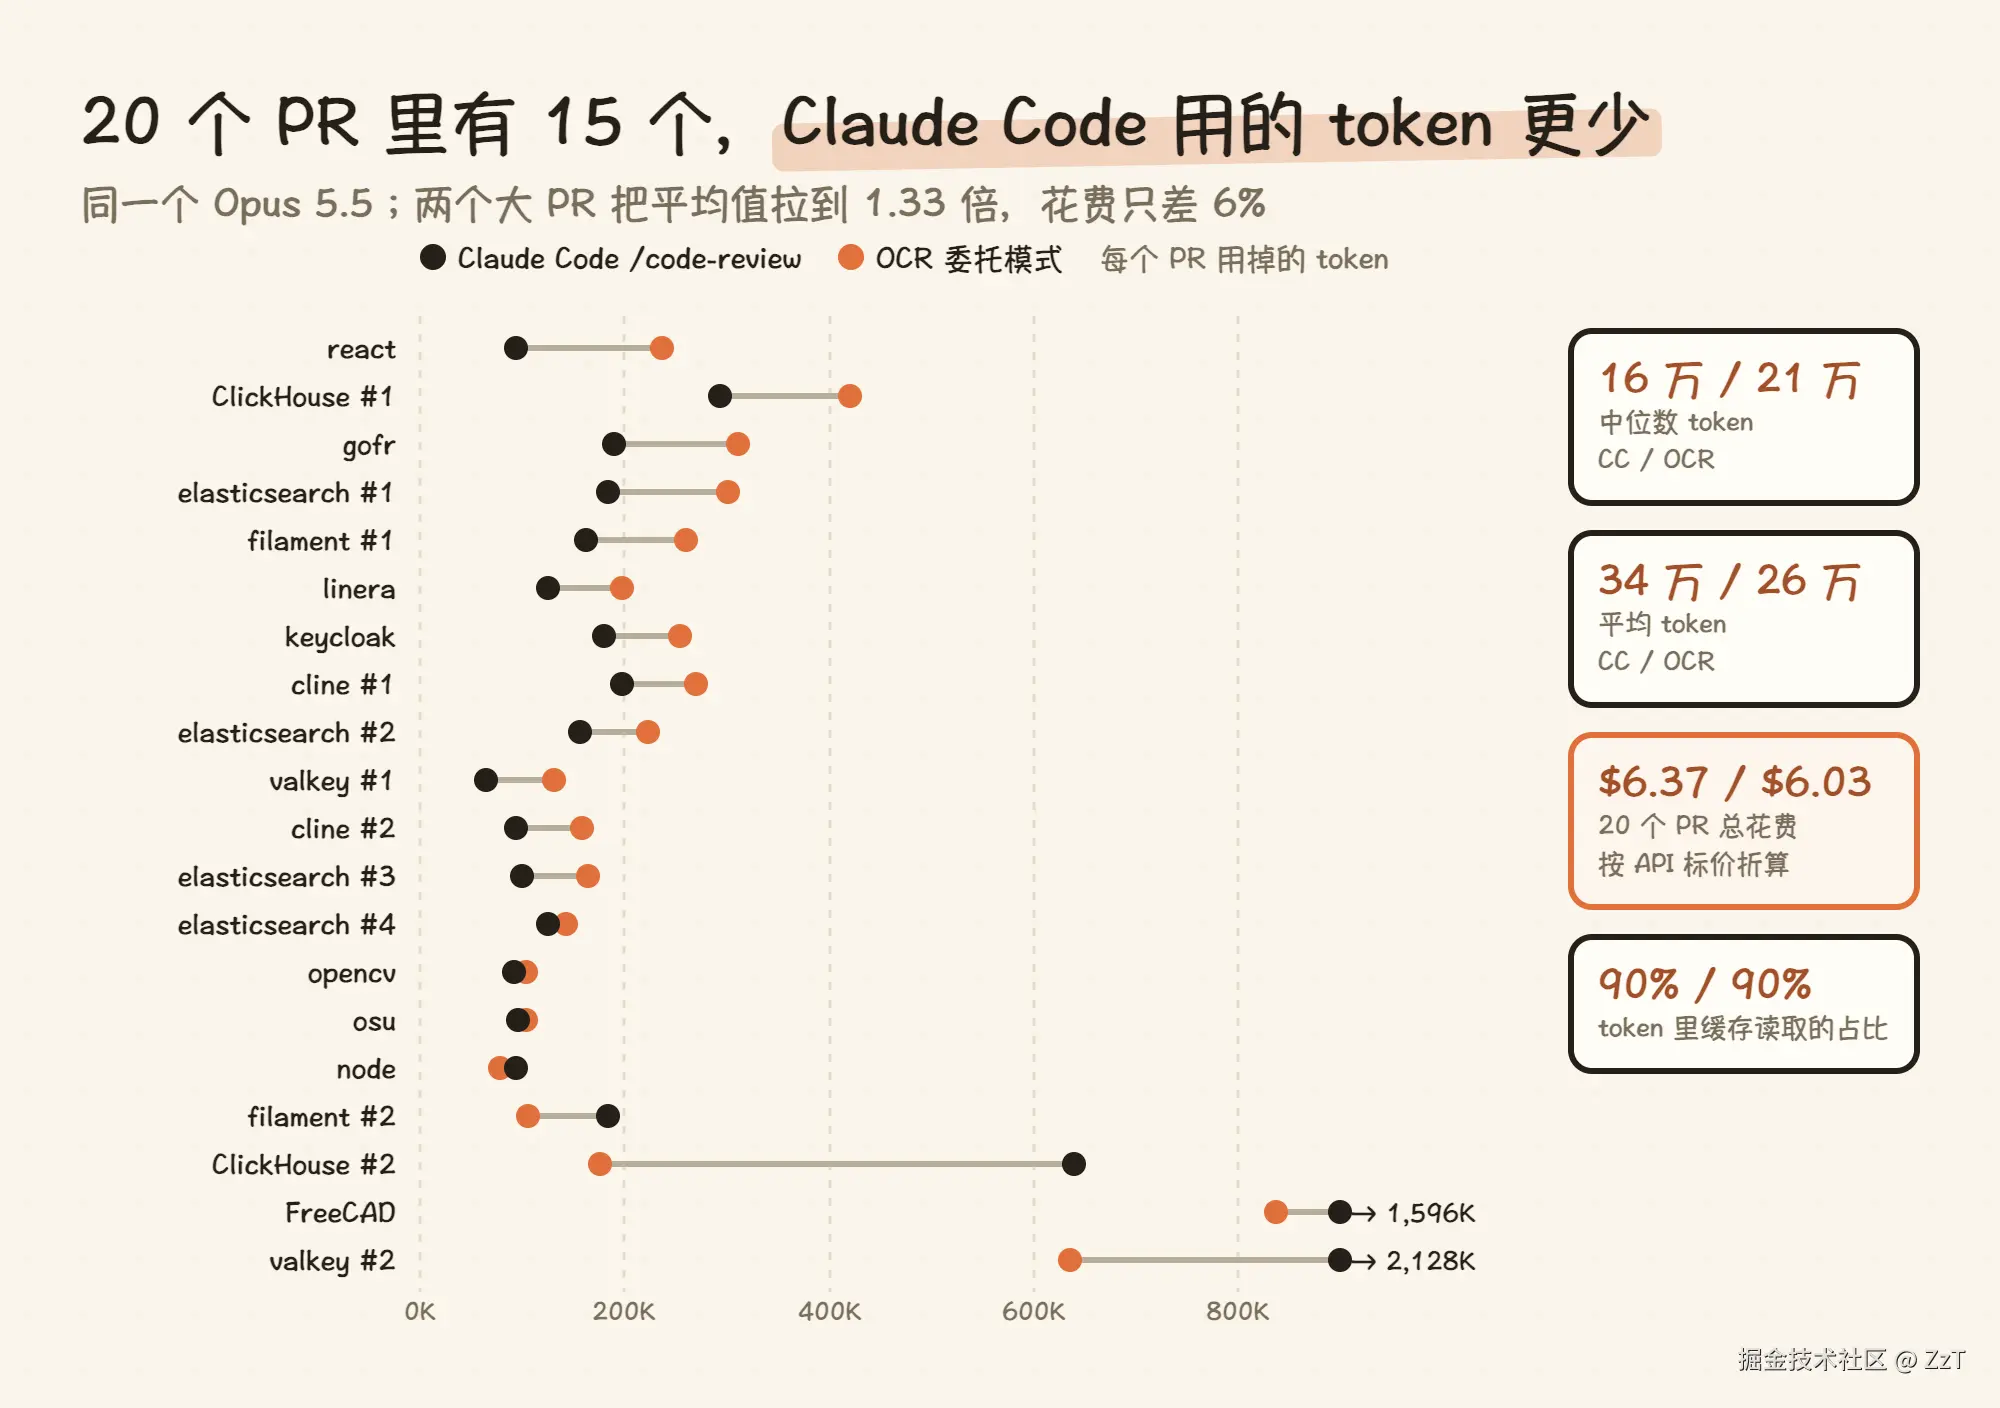
20 个 PR 里,有 15 个是 Claude Code 用的 token 更少。按中位数算,Claude Code 每个 PR 16 万 token,OCR 21 万。
平均值反过来,是被两个大 PR 拉高的:
- valkey 的一个 PR:改了 7 个文件、500 多行,Claude Code 用了 213 万 token,OCR 用了 64 万。
- FreeCAD 的一个 PR:Claude Code 160 万,OCR 84 万。
20 个 PR 加起来,Claude Code 用了 679 万 token,OCR 511 万,比值 1.33。按 API 标价折算,Claude Code 花 6.37 美元,OCR 花 6.03 美元,只差 6%。
token 多 33%、花费只多 6%,原因在计价方式:
- 两边的 token 都有九成是缓存读取,按输入单价的 0.1 倍计费。Claude Code 多出来的 token 主要就是这部分:缓存读取多了 152 万,缓存写入只多 12 万。
- 缓存写入的档位不同。 会话记录显示,
/code-review是派一个子 agent 跑完的,58 万缓存写入全部是 5 分钟档;OCR 的命令在主会话里执行,46 万缓存写入全部是 1 小时档。官方价目里,5 分钟档写入是输入单价的 1.25 倍,1 小时档是 2 倍。
aacr-bench 把缓存读取、缓存写入和正常输入加在一起算 token,所以只看 token 数会放大成本差距,榜单里的「约 1/9」也是这样算出来的。
耗时上,Claude Code 平均每个 PR 1 分 21 秒,OCR 50 秒;中位数两边都是 47 秒。
召回率与准确率
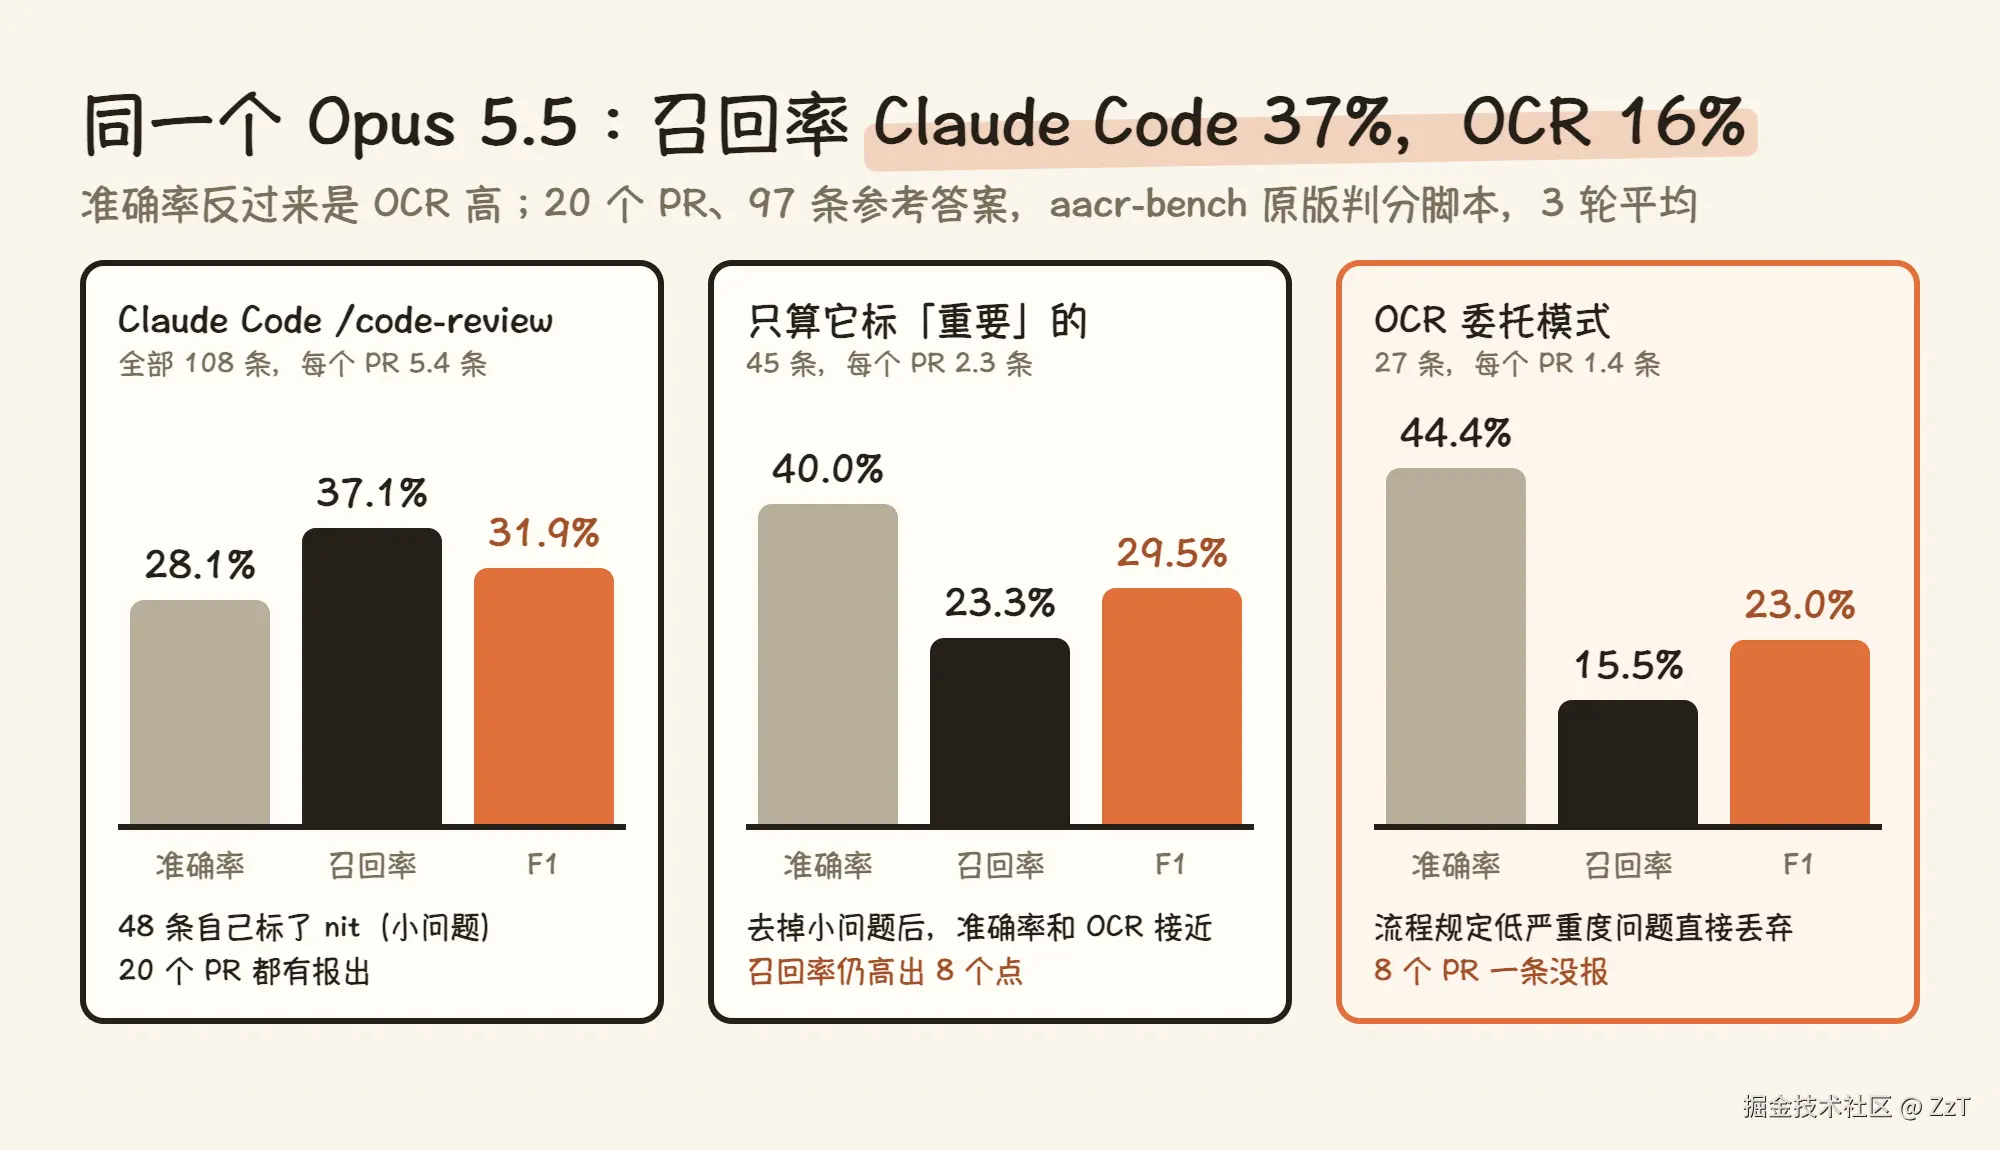
97 条参考评论里,Claude Code 找到了约 36 条,召回率 37.1%;OCR 找到 15 条,召回率 15.5%。准确率反过来,OCR 报的 27 条里有 12 条对上参考答案,44.4%;Claude Code 报的 108 条里对上约 30 条,28.1%。F1 是 Claude Code 31.9%,OCR 23.0%。
两边的差别主要来自报不报小问题。
- OCR 的委托命令规定 Low 直接丢弃。 20 个 PR 里有 8 个,OCR 一条都没报,回复里写的是「没有发现高或中严重度的问题」。
- Claude Code 的 108 条里,有 48 条自己标了 Nit。 只看它标 Important 的 45 条,准确率 40.0%,和 OCR 接近;召回率 23.3%,仍比 OCR 高约 8 个点。
所以在同一个模型下,OCR 委托模式少报,准确率高一些;Claude Code 多报,召回率高一倍多,并且用分级把小问题标了出来,看的人可以先只看 Important。
准确率的含义
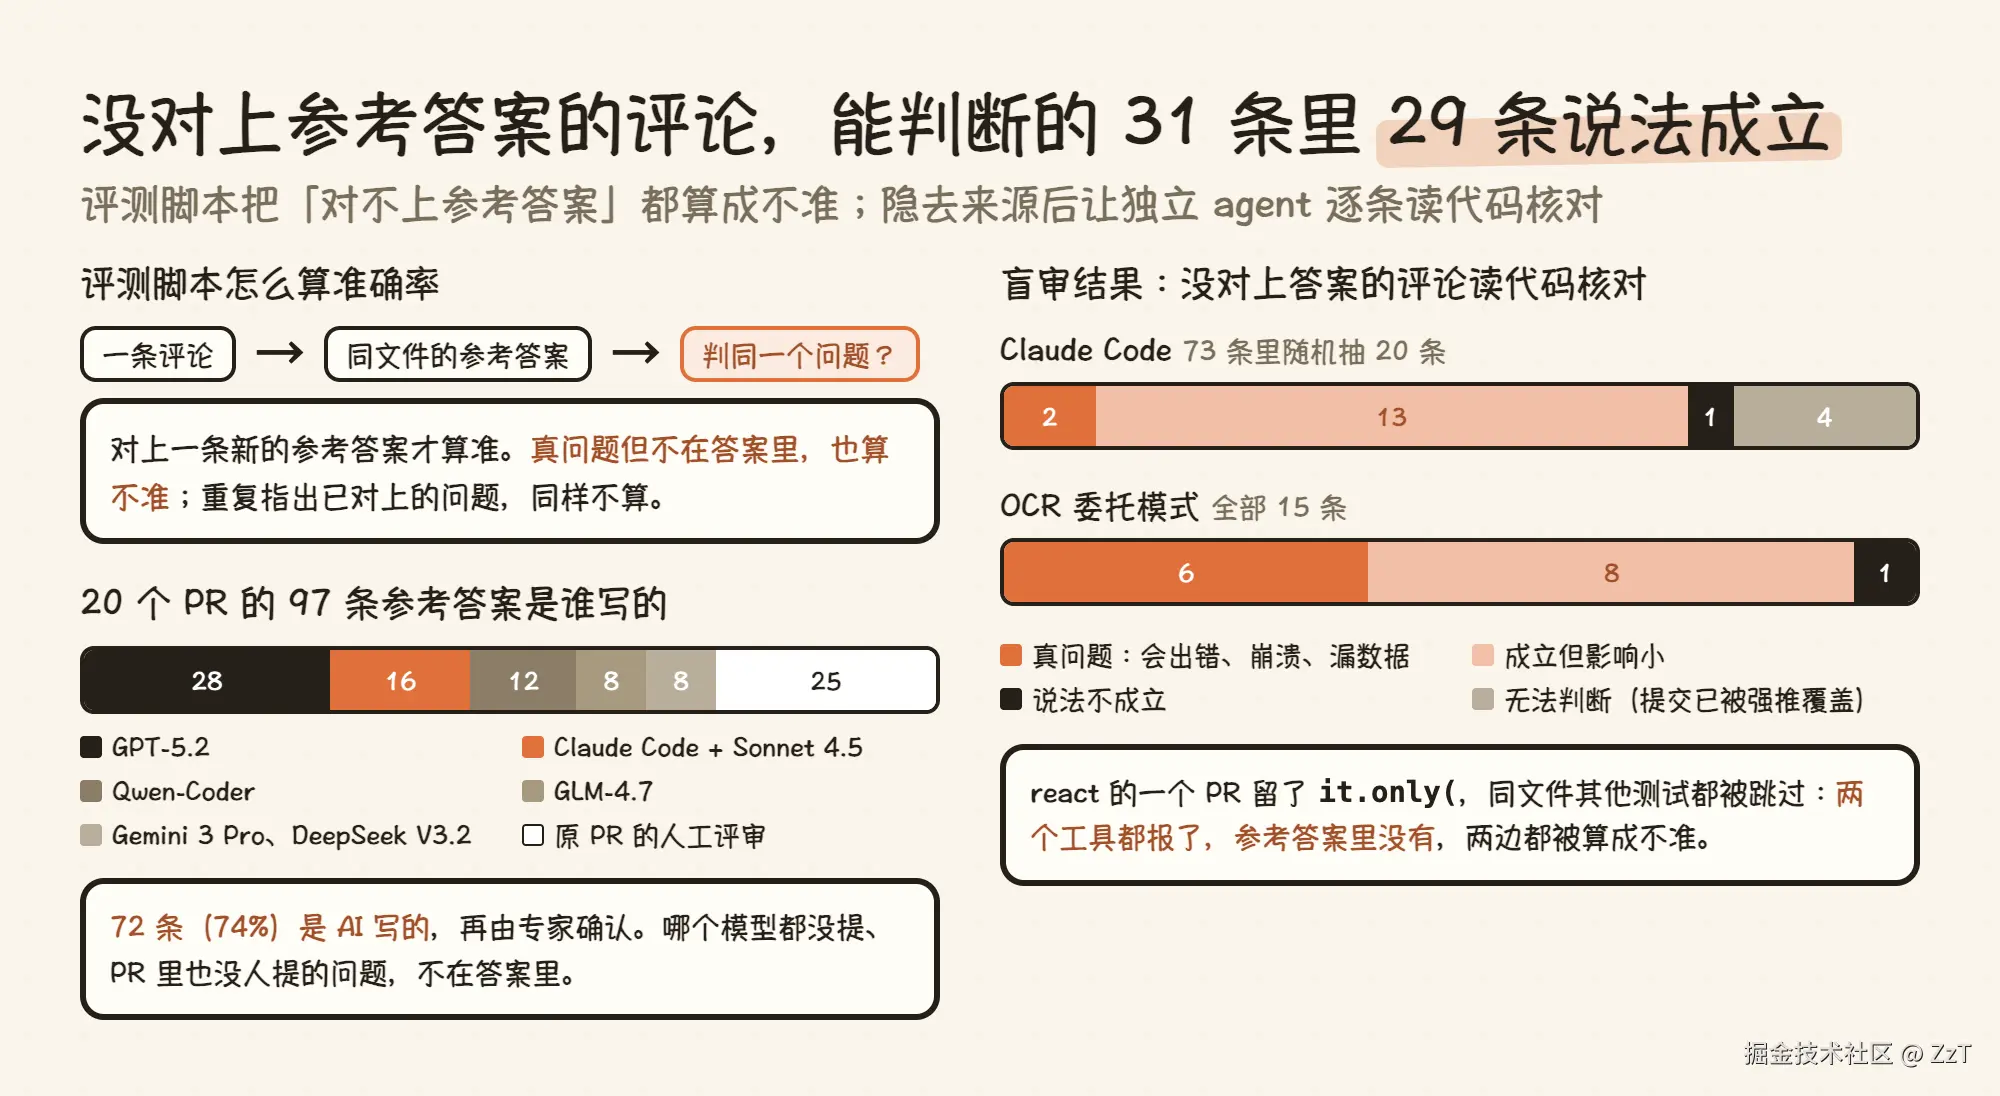
aacr-bench 的指标文档写得很清楚:每条生成评论和同一文件的全部参考答案一起交给判分模型,由它判断是不是在说同一个问题。一条评论只有对上一条此前还没被对上的参考答案,才算进准确率的分子。
所以这里的准确率是「和参考答案对上的比例」。README 的指标表把它解释成 "Proportion of reported issues that are real defects",即报出的问题里真缺陷的比例。只有参考答案覆盖了全部真问题,两者才相等。
参考答案并不全。这次抽到的 20 个 PR 共有 97 条参考答案:
- 72 条(74%)由 AI 模型生成,再经专家确认:GPT-5.2 28 条、Claude Code + Sonnet 4.5 16 条、Qwen-Coder 12 条、GLM-4.7 8 条,Gemini 3 Pro 和 DeepSeek V3.2 各 4 条。
- 25 条来自原 PR 里的人工评审。
这些模型和 PR 评审者都没提到的问题,就不在答案里。
为了看对不上答案的评论到底错没错,我做了一次盲审。OCR 没对上的 15 条全部取出,Claude Code 没对上的 73 条随机抽 20 条,打乱顺序、去掉来源,分给 3 个独立的 agent。它们按提交号从 GitHub 拉代码,逐条判断说法是否成立、影响多大。
- 说法成立:Claude Code 能判断的 16 条里有 15 条,OCR 15 条里有 14 条,两边各有 1 条不成立。
- 无法判断的 4 条都来自 keycloak 的同一个 PR,被测的提交已经被强推覆盖,GitHub 上取不到。
- 严重程度差得多 :OCR 这 15 条里有 6 条是真问题。例如 gofr 的一个 PR 里,连接失败后
connManager留空,之后调用导出的SubscribeWithHandler会空指针崩溃。Claude Code 抽到的 16 条里真问题 2 条,13 条成立但影响小,其中多数它自己就标了 Nit。
react 的一个 PR 是个典型例子。改动里留了一行 it.only(,会让同文件其余测试全部被跳过。两个工具都报了这一条,参考答案里没有,两边都被记成不准。同一条问题,两个审查 agent 一个判真问题、一个判影响小,可见真问题和小问题之间的界线有主观成分;「说法是否成立」这一层两者判断一致。
所以 28% 对 44% 的准确率差距,量的是两种工具报不报小问题,不代表 Claude Code 有七成结论是错的。按「对上答案」计算,两边的准确率都被低估了。
复测的局限
- 没测 OCR 原生模式。 榜单里那组「1/9」测的是原生模式,分组、定位、复核这些设计也只在原生模式里运行,这次没有可用的模型 API 额度,无法直接验证。
- 样本只有 20 个 PR。 召回率 37% 对 16% 的差距足够大,准确率 28% 对 44% 在 20 个 PR 上会有一定波动。
- 每个 PR 只跑了一次。 判分跑了 3 轮,Claude Code 组的召回率在 34% 到 39% 之间,OCR 组 3 轮完全一致;审查本身没有重复跑。
- 判分模型不同。 榜单的判分模型没有公开,这次用的是 Claude Sonnet 5.5,所以这里的准确率和召回率不宜和榜单的绝对值直接比较。
使用建议
| 场景 | 建议 |
|---|---|
| 只有 Claude 订阅,审本地改动或 PR | 用 Claude Code 自带的 /code-review,先看标了 Important 的条目 |
| 有单独的模型 API,要在每个 PR 上自动审查 | 试 OCR 原生模式配官方 GitHub Action,上线前用 aacr-bench 和当前版 Claude Code 对照跑一遍 |
| 所用的 agent 没有自带审查命令 | 可以用 OCR 委托模式补上待审文件清单、按文件的规则和覆盖率检查(这次没测这种组合) |
| 团队对不同目录、文件类型有不同的审查要求 | 用 OCR 的 .opencodereview/rule.json 按路径写规则 |
第一条的依据是这次的数据:同一个模型下,/code-review 和 OCR 委托模式花费基本一样,找到的问题多一倍多;只看 Important 时准确率 40%,和 OCR 委托模式的 44% 接近,召回率仍高约 8 个点。
第二条是因为 OCR 区别于通用 agent 的那部分设计,也就是分组、子 agent 并发、定位和复核,只在原生模式里运行,这次没有测到。榜单里对照的 Claude Code 还是 6 月的 2.1.169,评估时要换成当前版本自己重跑。aacr-bench 的脚本是公开的,换个模型配置就能跑。
参考链接
- open-code-review:github.com/alibaba/ope...
- open-code-review 架构文档:github.com/alibaba/ope...
- aacr-bench 评测脚本:github.com/alibaba/aac...
- AACR-Bench 数据集:huggingface.co/datasets/Al...
- 评测指标说明:github.com/alibaba/aac...
- Claude Code changelog:github.com/anthropics/...
- Claude Code
/code-review文档:code.claude.com/docs/en/cod...