|--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| 英文名称: DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model 中文名称: DeepSeek-V2:强大、经济高效的专家混合语言模型 链接: http://arxiv.org/abs/2405.04434v2 代码: https://github.com/deepseek-ai/DeepSeek-V2 作者: DeepSeek-AI 机构: DeepSeek-AI 深度探索公司 日期: 2024-05-07 |
1 读后感
DeepSeek 最近推出的 V2 版本,无疑是当前性价比最高的选择。直观地讲:KIMI 的价格是 12 元/M tokens,Chat 的价格约为 3.5 元/M,GPT 4o 的价格约为 35 元/M。然而,DeepSeek 的价格仅为 1 元/M(这是按照输入计算的,输出通常是输入的两倍,美元兑换按 7 计算)。
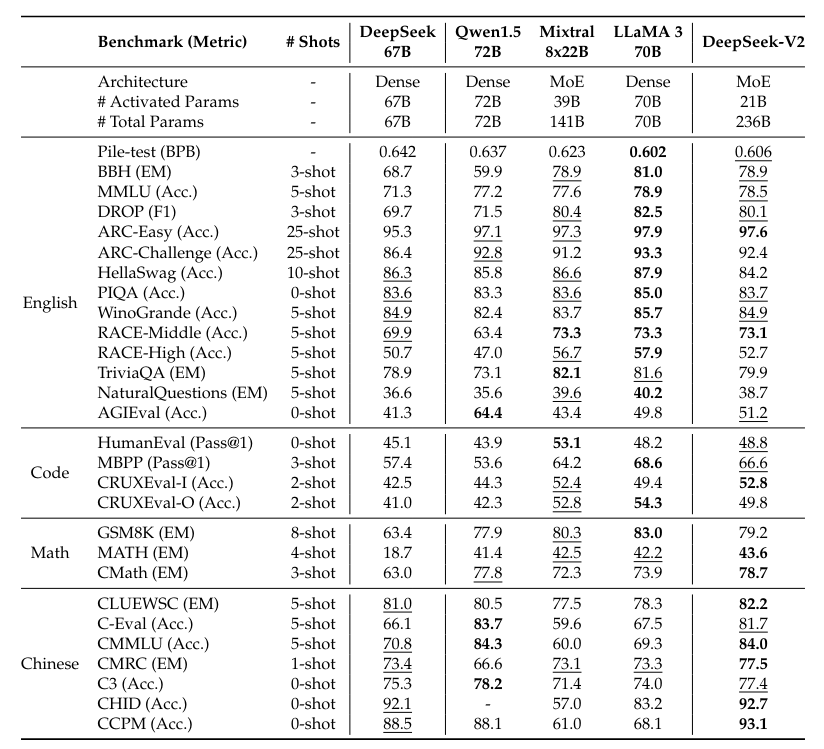
我在之前调研代码模型的时候就注意到 DeepSeek 的单模型在排名中很靠前。从论文和网站数据可以看到模型效果在开源领域,甚至在国内开源 + 闭源领域都算是很能打了,因为是一家中文公司,对中文也更加友好。从实验结果来看,它是一种对中文,英文,编码各方面水平比较均衡的模型。
DeepSeek 是一个开源模型,理论上可以在本地部署,但 MoE 的方式虽然快速,却占用大量内存,硬件成本也高。比起这样,购买他们的服务可能更划算。
本篇就来看看 DeepSeek 是如何实现降本增效的。
2 摘要
- 目标:DeepSeek-V2 是一个 MoE 语言模型,其特点是经济高效的训练和推理。
- 方法:DeepSeek-V2 采用了创新的架构,包括 Multi-head Latent Attention(MLA)和 DeepSeekMoE。MLA 通过将 Key-Value(KV)缓存显著压缩为潜在向量,确保了高效的推理;而 DeepSeekMoE 通过稀疏计算实现了经济高效的模型训练。
- 结论:与 DeepSeek 67B 相比,DeepSeek-V2 表现更强,同时节省了 42.5% 的训练成本,将 KV 缓存减少了 93.3%,并将最大生成吞吐量提升了 5.76 倍。
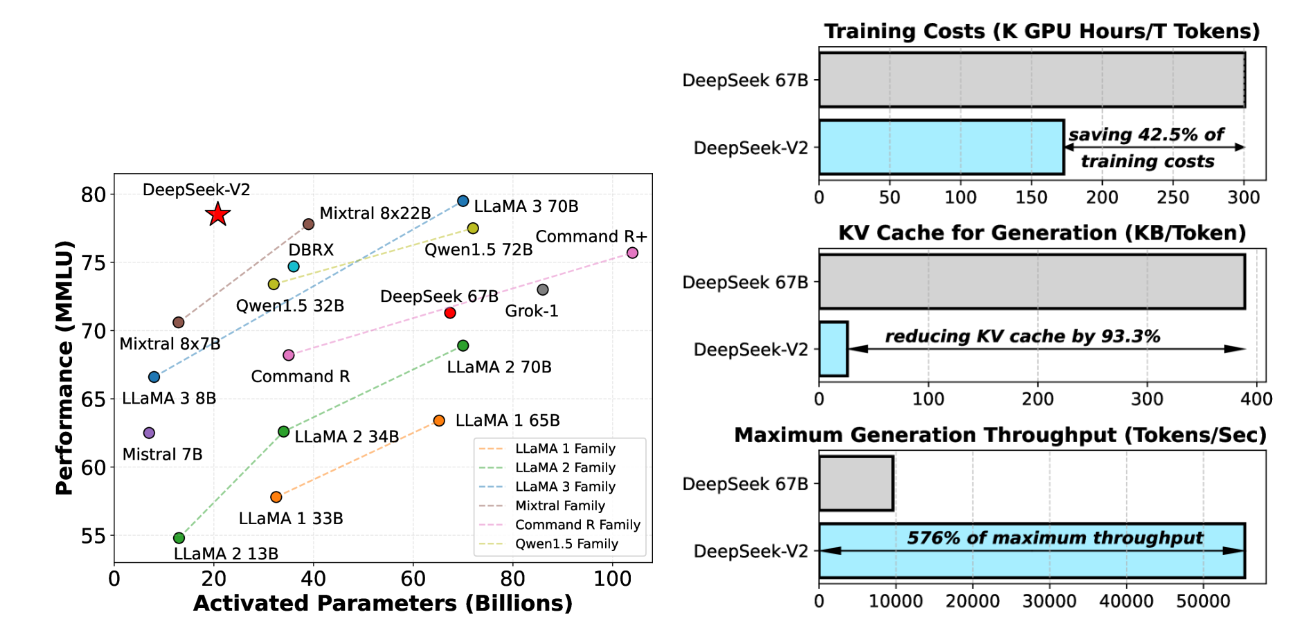
图 -1,左侧展示模型的理解能力,右侧展示成本和效率的改进。
3 方法
3.1 模型参数
- 总共包含了 236B 参数
- 其中每个 token 激活的参数为 21B
- 支持 128K 个 token 的上下文长度
3.2 架构改进
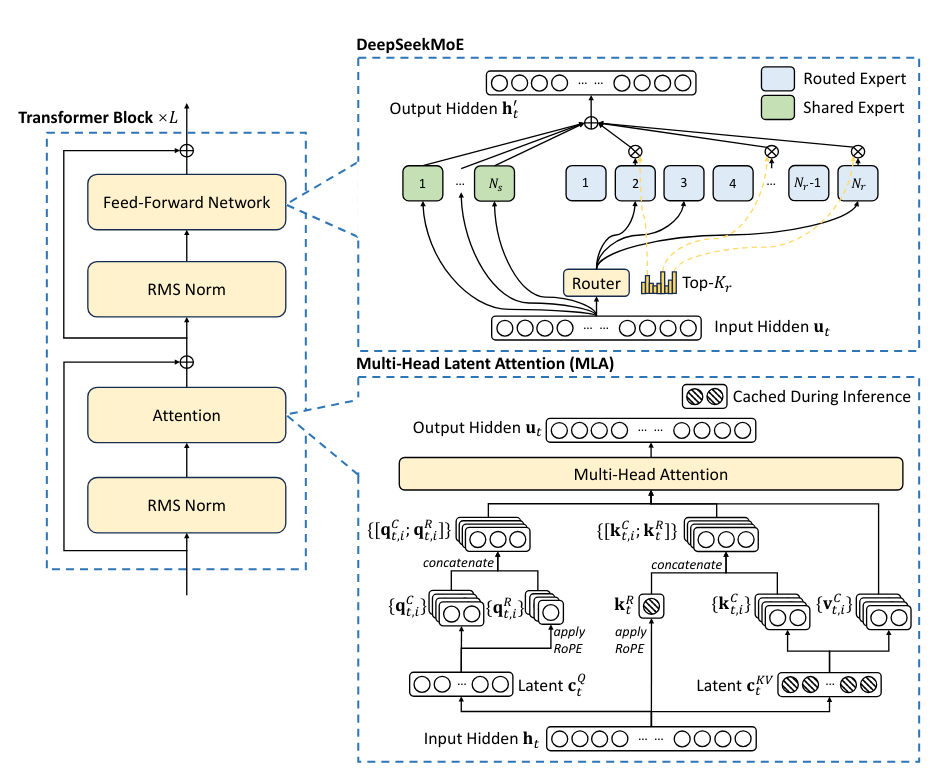
- 对于前馈网络(FFN),采用细粒度的专家分割和共享的专家隔离,以提高专家专业化的潜力。论文阅读_MoE_Switch Transformers
- 多头潜在注意力(MLA),配备低秩键值联合压缩的注意力机制。从而提高了推理效率,下面展开说明 MLA。
3.2.1 Multi-Head Latent Attention 多头潜在注意力
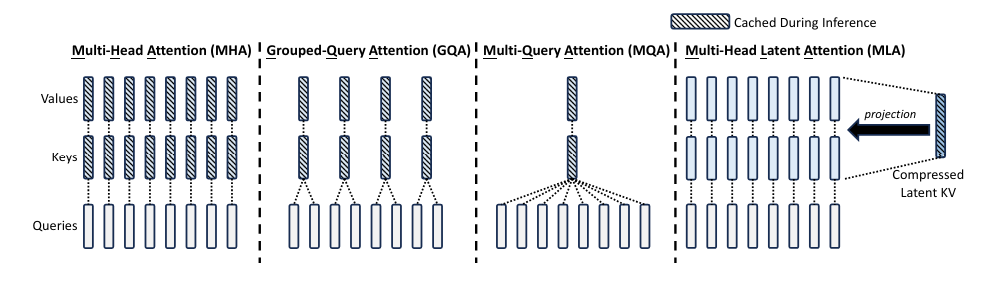
多头注意力(MHA)的键值(KV)缓存(Vaswani et al.,2017)对推理 LLMs 效率构成了重大障碍。为了减少 KV 缓存,提出了多查询注意力(MQA)和分组查询注意力(GQA)。它们需要较小量级的 KV 缓存,但它们的表现不如 MHA。
这篇文章中提出了低秩键值结合压缩。
𝑐𝑡𝐾𝑉=𝑊𝐷𝐾𝑉ℎ𝑡,𝑘𝑡𝐶=𝑊𝑈𝐾𝑐𝑡𝐾𝑉,𝑣𝑡𝐶=𝑊𝑈𝑉𝑐𝑡𝐾𝑉,𝑐𝑡𝑄=𝑊𝐷𝑄ℎ𝑡,𝑞𝑡𝐶=𝑊𝑈𝑄𝑐𝑡𝑄,
简单地讲,就是先用矩阵 W^DKV 压缩,到 c 的维度,即潜空间,c 的维度相比 h 维度小很多,𝑑𝑐′(≪𝑑ℎ𝑛ℎ),然后再计算 k,v 以及 q,在推理过程中,MLA 只需要缓存 𝐜𝑡𝐾𝑉。这和 LORA 原理差不多,也使用了低秩分解,其背景的原理是注意力存在冗余,可被压缩,并且还有可能因为提纯而得到更好的效果。
对比几种优化注意力机制:
3.2.2 解耦旋转位置嵌入
为配合 MLA,使用解耦旋转位置嵌入 RoPE 策略。
3.3 训练数据
- 构建了一个由 8.1T token 组成的高质量、多源的预训练语料库。
- 尤其强调了中文数据的收集,并确保了数据的高质。
- 为了执行 DeepSeek-V2 聊天的监督微调(SFT),我们收集了覆盖数学、代码、写作、推理、安全等各个领域的 1.5M 会话。
- 遵循 DeepSeekMath(Shao et al.,2024)的方法,采用了组相对策略优化(GRPO),旨在使我们的模型更好地符合人类的偏好。
4 实验结果
主实验结果: