下载地址:Apache Kafka
1. 上传并解压安装包
tar -zxvf kafka_2.13-3.6.2.tgz
修改文件名:mv kafka_2.13-3.6.2 kafka
2. 配置环境变量
sudo vim /etc/profile
|---------------------------------------------------------------------------------------|
| #配置kafka环境变量 export KAFKA_HOME=/export/server/kafka export PATH=PATH:KAFKA_HOME/bin |
使配置生效:source /etc/profile
3. 修改kafka配置文件
修改server.properties(在文件中找到相应位置进行修改)
|-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| # The id of the broker. This must be set to a unique integer for each broker. broker.id=1 #其他节点分别配置不同数值即可,本人依次递增1,2,3 # listeners = PLAINTEXT://your.host.name:9092 listeners=PLAINTEXT://node1:9092 #其他节点分别改为node2,node3,node4 # A comma separated list of directories under which to store log files log.dirs=/export/server/kafka_2.13-3.2.0/logs #需要自己创建logs目录 ####### Zookeeper ##### # Zookeeper connection string (see zookeeper docs for details). # This is a comma separated host:port pairs, each corresponding to a zk # server. e.g. "127.0.0.1:3000,127.0.0.1:3001,127.0.0.1:3002". # You can also append an optional chroot string to the urls to specify the # root directory for all kafka znodes. zookeeper.connect=node1:2181,node2:2181,node3:2181,node4:2181/Kafka num.partitions=5 # 默认partition数量为1,如果topic在创建时没有指定partition数量,默认使用此值,建议改为5 auto.create.topics.enable=false #自动创建topic参数,建议此值设置为false,严格控制topic管理,防止生产者错写topic。 default.replication.factor=3 #默认副本数量为1,建议改为2。 delete.topic.enable=true #启用deletetopic参数,建议设置为true controlled.shutdown.enable=true #允许broker shutdown。如果启用,broker在关闭自己之前会把它上面的所有leaders转移到其它brokers上,建议启用,增加集群稳定性。 offsets.topic.replication.factor=3 |
4.开启Kafka服务
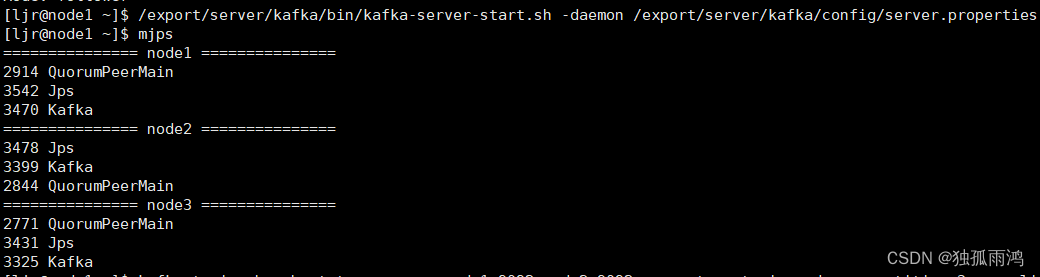
先启动zookeeper,再在各节点分别开启服务
/export/server/kafka/bin/kafka-server-start.sh -daemon /export/server/kafka/config/server.properties
5.简单使用
Kafka常用命令
(1)查看Kafka Topic列表
kafka-topics.sh --bootstrap-server node1:9092,node2:9092 --list
(2)创建Kafka Topic
kafka-topics.sh --bootstrap-server node1:9092,node2:9092 --create --topic customers --partitions 3 --replication-factor 3
(3个分区,三个副本)


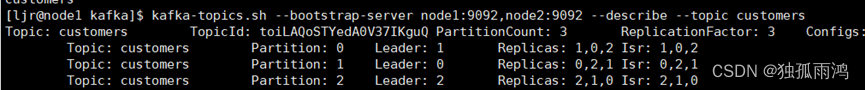
(3)查看topic的详情
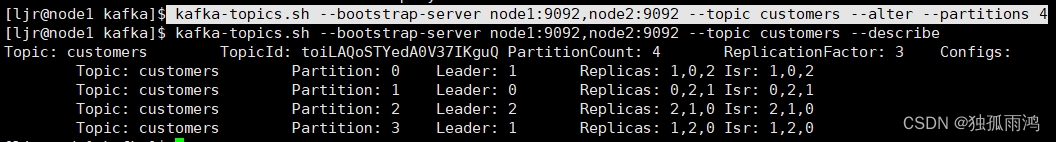
kafka-topics.sh --bootstrap-server node1:9092,node2:9092 --topic customers --describe
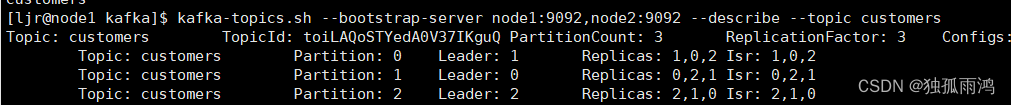
(4)增加分区
kafka-topics.sh --bootstrap-server node1:9092,node2:9092 --topic customers --alter --partitions 4
(5)删除Kafka Topic
kafka-topics.sh --bootstrap-server node1:9092,node2:9092 --delete --topic topic

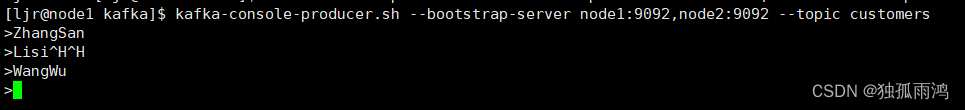
(6)Kafka生产消息
kafka-console-producer.sh --bootstrap-server node1:9092,node2:9092 --topic customers
(7)Kafka消费消息
kafka-console-consumer.sh -bootstrap-server node1:9092,node2:9092 --topic customers --from-beginning
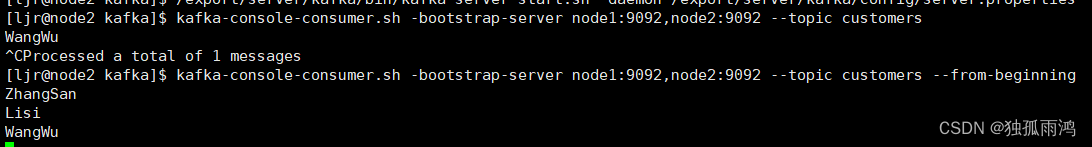
--from-beginning:会把主题中以往所有的数据都读取出来。根据业务场景选择是否增加该参数。
6.关闭Kafka
/export/server/kafka/bin/kafka-server-stop.sh
集群关闭顺序:先关闭Kafka,再关闭Zookeeper,最后关闭hadoop