安装IK分词器
网址:https://github.com/infinilabs/analysis-ik

3.1.在线安装ik插件(较慢,不推荐)
shell
# 进入容器内部 es为容器名称
docker exec -it es /bin/bash

# 在线下载并安装 7.17.21为镜像版本要与之前保持一致
./bin/elasticsearch-plugin  install https://github.com/medcl/elasticsearch-analysis-ik/releases/download/v7.17.21/elasticsearch-analysis-ik-7.17.21.zip

#退出
exit
#重启容器
docker restart es
3.2.离线安装ik插件(推荐)
1)下载ik,解压缩分词器安装包
ik下载地址:https://release.infinilabs.com/
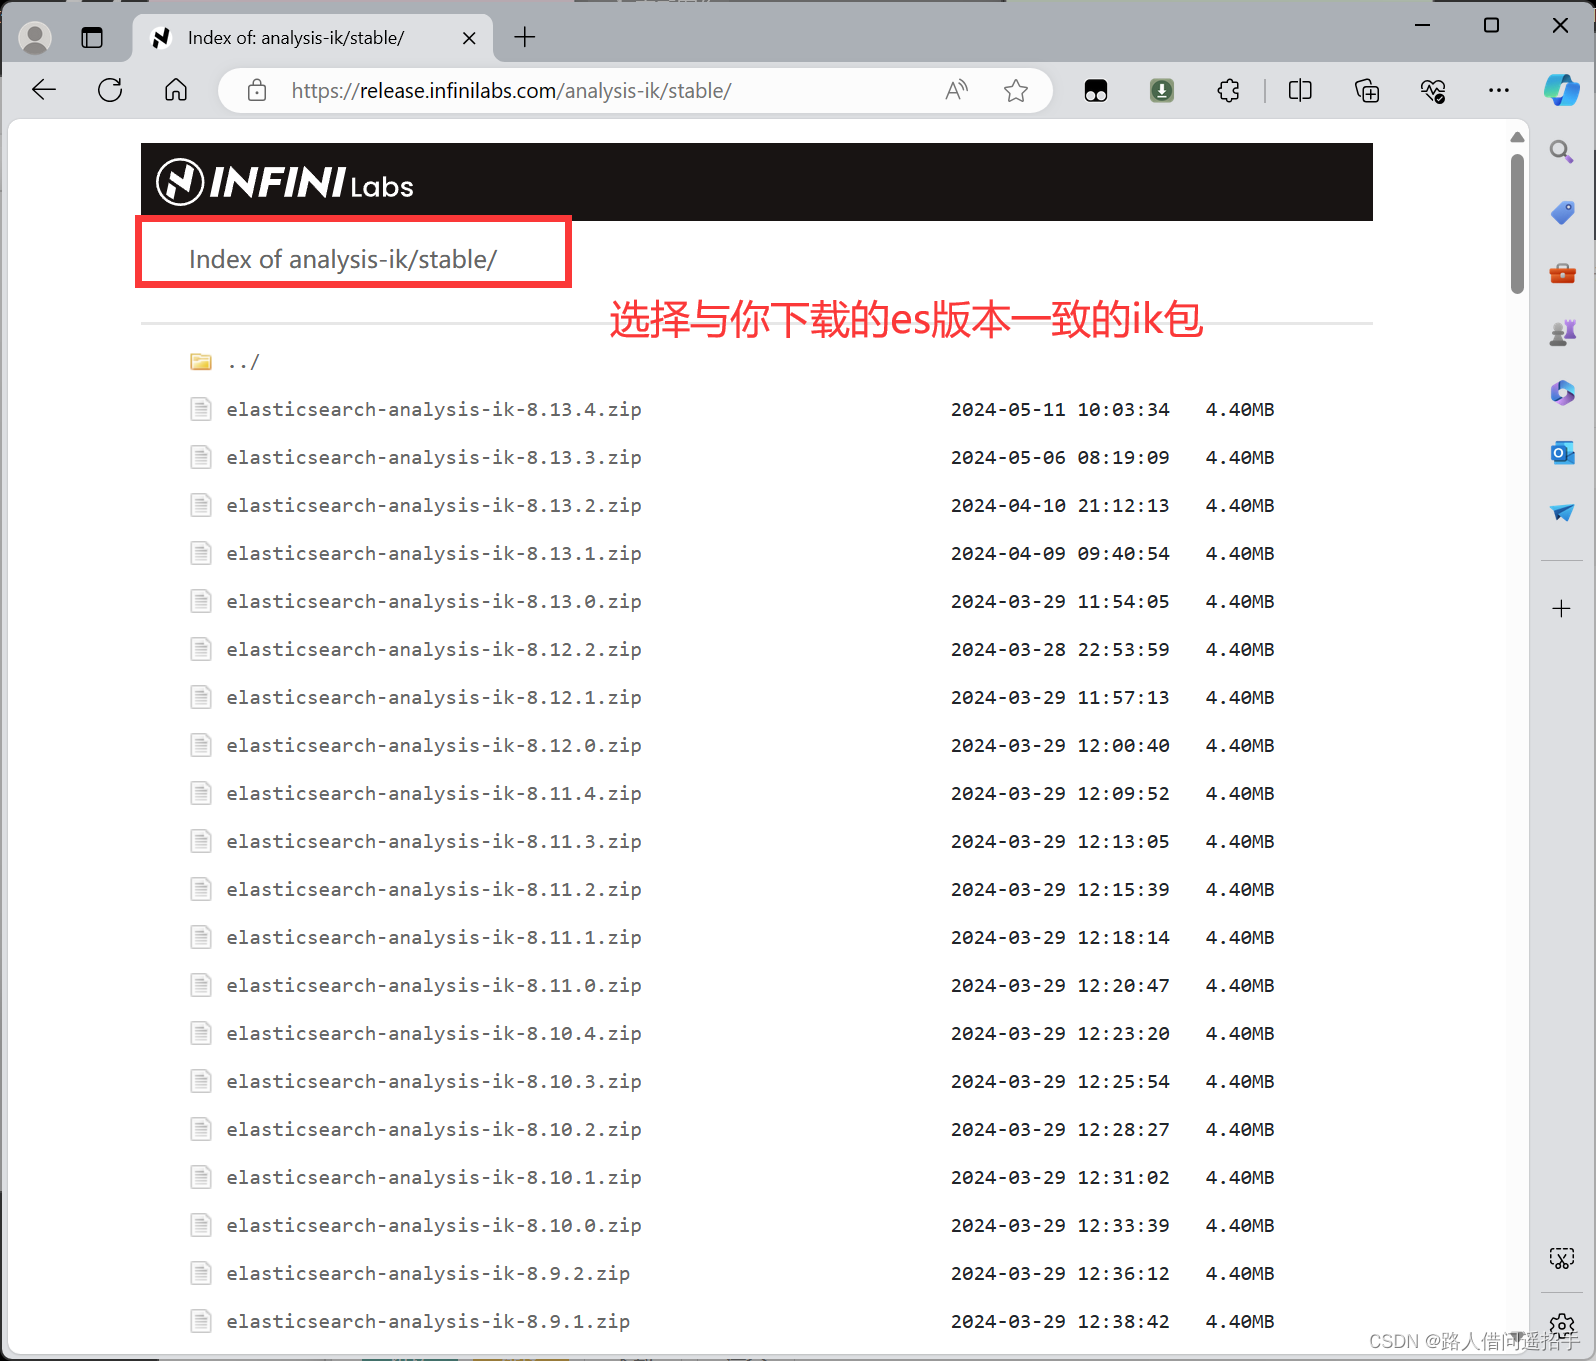
将解压后的ik包拖入虚拟机中
2)查看数据卷目录
安装插件需要知道elasticsearch的plugins目录位置,而我们用了数据卷挂载,因此需要查看elasticsearch的数据卷目录,通过下面命令查看:
sh
sudo docker volume inspect es-plugins显示结果:

说明plugins目录被挂载到了:/var/lib/docker/volumes/es-plugins/_data 这个目录中。
3)将ik包拖到到es容器的插件数据卷中
也就是/var/lib/docker/volumes/es-plugins/_data :

4)重启容器
shell
# 4、重启容器
docker restart es
sh
# 查看es日志
docker logs -f es
5)测试:
IK分词器包含两种模式:
-
ik_smart:最少切分 -
ik_max_word:最细切分
json
POST /_analyze
{
  "text":"合理小姐是凑巧先生独一无二的女主角",
  "analyzer": "ik_smart"
}
结果:
json
{
  "tokens" : [
    {
      "token" : "合理",
      "start_offset" : 0,
      "end_offset" : 2,
      "type" : "CN_WORD",
      "position" : 0
    },
    {
      "token" : "小姐",
      "start_offset" : 2,
      "end_offset" : 4,
      "type" : "CN_WORD",
      "position" : 1
    },
    {
      "token" : "是",
      "start_offset" : 4,
      "end_offset" : 5,
      "type" : "CN_CHAR",
      "position" : 2
    },
    {
      "token" : "凑巧",
      "start_offset" : 5,
      "end_offset" : 7,
      "type" : "CN_WORD",
      "position" : 3
    },
    {
      "token" : "先生",
      "start_offset" : 7,
      "end_offset" : 9,
      "type" : "CN_WORD",
      "position" : 4
    },
    {
      "token" : "独一无二",
      "start_offset" : 9,
      "end_offset" : 13,
      "type" : "CN_WORD",
      "position" : 5
    },
    {
      "token" : "的",
      "start_offset" : 13,
      "end_offset" : 14,
      "type" : "CN_CHAR",
      "position" : 6
    },
    {
      "token" : "女主角",
      "start_offset" : 14,
      "end_offset" : 17,
      "type" : "CN_WORD",
      "position" : 7
    }
  ]
}
3.3 扩展词词典
随着互联网的发展,"造词运动"也越发的频繁。出现了很多新的词语,在原有的词汇列表中并不存在。比如:"奥力给","传智播客" 等。
所以我们的词汇也需要不断的更新,IK分词器提供了扩展词汇的功能。
要拓展ik分词器的词库,只需要修改一个iK分词器目录中的confia目录中的lkAnalvzer.cfa.xml文件:
1)打开IK分词器config目录:
2)在IKAnalyzer.cfg.xml配置文件内容添加:
xml
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE properties SYSTEM "http://java.sun.com/dtd/properties.dtd">
<properties>
        <comment>IK Analyzer 扩展配置</comment>
        <!--用户可以在这里配置自己的扩展字典 *** 添加扩展词典-->
        <entry key="ext_dict">ext.dic</entry>
</properties>
3)新建一个 ext.dic,可以参考config目录下复制一个配置文件进行修改
properties
山不在高
有杨则名
水不在深
有龙则灵
4)重启elasticsearch
sh
docker restart es

# 查看 日志
docker logs -f elasticsearch
日志中已经成功加载ext.dic配置文件
注意当前文件的编码必须是 UTF-8 格式,严禁使用Windows记事本编辑
3.4 停用词词典
在互联网项目中,在网络间传输的速度很快,所以很多语言是不允许在网络上传递的,如:关于宗教、政治等敏感词语,那么我们在搜索时也应该忽略当前词汇。
IK分词器也提供了强大的停用词功能,让我们在索引时就直接忽略当前的停用词汇表中的内容。
1)IKAnalyzer.cfg.xml配置文件内容添加:
xml
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE properties SYSTEM "http://java.sun.com/dtd/properties.dtd">
<properties>
        <comment>IK Analyzer 扩展配置</comment>
        <!--用户可以在这里配置自己的扩展字典-->
        <entry key="ext_dict">ext.dic</entry>
         <!--用户可以在这里配置自己的扩展停止词字典  *** 添加停用词词典-->
        <entry key="ext_stopwords">stopword.dic</entry>
</properties>
3)在 stopword.dic 添加停用词
properties
小黄花,向杨而生4)重启elasticsearch
sh
# 重启服务
docker restart elasticsearch
docker restart kibana

# 查看 日志
docker logs -f elasticsearch
日志中已经成功加载stopword.dic配置文件
注意当前文件的编码必须是 UTF-8 格式,严禁使用Windows记事本编辑