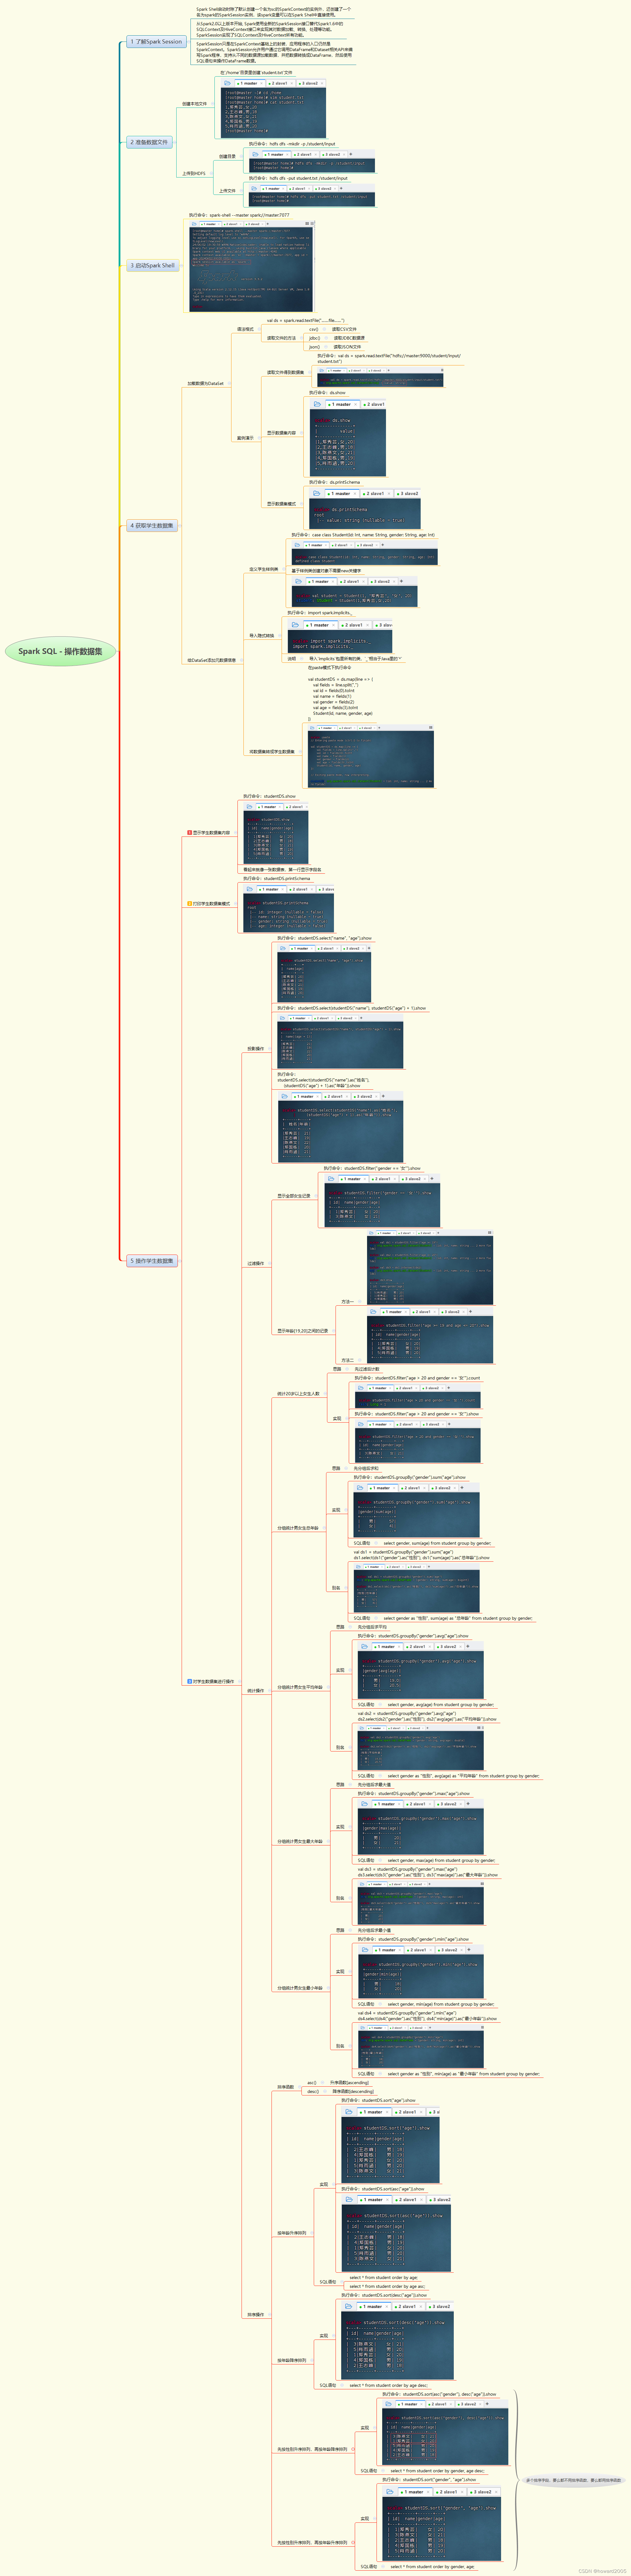
本教程将通过一个具体的案例来演示如何在Spark SQL中操作数据集。我们将从创建本地文件开始,然后上传到HDFS,并使用Spark Shell启动Spark程序。接下来,我们将加载数据为DataSet,并给DataSet添加元数据信息。最后,我们将对数据集进行各种操作,如投影、过滤、统计和排序等。
具体步骤如下:
- 在
/home目录里创建student.txt文件。 - 执行命令:hdfs dfs -mkdir -p /student/input,创建目录。
- 执行命令:hdfs dfs -put student.txt /student/input,上传文件。
- 执行命令:spark-shell --master spark://master:7077,启动Spark Shell。
- 执行命令:val ds = spark.read.textFile("hdfs://master:9000/student/input/student.txt"),读取文件得到数据集。
- 执行命令:ds.show,显示数据集内容。
- 执行命令:ds.printSchema,显示数据集模式。
- 定义学生样例类:case class Student(id: Int, name: String, gender: String, age: Int)。
- 导入隐式转换:import spark.implicits._。
- 将数据集转成学生数据集:val studentDS = ds.map(line => { val fields = line.split(","); val id = fields(0).toInt; val name = fields(1); val gender = fields(2); val age = fields(3).toInt; Student(id, name, gender, age) })。
- 对学生数据集进行操作,如投影、过滤、统计和排序等。