扩散模型Stable Diffusion

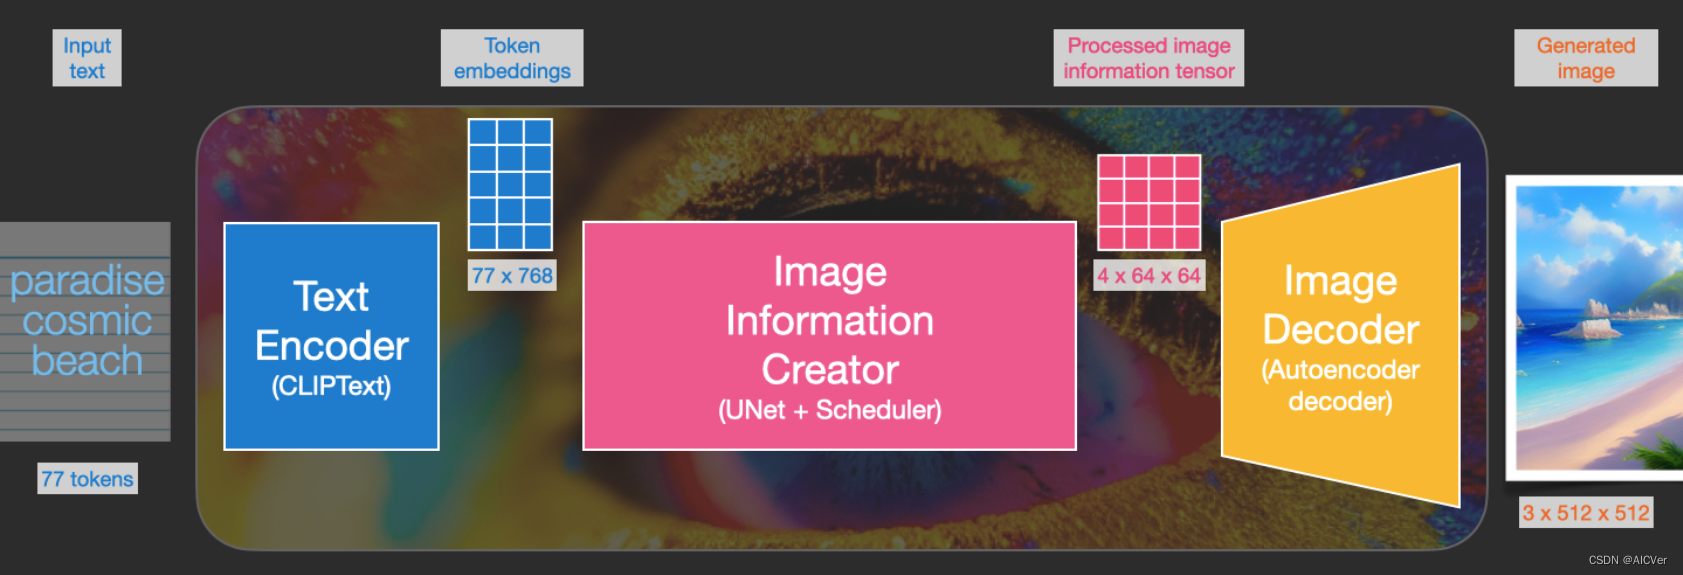
扩散模型构成

Text Encoder(CLIPText)

Clip Text为文本编码器。以77 token为输入,输出为77 token 嵌入向量,每个向量有768维度。

Diffusion(UNet+Scheduler)
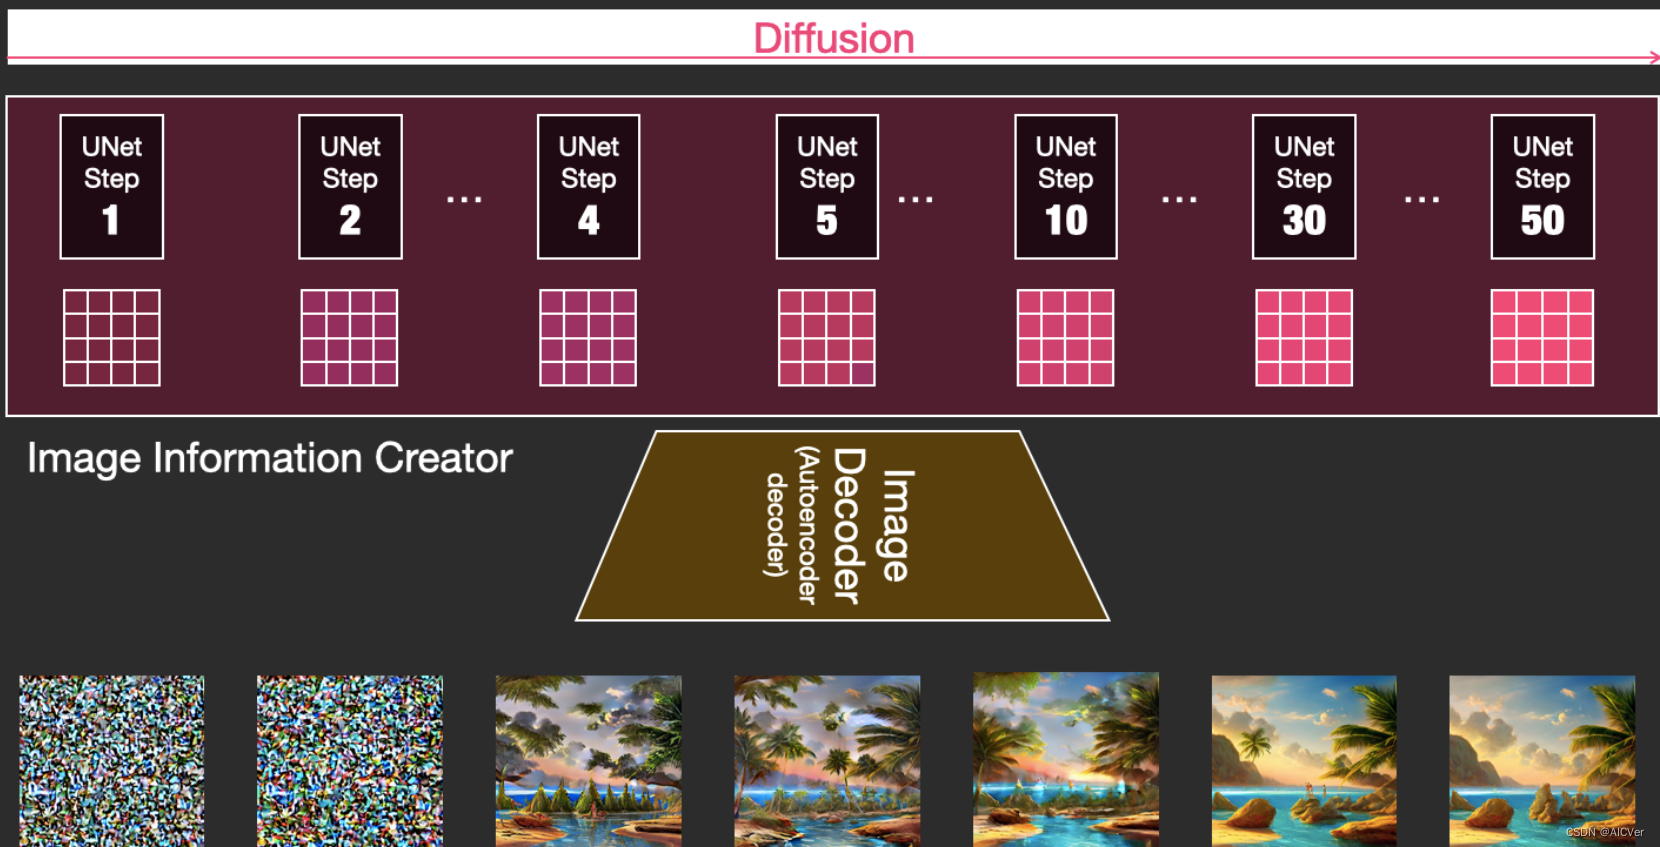
在潜在空间中逐步处理扩散信息。以文本嵌入向量和由噪声组成的起始多维数组为输入,输出处理的信息数组。

UNet
训练过程
  1. 随机噪声添加到图像上,构成一个训练样本
  2. 不同的噪声不同的图像,可构成训练集
  3. 使用上述训练集,训练噪声预测模型(Unet)
推理过程

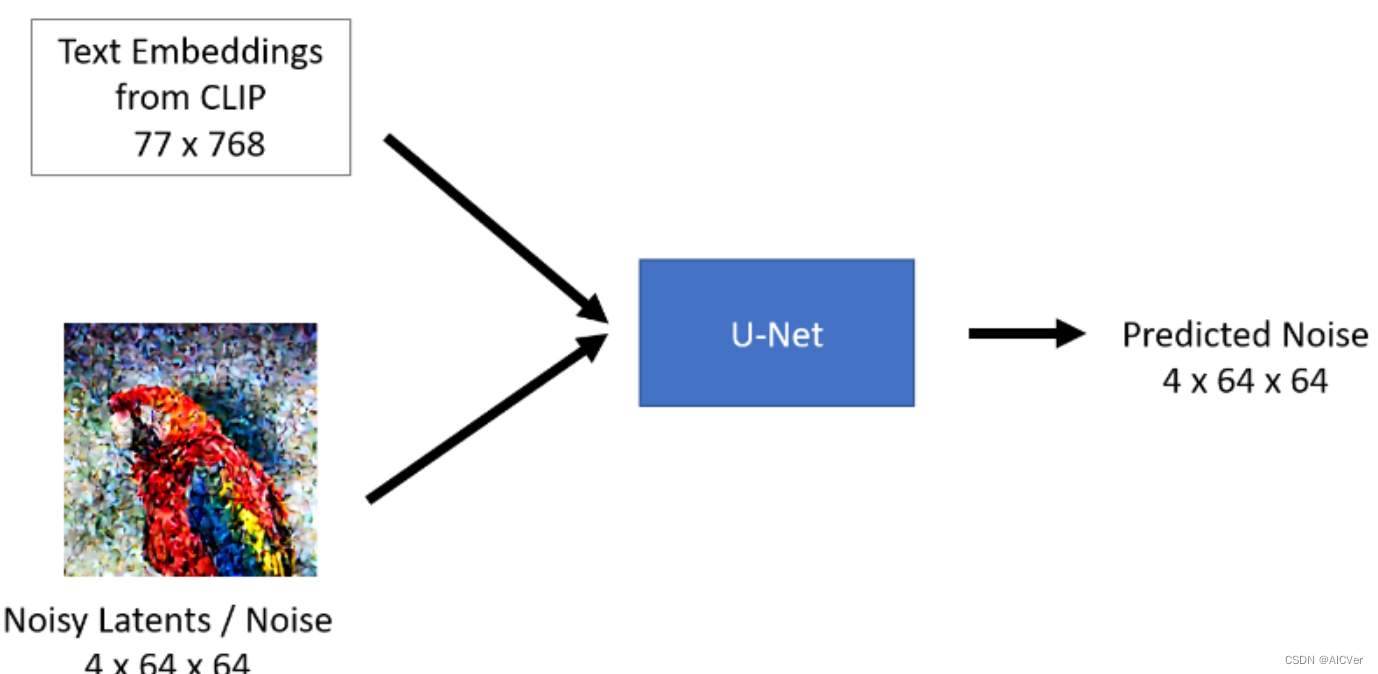
通常来说一个U-Net包含两个输入:

  • Noisy latent/Noise : 该Noisy latent主要是由VAE编码器产生并在其基础上添加了噪声;或者如果我们想仅根据文本描述来创建随机的新图像,则可以采用纯噪声作为输入。
  • Text embeddings: 基于CLIP的将文本输入提示转化为文本语义嵌入(embedding)

U-Net模型的输出:

  • 从包含输入噪声的Noisy Latents中预测其所包含的噪声。换句话说,它预测输出的为Noisy Latents减去de-noised latents后的结果。

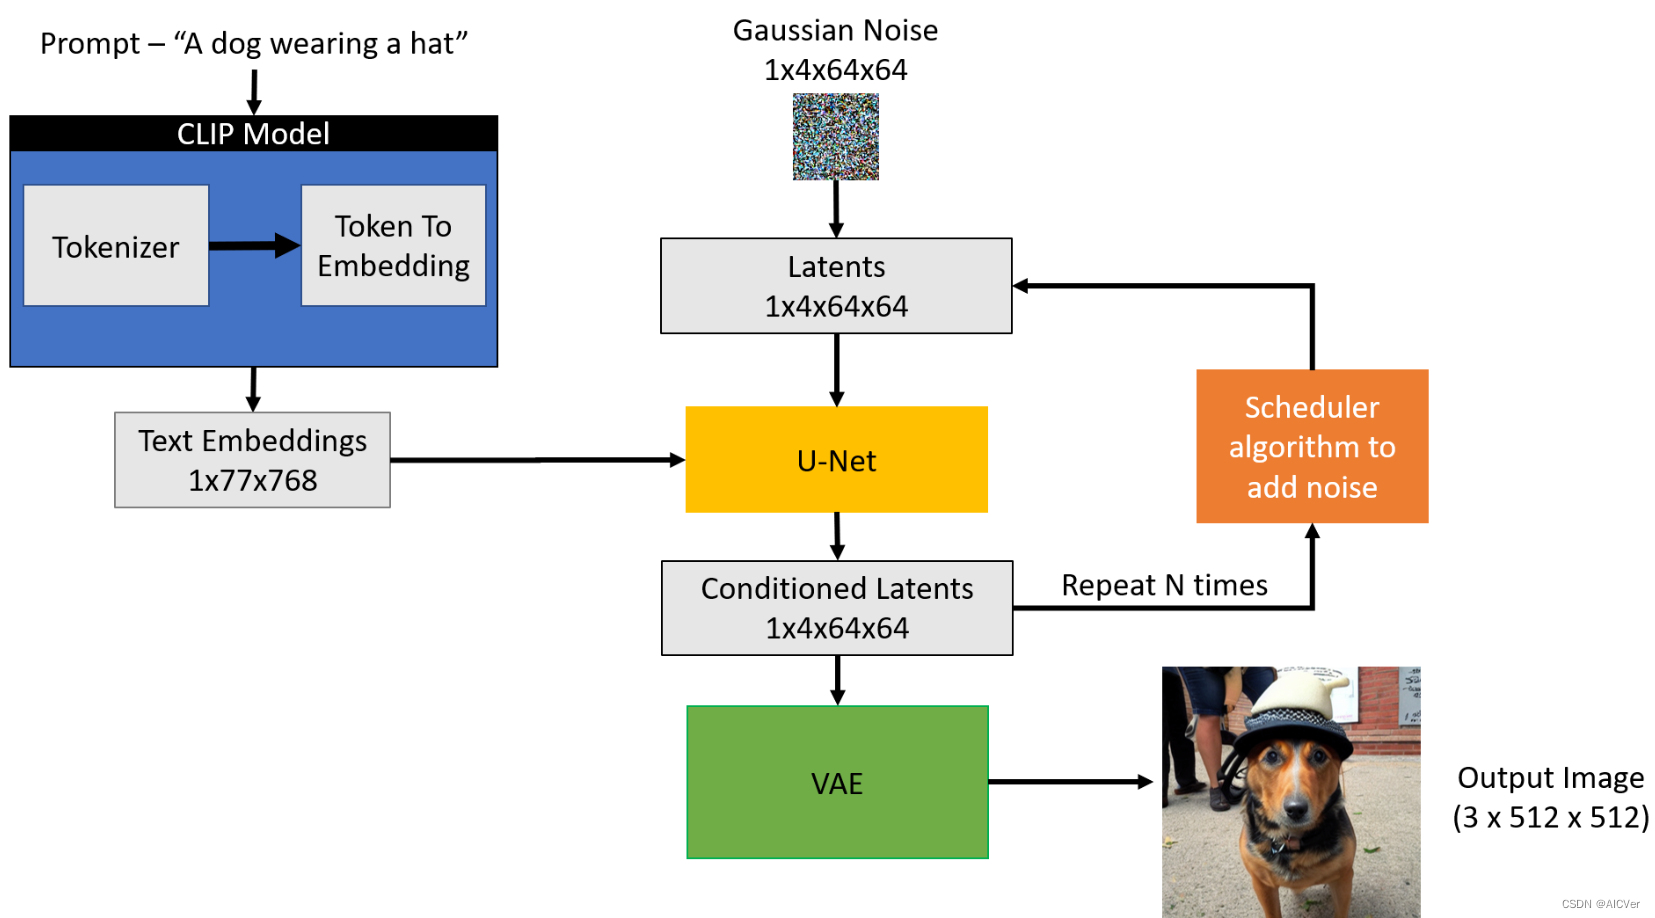
Scheduler

scheduler的目的是确定在扩散过程中的给定的步骤中向latent 添加多少噪声。随着step的增大,添加噪声的权重在逐渐减小。
相关推荐
Miss小乐5 天前
stable-diffusion-webui安装教程和遇到的问题解决
stable diffusion
Είναι η κοπέλα6 天前
Stable Diffusion文生图:本地 AI 绘画事实标准入门
人工智能·stable diffusion
瑶山11 天前
stable-diffusion.cpp 参数全集整理(sd-cli.exe / sd-server.exe)
java·数据库·stable diffusion·参数全集
云间月131412 天前
Stable Diffusion WebUI完整部署:从本地出图到7860远程访问
stable diffusion
霸道流氓气质12 天前
Java调用StableDiffusion/ComfyUI图像生成:DAG工作流编排、WebSocket实时进度与Flux模型集成的生产级实战
java·websocket·stable diffusion
一木 之林21 天前
《OpenAI库基础学习总结:Client 初始化、流式输出 delta 拼接与多轮历史 messages 全流程拆解》
人工智能·学习·计算机视觉·stable diffusion·aigc
一木 之林23 天前
Stable Diffusion 详解:潜空间扩散原理、三件套分工与 diffusers 文生图实战
人工智能·计算机视觉·stable diffusion
AIGC小尼1 个月前
本地AI漫剧部署|低配8G显存实战部署MiniMax-H3|4步极速采样+低显存优化完整方案(可角色替换/视频魔改)
人工智能·stable diffusion·comfyui·ai漫剧
一去不复返的通信er1 个月前
Stable Diffusion详解
stable diffusion
月疯2 个月前
Stable Diffusion是如何生成视频
人工智能·stable diffusion