Scrapy框架与一般的爬虫代码之间有几个显著的区别,这些差异主要体现在设计模式、代码结构、执行效率以及可扩展性等方面。下面是一些关键的不同点:
-
结构化与模块化:
-
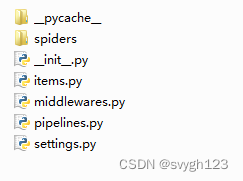
Scrapy :提供了高度结构化的框架,包括定义好的Spider类、Item容器、Pipelines、中间件等,这使得爬虫项目更易于组织和维护。
-
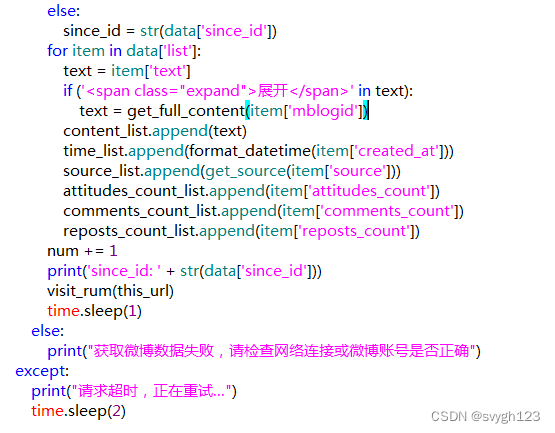
一般爬虫 :可能只是简单的脚本或程序,缺乏清晰的模块划分,通常需要手动处理很多细节,如数据存储、错误处理等。
-
-
异步处理与并发:
-
Scrapy:基于Twisted异步网络框架,可以高效地处理多个HTTP请求,同时下载多个页面,大大提高了爬取速度。
-
一般爬虫:可能是同步的,这意味着它需要等待一个请求完成才能发送下一个,这在处理大量请求时会非常慢。
-
-
自动重试与错误处理:
- Scrapy:具有自动重试机制,当请求失败时,可以自动重新发送请求;并且有详细的错误处理和日志记录。
- 一般爬虫:可能需要手动添加重试逻辑和错误处理代码。
-
数据流与Pipeline:
- Scrapy:定义了数据流的概念,从爬取到存储的数据处理过程可以被分解成多个步骤,即Pipelines,每个Pipeline负责一部分数据处理工作。
- 一般爬虫:数据处理通常是在主程序中完成,可能缺乏对数据流的明确分离。
-
配置与命令行接口:
- Scrapy:提供了丰富的配置选项和命令行接口,可以方便地启动爬虫、查看状态、调试问题等。
- 一般爬虫:配置和启动可能更简单,但灵活性和可配置性较低。
-
扩展性和插件系统:
-
Scrapy :支持多种中间件,包括下载中间件和蜘蛛中间件,可以轻松地扩展功能,如添加代理、用户代理池、cookie处理等。
-
一般爬虫:可能需要从零开始实现所有功能,缺乏现成的扩展机制。
-
-
社区与资源:
- Scrapy:有一个活跃的社区,提供了大量的文档、教程和示例项目,对于初学者来说更容易上手。
- 一般爬虫:可能依赖于个人经验和在线搜索,资源和帮助相对分散。
总的来说,Scrapy框架提供了更为强大、高效、易用的爬虫解决方案,特别适用于大规模、复杂的爬虫项目。而一般的爬虫代码可能更适合小规模或特定需求的爬虫任务。