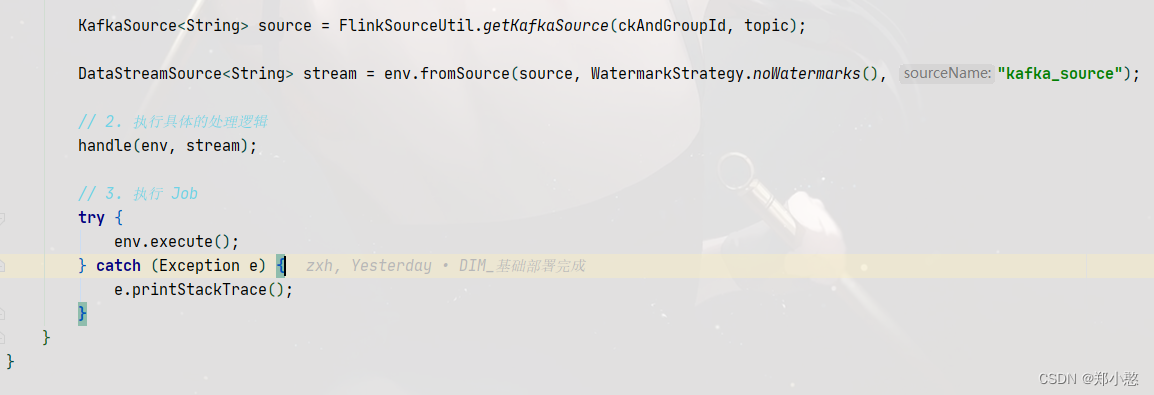
使用Flink接受kafka中的数据并对数据进行ETL

做这个开发是因为:在实际开发操作中,你的kafka主题中会有大量的数据但是需求并不需要所有数据,所有我们要对数据进行清洗,把需要的数据保存在flink流中,为下流的开发做好数据保障!

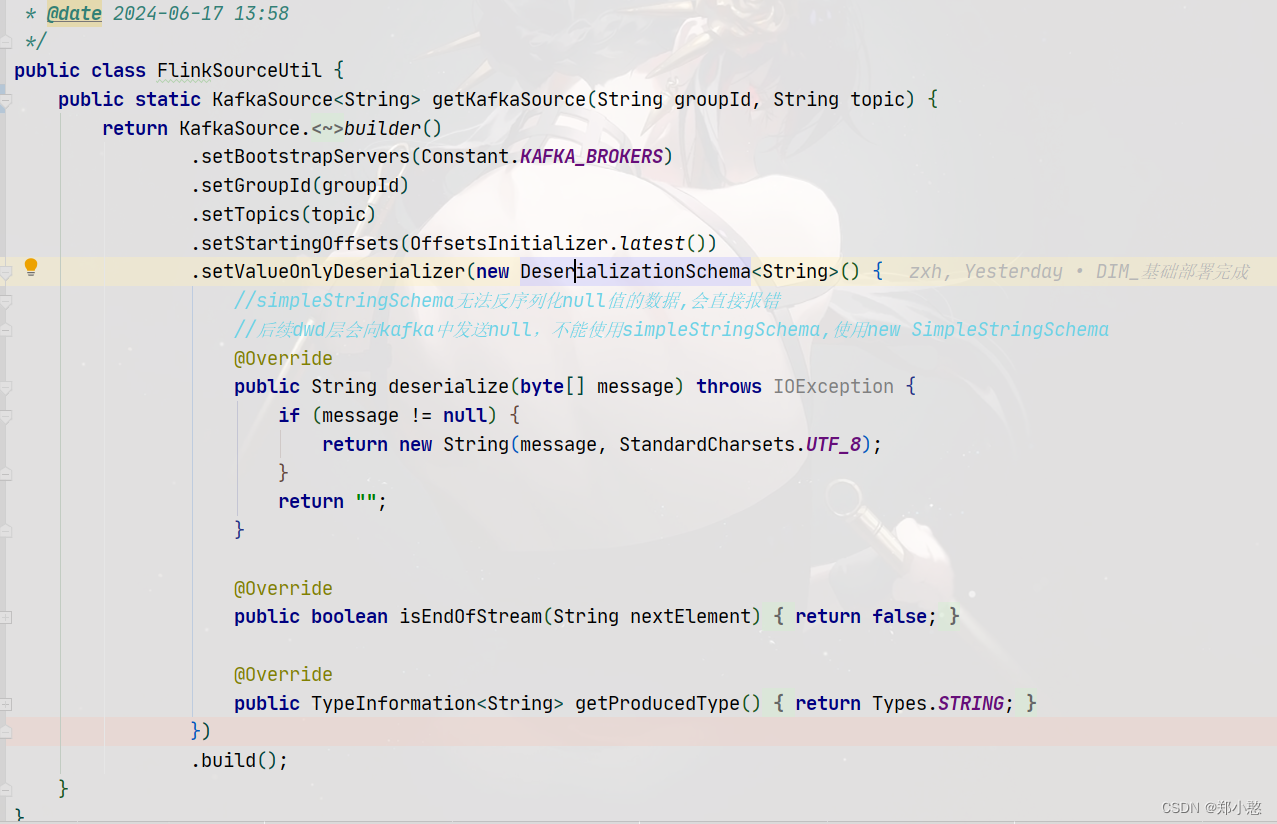
首先创建工具类
再写一个抽象类,测试阶段可以把状态后端和检查点给注释掉,可以提高效率

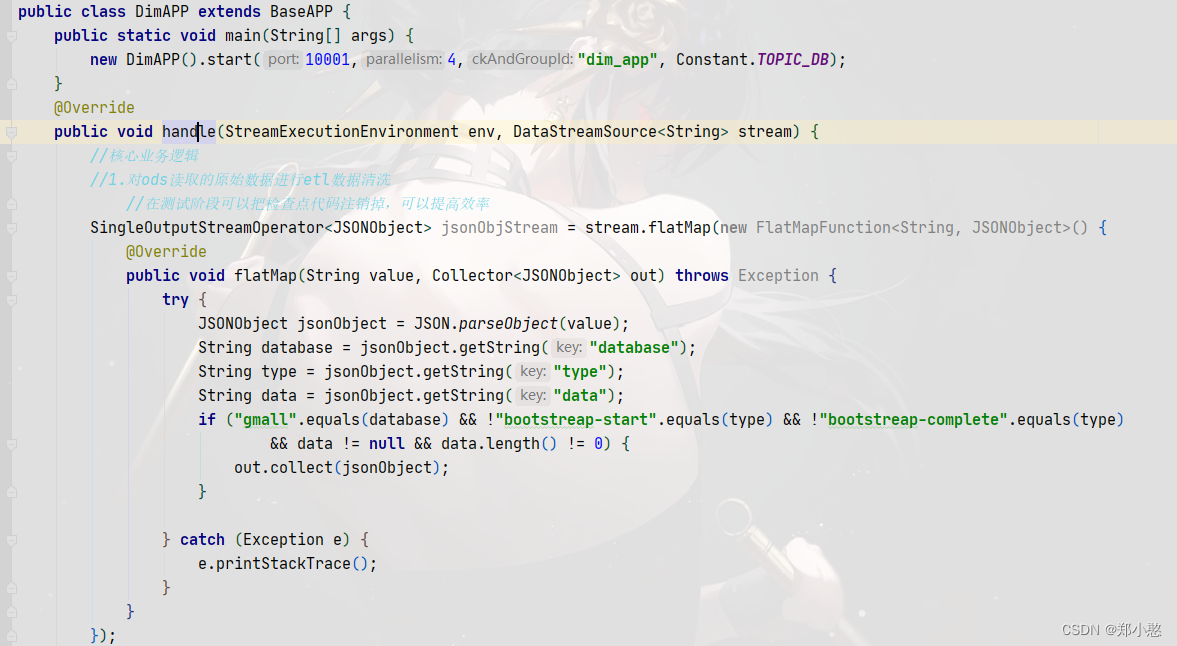
再写一个主程序继承抽象类中的方法,并在程序中对数据进行etl
相关推荐
qq_452396234 天前
第二篇:《CommitLog + ConsumeQueue:一条日志解决 Kafka 多分区随机写的难题》
分布式·kafka
我不会起名字3226 天前
消费回调固定 return nil:错误传播与 Kafka 位点提交的区别
后端·mongodb·kafka·go·im·故障排查
qq_452396236 天前
第十篇:《Kafka 安全加固:SASL、SSL、ACL 与多租户隔离》
安全·kafka·ssl
用户3610588626127 天前
KafkaProducer 元数据管理:send() 卡住时,它在等什么
kafka
空奈qwq7 天前
【Kafka 从入门到实战】从手写一个队列到生产级消息中间件:架构、分区、消费组、零拷贝全解析
分布式·架构·kafka
且从容.8 天前
ubuntu安装flink
linux·ubuntu·flink
用户3610588626129 天前
深度拆解 Kafka 源码:Producer 构造器装配了哪些核心组件
kafka
知识搬运临时工10 天前
Kafka 发 1 GiB 数据,用户态 CPU 只花 0.016 秒,总耗时反而慢了 11%
后端·kafka
用户36105886261211 天前
Flink 内存分配源码深度剖析:从启动计算到运行时动态分配的完整链路
大数据·flink