解析PDF文件中的图片为文本
1 介绍
解析PDF文件中的图片,由两种思路,一种是自己读取PDF文件中的图片,然后用OCR解析,例如:使用PyMuPDF读取pdf文件,再用PaddleOCR或者Tesseract-OCR识别文字。另一种使用第三方框架,直接读取文字,例如:OCRmyPDF。
读取pdf的包PyMuPDF可以获取PDF中的文本、布局和图片等,并且内嵌了Tesseract-OCR需要独立安装Tesseract项目的tessdata,有兴趣可以试试。
# 开发文档
https://pymupdf.readthedocs.io/en/latest/

# Github地址
https://github.com/pymupdf/PyMuPDF
此外,PDF转word用的pdf2docx就用到了PyMuPDF、生成word部分使用的是python-docx
# pdf2docx包
https://github.com/ArtifexSoftware/pdf2docx
OCRmyPDF是基于Tesseract-OCR框架使用Python实现的开源项目,主要解决扫描版的PDF文本识别,可以实现扫描版本的文件查询和解析。
# GitHub地址
https://github.com/ocrmypdf/OCRmyPDF

# 开发文档
https://ocrmypdf.readthedocs.io/en/latest/index.html
2 安装环境
本文使用PyMuPDF和PaddleOCR识别pdf文件中的OCR。
# 安装PyMuPDF
pip install PyMuPDF -i https://pypi.tuna.tsinghua.edu.cn/simple

# 安装paddlepaddle(我用的是cpu版本)
pip install paddlepaddle -i https://mirror.baidu.com/pypi/simple

# 安装paddleocr,注意版本问题
# 使用Python时,如果出现"NameError: name 'predict_system' is not defined"错误,请设置版本,我用的是2.7.2
pip install paddleocr -i https://mirror.baidu.com/pypi/simple

# PaddleOCR模型下载地址
https://github.com/PaddlePaddle/PaddleOCR/blob/main/doc/doc_ch/models_list.md
3 源代码
python
import pymupdf

from paddleocr import PaddleOCR


def parse_img_2_text(img_path: str):
    # 'use_gpu=False'不用gpu,默认使用GPU
    # 'use_angle_cls=True'自动下载相关的包
    # 'lang="ch"'设置语言,支持中英文、英文、法语、德语、韩语、日语,参数依次为`ch`, `en`, `french`, `german`, `korean`, `japan`。
    # 离线使用时,设置模型的目录det_model_dir、rec_model_dir、cls_model_dir第一次联网模型会自动下载到model目录下
    ocr_model = PaddleOCR(
        use_gpu=False,
        use_angle_cls=True,
        det_model_dir="./model/ch_PP-OCRv4_det_infer/",
        rec_model_dir="./model/ch_PP-OCRv4_rec_infer/",
        cls_model_dir="./model/ch_ppocr_mobile_v2.0_cls_infer/"
    )

    # 识别图片
    result = ocr_model.ocr(img_path, cls=True)
    for idx in range(len(result)):
        res = result[idx]
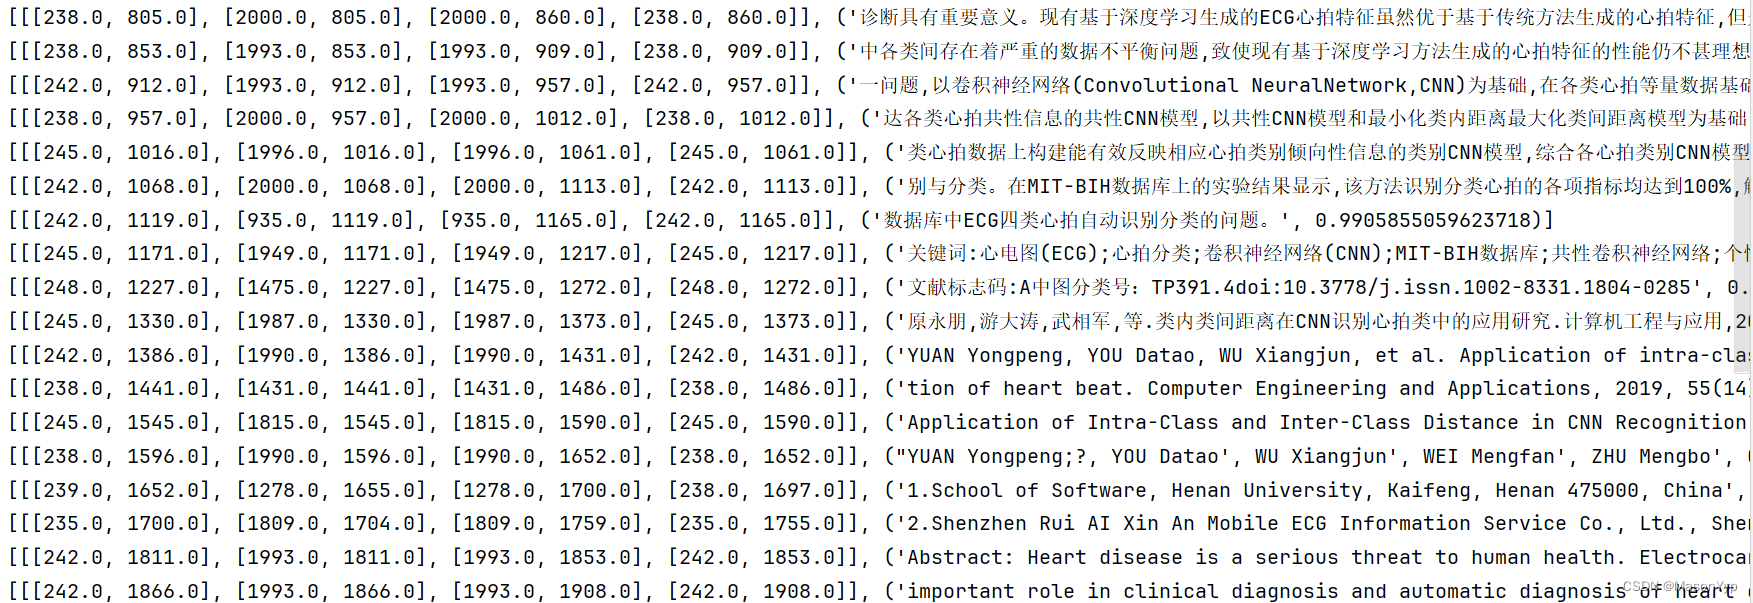
        # line是一个列表' [[文本框的位置],(文字,置信度)] '
        for line in res:
            print(line)


def parse_text(pdf_path: str):
    # 读取pdf文件
    doc = pymupdf.open(pdf_path)

    # 读取pdf中的页
    for page in doc:
        # 读取纯文本
        text = page.get_textpage().extractText()

        # 转化为UTF-8
        text = text.encode("gbk", errors="ignore").decode("utf-8", errors="ignore")
        print(text)


def parse_pdf_2_img(pdf_path: str):
    # 读取pdf文件
    doc = pymupdf.open(pdf_path)

    # 读取pdf中的页
    for page in doc:
        # 读取图片,dpi可以调节图片的清晰度
        page_pix = page.get_pixmap(dpi=256)
        page_pix.save("E:/test/img/page-%i.png" % page.number)


pdf_path_temp = "E:/test/test.pdf"
# parse_text(pdf_path_temp)

parse_pdf_2_img(pdf_path_temp)
parse_img_2_text("E:/test/img/page-0.png")
执行截图