AudioSep 是一种 AI 模型,可以使用自然语言查询进行声音分离。这一创新性的模型由Audio-AGI开发,使用户能够通过简单的语言描述来分离各种声音源。
比如在嘈杂的人流车流中说话 的录音中,可以分别提取干净的人声说话声音 和嘈杂的人流车流噪声 。可以根据需求分离,保留人声或者噪声。甚至可以单独提取声音中的笑声。除此之外,还能提取伴奏声音里指定的乐器声音,比如一段钢琴和吉他 合奏曲目,需要单独分离钢琴曲 ,就可以用这个项目来实现。
但缺点是目前不支持歌曲的人声和伴奏分离,如果有类似需求,可以尝试用 UVR5 来分离,这个工具恰好弥补了UVR5的不足,两者相辅相成,AI语音项目里的两个神器。
做AI语音训练的人都知道,一段干净的纯人声是多么的重要,一个声音模型的好坏,就取决于人声素材的纯净与否,这个工具的出现,大大解决了分离声音素材噪声的问题,相信在这个工具的加持下,训练的声音模型会有本质的提升。
除了使用现有模型分离,还支持自己训练指定的音频数据集模型来实现特殊的音频分离场景。
项目地址: ++https://github.com/Audio-AGI/AudioSep++
++本地一键整合包:++ AudioSep:从音频中分离出特定声音(人声、笑声、噪音、乐器等)本地一键整合包下载
使用说明:
双击启动一键整合包,点击一键启动,等待自动跳转到WebUI界面

点击上传需要分离的音频素材,如下图
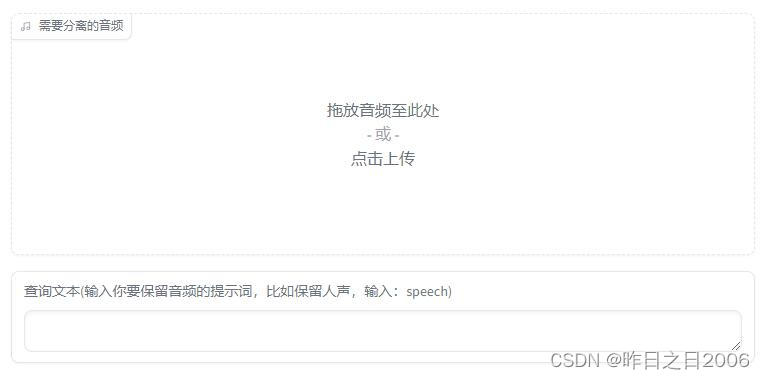
输入要保留的音频元素,比如从噪声中分离说话的声音,就输入 speech,英文不好的可以借助翻译工具
最后点提取,等待完成即可。

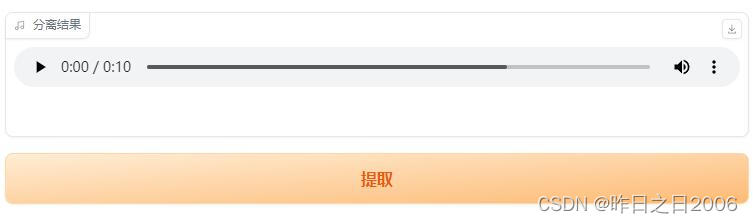
成功后,输出区域会显示提取后的音频,可以点击试听,并根据需要下载到本地。如下图