论文阅读--Cross-view Transformers for real-time Map-view Semantic Segmentation

一种新的2D维度的bev特征提取方案,其通过引入相机先验信息(相机内参和外参)构建了一个多视图交叉注意力机制,能够将多视图特征映射为BEV特征。

cross view attention:BEV位置编码+由根据相机标定结果(内参和外参)演算得到的相机位置编码+多视图特征做attention得到

整体上文章的网络前端使用CNN作为特征抽取网络,中端使用CNN多级特征作为输入在多视图下优化BEV特征(也就是使用了级联优化),后端使用CNN形式的解码器进行输出
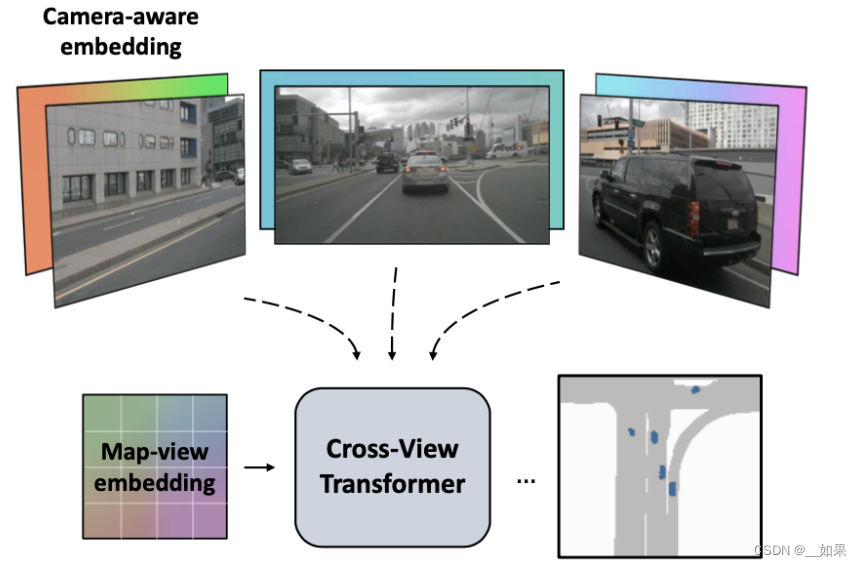
q:bev下加上map-view embedding进行refine

k:在多视图特征(由CNN网络得到)上也会添加camera-view的embedding进行refine

v:原多视图特征也会经过线型映射

为了感知道路的3D位置几何关系还对相机位置进行embedding(代码中为减去操作),并与上述的两种embedding进行关联

因为不知道实际的深度值,所以存在scale上的不确定性。与LSS不同,在这篇文章中并没有显式使用深度信息或者是隐式编码深度空间分布,而是将scale上的不确定性编码使用上述提到的camera-view embedding、map-view embedding和transformer网络进行学习和适应

相关推荐
Rocky Ding*15 小时前
【三年面试五年模拟】2026-11-01_字节跳动AI Agent全栈研发一面面经全解析
论文阅读·人工智能·深度学习·机器学习·aigc·ai-native·ai agent
五网20 小时前
软件测试用例模板怎么写:从用例设计到执行记录的全套指南
软件测试·论文阅读·全文检索·测试用例·论文笔记·用例设计·用例模板
布吉岛的石头1 天前
Java 程序员第 50 阶段14:灾难性遗忘与回放
人工智能·深度学习·transformer
Rocky Ding*2 天前
深入浅出IDM-VTON论文精读:虚拟试衣怎样同时保住服装语义与局部细节
论文阅读·人工智能·深度学习·机器学习·aigc·ai-native·idm-vton
天树星智源2 天前
机器人 VLA 一个模型同时动手和动脑:动作参数只占 0.21%,万级扰动任务 85.9%
论文阅读·机器人·vla·全身控制
weixin_468466852 天前
视觉Transformer的“第二次革命”:ViT³如何用测试时训练重构注意力范式
人工智能·深度学习·机器学习·ai·重构·transformer·vit
DevOps老兵3 天前
Transformer拆解13:现代大模型改了什么,RoPE、RMSNorm、SwiGLU与GQA
transformer·gqa·rope·rmsnorm·swiglu
DUTBenjamin4 天前
论文阅读笔记:GPT-6-Astra Lights Up Embodied Navigation
论文阅读·具身智能·vln
七元权4 天前
FoundationPose 推理全流程解读:从一帧 RGB-D 到 6D 位姿
论文阅读·深度学习·6d姿态估计
m4Rk_5 天前
【论文阅读】Agent 记忆机制(119):EvoLife——让具身 Agent 把主动问到的答案沉淀为可复用的空间经验
论文阅读·人工智能·学习·开源·github