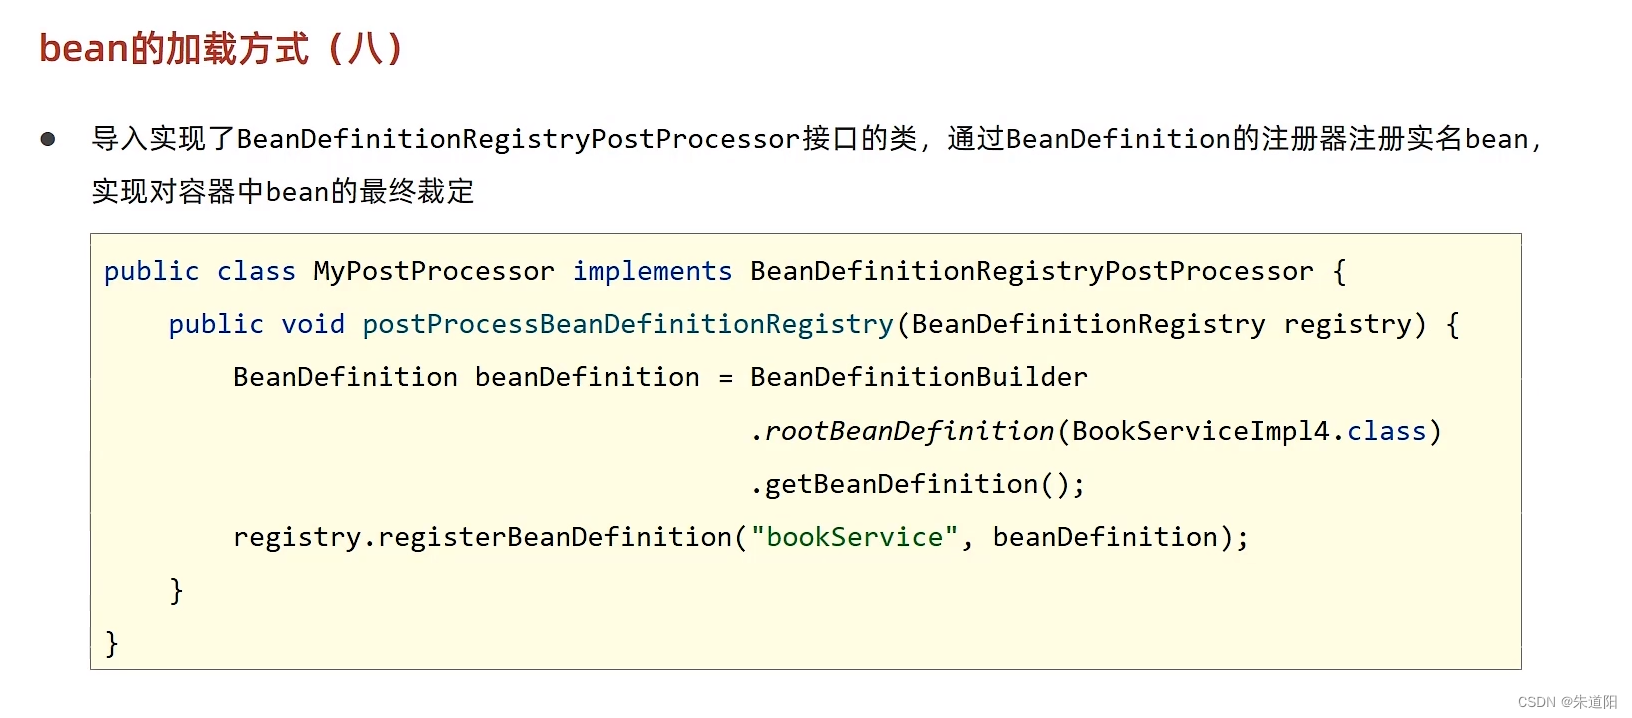
BeanDefinitionRegistryPostProcessor注解
这种方式和第七种比较像

要实现两个方法
第一个方法是实现工厂
第二个方法叫后处理bean注册
package com.bigdata1421.bean;

import org.springframework.beans.BeansException;
import org.springframework.beans.factory.config.ConfigurableListableBeanFactory;
import org.springframework.beans.factory.support.BeanDefinitionRegistry;
import org.springframework.beans.factory.support.BeanDefinitionRegistryPostProcessor;

public class MyPostProcessor implements BeanDefinitionRegistryPostProcessor {

    @Override
    public void postProcessBeanDefinitionRegistry(BeanDefinitionRegistry beanDefinitionRegistry) throws BeansException {

    }

    @Override
    public void postProcessBeanFactory(ConfigurableListableBeanFactory configurableListableBeanFactory) throws BeansException {

    }

}
跟之前的写法一样

package com.bigdata1421.bean;

import com.bigdata1421.bean.service.impl.BookServiceImpl1;
import com.bigdata1421.bean.service.impl.BookServiceImpl2;
import org.springframework.beans.factory.config.BeanDefinition;
import org.springframework.beans.factory.support.BeanDefinitionBuilder;
import org.springframework.beans.factory.support.BeanDefinitionRegistry;
import org.springframework.beans.factory.support.BeanNameGenerator;
import org.springframework.context.annotation.ImportBeanDefinitionRegistrar;
import org.springframework.core.type.AnnotationMetadata;

public class MyRegistrar implements ImportBeanDefinitionRegistrar {
    @Override
    public void registerBeanDefinitions(AnnotationMetadata importingClassMetadata, BeanDefinitionRegistry registry) {

        BeanDefinition beanDefinition= BeanDefinitionBuilder.rootBeanDefinition(BookServiceImpl2.class).getBeanDefinition();
        registry.registerBeanDefinition("yellow",beanDefinition);

    }

}
我们操作配置类
我们首先Config8注入一个新的
类加载器

package com.bigdata1421.config;

import com.bigdata1421.bean.service.BookService;
import com.bigdata1421.bean.service.impl.BookServiceImpl1;
import org.springframework.context.annotation.Import;

@Import(BookServiceImpl1.class)
public class SpringConfig8 {
}
我写一个APP8去拿bean

package com.bigdata1421.bean.app;

import com.bigdata1421.bean.service.BookService;
import com.bigdata1421.config.SpringConfig7;
import com.bigdata1421.config.SpringConfig8;
import org.springframework.context.ApplicationContext;
import org.springframework.context.annotation.AnnotationConfigApplicationContext;

public class App8 {
    public static void main(String[] args) {
        ApplicationContext ctx=new AnnotationConfigApplicationContext(SpringConfig8.class);
        BookService bookService = ctx.getBean("bookService", BookService.class);
        bookService.check();
    }
}
看一下业务层的实现类

package com.bigdata1421.bean.service.impl;

import com.bigdata1421.bean.service.BookService;
import org.springframework.stereotype.Service;

@Service("bookService")
public class BookServiceImpl1 implements BookService {
    @Override
    public void check() {
        System.out.println("1");
    }
}
名字叫bookService
运行
打印

这里我们导入一个bean

这就相当于有人在系统中已经定义好了
我们现在用register注册bean
我们这时候注入两个bean

package com.bigdata1421.config;

import com.bigdata1421.bean.MyRegistrar;
import com.bigdata1421.bean.service.BookService;
import com.bigdata1421.bean.service.impl.BookServiceImpl1;
import org.springframework.context.annotation.Import;

@Import({BookServiceImpl1.class, MyRegistrar.class})
public class SpringConfig8 {

}
Myregistrar里面是这样写的

思考
我们在这边注入的是两个类加载器
bean是同一个bean

但无论我们怎么调换顺序
都是打印的这个

这种加载bean的顺序是有讲究的
小结
在Spring框架中,Bean的底层数据结构通常是使用HashMap或ConcurrentHashMap来存储的。具体来说,Spring使用一个名为BeanFactory的接口来管理Bean,其默认实现是DefaultListableBeanFactory,它内部使用一个ConcurrentHashMap来存储所有的Bean实例,以及它们的相关信息。
这种设计使得Spring能够高效地管理大量的Bean,并且支持并发访问。通过HashMap或ConcurrentHashMap,Spring能够根据Bean的名称或类型快速查找和访问相应的Bean实例,同时还能够处理Bean的依赖注入和生命周期管理等功能。
ConcurrentHashMap 是 Java 中的一个线程安全的哈希表实现,它是对 HashMap 的改进版本,专门用于在多线程环境下进行并发操作。
主要特点包括:
-
分段锁设计:
-
ConcurrentHashMap 内部通过将整个 Map 分割为多个 Segment(段),每个 Segment 默认是一个 HashEntry 数组,各自维护一部分数据,因此不同 Segment 的数据可以同时被多个线程访问,提高了并发访问效率。
-
每个 Segment 内部都是一个类似于 HashMap 的结构,使用 synchronized 关键字来保证线程安全。
-
-
线程安全性:
-
ConcurrentHashMap 允许多个线程同时读取,不会出现读取数据时的阻塞情况(非阻塞读取)。
-
对于写操作(put、remove 等),只会锁住相关的 Segment,而不是整个 Map,因此多个线程可以同时执行写操作,从而提高了写操作的并发性能。
-
-
适用场景:
-
ConcurrentHashMap 特别适用于多线程并发访问的场景,例如在高并发的 Web 应用中,作为缓存或者共享数据的存储结构,能够提供较好的性能表现。
-
在 Java 并发框架中,ConcurrentHashMap 是非常重要的组成部分,被广泛应用于各种需要高效并发访问的场景。
-
-
迭代器特性:
- ConcurrentHashMap 的迭代器是弱一致性的(Weakly Consistent),即迭代器可以读取到其他线程改变后的数据,但不会抛出 ConcurrentModificationException 异常,因此可以在遍历的同时进行修改操作,但可能会读取到一些旧数据。
总体来说,ConcurrentHashMap 通过分段锁和优化的数据结构设计,实现了在高并发情况下的高效读写操作,是 Java 并发编程中常用的工具之一。
个人号推广
博客主页
Web后端开发
https://blog.csdn.net/qq_30500575/category_12624592.html?spm=1001.2014.3001.5482
Web前端开发
https://blog.csdn.net/qq_30500575/category_12642989.html?spm=1001.2014.3001.5482
数据库开发
https://blog.csdn.net/qq_30500575/category_12651993.html?spm=1001.2014.3001.5482
项目实战
https://blog.csdn.net/qq_30500575/category_12699801.html?spm=1001.2014.3001.5482
算法与数据结构
https://blog.csdn.net/qq_30500575/category_12630954.html?spm=1001.2014.3001.5482
计算机基础
https://blog.csdn.net/qq_30500575/category_12701605.html?spm=1001.2014.3001.5482
回忆录
https://blog.csdn.net/qq_30500575/category_12620276.html?spm=1001.2014.3001.5482