Kafka Producer之数据重复和乱序问题

文章目录

  • [1. 数据重复](#1. 数据重复)
  • [2. 数据乱序](#2. 数据乱序)

为了可靠性,Kafka有消息重试机制,但是同时也带来了2大问题

1. 数据重复

消息发送到broker后,broker记录消息数据到log中,但是由于网络问题,producer没有收到acks,于是再次发送消息。

除此之外,也可能是其他场景,导致了消息的重复。

2. 数据乱序
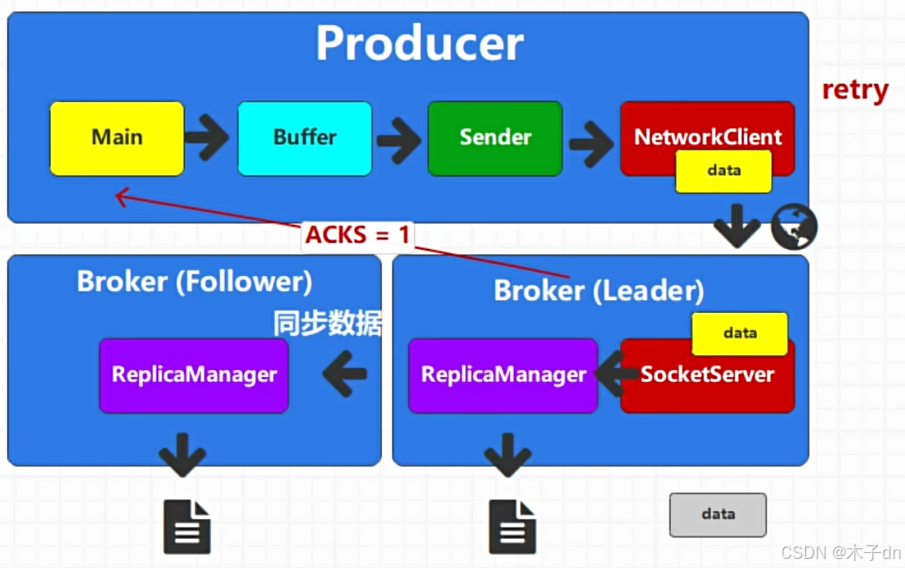
如图,消息2、3发送到了broker,但是data1因为网络问题没有到broker,然后被producer重试了,第二次到了,但是顺序乱了。

相关推荐
PingCAP21 分钟前
善战者无赫赫之功:消费金融核心系统的数据库选型与升级路径
数据库·分布式·架构
库库的数据库笔记1 小时前
金融核心交易系统的数据库国产信创改造该如何做?
大数据·数据库·分布式·mysql·oracle·金融·数据库架构
RobinXYuan5 小时前
【Kafka 源码手记】04 客户端如何找到 Broker
kafka·源码阅读
爱吃火鸡面呀7 小时前
深入理解 Spark RDD:五大特性与实战解析
大数据·分布式·spark
Linux实战笔记8 小时前
记一次消息队列选型对比线上排查:Kafka/RabbitMQ/Pulsar 技术选型
kafka·rabbitmq·高并发·pulsar·消息队列选型
Norris Huang9 小时前
Kafka Connect 与 Flink CDC 写入 Iceberg:Upsert 的代价,以及 S3 Tables 的真正价值
分布式·flink·kafka
张彦峰ZYF9 小时前
一条消息的丢与重:Kafka 与 RabbitMQ 可靠投递的确认、位点、死信与幂等全链路
后端·kafka·消息队列·rabbitmq·isr·解耦与削峰·丢失与重复
我就是不信9 小时前
集群高并发环境下如何保证分布式唯一全局ID生成?
分布式
黄俊懿1 天前
【架构师从入门到进阶】第六章:服务集群优化——第八节:线程数公式
java·服务器·数据库·分布式·性能优化·架构·系统架构
大菠萝爱上小西瓜1 天前
基于 Spark + Iceberg 湖仓一体的 Netflix 流媒体用户行为全链路数仓与 ALS 智能推荐决策系统(含穿透下钻大屏)
大数据·分布式·spark