Redis篇(应用案例 - UV统计)(持续更新迭代)

目录

一、HyperLogLog

二、测试百万数据的统计


一、HyperLogLog

首先我们搞懂两个概念:

UV:全称Unique Visitor,也叫独立访客量,是指通过互联网访问、浏览这个网页的自然人。

1天内同一个用户多次访问该网站,只记录1次。

PV:全称Page View,也叫页面访问量或点击量,用户每访问网站的一个页面,记录1次PV,用户多次打开页

面,则记录多次PV。

往往用来衡量网站的流量。

通常来说UV会比PV大很多,所以衡量同一个网站的访问量,我们需要综合考虑很多因素,

所以我们只是单纯的把这两个值作为一个参考值

UV统计在服务端做会比较麻烦,因为要判断该用户是否已经统计过了,需要将统计过的用户信息保存。

但是如果每个访问的用户都保存到Redis中,数据量会非常恐怖,那怎么处理呢?

Hyperloglog(HLL)是从Loglog算法派生的概率算法,用于确定非常大的集合的基数,而不需要存储其所有

值。

相关算法原理大家可以参考:https://juejin.cn/post/6844903785744056333#heading-0

Redis中的HLL是基于string结构实现的,单个HLL的内存永远小于16kb,内存占用低的令人发指!

作为代价,其测量结果是概率性的,有小于0.81%的误差。

不过对于UV统计来说,这完全可以忽略。

二、测试百万数据的统计

测试思路:我们直接利用单元测试,向HyperLogLog中添加100万条数据,看看内存占用和统计效果如何
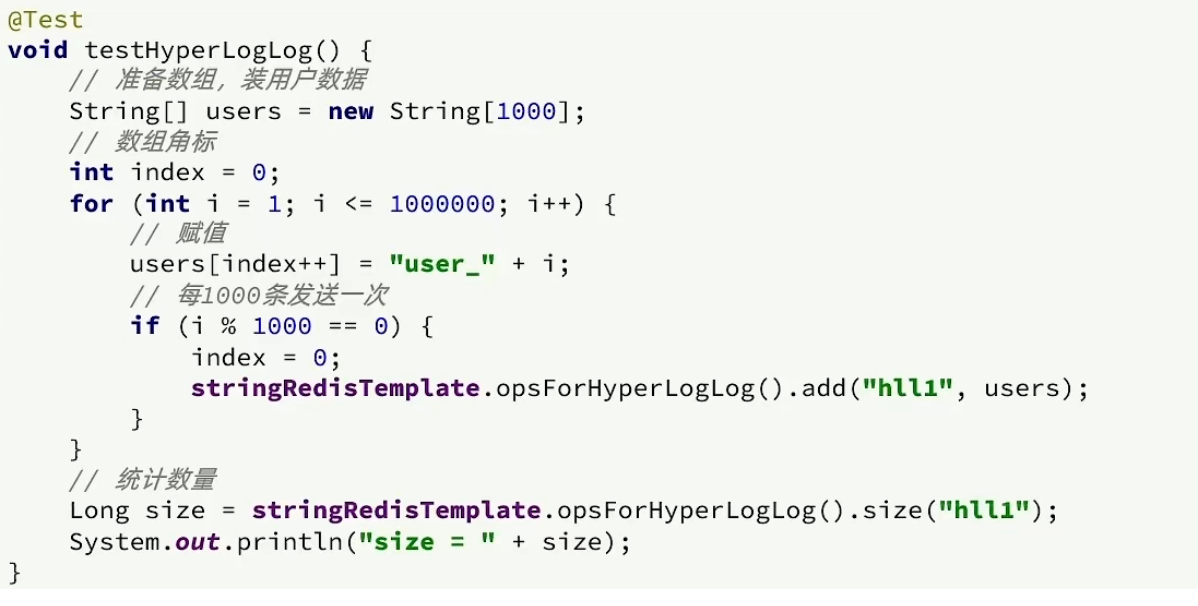
经过测试:我们会发生他的误差是在允许范围内,并且内存占用极小

相关推荐
Flynn Liang3 分钟前
AI Agent 分层记忆体系实战:用 Redis 五类结构构建可淘汰、可追溯的长短期记忆
数据库·人工智能·redis
IT规划师34 分钟前
Redis 核心机制 | 事务:执行序列的原子性、乐观锁与 8.x 条件写
redis·.net
Henry-SAP10 小时前
PP的生产调度员(Production Scheduler)的角色与配置
数据库
Flynn Liang12 小时前
HikariCP 连接池不是越大越好:I/O 密集型 Java 服务的数据库容量工程
java·数据库·mysql·高并发·连接池·hikaricp·sql 优化
小乖写代码14 小时前
消息、回执与媒体 · msgstore.db · Messages, Receipts, and Media
数据库·媒体·whatsapp·消息回执
泓度科技14 小时前
接口防暴力破解+短信防刷,低成本安全加固怎么做
redis·安全加固·限流熔断·接口防暴力破解·短信防刷
GeW15 小时前
世界目光聚焦中国:底层技术、Linux、数据库的破局逻辑
linux·数据库
PingCAP15 小时前
平凯数据库 × 圣诺云数:让治理数据实时可用、跨域可信流通
数据库·tidb
利威尔xu15 小时前
PostgreSQL 索引失效 4 类:函数运算让查询全表扫描拖垮性能
开发语言·数据库·postgresql·性能优化·索引优化